

Нужен ли Kubernetes
Во многих командах данных Kubernetes не нужен. Контейнеров, Compose и облачных сервисов хватает. Kubernetes полезен, но у него есть цена. Её стоит платить, когда вы можете назвать конкретную проблему, которую он решает.
Что такое Kubernetes
Заголовок раздела «Что такое Kubernetes»Kubernetes (K8s) — система, которая запускает контейнеры на группе серверов и следит за ними.
| Понятие | Что это |
|---|---|
| Cluster | Группа серверов под управлением Kubernetes |
| Node | Один сервер в кластере |
| Pod | Один или несколько контейнеров, которые запускаются вместе. Минимальная единица |
| Deployment | Описание: «держи 3 копии этого pod и обновляй их по очереди» |
| Service | Постоянный адрес и порт для группы pod |
Вы описываете желаемое состояние в YAML. Kubernetes сам приводит кластер к нему.
Что он даёт
Заголовок раздела «Что он даёт»- Самовосстановление. Контейнер упал — Kubernetes запустит новый. Сервер сломался — перенесёт контейнеры на другой.
- Масштабирование. Нагрузка выросла — копий стало больше. Можно настроить по своим метрикам.
- Обновление без остановки. Новая версия включается постепенно. Если она сломана, откат одной командой.
- Много сервисов и команд. Общие правила, права и сеть для десятков сервисов.
Сколько он стоит
Заголовок раздела «Сколько он стоит»- Сложность. Нужно знать pod, Service, Ingress, ConfigMap, Secret, PVC и ещё десятки понятий.
- Время на поддержку. Кластер нужно обновлять, мониторить и чинить.
- Много YAML. Сервис, который в Compose занимает 10 строк, в Kubernetes занимает 40.
- Сеть и права. Они сложнее, чем в Docker.
- Деньги. Кластер работает постоянно, даже когда задач нет.
- Люди. Нужны те, кто умеет им управлять. Часто это отдельная платформенная команда.
Что хватает обычной команде данных
Заголовок раздела «Что хватает обычной команде данных»Типичная команда данных: 5–30 пакетных пайплайнов, один BI-инструмент, одно хранилище. Для этого Kubernetes не нужен.
| Ситуация | Что хватает |
|---|---|
| Локальная разработка | Docker и Compose |
| Одна база, один BI, несколько задач на одном сервере | Compose на одной виртуальной машине |
| Пакетные задачи по расписанию | AWS ECS на Fargate, Cloud Run jobs, Container Apps jobs |
| Веб-сервис или API с небольшой нагрузкой | Cloud Run, ECS на Fargate (или ECS Express Mode), Container Apps |
| Оркестрация пайплайнов | Управляемый Airflow: MWAA, Cloud Composer, Astronomer |
| Задачи по событию, короткие | Lambda с образом контейнера |
Когда Kubernetes имеет смысл
Заголовок раздела «Когда Kubernetes имеет смысл»- Десятки сервисов и несколько команд на одной платформе.
- Нужно масштабирование по своим метрикам, например по длине очереди.
- В компании уже есть платформенная команда, которая поддерживает кластер.
- Требование: свои серверы (on-prem) или несколько облаков с одним способом запуска.
- Airflow с
KubernetesExecutorпри большом числе параллельных задач. - Spark на Kubernetes.
- Сервинг ML-моделей в большом масштабе.
Правило
Заголовок раздела «Правило»Начните просто. Переходите на Kubernetes, когда можете назвать конкретную проблему, которую он решает. «Все так делают» — не проблема. «Нам нужно 200 параллельных задач, и Fargate стоит слишком дорого» — проблема.
Что переносится
Заголовок раздела «Что переносится»Всё, чему вы научились в этом курсе, пригодится в Kubernetes.
Dockerfileи образ остаются теми же. Kubernetes запускает тот же образ.- Переменные окружения работают так же.
- Том в Docker похож на PVC в Kubernetes.
- Имя службы в Compose (
db) похоже на Service: постоянный адрес, по которому другие находят сервис.
Сравнение: Compose и Kubernetes
Заголовок раздела «Сравнение: Compose и Kubernetes»Сервис db в Compose:
services: db: image: postgres:17 environment: POSTGRES_PASSWORD: ${DB_PASSWORD} ports: - "5432:5432" volumes: - pgdata:/var/lib/postgresql/dataТот же сервис в Kubernetes (концептуальный пример, не запускаем). Для баз в Kubernetes обычно берут StatefulSet. Здесь Deployment, чтобы пример был проще:
apiVersion: apps/v1kind: Deploymentmetadata: name: dbspec: replicas: 1 selector: matchLabels: app: db template: metadata: labels: app: db spec: containers: - name: db image: postgres:17 env: - name: POSTGRES_PASSWORD valueFrom: secretKeyRef: name: db-secret key: password ports: - containerPort: 5432 volumeMounts: - name: pgdata mountPath: /var/lib/postgresql/data volumes: - name: pgdata persistentVolumeClaim: claimName: pgdata---apiVersion: v1kind: Servicemetadata: name: dbspec: selector: app: db ports: - port: 5432Идея та же: образ, переменные, порт, том. Но текста больше. И нужны ещё Secret и PersistentVolumeClaim. В реальной работе базу в Kubernetes обычно не запускают. Берут управляемую базу в облаке.
Путь обучения
Заголовок раздела «Путь обучения»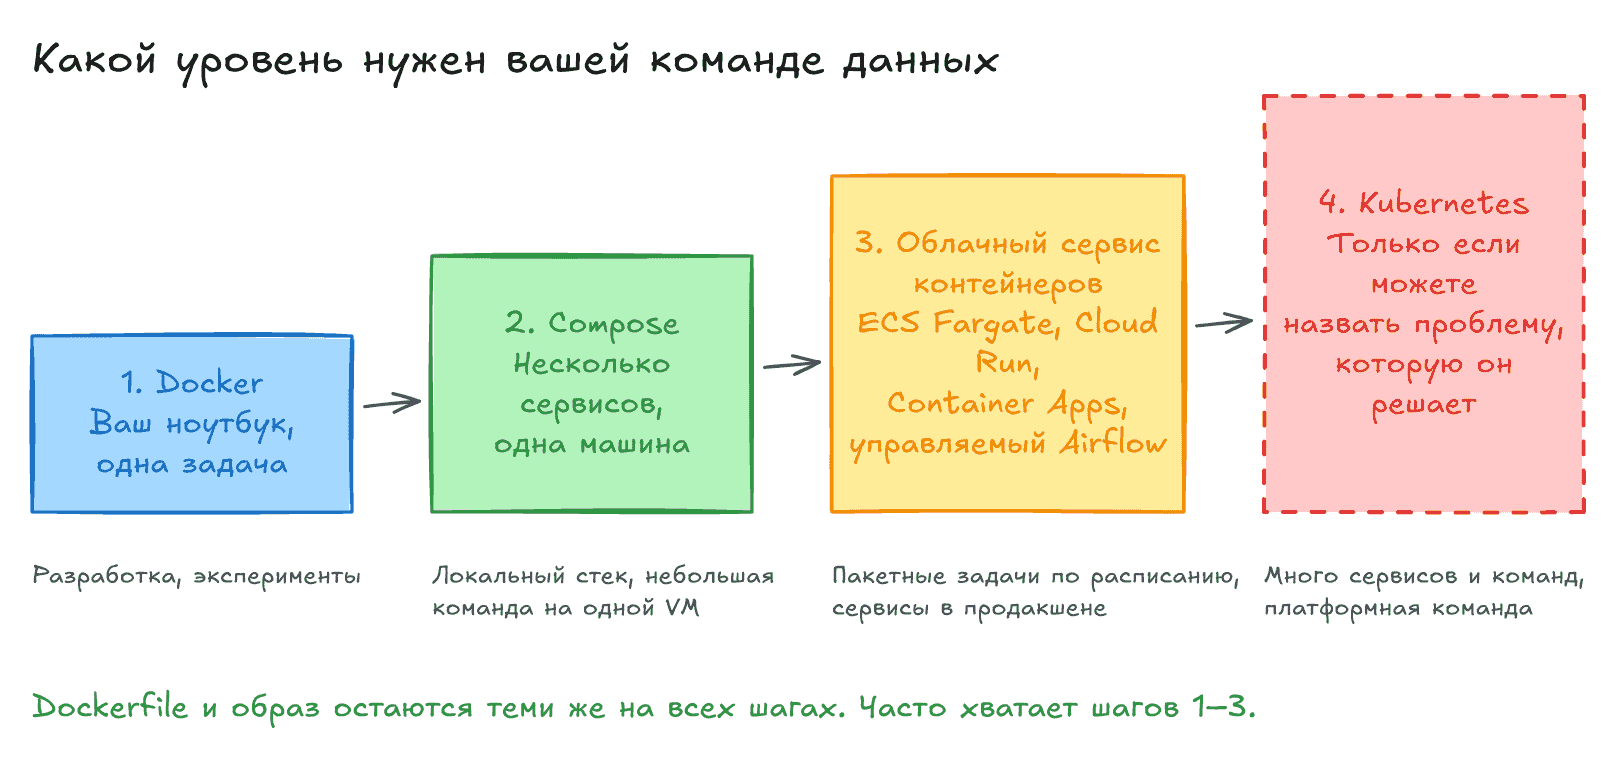
- Docker: образы и контейнеры.
- Compose: несколько сервисов вместе.
- Один облачный сервис контейнеров: ECS, Cloud Run или Container Apps.
- Kubernetes. Только если он действительно нужен.
Попробовать Kubernetes на своём компьютере можно в kind или в Docker Desktop (раздел Kubernetes в настройках).
Практика
Заголовок раздела «Практика»Это задания на размышление. Для каждого выберите решение и объясните его.
Задание 1
Заголовок раздела «Задание 1»Команда из трёх аналитиков. Каждую ночь работает 8 скриптов Python. Они грузят данные из API в хранилище. Каждый скрипт работает 5–20 минут. Что выбрать?
Проверка: ответ не включает Kubernetes.
Решение
Подойдёт любой из вариантов:
- Каждый скрипт — образ. Запуск по расписанию в Cloud Run jobs, ECS на Fargate или Container Apps jobs.
- Или управляемый Airflow, если нужны зависимости между задачами.
- Самый простой вариант: одна виртуальная машина с
cronиdocker run.
Kubernetes не нужен. Задач мало, они короткие, нагрузка предсказуема.
Задание 2
Заголовок раздела «Задание 2»В компании 15 команд данных и 200 DAG в Airflow. Задачи требуют разных библиотек. Пик нагрузки — 300 параллельных задач. Есть платформенная команда, которая уже поддерживает кластер Kubernetes. Что выбрать?
Проверка: ответ включает Kubernetes и называет причину.
Решение
Airflow с KubernetesExecutor или KubernetesPodOperator в существующем кластере.
Причины:
- Большое число параллельных задач.
- Каждая задача в своём образе, с разными библиотеками.
- Платформенная команда уже умеет работать с кластером. Не нужно нанимать людей для кластера.
Задание 3
Заголовок раздела «Задание 3»Один инженер данных. Нужно запустить Metabase и Postgres для небольшой команды из 10 человек. Нагрузка небольшая. Что выбрать?
Проверка: ответ не включает Kubernetes.
Решение
Compose на одной виртуальной машине в облаке. Те же compose.yaml и том для Postgres, что мы писали на уроках. Добавьте регулярные бэкапы базы.
Если не хочется поддерживать сервер, возьмите управляемую базу в облаке (RDS, Cloud SQL) и запустите Metabase в Cloud Run или ECS.
Kubernetes здесь добавит работы, но не принесёт пользы.
Дальше: Итоговая практика.