

Нормальное распределение
Нормальное распределение — колокол. Значения сгруппированы вокруг среднего и симметрично спадают в обе стороны. Оно встречается, когда на результат влияет много мелких независимых причин: рост людей, время доставки, ошибки измерений.
У него два параметра: среднее μ и стандартное отклонение σ.
Правило 68–95–99,7
Заголовок раздела «Правило 68–95–99,7»Для нормального распределения доли данных вокруг среднего известны заранее:
| Диапазон | Доля данных |
|---|---|
μ ± 1σ | около 68% |
μ ± 2σ | около 95% |
μ ± 3σ | около 99,7% |
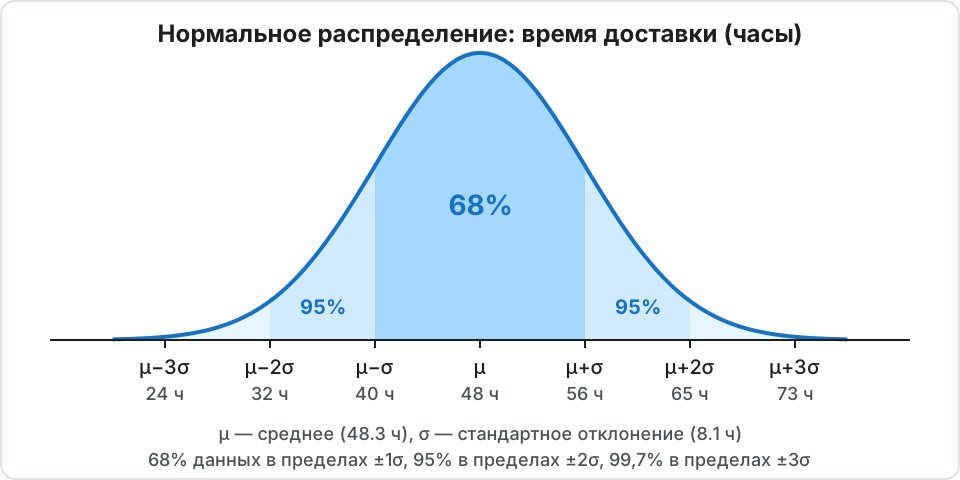
Для времени доставки μ = 48,3 часа, σ = 8,1. Значит, 95% заказов должны приходить за 48,3 ± 16,2, то есть за 32–65 часов.
Проверяем на данных
Заголовок раздела «Проверяем на данных»Подготовка: вы в папке stats-practice.
import csvimport statistics as st
with open("data/orders.csv") as f:    orders = list(csv.DictReader(f))
hours = [float(r["delivery_hours"]) for r in orders]m = st.mean(hours)s = st.stdev(hours)
for k in (1, 2, 3):    share = sum(abs(h - m) <= k * s for h in hours) / len(hours)    print(k, share)
Ответ:
1 0.6752 0.9613 0.999WITH stats AS ( SELECT avg(delivery_hours) AS m, stddev_samp(delivery_hours) AS s FROM orders)SELECT round(avg((abs(delivery_hours - m) <= 1 * s)::INT), 3) AS within_1, round(avg((abs(delivery_hours - m) <= 2 * s)::INT), 3) AS within_2, round(avg((abs(delivery_hours - m) <= 3 * s)::INT), 3) AS within_3FROM orders, stats;Ответ:
within_1 within_2 within_30.675 0.961 0.999(условие)::INT превращает истину в 1, ложь в 0. Среднее из единиц и нулей — доля.
Реальные доли: 67,5%, 96,1% и 99,9%. Правило сработало: время доставки близко к нормальному.
z-оценка
Заголовок раздела «z-оценка»z-оценка (z-score) говорит, на сколько стандартных отклонений значение отстоит от среднего:
z = (x − среднее) / σz = 0— ровно среднее.z = 2— на два σ выше среднего. Такое значение редкое: выше него лишь около 2,5% данных.z = −3— очень низкое значение.
Правило: |z| > 3 — повод проверить значение. Это выброс для нормальных данных.
z-оценка нужна, чтобы сравнивать разные шкалы. Время доставки 60 часов и сумма 150 — несравнимы. Но их z-оценки сравнить можно.
nd = st.NormalDist(m, s)          # нормальное распределение с нашими μ и σ
print(round((60 - m) / s, 2))     # z-оценка для 60 часовprint(round(1 - nd.cdf(60), 4))   # доля заказов дольше 60 часов по теорииprint(sum(h > 60 for h in hours) / len(hours))   # доля по факту
Ответ:
1.440.07490.079cdf(x) — доля значений не больше x. Поэтому «дольше 60» — это 1 − cdf(60).
WITH stats AS ( SELECT avg(delivery_hours) AS m, stddev_samp(delivery_hours) AS s FROM orders)SELECT order_id, delivery_hours, round((delivery_hours - m) / s, 2) AS zFROM orders, statsWHERE order_id IN (1001, 1002, 1003)ORDER BY order_id;Ответ:
order_id delivery_hours z1001 49.5 0.141002 47.9 -0.051003 54.8 0.8Теория говорит: дольше 60 часов будут 7,5% заказов. По факту — 7,9%. Близко. Модель нормального распределения подходит.
Практика
Заголовок раздела «Практика»Задание 1
Заголовок раздела «Задание 1»Найдите z-оценку самого дорогого заказа (4493,42) по сумме. Что она говорит?
Проверка: z ≈ 15,95. Заказ в 16 стандартных отклонений от среднего. При нормальном распределении это невозможно.
Решение
amount = [float(r["amount"]) for r in orders]ma, sa = st.mean(amount), st.stdev(amount)print(round((max(amount) - ma) / sa, 2))SQL:
SELECT round((max(amount) - avg(amount)) / stddev_samp(amount), 2) FROM orders;Задание 2
Заголовок раздела «Задание 2»Сколько заказов имеют |z| > 3 по времени доставки? Какой это заказ?
Проверка: один заказ. Время 21,8 часа, z = −3,28.
Решение
for r in orders: z = (float(r["delivery_hours"]) - m) / s if abs(z) > 3: print(r["order_id"], r["delivery_hours"], round(z, 2))SQL:
WITH stats AS ( SELECT avg(delivery_hours) AS m, stddev_samp(delivery_hours) AS s FROM orders)SELECT order_id, delivery_hours, round((delivery_hours - m) / s, 2) AS zFROM orders, statsWHERE abs((delivery_hours - m) / s) > 3;По теории |z| > 3 бывает у 0,3% значений, то есть у 3 из 1000. У нас один. Это нормально.
Задание 3
Заголовок раздела «Задание 3»Найдите по модели нормального распределения время, за которое приходят 95% заказов (то есть 95-й перцентиль). Сравните с реальным.
Проверка: по модели 61,66 часа. По факту (P95) — 61,8 часа. Почти одно и то же.
Решение
print(round(nd.inv_cdf(0.95), 2))inv_cdf(p) работает наоборот: даёт значение, ниже которого лежит доля p.
Реальный P95 мы считали в уроке про разброс: quantile_cont(delivery_hours, 0.95).
Дальше: Выборка и доверительный интервал.