

Среднее, медиана, мода
Нам нужно одно число, которое описывает «типичное» значение. Есть три способа.
| Мера | Что это | Как найти |
|---|---|---|
| Среднее (mean) | Сумма всех значений, делённая на их число | Сложить и разделить |
| Медиана (median) | Значение посередине, если выстроить данные по порядку. Половина значений меньше, половина больше | Отсортировать и взять середину |
| Мода (mode) | Самое частое значение | Посчитать, что встречается чаще |
Маленький пример. Пять заказов: 10, 20, 30, 40, 900.
- Среднее:
(10 + 20 + 30 + 40 + 900) / 5 = 200. - Медиана: середина списка —
30. - Один большой заказ сдвинул среднее до 200. Медиана осталась 30. Она устойчива к выбросам.
Считаем
Заголовок раздела «Считаем»Подготовка: вы в папке stats-practice.
import csvimport statistics as st
with open("data/orders.csv") as f:    orders = list(csv.DictReader(f))
amount = [float(r["amount"]) for r in orders]items = [int(r["items"]) for r in orders]
print(st.mean(amount))print(st.median(amount))print(st.mode(items))
Ответ:
77.3348648.0451SELECT avg(amount) AS mean_amount, median(amount) AS median_amount, mode(items) AS mode_itemsFROM orders;Ответ:
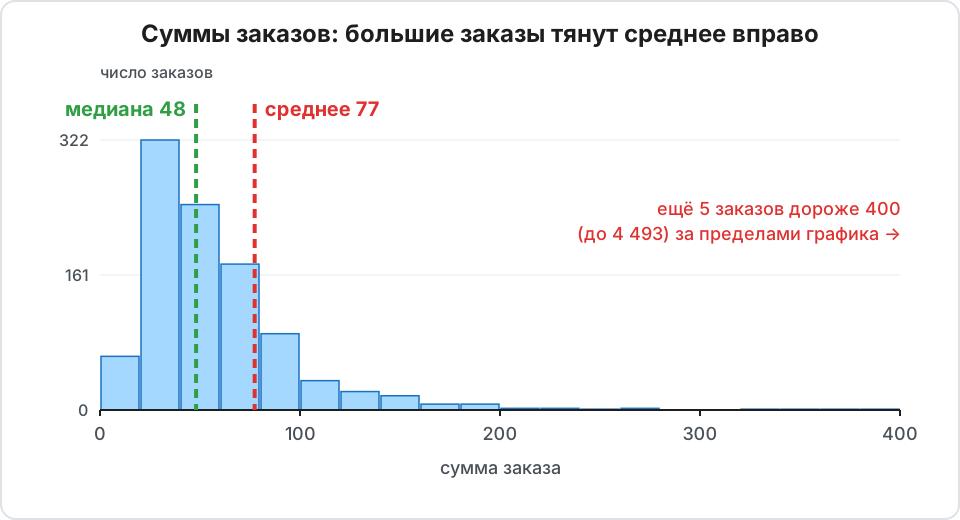
mean_amount median_amount mode_items77.33486 48.045 1Среднее (77) заметно больше медианы (48). Это сигнал: в данных есть большие значения справа.
Что выбрать
Заголовок раздела «Что выбрать»| Ситуация | Что использовать |
|---|---|
| Данные симметричные, без выбросов (например, время доставки) | Среднее. Медиана будет почти такой же |
| Данные скошены или есть выбросы (суммы заказов, зарплаты, цены на жильё) | Медиана |
| Категории (канал, устройство, страна) | Мода |
| Нужна сумма (выручка = среднее × число заказов) | Среднее |
Практика
Заголовок раздела «Практика»Задание 1
Заголовок раздела «Задание 1»Посчитайте среднее и медиану времени доставки (delivery_hours). Они близки или различаются?
Проверка: среднее 48,34, медиана 48,25. Они близки: данные почти симметричны.
Решение
Python:
hours = [float(r["delivery_hours"]) for r in orders]print(round(st.mean(hours), 2), st.median(hours))SQL:
SELECT round(avg(delivery_hours), 2), median(delivery_hours) FROM orders;Задание 2
Заголовок раздела «Задание 2»Посчитайте средний чек и медианный чек по каждому каналу. В каком канале самый высокий средний чек? В каком — самая высокая медиана?
Проверка:
| channel | среднее | медиана |
|---|---|---|
| ads | 87,77 | 46,09 |
| 56,94 | 45,30 | |
| organic | 81,02 | 52,73 |
Самое высокое среднее — у ads. Самая высокая медиана — у organic.
Решение
SQL:
SELECT channel, round(avg(amount), 2) AS mean_amount, median(amount) AS median_amountFROM ordersGROUP BY channelORDER BY channel;Python:
for ch in ["ads", "email", "organic"]: a = [float(r["amount"]) for r in orders if r["channel"] == ch] print(ch, round(st.mean(a), 2), round(st.median(a), 2))Среднее у ads высокое из-за нескольких больших заказов. Типичный заказ в organic дороже. Поэтому для сумм заказов лучше смотреть медиану.
Задание 3
Заголовок раздела «Задание 3»Найдите заказы дороже 1000. Сколько их? Какое среднее и медиана без них?
Проверка: таких заказов 5. Без них среднее 58,04 (было 77,33), медиана 47,88 (была 48,05).
Решение
Python:
big = [a for a in amount if a > 1000]rest = [a for a in amount if a <= 1000]print(len(big))print(round(st.mean(rest), 2), st.median(rest))SQL:
SELECT count(*) FILTER (WHERE amount > 1000) AS big, round(avg(amount) FILTER (WHERE amount <= 1000), 2) AS mean_rest, median(amount) FILTER (WHERE amount <= 1000) AS median_restFROM orders;Пять заказов из 1000 подняли среднее на 19 единиц, то есть на треть. Медиана почти не изменилась.
Задание 4
Заголовок раздела «Задание 4»Какое количество товаров в заказе самое частое? Какая доля заказов — с одним товаром?
Проверка: мода items — 1. С одним товаром 610 заказов, то есть 61%.
Решение
from collections import Counter
print(Counter(r["items"] for r in orders))
SELECT items, count(*) AS n, round(100.0 * count(*) / sum(count(*)) OVER (), 1) AS pctFROM ordersGROUP BY itemsORDER BY items;Дальше: Разброс.