

OLTP и OLAP: зачем моделировать
Данные в хранилище нельзя просто скопировать из приложения. Приложению и аналитику нужна разная форма данных. В этом уроке разберёмся почему.
Две разные задачи
Заголовок раздела «Две разные задачи»Приложение магазина делает много маленьких операций: создать заказ, поменять адрес, списать товар. Аналитик делает мало больших запросов: выручка по категориям за полгода.
| OLTP | OLAP | |
|---|---|---|
| Расшифровка | Online Transaction Processing | Online Analytical Processing |
| Кто работает | Приложение, сайт, касса | Аналитик, BI, дашборд, AI-агент |
| Типичный запрос | INSERT, UPDATE одной строки | SELECT с GROUP BY по миллионам строк |
| Что важно | Скорость записи, целостность | Скорость чтения, понятность |
| История | Только текущее состояние | Вся история изменений |
| Модель | Нормализованная (3NF) | Dimensional (star schema) |
| Примеры баз | PostgreSQL, MySQL, Oracle | Snowflake, BigQuery, ClickHouse, DuckDB |
Dimensional modeling (размерное моделирование) — способ организовать данные для второй задачи: для чтения и анализа. Его придумал и описал Ральф Кимбалл в книге The Data Warehouse Toolkit. Результат — star schema (схема «звезда»).
Нормализация
Заголовок раздела «Нормализация»Нормализация — способ хранить каждый факт один раз. Данные делят на много маленьких таблиц и связывают ключами.
В нашем источнике название категории хранится в одном месте — в categories. Товар хранит только category_id.
products categoriesproduct_id | product_name | cat_id category_id | category_name5 | Кроссовки | 2 ───► 2 | Обувь6 | Кеды | 2 ───►Зачем это приложению:
- Нет противоречий. Если переименовать «Обувь», это одно
UPDATEодной строки. - Быстрая запись. Каждая операция трогает мало данных.
- Меньше места. Ничего не повторяется.
Обычная цель — третья нормальная форма (3NF). Простое правило: каждая колонка зависит от ключа таблицы, от всего ключа и ни от чего, кроме ключа. Чем меньше повторов, тем модель нормализованнее.
Три аномалии, от которых защищает нормализация
Представьте, что категория записана прямо в каждой позиции заказа.
- Аномалия обновления. Переименовали категорию. Нужно обновить тысячи строк. Забыли одну — данные противоречат друг другу.
- Аномалия вставки. Нельзя завести новую категорию, пока в ней нет ни одной продажи.
- Аномалия удаления. Удалили последний заказ с этой категорией — категория исчезла.
Проблема нормализации для аналитики
Заголовок раздела «Проблема нормализации для аналитики»Вопрос: «Сколько мы продали по каждой категории?» Чтобы ответить, нужна цепочка:
categories → products → order_items → orders
Три JOIN ради одного простого вопроса. Если добавить город клиента и регион магазина, будет пять JOIN. Такие запросы:
- медленнее на больших данных;
- сложнее писать, легче ошибиться;
- непонятны бизнесу: «где лежит выручка?».
Денормализация
Заголовок раздела «Денормализация»Денормализация — мы специально добавляем повторы, чтобы читать было проще и быстрее. Например, кладём category_name прямо в таблицу товаров. Теперь «Обувь» повторяется у каждого товара обуви. Зато для отчёта нужен на один JOIN меньше.
Модели данных лежат на шкале от полной нормализации до полной денормализации:
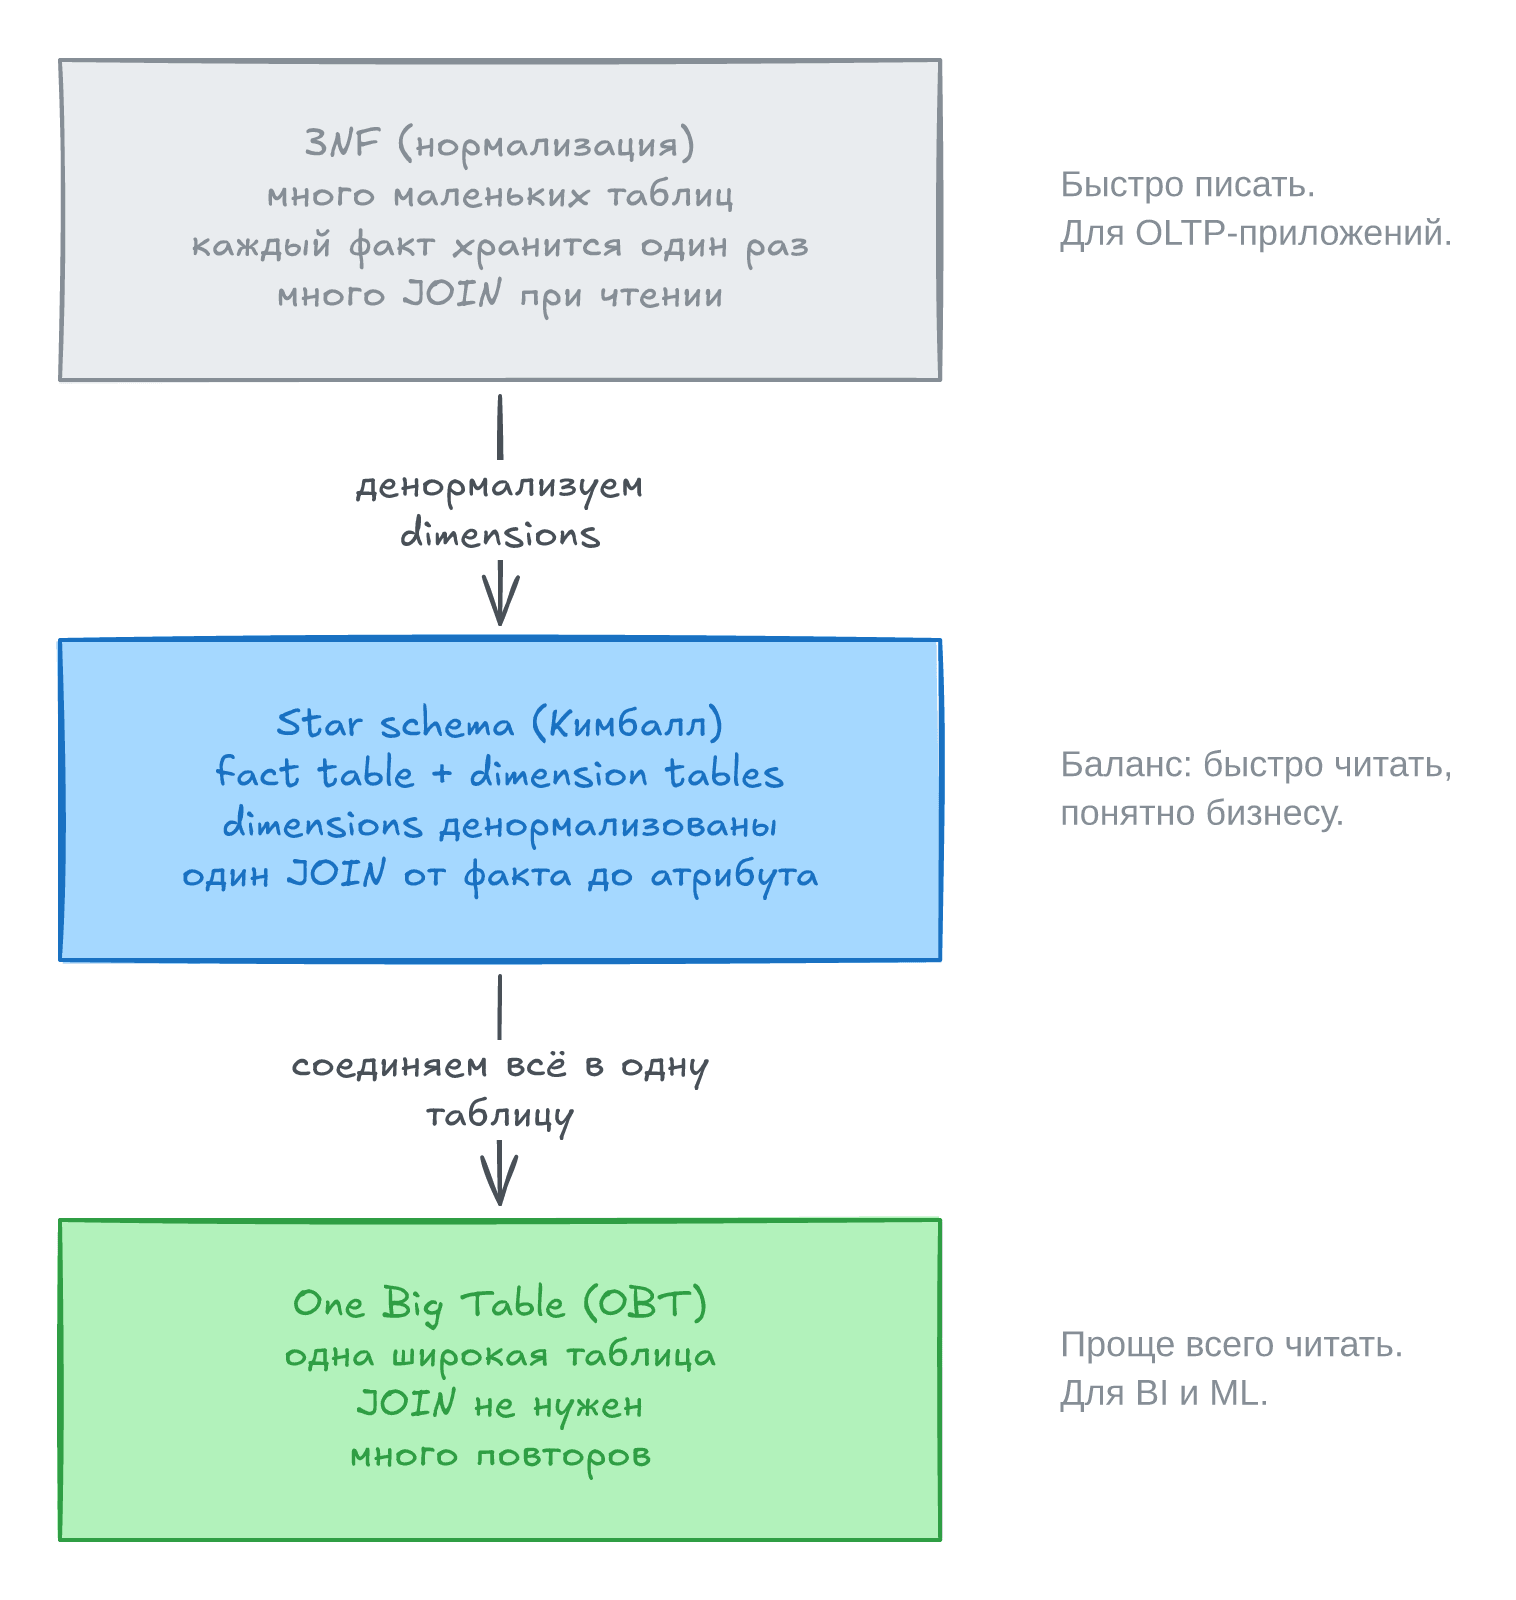
Star schema — середина. Она денормализует измерения (справочники), но держит факты (события и числа) в отдельной узкой таблице. Это баланс между скоростью, простотой и объёмом.
Практика
Заголовок раздела «Практика»Решайте сами, без AI. Сначала напишите запрос, потом сверьтесь с проверкой, и только потом открывайте решение.
Подготовка: вы в папке modeling-practice, база открыта: duckdb modeling.duckdb.
Пример: выручка по категориям из источника
Заголовок раздела «Пример: выручка по категориям из источника»Отменённые заказы не считаем. Выручка позиции = количество × цена − скидка.
SELECT c.category_name, sum(i.quantity * i.unit_price - i.discount_amount) AS revenueFROM src.order_items iJOIN src.orders o ON o.order_id = i.order_idJOIN src.products p ON p.product_id = i.product_idJOIN src.categories c ON c.category_id = p.category_idWHERE o.status <> 'cancelled'GROUP BY c.category_nameORDER BY revenue DESC;Ответ:
category_name revenueЭлектроника 9650300Обувь 6943482Одежда 4218931Снаряжение 3226601Аксессуары 1960649Три JOIN. Запомните эти числа: мы получим их снова из star schema.
Пример: одна плоская таблица
Заголовок раздела «Пример: одна плоская таблица»Соединим всё один раз и сохраним результат. Это полностью денормализованная таблица.
CREATE OR REPLACE TABLE flat_sales ASSELECT o.order_id, i.line_number, o.order_date, o.status,       cu.customer_name, cu.city AS customer_city, cu.segment,       s.store_name, s.city AS store_city, s.region,       p.product_name, p.brand, c.category_name,       i.quantity, i.unit_price, i.discount_amountFROM src.order_items iJOIN src.orders     o  ON o.order_id     = i.order_idLEFT JOIN src.customers cu ON cu.customer_id = o.customer_idJOIN src.stores     s  ON s.store_id     = o.store_idJOIN src.products   p  ON p.product_id   = i.product_idJOIN src.categories c  ON c.category_id  = p.category_id;
SELECT category_name,       sum(quantity * unit_price - discount_amount) AS revenueFROM flat_salesWHERE status <> 'cancelled'GROUP BY ALLORDER BY revenue DESC;
Те же числа, и ни одного JOIN. Обратите внимание на LEFT JOIN для клиентов: в магазинах есть покупки без карты, у них customer_id пустой. Обычный JOIN потерял бы эти строки.
Задание 1
Заголовок раздела «Задание 1»Сколько раз в flat_sales повторяется название категории «Обувь»? А сколько раз оно записано в источнике?
Проверка: в flat_sales — 690 раз. В источнике — 1 раз, в src.categories.
Решение
SELECT count(*) FROM flat_sales WHERE category_name = 'Обувь';SELECT count(*) FROM src.categories WHERE category_name = 'Обувь';Задание 2
Заголовок раздела «Задание 2»Бизнес решил переименовать категорию «Снаряжение» в «Инвентарь». Сколько строк нужно обновить в источнике? А в flat_sales? Не обновляйте, только посчитайте.
Проверка: в источнике — 1 строку. В flat_sales — 708 строк. Это и есть аномалия обновления. В хранилище с ней живут: таблицы пересобирает ETL, а не пользователь.
Решение
SELECT count(*) FROM src.categories WHERE category_name = 'Снаряжение';SELECT count(*) FROM flat_sales WHERE category_name = 'Снаряжение';Задание 3
Заголовок раздела «Задание 3»Выручка по региону магазина и сегменту клиента. Напишите запрос двумя способами: из источника и из flat_sales. Сколько JOIN понадобилось в первом случае?
Проверка: 9 строк. Первая — Центр, Обычный: 14 794 179.
Решение
Из источника:
SELECT s.region, cu.segment, sum(i.quantity * i.unit_price - i.discount_amount) AS revenueFROM src.order_items iJOIN src.orders o ON o.order_id = i.order_idJOIN src.stores s ON s.store_id = o.store_idLEFT JOIN src.customers cu ON cu.customer_id = o.customer_idWHERE o.status <> 'cancelled'GROUP BY ALLORDER BY revenue DESC;Из плоской таблицы:
SELECT region, segment, sum(quantity * unit_price - discount_amount) AS revenueFROM flat_salesWHERE status <> 'cancelled'GROUP BY ALLORDER BY revenue DESC;В первом случае нужно 3 JOIN (orders, stores, customers). Для клиентов — LEFT JOIN, чтобы не потерять гостей. Строки без сегмента — это покупки гостей.
Полный результат:
| region | segment | revenue |
|---|---|---|
| Центр | Обычный | 14 794 179 |
| Северо-Запад | Обычный | 2 594 224 |
| Поволжье | Обычный | 2 533 826 |
| Центр | VIP | 2 525 472 |
| Центр | NULL | 1 265 170 |
| Северо-Запад | VIP | 814 064 |
| Поволжье | VIP | 644 558 |
| Северо-Запад | NULL | 462 220 |
| Поволжье | NULL | 366 250 |
Регион «Центр» самый большой: в нём онлайн-магазин.
Задание 4
Заголовок раздела «Задание 4»В src.products есть колонка list_price. В src.order_items — unit_price. Для каких товаров они не совпадают хотя бы в одной продаже? Почему так?
Проверка: 4 товара: Футболка беговая, Кроссовки беговые, Смарт-часы, Наушники беспроводные. 1 апреля цены на них выросли на 10%. list_price — текущая цена. unit_price — цена в момент продажи.
Вывод: цену продажи нельзя брать из справочника товаров. Это факт события, он хранится вместе с продажей. Справочник показывает только текущее состояние.
Решение
SELECT p.product_name, p.list_price, min(i.unit_price) AS min_price, max(i.unit_price) AS max_priceFROM src.order_items iJOIN src.products p ON p.product_id = i.product_idGROUP BY ALLHAVING min(i.unit_price) <> p.list_price OR max(i.unit_price) <> p.list_priceORDER BY p.product_name;- OLTP-модель (3NF) хороша для записи. Для анализа нужно много
JOIN. - Плоская таблица удобна для чтения, но в ней много повторов.
- Star schema — баланс между ними. Её строим в следующих уроках.
- Источник хранит только текущее состояние. Историю (цены, адреса) нужно сохранять в хранилище.
Глубже: The Data Warehouse Toolkit, глава 1 — зачем нужно хранилище и чем dimensional model отличается от 3NF.
Дальше: Факты и измерения.