

The Data Warehouse Toolkit, глава 1: DW/BI и dimensional modeling
Главная мысль: хранилище данных должно быть простым и быстрым для бизнеса. Dimensional modeling делает это: данные лежат в понятных fact и dimension таблицах на самом детальном grain.
Зачем нужно хранилище
Заголовок раздела «Зачем нужно хранилище»Операционные системы записывают транзакции. Аналитикам нужно другое: смотреть на данные в разрезах и сравнивать периоды.
| Операционная система | DW/BI система |
|---|---|
| Записывает одну транзакцию быстро | Читает миллионы строк для анализа |
| Хранит текущее состояние | Хранит историю |
| Нормализована (3NF) | Dimensional model |
| Пользователь работает по сценарию | Пользователь задаёт любые вопросы |
Книга называет семь целей DW/BI:
- Данные просто найти и понять. Названия колонок похожи на слова бизнеса. Запросы быстрые.
- Данные согласованы. Если две метрики называются одинаково, они значат одно и то же.
- Система переживает изменения. Новые вопросы и атрибуты не ломают старые отчёты.
- Данные приходят вовремя. Бизнес договаривается, насколько свежими они должны быть.
- Данные защищены.
- Система — надёжная основа для решений. Её ценность в решениях, которые на ней принимают.
- Бизнес принимает систему. Если ей не пользуются, проект провален. Это самое важное требование.
Fact и dimension
Заголовок раздела «Fact и dimension»Dimensional model состоит из двух видов таблиц.
| Таблица | Что хранит | Как выглядит |
|---|---|---|
| Fact | Числа: измерения бизнес-процесса | Узкая и очень длинная. Много строк |
| Dimension | Описания: кто, что, где, когда, почему | Широкая и короткая. Много текстовых атрибутов |
Одна строка fact — одно событие измерения. Facts бывают трёх видов:
additive: можно суммировать по любой dimension. Пример: сумма продаж.semi-additive: нельзя суммировать по времени. Пример: остаток на счёте.non-additive: нельзя суммировать вообще. Пример: цена за единицу.
В отчёте всё просто:
- атрибуты dimension дают фильтры и группировку;
- fact даёт числа, которые мы суммируем.
-- типичный запрос к star schemaSELECT store.district, product.brand, sum(f.sales_amount)FROM fact_sales fJOIN dim_store store USING (store_key)JOIN dim_product product USING (product_key)JOIN dim_date d USING (date_key)WHERE d.month_name = 'June'GROUP BY ALL;Такой запрос легко писать и легко генерировать в BI-инструменте. Одна join на каждую dimension, одна агрегация.
Сравнение с 3NF
Заголовок раздела «Сравнение с 3NF»- Обе модели хранят одну и ту же информацию. Разница в удобстве.
- 3NF нужна, чтобы быстро и без дублей записывать транзакции. Для чтения она слишком сложна: десятки таблиц и join.
- Star schema нарочно денормализована ради понятности и скорости чтения.
- Dimensional model можно хранить в реляционной БД (
star schema) или в многомерной (OLAP cube).
Архитектура Kimball
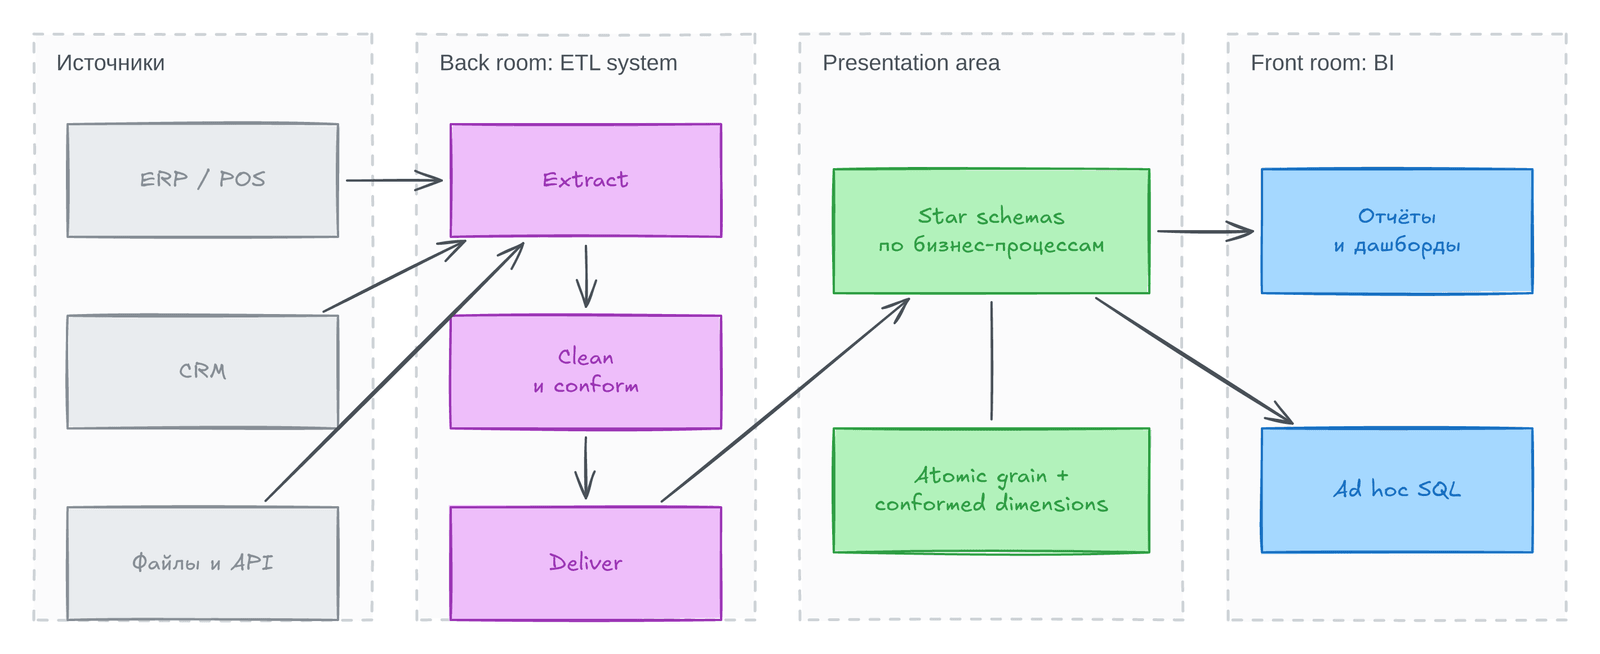
Заголовок раздела «Архитектура Kimball»Книга делит систему на четыре компонента.
| Зона | Что в ней | Кто ходит |
|---|---|---|
| Source | Операционные системы | Операционные пользователи |
| Back room (ETL system) | Extract, clean, conform, deliver | Только разработчики. Бизнес сюда не ходит |
| Presentation area | Dimensional models | Бизнес и BI-инструменты |
| Front room (BI) | Отчёты, дашборды, ad hoc SQL | Бизнес |
Правила presentation area:
- Данные dimensional. Не 3NF.
- Данные atomic. Агрегаты только дополняют детали и не заменяют их.
- Данные организованы по бизнес-процессам, а не по отделам.
- Все витрины используют общие conformed dimensions. Это
enterprise data warehouse bus.
Книга использует метафору ресторана: ETL — это кухня ресторана, presentation area — обеденный зал. Гости не ходят на кухню. Кухня отвечает за качество.
ETL в четырёх шагах
Заголовок раздела «ETL в четырёх шагах»Extract: забрать данные из источника.Clean: исправить ошибки, обработать пропуски, убрать дубли.Conform: привести к общим dimensions и общим определениям.Deliver: загрузить в dimensional models.
В современных стеках то же самое делают dbt и ELT. Идея не меняется. Меняются только инструменты.
Другие архитектуры
Заголовок раздела «Другие архитектуры»| Подход | Суть | Оценка книги |
|---|---|---|
| Independent data marts | Каждый отдел строит свою витрину | Не рекомендуется. Цифры не сходятся |
| Hub-and-spoke (Inmon, CIF) | Нормализованный EDW в 3NF, из него витрины | Работает, но дорого. Бизнес не должен ходить в 3NF |
| Hybrid | 3NF EDW, а потом Kimball presentation area | Допустимо, если 3NF EDW уже есть. С нуля дороже |
| Kimball bus | Dimensional витрины на conformed dimensions | Рекомендуется |
Главная разница: Inmon требует нормализованное хранилище. Kimball считает, что интеграцию дают conformed dimensions, а нормализация для этого не нужна.
Мифы о dimensional modeling
Заголовок раздела «Мифы о dimensional modeling»| Миф | Что на самом деле |
|---|---|
| Только для агрегатов | Нужен самый детальный grain. Агрегаты нужны для скорости |
| Только для отделов | Строим по бизнес-процессу. Много отделов смотрят на одни данные |
| Не масштабируется | Fact table с миллиардами строк — обычное дело |
| Только для известных отчётов | Моделируем процесс измерения, а не список отчётов |
| Нельзя интегрировать | Conformed dimensions именно для этого |
Гибкость модели
Заголовок раздела «Гибкость модели»Dimensional model легко расширять. Всё это не ломает старые запросы:
- новая колонка с fact на том же grain;
- новая dimension, если у неё одно значение на строку fact;
- новый атрибут в dimension;
- более детальный grain: перезагрузить fact с сохранением имён колонок.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| DW/BI | Хранилище и инструменты анализа вместе |
| Fact table | Числовые измерения бизнес-процесса |
| Dimension table | Описательный контекст для фильтров и группировок |
| Atomic grain | Самый детальный уровень данных |
| ETL system | Back room: подготовка данных |
| Presentation area | Витрины, доступные бизнесу |
| Conformed dimension | Общая dimension для разных процессов |
| Bus architecture | Набор витрин на общих conformed dimensions |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Строим витрины по бизнес-процессам: заказы, платежи, звонки. Не по отделам.
- Всегда храним atomic данные. Агрегаты — отдельные таблицы сверху.
- Названия колонок и значения в dimension должны быть понятны бизнесу.
Region, а неREG_CD. - Слой
martsвdbt— это presentation area. Слойstaging— часть back room. - Если две команды строят одну метрику по-разному, нужна общая conformed dimension и общее определение.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку в одной сессии.
Шаг 1. Создаём маленькую star schema
Заголовок раздела «Шаг 1. Создаём маленькую star schema»CREATE TABLE dim_date ASSELECT strftime(d, '%Y%m%d')::INT AS date_key, d::DATE AS full_date, monthname(d) AS month_name, dayname(d) AS day_nameFROM generate_series(DATE '2024-06-01', DATE '2024-06-30', INTERVAL 1 DAY) t(d);
CREATE TABLE dim_product ASSELECT * FROM (VALUES (1, 'SKU-1', 'Порошок A', 'PowerClean', 'Бытовая химия'), (2, 'SKU-2', 'Порошок B', 'Zippy', 'Бытовая химия'), (3, 'SKU-3', 'Мыло', 'Zippy', 'Гигиена'), (4, 'SKU-4', 'Шампунь', 'Clean Fast', 'Гигиена')) t(product_key, sku, product_name, brand, category);
CREATE TABLE dim_store ASSELECT * FROM (VALUES (1, 'Магазин 1', 'Atherton', 'Запад'), (2, 'Магазин 2', 'Belmont', 'Запад'), (3, 'Магазин 3', 'Camden', 'Восток')) t(store_key, store_name, district, region);
-- grain: одна позиция в чекеCREATE TABLE fact_sales ASSELECT strftime(DATE '2024-06-01' + (i % 30)::INT, '%Y%m%d')::INT AS date_key, 1 + i % 4 AS product_key, 1 + i % 3 AS store_key, 'T' || lpad((i // 3)::VARCHAR, 4, '0') AS ticket_number, 1 + i % 3 AS sales_units, (1 + i % 3) * (10 + 5 * (1 + i % 4)) AS sales_amountFROM range(0, 240) t(i);
SELECT count(*) AS fact_rows FROM fact_sales;Задания
Заголовок раздела «Задания»1. Отчёт «Продажи за июнь» по району и бренду. Фильтры берите из dimension, числа из fact.
Решение
SELECT s.district, p.brand, sum(f.sales_amount) AS sales_dollarsFROM fact_sales fJOIN dim_store s USING (store_key)JOIN dim_product p USING (product_key)JOIN dim_date d USING (date_key)WHERE d.month_name = 'June'GROUP BY ALLORDER BY s.district, sales_dollars DESC;2. Atomic или агрегат. Создайте агрегат по бренду и месяцу. Проверьте, что сумма совпала с fact. Потом ответьте: можно ли из агрегата узнать продажи конкретного товара?
Решение
CREATE TABLE agg_sales_brand_month ASSELECT d.month_name, p.brand, sum(f.sales_amount) AS sales_amountFROM fact_sales fJOIN dim_product p USING (product_key)JOIN dim_date d USING (date_key)GROUP BY ALL;
-- обе суммы равныSELECT (SELECT sum(sales_amount) FROM fact_sales)         AS atomic_total,       (SELECT sum(sales_amount) FROM agg_sales_brand_month) AS agg_total;
Нет, товар из агрегата не достать. В агрегате остались только бренд и месяц. Atomic fact отвечает на любой вопрос, агрегат — только на заранее заданные.
3. Graceful extension. Добавьте в dim_product новый атрибут is_premium. Потом сгруппируйте продажи по нему. Fact не меняйте.
Решение
ALTER TABLE dim_product ADD COLUMN is_premium BOOLEAN;UPDATE dim_product SET is_premium = (brand = 'PowerClean');
SELECT p.is_premium, sum(f.sales_amount) AS sales_amountFROM fact_sales fJOIN dim_product p USING (product_key)GROUP BY p.is_premium;
Старые запросы работают как раньше. Данные не перезагружали.
4. Conformed dimensions и drill across. Создайте таблицу fact_forecast с grain «магазин × товар × неделя» (4 недели июня). Сравните план и факт по магазину. Агрегируйте каждый fact отдельно, потом соедините по общим ключам.
Решение
CREATE TABLE fact_forecast ASSELECT s.store_key, p.product_key, w.week_no,       75 * p.product_key AS forecast_amountFROM dim_store s CROSS JOIN dim_product p CROSS JOIN range(1, 5) w(week_no);
WITH actual AS (    SELECT store_key, product_key, sum(sales_amount) AS actual_amount    FROM fact_sales GROUP BY ALL), plan AS (    SELECT store_key, product_key, sum(forecast_amount) AS forecast_amount    FROM fact_forecast GROUP BY ALL)SELECT s.store_name,       sum(a.actual_amount)   AS actual,       sum(pl.forecast_amount) AS forecast,       round(sum(a.actual_amount) / sum(pl.forecast_amount), 2) AS actual_to_forecastFROM actual aJOIN plan pl USING (store_key, product_key)JOIN dim_store s USING (store_key)GROUP BY s.store_nameORDER BY s.store_name;
5. Ловушка. Соедините два fact напрямую и покажите, что суммы раздуваются. Затем объясните, почему drill across из задания 4 правильный.
Решение
-- неверно: каждая строка sales повторяется 4 раза, по числу недель планаSELECT sum(f.sales_amount) AS wrong_salesFROM fact_sales fJOIN fact_forecast fc USING (store_key, product_key);
SELECT sum(sales_amount) AS right_sales FROM fact_sales;
Прямая join двух fact даёт fan-out. Строка продаж размножается на каждую недельную строку плана. Поэтому сначала приводим fact к общему grain, потом соединяем.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему книга советует хранить atomic данные, а не только агрегаты?
- Чем presentation area отличается от back room? Кто к ним имеет доступ?
- В чём главное различие подходов Kimball и Inmon?
- Почему независимые data marts приводят к несходящимся цифрам?