

The Data Warehouse Toolkit, глава 2: Техники Kimball
Главная мысль: глава 2 — справочник всех техник Kimball. Её не читают подряд. К ней возвращаются, когда нужен приём: какой тип fact table выбрать, как хранить историю dimension, как назвать роли дат.
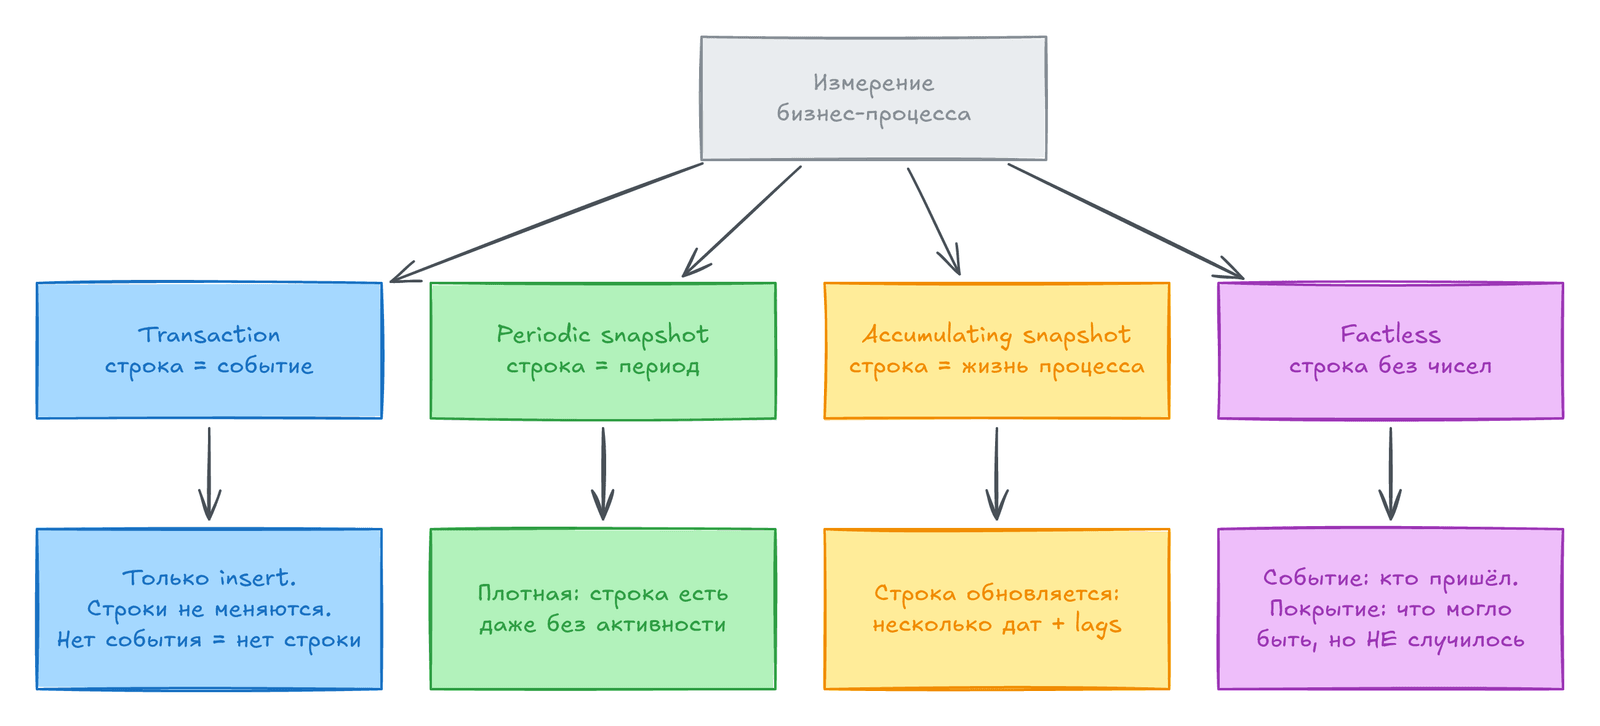
Фундамент
Заголовок раздела «Фундамент»Эти приёмы нужны в каждой модели.
| Техника | Суть |
|---|---|
| Требования и реальность данных | Сначала бизнес-цели, потом профилирование источников. Нужны оба |
| Workshops | Модель создают вместе с бизнесом. Моделер ведёт, но не работает один |
| Четыре шага | Business process, grain, dimensions, facts. В таком порядке |
| Grain | Что значит одна строка. Это контракт. Начинайте с atomic grain |
| Dimensions | Контекст: кто, что, где, когда, почему, как |
| Facts | Числа, согласованные с grain |
| Star schema и OLAP cube | Одна модель в реляционной БД или в кубе |
Один fact table — одно grain. Разные grain не смешиваем в одной таблице.
Типы fact tables
Заголовок раздела «Типы fact tables»| Тип | Что значит строка | Плотность | Обновления |
|---|---|---|---|
| Transaction | Одно событие в точке времени | Только когда было событие | Только вставки |
| Periodic snapshot | Состояние за период (день, месяц) | Строка есть всегда, даже при нулевой активности | Вставки |
| Accumulating snapshot | Один процесс от начала до конца | Одна строка на процесс | Строка обновляется по ходу процесса |
| Factless | Событие или покрытие без чисел | По событиям | Вставки |
Дополнительно:
Aggregate fact table— агрегат для скорости. Работает как индекс: BI-инструмент выбирает его сам. Ссылается на shrunken dimensions.Consolidated fact table— факты из разных процессов на одном grain. Например, план и факт вместе. Дороже в ETL, дешевле для аналитика.- Factless бывает двух видов: событие без чисел (студент пришёл на лекцию) и coverage (всё, что могло случиться). Разность «coverage минус события» даёт то, чего не было.
Типы фактов
Заголовок раздела «Типы фактов»| Тип | Суммируется | Пример |
|---|---|---|
| Additive | По всем dimensions | Продано штук |
| Semi-additive | Не по времени | Остаток на счёте |
| Non-additive | Нет | Процент, цена. Храните числитель и знаменатель |
Другие правила:
NULLв факте допустим.NULLв foreign key нельзя. Заведите в dimension строку «Unknown».Conformed facts: если метрика есть в двух fact, определение одно и то же. Если определения разные, называйте метрики по-разному.
Техники для dimensions
Заголовок раздела «Техники для dimensions»Структура и ключи
Заголовок раздела «Структура и ключи»- Dimension — широкая плоская денормализованная таблица. Много текстовых атрибутов.
- Первичный ключ —
surrogate key. Это целое число без смысла. Natural key из источника не подходит: при истории будет несколько строк на один natural key, а ключи разных систем несовместимы. Durable key(supernatural key) — ключ, который не меняется, даже если сущность переехала из одной системы в другую.Degenerate dimension— номер документа в fact table без отдельной таблицы.- Иерархии кладём в одну таблицу (
denormalized flattened). Несколько иерархий в одной dimension — нормально. - Флаги
Y/Nзаменяем понятным текстом:Rush order, а неY. NULLв атрибутах dimension заменяем на «Unknown» или «N/A». Тогда фильтры и группы работают одинаково.
Calendar date dimension
Заголовок раздела «Calendar date dimension»Строим один раз. Атрибуты: день недели, месяц, квартал, праздник, fiscal period. Smart key вида 20240131 допустим только для date dimension.
Role-playing dimension
Заголовок раздела «Role-playing dimension»Одна физическая dimension используется несколько раз в одном fact с разными ролями. Классический пример — даты: order date, ship date, delivery date.
- Таблица одна. В запросе — несколько alias.
- Удобно сделать view на каждую роль с переименованными колонками.
Junk dimension
Заголовок раздела «Junk dimension»Много мелких флагов и кодов (тип оплаты, канал, срочность) не нужны как отдельные таблицы. Их комбинации складывают в одну junk dimension. В fact остаётся один ключ.
- Строим из реально встречающихся комбинаций или из всех возможных, если их мало.
- Альтернатива хуже: десятки колонок-флагов в fact table.
Snowflake и outrigger
Заголовок раздела «Snowflake и outrigger»- Snowflake: dimension нормализована в подтаблицы. Книга не рекомендует.
Outrigger— подчинённая dimension, на которую ссылается другая dimension. Допустима как исключение. Пример: дата первой покупки клиента.
Conformed и shrunken dimensions
Заголовок раздела «Conformed и shrunken dimensions»Conformed dimension— общая для нескольких fact. Одинаковые ключи, названия, значения.Shrunken dimension— урезанная версия: подмножество атрибутов (месяц вместо дня) или строк. Нужна для агрегатов.Drill across— запрос, который берёт числа из разных fact и объединяет по общим атрибутам conformed dimensions. Каждый fact агрегируем отдельно.Bus matrix— таблица: строки — бизнес-процессы, колонки — conformed dimensions. План всего хранилища.Detailed implementation bus matrix— та же матрица, но строка — отдельный fact table с grain и фактами.Opportunity/stakeholder matrix— строки — процессы, колонки — отделы. Показывает, кому нужен каждый процесс.Value chain— цепочка процессов компании (закупка → склад → продажа). У каждого процесса свой fact table.
Slowly Changing Dimensions
Заголовок раздела «Slowly Changing Dimensions»Атрибуты dimension иногда меняются. Для каждого атрибута выбираем тип.
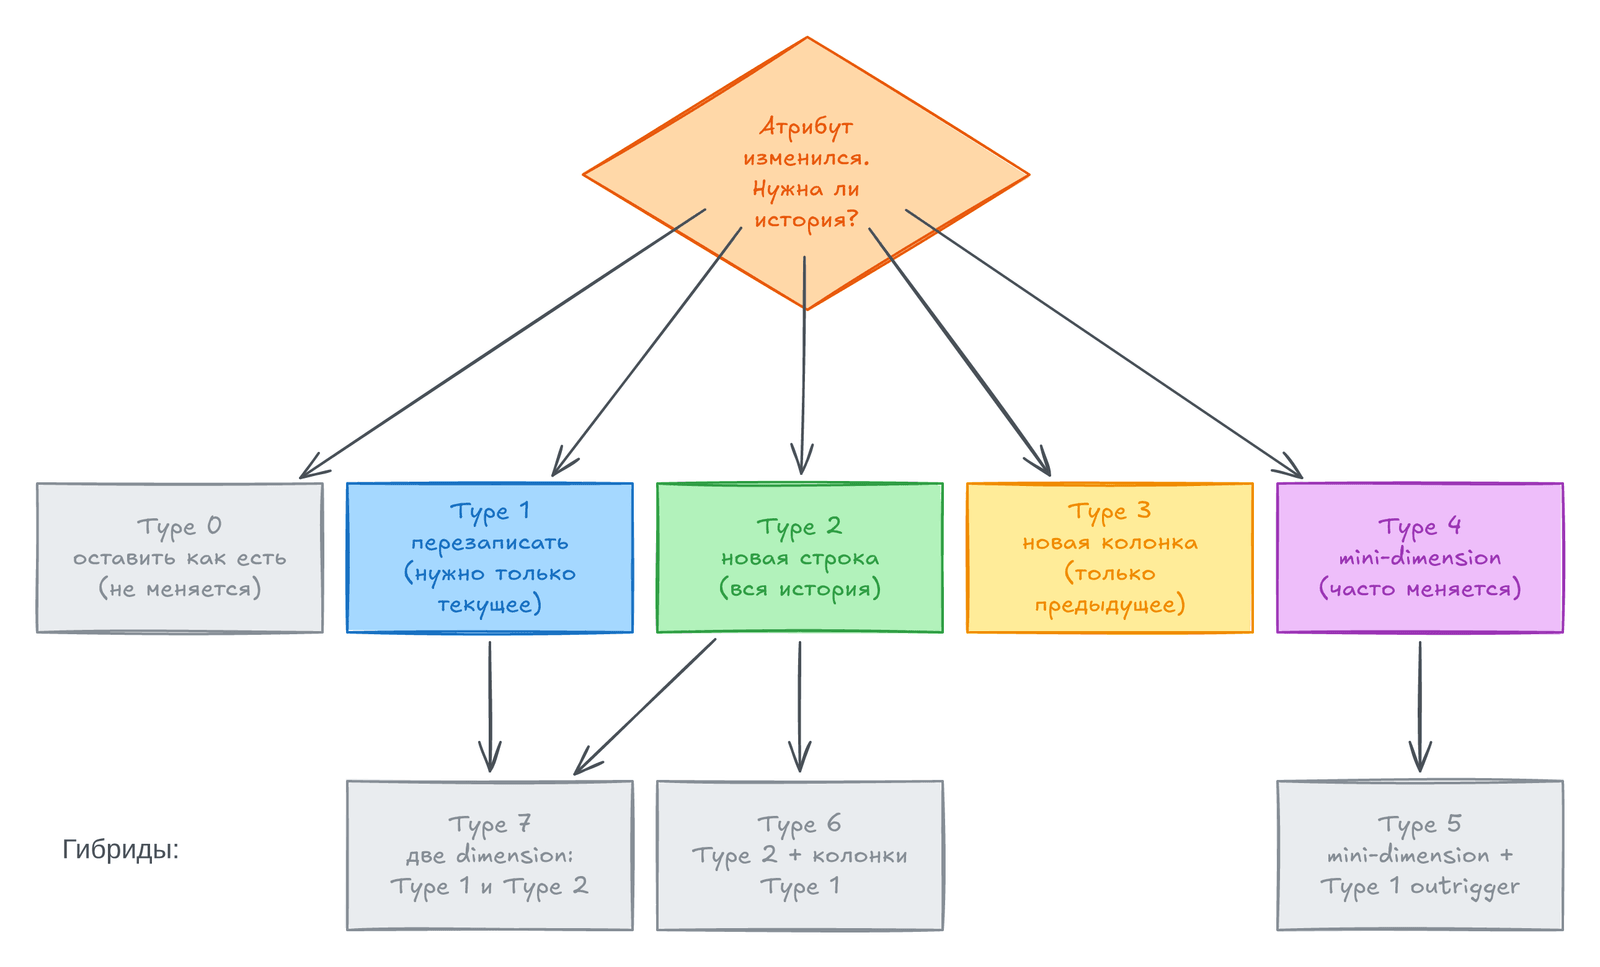
| Тип | Что делаем | История | Пример |
|---|---|---|---|
| 0 | Оставляем исходное значение | Нет, значение фиксировано | Дата первой покупки |
| 1 | Перезаписываем | Нет | Исправили опечатку в имени |
| 2 | Добавляем новую строку | Полная | Клиент переехал в другой город |
| 3 | Добавляем колонку «предыдущее значение» | Только одна смена | Старый и новый регион |
| 4 | Выносим быстро меняющиеся атрибуты в mini-dimension | Через fact | Возрастная группа, доход |
| 5 | Type 4 плюс Type 1 outrigger | Текущий профиль + история | Профиль клиента |
| 6 | Type 2 строка с Type 1 колонкой «текущее значение» | Обе | Историческая и текущая категория |
| 7 | В fact два ключа: surrogate key (Type 2) и durable key (ведёт к view текущих строк) | Обе | Отчёт «как было» или «как сейчас» на выбор |
Типы 5, 6, 7 — гибриды. Они нужны редко. Подробно их разбирает глава 5.
Для Type 2 добавляем в dimension служебные колонки:
row_effective_date,row_expiration_date;is_current.
Fact хранит surrogate key той версии dimension, которая действовала в момент события.
В книге row_expiration_date — день перед стартом следующей версии. В практике ниже мы используем полуоткрытый интервал: дата окончания равна дате начала следующей версии, а в join стоит <. Оба варианта рабочие. Главное — один стиль во всём хранилище.
Иерархии
Заголовок раздела «Иерархии»| Вид | Как моделировать |
|---|---|
| Фиксированная глубина | Колонки в dimension: category, subcategory, product |
| Слегка рваная | Те же колонки, пустые уровни заполняем |
| Рваная произвольной глубины | Bridge table между dimension и fact или колонка pathstring |
Продвинутые техники fact
Заголовок раздела «Продвинутые техники fact»| Техника | Суть |
|---|---|
| Header/line | Заголовок и строки документа. Заголовочные суммы раскладываем по строкам (глава 6) |
| Allocated facts | Распределение общих сумм (доставка) по строкам |
| Lag/duration facts | Разница между датами храним числом |
| Multiple currency | Сумма в местной и в единой валюте |
| Multiple units of measure | Несколько единиц измерения в одной строке |
| Year-to-date | Не храните YTD. Считайте в BI |
| Late arriving facts | Факт пришёл поздно. Ищем версию dimension на дату события |
| Fact table surrogate key | Нужен для надёжного перезапуска ETL и для обновлений |
| Centipede fact | Слишком много foreign keys (десятки). Признак ошибки: объединяйте dimensions |
| Числа как атрибут или факт | Если число в основном фильтруют и группируют — это атрибут. Если суммируют — факт. Иногда нужно и то, и другое |
| Multipass SQL | Не соединяем два fact напрямую. Каждый агрегируем отдельно, потом объединяем (drill across) |
| Timespan tracking | Строка fact с датами начала и конца действия. Позволяет узнать состояние на любую дату |
Продвинутые техники dimension
Заголовок раздела «Продвинутые техники dimension»Multivalued dimensionиbridge table: у одной строки fact несколько значений dimension (счёт с двумя владельцами).Behavior tag,study group: метки поведения клиента вынесены в dimension.Aggregated facts as attributes: «выручка клиента за год» как атрибут для сегментации.Dynamic value bands: диапазоны сумм в отдельной dimension.Late arriving dimension: факт пришёл, а строки в dimension ещё нет. Создаём заглушку и обновляем позже.Audit dimension: метаданные загрузки (ETL batch, качество строки) в dimension.Hot swappable dimension: разные наборы атрибутов для разных групп пользователей.Multiple time zones: храним время в местной зоне и в UTC.Step dimension: номер шага в сессии или процессе (шаг 3 из 7).Text comments dimension: свободный текст выносим в отдельную dimension, а не в fact.Measure type dimensionиabstract generic dimension: одна колонка «значение» плюс тип метрики, или одна dimension на всё подряд. Книга советует избегать: запросы становятся сложными.
Special purpose schemas
Заголовок раздела «Special purpose schemas»Supertype/subtype: разные виды продуктов с разным набором атрибутов (банковские счета).Real-time fact tables: горячий раздел для свежих данных.Error event schema: события ошибок качества данных пишем в свою схему.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Role-playing dimension | Одна dimension в нескольких ролях |
| Junk dimension | Флаги и коды в одной таблице |
| SCD | Slowly changing dimension: способ хранить изменения атрибутов |
| Conformed dimension | Общая dimension для нескольких fact |
| Drill across | Объединение метрик из разных fact |
| Bus matrix | План: процессы против dimensions |
| Bridge table | Связь многие-ко-многим между fact и dimension |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для каждого атрибута dimension запишите тип SCD. Не для всей таблицы.
- В
dbtType 2 — этоsnapshot. Он ведётdbt_valid_fromиdbt_valid_to. - Не держите флаги в fact: сделайте junk dimension.
- Не храните YTD и проценты. Считайте их в запросе.
- Для каждой роли даты делайте отдельный view:
dim_order_date,dim_ship_date.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку в одной сессии. Не пропускайте задания: каждое меняет таблицы для следующего.
Шаг 1. Создаём схему
Заголовок раздела «Шаг 1. Создаём схему»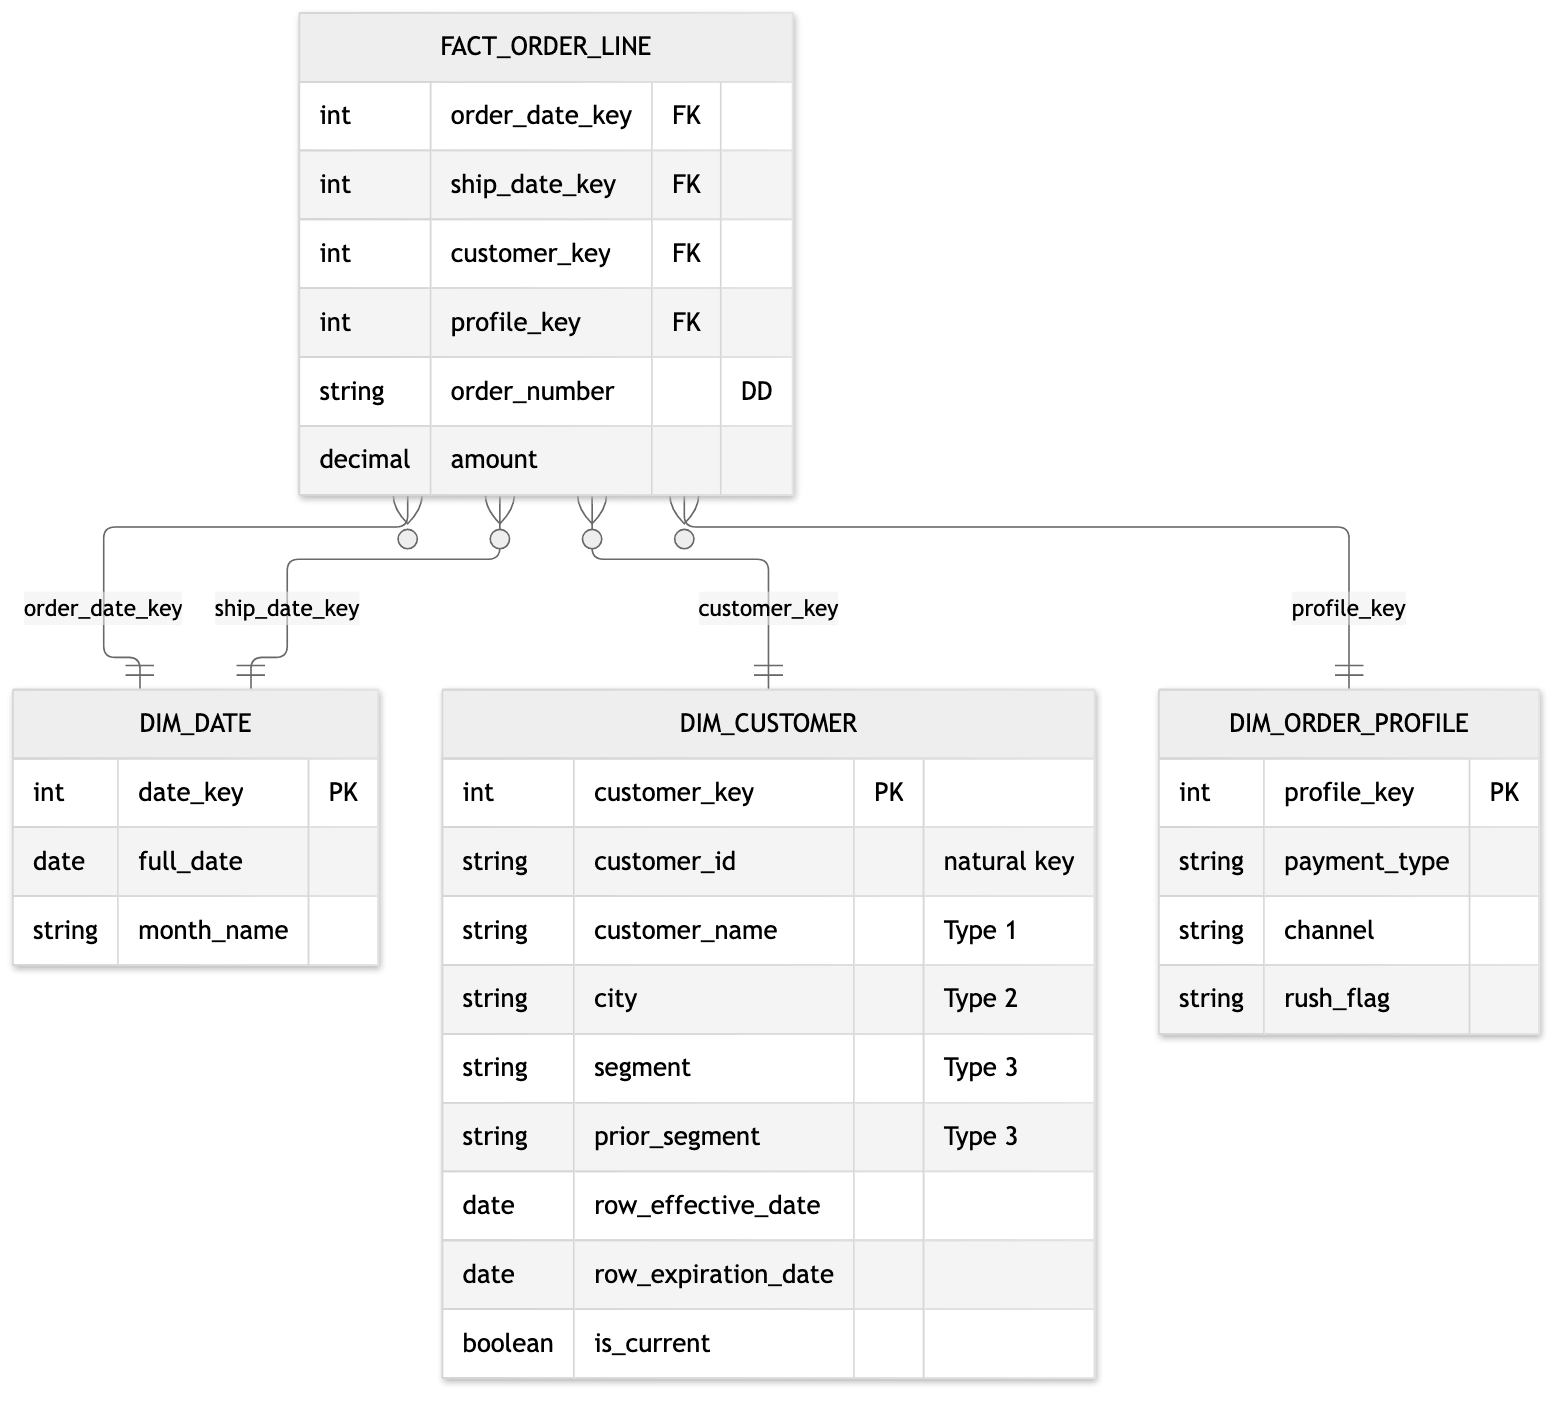
CREATE TABLE dim_date ASSELECT    strftime(d, '%Y%m%d')::INT AS date_key,    d::DATE AS full_date,    monthname(d) AS month_nameFROM generate_series(DATE '2024-01-01', DATE '2024-06-30', INTERVAL 1 DAY) t(d);
-- SCD: city = Type 2, customer_name = Type 1, segment = Type 3 (prior_segment)CREATE TABLE dim_customer ASSELECT * FROM (VALUES    (1, 'C1', 'Анна Смирнова', 'Москва', 'Retail', NULL::VARCHAR, DATE '2024-01-01', DATE '9999-12-31', true),    (2, 'C2', 'Борис Иванов',  'Казань', 'Retail', NULL::VARCHAR, DATE '2024-01-01', DATE '9999-12-31', true),    (3, 'C3', 'Вера Петрова',  'Казань', 'Retail', NULL::VARCHAR, DATE '2024-01-01', DATE '9999-12-31', true)) t(customer_key, customer_id, customer_name, city, segment, prior_segment,    row_effective_date, row_expiration_date, is_current);
-- новый срез из источника на 2024-03-01CREATE TABLE stg_customer ASSELECT * FROM (VALUES    ('C1', 'Анна Смирнова',        'Москва', 'Corporate'),  -- segment изменился    ('C2', 'Борис Иванов',         'Москва', 'Retail'),     -- city изменился    ('C3', 'Вера Петрова-Сидорова','Казань', 'Retail')      -- имя исправлено) t(customer_id, customer_name, city, segment);
-- junk dimension: комбинации флагов заказаCREATE TABLE dim_order_profile ASSELECT * FROM (VALUES    (1, 'Карта',    'Сайт',  'Обычный'),    (2, 'Карта',    'Сайт',  'Срочный'),    (3, 'Наличные', 'Офлайн','Обычный'),    (4, 'Наличные', 'Офлайн','Срочный')) t(profile_key, payment_type, channel, rush_flag);
-- grain: одна строка заказа. Две роли даты: order и shipCREATE TABLE fact_order_line ASSELECT    strftime(order_date, '%Y%m%d')::INT AS order_date_key,    strftime(ship_date,  '%Y%m%d')::INT AS ship_date_key,    customer_key, profile_key, order_number, amountFROM (VALUES    ('O1', DATE '2024-01-10', DATE '2024-01-12', 1, 1, 100),    ('O2', DATE '2024-01-15', DATE '2024-01-20', 2, 3, 200),    ('O3', DATE '2024-02-05', DATE '2024-02-07', 2, 2, 150),    ('O4', DATE '2024-02-27', DATE '2024-03-02', 3, 1,  80)) t(order_number, order_date, ship_date, customer_key, profile_key, amount);
Задания
Заголовок раздела «Задания»1. Type 1. Исправьте имя клиента из stg_customer. История не нужна: просто перезапишите значение в текущей строке.
Решение
UPDATE dim_customer dSET customer_name = s.customer_nameFROM stg_customer sWHERE d.customer_id = s.customer_id  AND d.is_current  AND d.customer_name <> s.customer_name;
SELECT customer_key, customer_id, customer_name FROM dim_customer ORDER BY 1;
Изменилась только строка C3. Ключ остался прежним, поэтому старые факты видят новое имя.
2. Type 2. Клиент C2 переехал. Закройте старую строку датой 2024-03-01 и добавьте новую версию с новым surrogate key.
Решение
-- 1) закрываем старую версиюUPDATE dim_customer dSET row_expiration_date = DATE '2024-03-01', is_current = falseFROM stg_customer sWHERE d.customer_id = s.customer_id  AND d.is_current  AND d.city <> s.city;
-- 2) вставляем новую версию для тех, у кого нет текущей строкиINSERT INTO dim_customerSELECT (SELECT max(customer_key) FROM dim_customer)         + row_number() OVER (ORDER BY s.customer_id),       s.customer_id, s.customer_name, s.city, s.segment, NULL::VARCHAR,       DATE '2024-03-01', DATE '9999-12-31', trueFROM stg_customer sWHERE NOT EXISTS (    SELECT 1 FROM dim_customer d    WHERE d.customer_id = s.customer_id AND d.is_current);
SELECT customer_key, customer_id, city, row_effective_date, row_expiration_date, is_currentFROM dim_customer ORDER BY customer_id, customer_key;
У C2 теперь две строки: Казань (ключ 2, закрыта) и Москва (ключ 4, текущая).
3. Type 3. У клиента C1 сменился segment. Сохраните прошлое значение в колонке prior_segment.
Решение
UPDATE dim_customer dSET prior_segment = d.segment,    segment = s.segmentFROM stg_customer sWHERE d.customer_id = s.customer_id  AND d.is_current  AND d.segment <> s.segment;
SELECT customer_id, segment, prior_segment FROM dim_customer WHERE is_current ORDER BY 1;
4. Загрузка новых fact. Добавьте три заказа за март и апрель (O5–O7, данные в решении). Для каждого найдите версию клиента, действовавшую на дату заказа. Потом покажите выручку по городам.
Решение
INSERT INTO fact_order_lineSELECT strftime(o.order_date, '%Y%m%d')::INT,       strftime(o.ship_date,  '%Y%m%d')::INT,       c.customer_key, o.profile_key, o.order_number, o.amountFROM (VALUES    ('O5', DATE '2024-03-10', DATE '2024-03-12', 'C2', 1, 300),    ('O6', DATE '2024-04-02', DATE '2024-04-03', 'C2', 4, 120),    ('O7', DATE '2024-04-08', DATE '2024-04-12', 'C1', 2,  90)) o(order_number, order_date, ship_date, customer_id, profile_key, amount)JOIN dim_customer c  ON c.customer_id = o.customer_id AND o.order_date >= c.row_effective_date AND o.order_date <  c.row_expiration_date;
SELECT c.city, sum(f.amount) AS revenueFROM fact_order_line fJOIN dim_customer c USING (customer_key)GROUP BY c.cityORDER BY c.city;
Заказы C2 до марта остались за Казанью. Заказы после — за Москвой. Это и есть смысл Type 2.
5. Role-playing и junk dimension. Покажите по месяцу заказа и месяцу отгрузки количество заказов и средний срок отгрузки в днях. Затем посчитайте выручку по типу оплаты и срочности.
Решение
SELECT od.month_name AS order_month,       sd.month_name AS ship_month,       count(*)      AS orders,       avg(sd.full_date - od.full_date) AS avg_ship_daysFROM fact_order_line fJOIN dim_date od ON od.date_key = f.order_date_key   -- роль: order dateJOIN dim_date sd ON sd.date_key = f.ship_date_key    -- роль: ship dateGROUP BY ALLORDER BY min(od.full_date);
SELECT p.payment_type, p.rush_flag, sum(f.amount) AS revenueFROM fact_order_line fJOIN dim_order_profile p USING (profile_key)GROUP BY ALLORDER BY revenue DESC;
Заказ O4 сделан в феврале, а отправлен в марте. Одна dimension в двух ролях показывает это.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Когда выбрать periodic snapshot, а когда transaction fact table?
- Почему natural key не годится как primary key dimension?
- Как выбрать между SCD Type 1, 2 и 3 для атрибута «город клиента»?
- Зачем junk dimension, если можно оставить флаги в fact?