

Designing Data-Intensive Applications, глава 4: Кодирование и эволюция схем
Главная мысль: приложения меняются, а старые и новые версии кода и данных работают одновременно. Формат кодирования должен поддерживать совместимость в обе стороны.
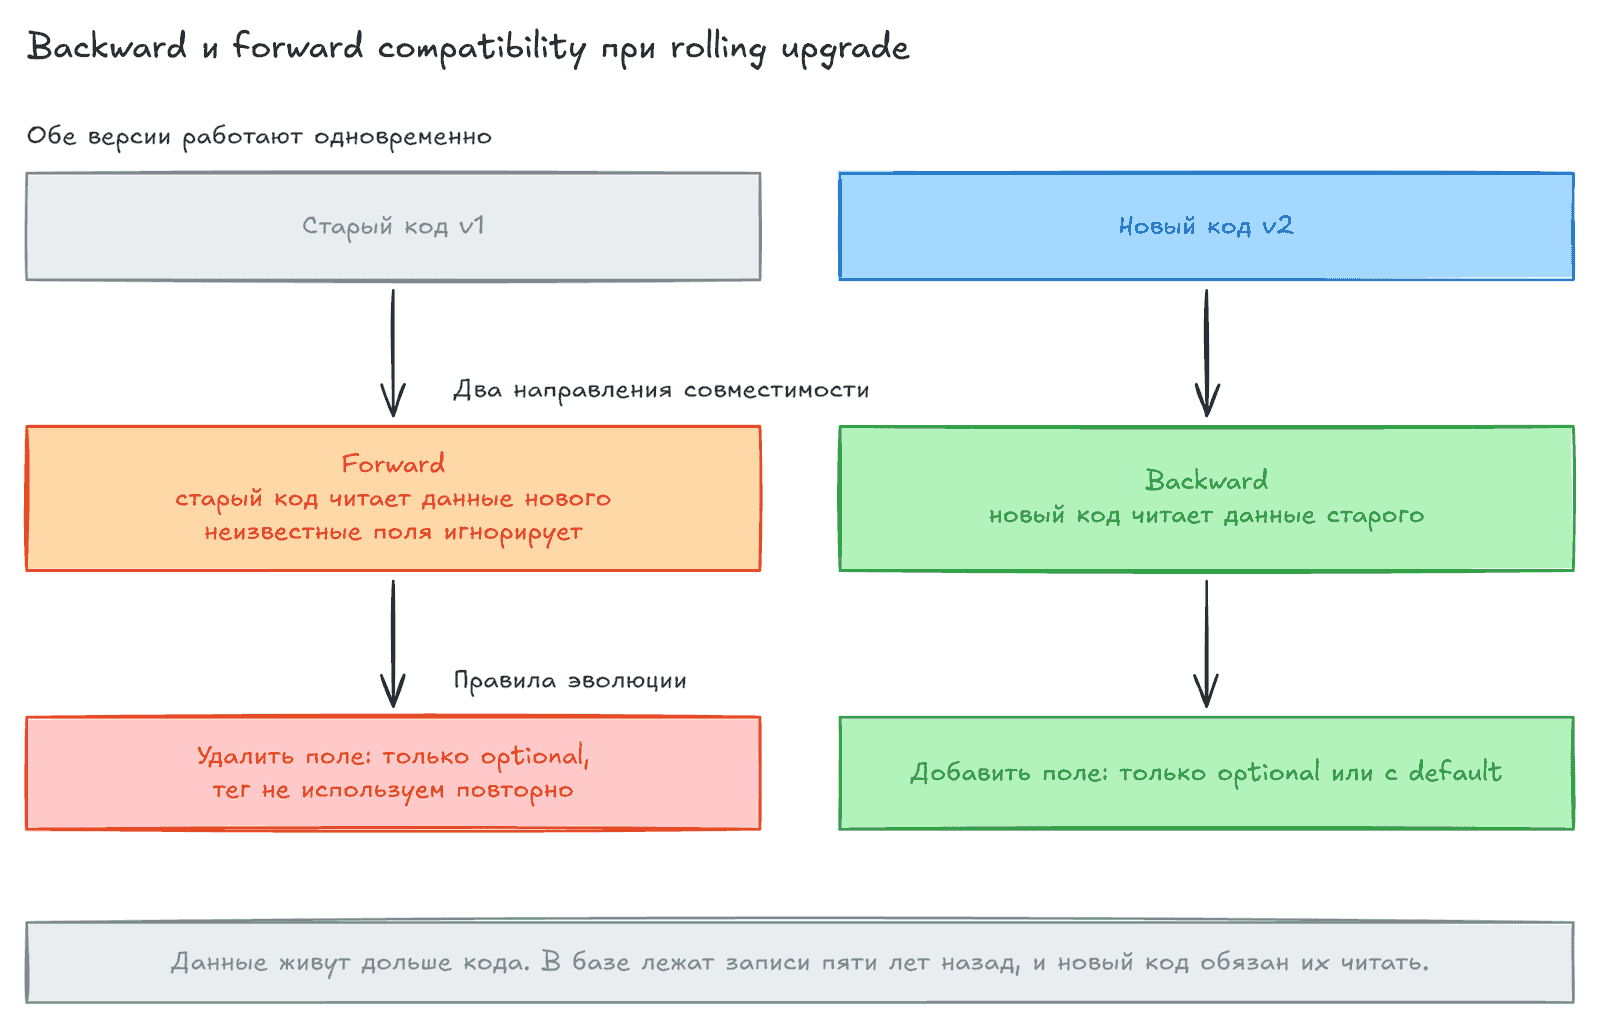
Совместимость
Заголовок раздела «Совместимость»При rolling upgrade (постепенное обновление узлов) и в клиентских приложениях разные версии работают вместе.
- Backward compatibility: новый код читает данные, записанные старым кодом. Обычно это легко.
- Forward compatibility: старый код читает данные, записанные новым. Сложнее: старый код должен игнорировать то, чего не знает.
Программа держит данные в памяти как объекты и указатели. Для файла или сети нужны байты. Перевод в байты это encoding (serialization), обратный это decoding. Это не шифрование.
Форматы кодирования
Заголовок раздела «Форматы кодирования»Форматы языка (Java Serializable, pickle, Kryo) удобны, но привязывают к языку, небезопасны (декодирование создаёт произвольные классы), плохо работают с версиями и неэффективны. Используйте их только для временных задач.
JSON, XML, CSV это текстовые форматы. Они широко поддерживаются, поэтому подходят для обмена между организациями. Проблемы:
- Числа неоднозначны. JSON не различает integer и float. Целые больше 2^53 теряют точность в JavaScript (пример: 64-битные ID твитов).
- Нет бинарных строк. Обходят через Base64.
- Схема опциональна и сложна. CSV вообще без схемы, а правила экранирования реализуют не все.
- Бинарные варианты JSON (MessagePack, BSON) почти не экономят место: в примере 66 байт против 81, потому что имена полей остаются.
Схемные бинарные форматы
Заголовок раздела «Схемные бинарные форматы»| Формат | Идентификация поля | Размер примера | Особенности |
|---|---|---|---|
| JSON (текст) | Имя поля | 81 байт | Читается человеком, схемы нет |
| MessagePack | Имя поля | 66 байт | Бинарный JSON |
| Thrift BinaryProtocol | Номер тега | 59 байт | Нужна IDL-схема и генерация кода |
| Thrift CompactProtocol | Номер тега | 34 байта | Тип и тег в одном байте, varint |
| Protocol Buffers | Номер тега | 33 байта | Похож на Compact, поле repeated вместо списка |
| Avro | Порядок полей в схеме | 32 байта | Нет тегов и типов в данных |
Эволюция схемы: Thrift и Protocol Buffers
Заголовок раздела «Эволюция схемы: Thrift и Protocol Buffers»Запись это набор полей с тегом и типом. Пустое поле просто не записывается.
- Имя поля менять можно. Номер тега менять нельзя.
- Новое поле: новый тег. Оно должно быть optional или иметь default. Тогда и старый код его игнорирует, и новый читает старые данные.
- Удалять можно только optional поле. Номер тега нельзя использовать повторно.
- Смена типа рискованна: 32-битное число в 64-битное. Старый код может обрезать значение.
- В Protocol Buffers можно сделать optional поле repeated.
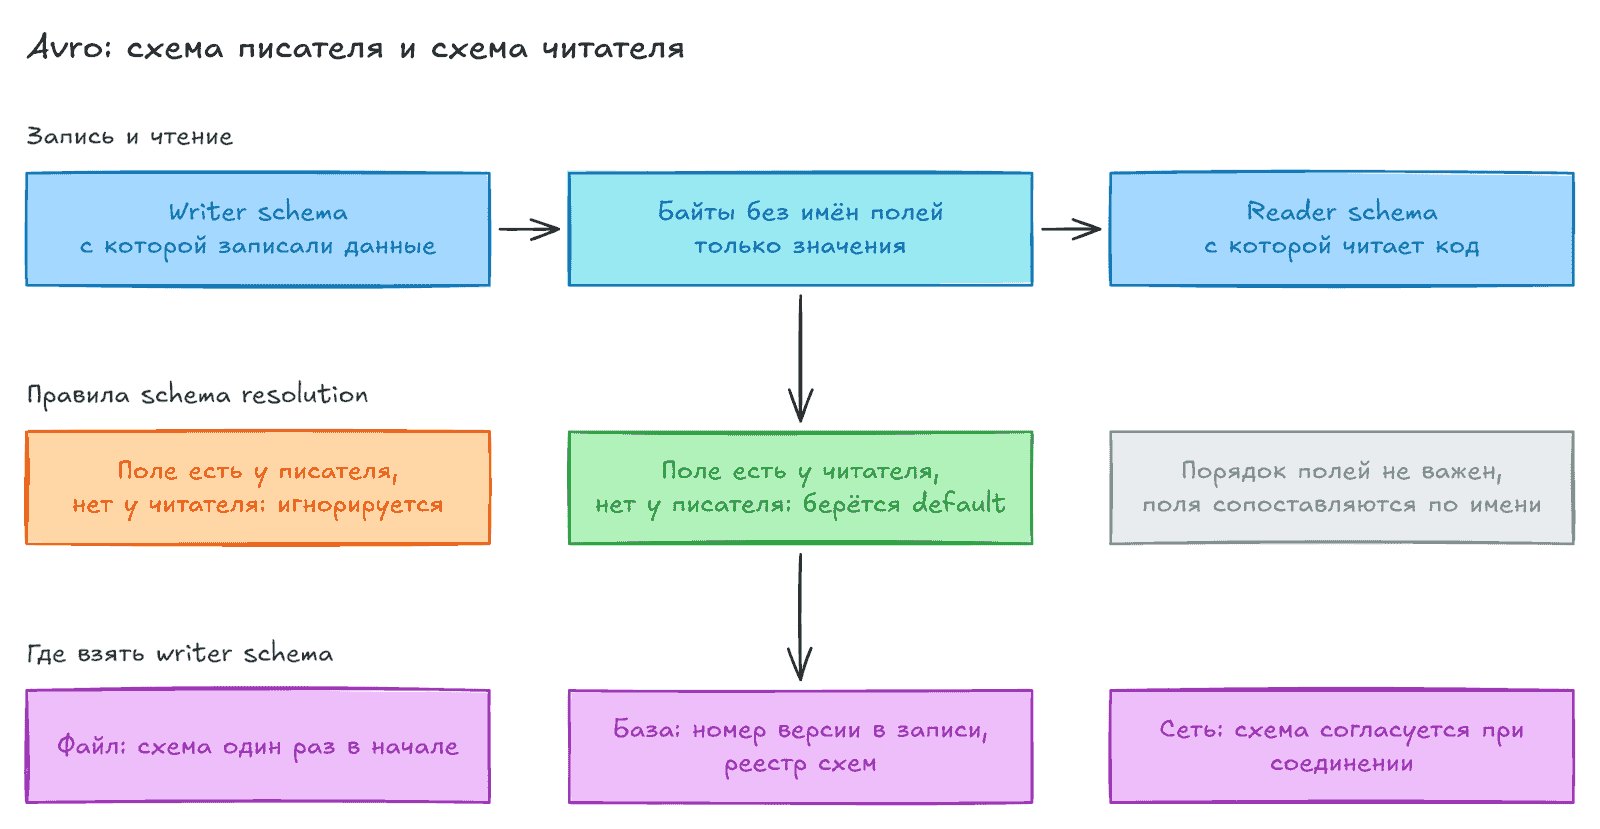
В Avro нет номеров тегов. Данные это просто значения подряд. Прочитать их можно только со схемой.
Writer schema и reader schema не обязаны совпадать, только быть совместимы. Библиотека сравнивает их при чтении:
- Порядок полей не важен, поля сопоставляются по имени.
- Поле есть у писателя, нет у читателя: игнорируется.
- Поле есть у читателя, нет у писателя: подставляется default.
- Добавлять и удалять можно только поле с default.
- null допустим только через union, например
union { null, long }. - Смена имени поля возможна через aliases (только backward).
Где взять writer schema:
- Большой файл: схема один раз в начале (object container file).
- База с отдельными записями: номер версии в начале записи и реестр схем.
- Сеть: схема согласуется при соединении.
Dynamically generated schemas. Avro удобен, когда схема строится автоматически, например из таблиц реляционной базы. Колонки становятся полями. При изменении таблицы просто генерируется новая схема. С Thrift и Protobuf теги пришлось бы назначать вручную.
Плюсы схемных форматов:
- Компактнее бинарного JSON.
- Схема это актуальная документация.
- Реестр схем позволяет проверять совместимость до деплоя.
- Кодогенерация даёт проверку типов в статических языках.
Потоки данных
Заголовок раздела «Потоки данных»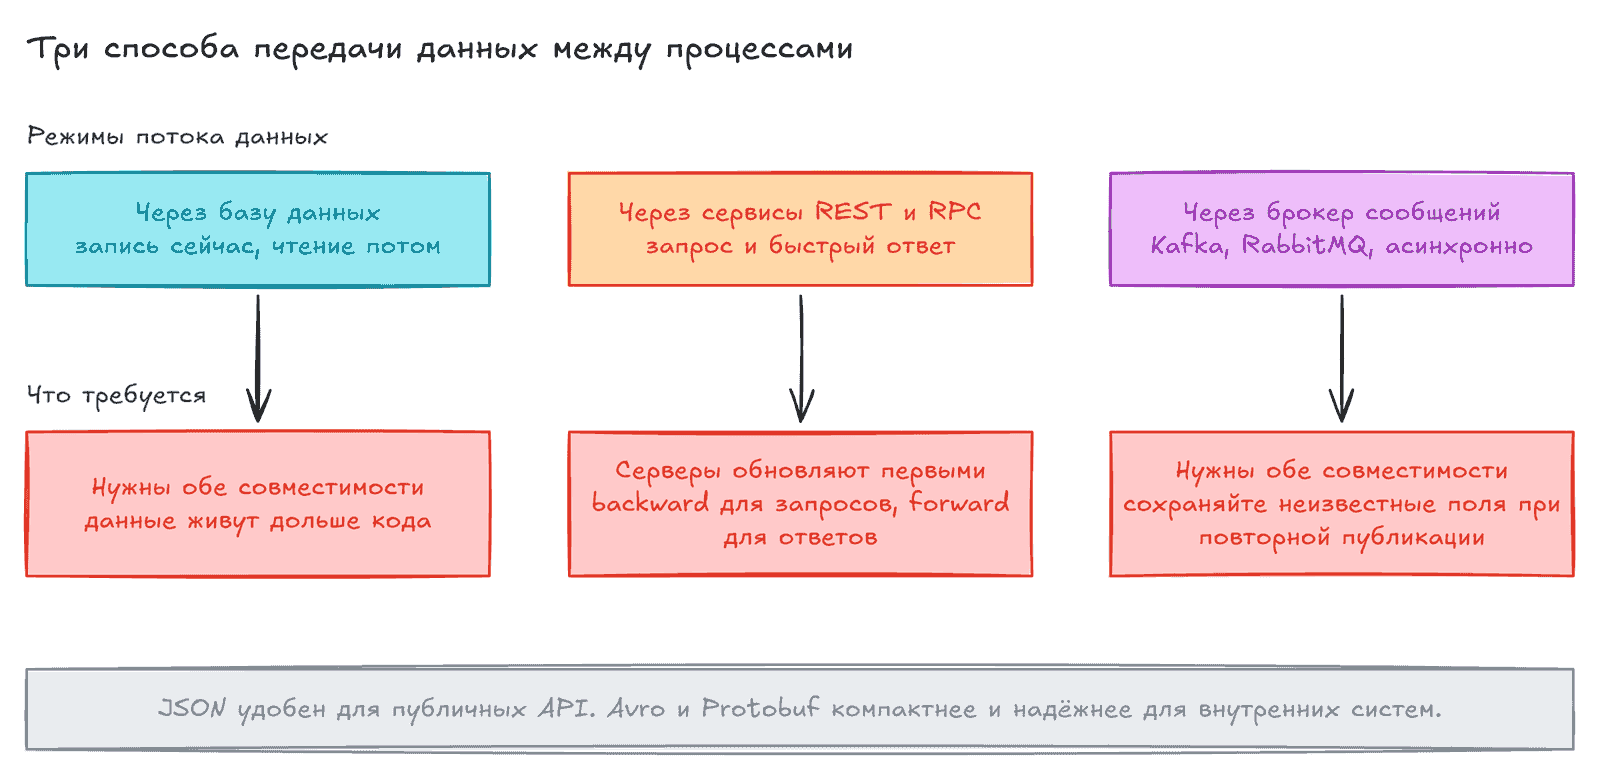
Через базу данных
Заголовок раздела «Через базу данных»Запись в базу это сообщение будущему себе. Нужны обе совместимости: часть процессов работает на старом коде.
- Потеря неизвестных полей. Старый код читает запись, меняет одно поле и пишет обратно. Новое поле может пропасть, если модель в коде его не знает.
- Data outlives code. Код меняется за минуты, а данные пятилетней давности остаются. Миграция больших таблиц дорога. Поэтому реляционные базы добавляют колонку с null без переписывания данных.
- Archival storage. Дамп для бэкапа или warehouse лучше писать в последней схеме. Подходят Avro и колоночные форматы вроде Parquet.
Через сервисы: REST и RPC
Заголовок раздела «Через сервисы: REST и RPC»- Web service это сервис по HTTP. REST это стиль на основе HTTP: URL, кэш, простые форматы. SOAP это XML-протокол с WSDL и множеством стандартов WS-*, сложный и зависящий от инструментов.
- RPC пытается сделать удалённый вызов похожим на локальный. Это ошибка. Сеть ненадёжна: возможен timeout без ответа, повторный запрос может выполнить действие дважды (нужна idempotence), задержка непредсказуема, типы данных различаются между языками.
- Современные RPC (gRPC, Thrift, Finagle, Rest.li) честно показывают, что вызов удалённый: futures, потоки.
- REST чаще для публичных API. RPC чаще между внутренними сервисами.
- Эволюция: обычно серверы обновляют первыми. Нужна backward compatibility для запросов и forward для ответов.
- Публичный API нельзя ломать, поэтому живут несколько версий. Версию указывают в URL, в заголовке Accept или на стороне сервера по API-ключу.
Через брокер сообщений
Заголовок раздела «Через брокер сообщений»Брокер (Kafka, RabbitMQ, ActiveMQ, NATS) хранит сообщение временно. Это что-то среднее между RPC и базой.
- Буфер при перегрузке получателя.
- Повторная доставка после сбоя.
- Отправитель не знает адрес получателя.
- Одно сообщение нескольким получателям.
- Отправитель и получатель независимы. Ответа обычно нет: это асинхронность.
Брокер не навязывает формат: сообщение это байты. Используйте совместимый формат. Если consumer публикует сообщения дальше, сохраняйте неизвестные поля.
Distributed actor frameworks (Akka, Orleans, Erlang OTP) соединяют брокер и модель акторов. При rolling upgrade совместимость тоже нужна. Сериализацию по умолчанию часто нужно заменить, например на Protocol Buffers.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Encoding / decoding | Перевод структур памяти в байты и обратно |
| Backward compatibility | Новый код читает старые данные |
| Forward compatibility | Старый код читает новые данные |
| Rolling upgrade | Постепенное обновление узлов без простоя |
| Schema evolution | Изменение схемы с сохранением совместимости |
| Field tag | Номер поля в Thrift и Protobuf |
| Writer / reader schema | Схема записи и схема чтения в Avro |
| Varint | Число переменной длины в байтах |
| Union type | Тип, допускающий несколько вариантов, например null и long |
| REST / RPC | Стиль API поверх HTTP и вызов удалённой процедуры |
| Idempotence | Повторный запрос не меняет результат |
| Message broker | Посредник, который временно хранит сообщения |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для событий и топиков Kafka используйте Avro или Protobuf со schema registry. Включайте проверку совместимости до деплоя.
- Новые поля делайте optional или с default. Не меняйте и не переиспользуйте теги и не удаляйте поля без default.
- Выгружайте данные из баз в Avro или Parquet. Схему генерируйте из таблицы.
- Следите за тем, чтобы ETL и consumers не теряли неизвестные поля при перезаписи.
- Для внешних API подходит JSON. Для внутренних систем лучше схемные форматы. Учитывайте проблему больших чисел в JSON.
- Делайте повторные запросы idempotent: в сети повтор и потеря ответа обычны.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем backward compatibility отличается от forward compatibility? Какая сложнее и почему?
- Почему в Protocol Buffers нельзя менять номер тега, а в Avro можно обойтись без тегов?
- Что такое writer schema и reader schema, и как reader узнаёт writer schema в базе?
- Почему RPC нельзя считать обычным вызовом функции?
Предыдущая: Хранение и извлечение. Следующая: Репликация.