

Designing Data-Intensive Applications, глава 1: Надёжность, масштабируемость, сопровождаемость
Главная мысль: хорошая система данных надёжна, масштабируема и сопровождаема. Эти слова нужно измерять и обсуждать на конкретных числах, а не на ощущениях.
Data-intensive приложения
Заголовок раздела «Data-intensive приложения»Большинство современных приложений ограничены не мощностью CPU, а объёмом, сложностью и скоростью изменения данных. Их собирают из стандартных блоков:
- базы данных (
database): хранят данные; - кэши (
cache): помнят результат дорогой операции; - поисковые индексы (
search index): поиск по ключевым словам и фильтры; - потоковая обработка (
stream processing): асинхронные сообщения; - пакетная обработка (
batch processing): периодический разбор больших объёмов данных.
Границы между категориями размываются. Redis работает как хранилище и как очередь. Kafka даёт гарантии сохранности, как база данных.
Часто одного инструмента мало. Тогда вы соединяете несколько (например, основную базу, кэш и Elasticsearch). Код приложения должен держать их в синхронизации. Так вы становитесь проектировщиком новой системы данных.
Reliability: надёжность
Заголовок раздела «Reliability: надёжность»Надёжность значит: система продолжает работать правильно, даже когда что-то идёт не так.
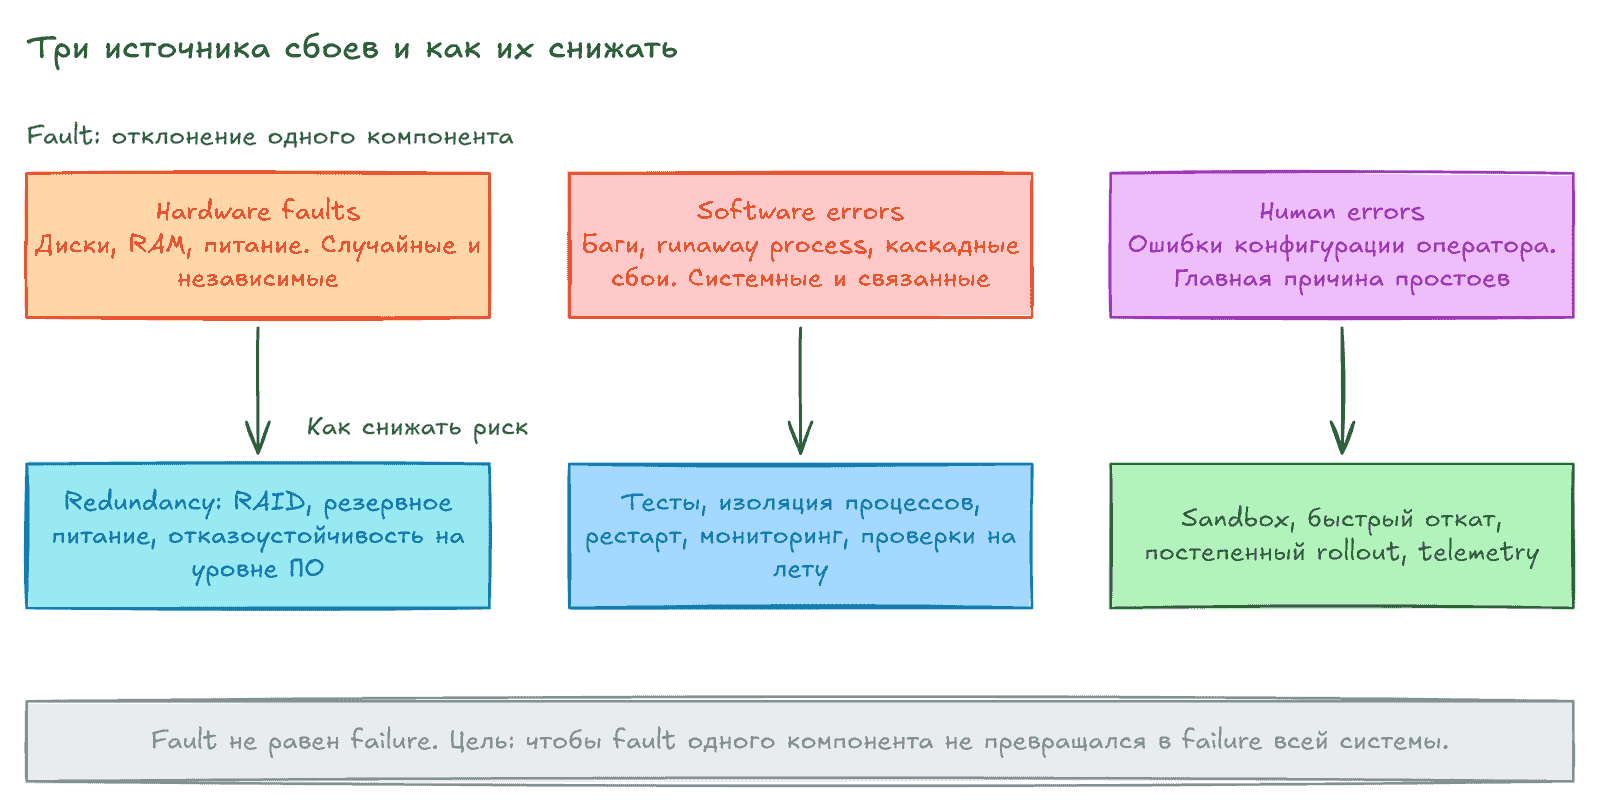
Fault — отклонение одного компонента от спецификации. Failure — когда вся система перестала обслуживать пользователей. Нельзя сделать вероятность fault нулевой. Нужно не дать fault превратиться в failure. Системы, которые это умеют, называют fault-tolerant.
Книга советует иногда вызывать сбои нарочно. Пример: Netflix Chaos Monkey случайно убивает процессы. Так механизмы восстановления проверяются постоянно.
| Тип fault | Особенности | Что помогает |
|---|---|---|
| Hardware | Случайные и независимые. В кластере из 10 000 дисков в среднем один диск в день выходит из строя | Redundancy (RAID, второй блок питания), отказоустойчивость на уровне ПО |
| Software | Системные, связаны между узлами, долго “спят”. Пример: баг с leap second в 2012 году | Тесты, изоляция процессов, рестарт, мониторинг, самопроверки |
| Human | Ошибки конфигурации часто главная причина простоев | См. список ниже |
Против human errors помогает комбинация мер:
- удобные API и интерфейсы, где легко сделать правильно;
- sandbox-среды с реальными данными, где можно экспериментировать;
- тесты на всех уровнях;
- быстрый откат конфигурации и постепенный rollout кода;
- возможность пересчитать данные, если старый расчёт был неверным;
- подробный мониторинг (telemetry).
Современные облака (например, AWS) не обещают, что виртуальная машина проживёт долго. Поэтому растёт доля систем, которые переживают потерю целой машины. Бонус: можно обновлять узлы по одному без простоя.
Scalability: масштабируемость
Заголовок раздела «Scalability: масштабируемость»Scalability — способность системы справляться с ростом нагрузки. Нельзя сказать “X масштабируем”. Нужно спросить: если нагрузка вырастет вот так, какие у нас варианты?
Описание нагрузки (load parameters)
Заголовок раздела «Описание нагрузки (load parameters)»Нагрузку описывают несколькими числами. Это могут быть запросы в секунду, доля чтений и записей, число активных пользователей, hit rate кэша. Лучший выбор зависит от архитектуры.
Пример из книги: Twitter. Два действия: post tweet (в среднем 4,6 тыс. запросов в секунду) и home timeline (300 тыс. запросов в секунду). Проблема не в объёме твитов, а в fan-out: у каждого пользователя много подписчиков.
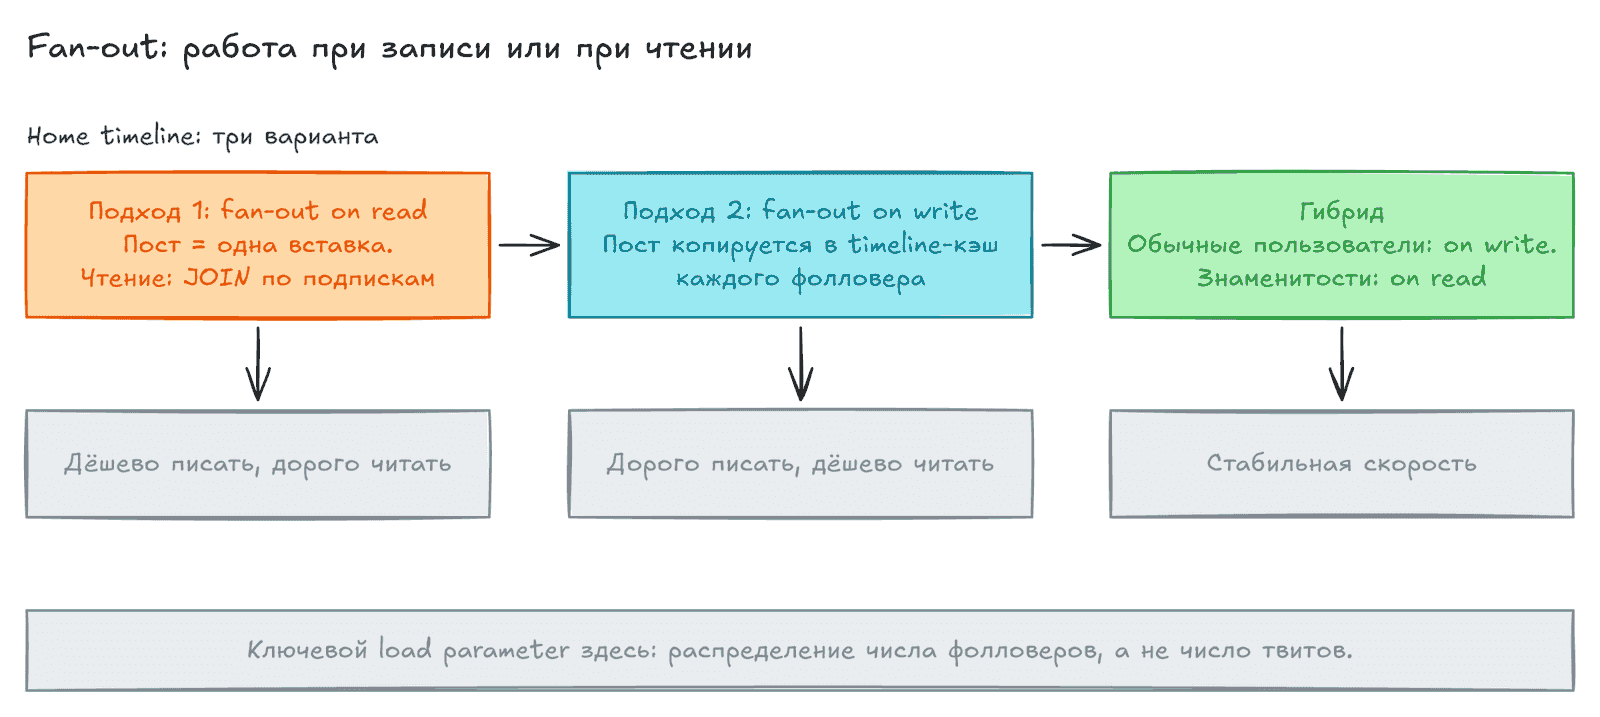
| Подход | Запись | Чтение | Проблема |
|---|---|---|---|
| Fan-out on read | Одна вставка в общую таблицу | JOIN по подпискам, слияние по времени | Чтений слишком много |
| Fan-out on write | Копия твита в timeline-кэш каждого подписчика | Дёшево, уже посчитано | У пользователя с миллионами подписчиков одна запись даёт миллионы записей |
| Гибрид | Обычные пользователи: on write | Знаменитости подмешиваются при чтении | Сложнее, но стабильная скорость |
Вывод: ключевой load parameter здесь не число твитов, а распределение числа подписчиков.
Описание производительности
Заголовок раздела «Описание производительности»Есть два вопроса:
- Если нагрузка растёт, а ресурсы те же, что будет с производительностью?
- Сколько ресурсов добавить, чтобы производительность осталась прежней?
Для batch-систем (Hadoop) важен throughput: записей в секунду или время выполнения job. Для онлайн-систем важно response time: время от запроса до ответа клиента. Latency — это только время ожидания в очереди. Response time включает ещё service time и сетевые задержки.
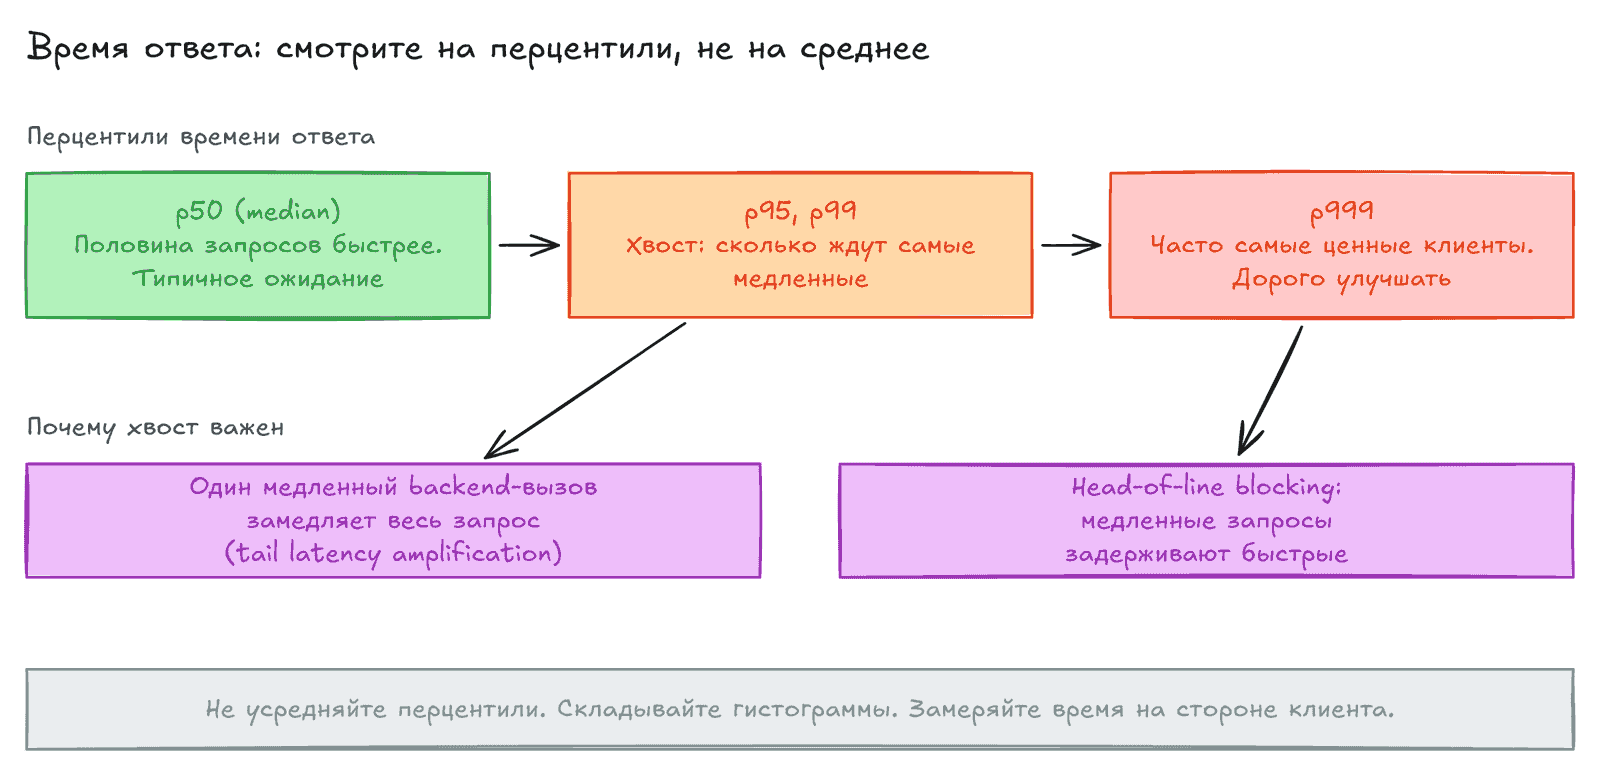
Response time — это распределение, а не одно число. Среднее (mean) плохо описывает типичный опыт. Лучше использовать перцентили:
| Перцентиль | Значение |
|---|---|
| p50 (median) | Половина запросов быстрее |
| p95, p99, p999 | Порог, быстрее которого 95%, 99%, 99,9% запросов. Описывает “хвост” (tail) |
Важные детали:
- Медленные запросы часто идут от самых ценных клиентов (у них больше данных). Amazon задаёт требования по p999.
- Оптимизация p9999 слишком дорога. Выигрыш мал.
- Tail latency amplification: если один запрос пользователя вызывает несколько backend-вызовов, достаточно одного медленного.
- Head-of-line blocking: несколько медленных запросов задерживают быстрые. Поэтому время нужно мерить на стороне клиента.
- При нагрузочном тесте клиент должен слать запросы независимо от ответов. Иначе очереди искусственно короче.
- Нельзя усреднять перцентили. Правильно складывать гистограммы. Для расчёта на лету есть t-digest, HdrHistogram, forward decay.
- Перцентили используют в SLO и SLA (целях и соглашениях об уровне сервиса).
Подходы к росту нагрузки
Заголовок раздела «Подходы к росту нагрузки»- Scaling up (vertical): более мощная машина. Просто, но дорого.
- Scaling out (horizontal): нагрузка на много машин,
shared nothing. - Elastic: система сама добавляет ресурсы. Полезно при непредсказуемой нагрузке. Ручное масштабирование проще и даёт меньше сюрпризов.
- Stateless-сервисы распределять легко. Stateful-хранилища сложнее. Традиционный совет: держать базу на одном узле, пока цена или требования к доступности не заставят распределить.
Универсальной масштабируемой архитектуры нет. Система на 100 000 запросов по 1 КБ в секунду выглядит совсем иначе, чем система на 3 запроса в минуту по 2 ГБ. Архитектура строится на предположениях, какие операции частые, а какие редкие. На раннем этапе продукта скорость итераций важнее гипотетической будущей нагрузки.
Maintainability: сопровождаемость
Заголовок раздела «Maintainability: сопровождаемость»Большая часть стоимости ПО приходится на сопровождение, а не на первую разработку. Книга выделяет три принципа.
| Принцип | Идея | Примеры |
|---|---|---|
| Operability | Операционной команде легко держать систему в рабочем состоянии | Мониторинг, автоматизация, нет зависимости от одной машины, понятная модель (“сделаю X, будет Y”), хорошие defaults |
| Simplicity | Новому инженеру легко понять систему | Убирать accidental complexity (она не часть задачи), использовать хорошие abstractions |
| Evolvability | Легко менять систему под новые требования | Простые системы и хорошие абстракции; ещё называют extensibility |
Главный инструмент против лишней сложности — abstraction. SQL скрывает структуры на диске, конкурентные запросы и сбои. Найти хорошие абстракции для распределённых систем трудно.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Data-intensive | Ограничение в объёме, сложности и скорости изменения данных, а не в CPU |
| Fault | Отказ одного компонента |
| Failure | Система в целом не работает |
| Fault-tolerant | Система переживает определённые fault |
| MTTF | Среднее время до отказа (диска) |
| Load parameters | Числа, описывающие нагрузку |
| Fan-out | Число запросов или записей, порождённых одним входящим запросом |
| Throughput | Объём работы в единицу времени |
| Response time | Время от запроса до ответа, как его видит клиент |
| Percentile (p50, p99) | Порог, быстрее которого отвечает заданная доля запросов |
| Tail latency | Время самых медленных запросов |
| SLO / SLA | Целевой уровень сервиса / соглашение с клиентом |
| Scaling up / out | Мощнее машина / больше машин |
| Elastic | Автоматическое добавление ресурсов |
| Operability, Simplicity, Evolvability | Три принципа сопровождаемости |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Описывайте нагрузку числами: объём данных, частота запусков, доля чтений и записей. Только потом выбирайте архитектуру.
- Для пайплайнов и API измеряйте p95 и p99, а не только среднее. Для batch-задач следите за throughput и за skew (перекос данных).
- Планируйте отказы. Делайте задачи
idempotent, чтобы повтор после сбоя не портил данные. Умейте быстро откатить конфигурацию и пересчитать данные. - Не усредняйте перцентили при агрегации метрик. Храните гистограммы.
- Если вы собираете систему из базы, кэша и поискового индекса, вы отвечаете за их согласованность. Решите заранее, кто источник истины и как идёт синхронизация.
- Не строите масштабируемость заранее без причины. Сначала понятная и простая система.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем fault отличается от failure? Почему цель в том, чтобы одно не вело к другому?
- Почему в примере с Twitter ключевой load parameter — число подписчиков, а не число твитов?
- Почему среднее время ответа плохо описывает опыт пользователя? Что лучше?
- Что такое accidental complexity и как с ней помогает abstraction?
Предыдущей главы нет. Следующая: Модели данных и языки запросов.