

Designing Data-Intensive Applications, глава 8: Проблемы распределённых систем
Главная мысль: в распределённой системе всегда что-то ломается частично. Сеть, часы и процессы ненадёжны. Узел не может знать наверняка, что происходит у других. Поэтому решения принимает большинство (quorum), а не один узел.
Частичные отказы
Заголовок раздела «Частичные отказы»Один компьютер работает либо полностью, либо падает. Результат предсказуем (deterministic).
В распределённой системе часть узлов может сломаться, пока остальные работают. Это partial failure. Он недетерминирован: одна и та же операция иногда проходит, иногда нет. Вы можете даже не знать, выполнилась она или нет.
Два подхода к большим системам:
| Подход | Как обрабатывает сбой |
|---|---|
| Supercomputer (HPC) | Периодический checkpoint. При сбое узла останавливает всю задачу и перезапускает с checkpoint |
| Cloud / интернет-сервисы | Сервис должен работать всегда. Сбои узлов терпят, узлы из обычного железа ломаются чаще |
Книга говорит об интернет-сервисах. Нужно строить надёжную систему из ненадёжных частей. Пример: TCP делает надёжную передачу поверх ненадёжного IP. Но TCP не убирает задержки.
Сбои нужно проверять заранее. Например, искусственно ломать сеть в тестах (chaos engineering).
Ненадёжные сети
Заголовок раздела «Ненадёжные сети»Узлы в книге работают по модели shared-nothing: у каждого своя память и диск. Общаются только по сети. Сеть асинхронная: нет гарантии, когда придёт пакет и придёт ли вообще.
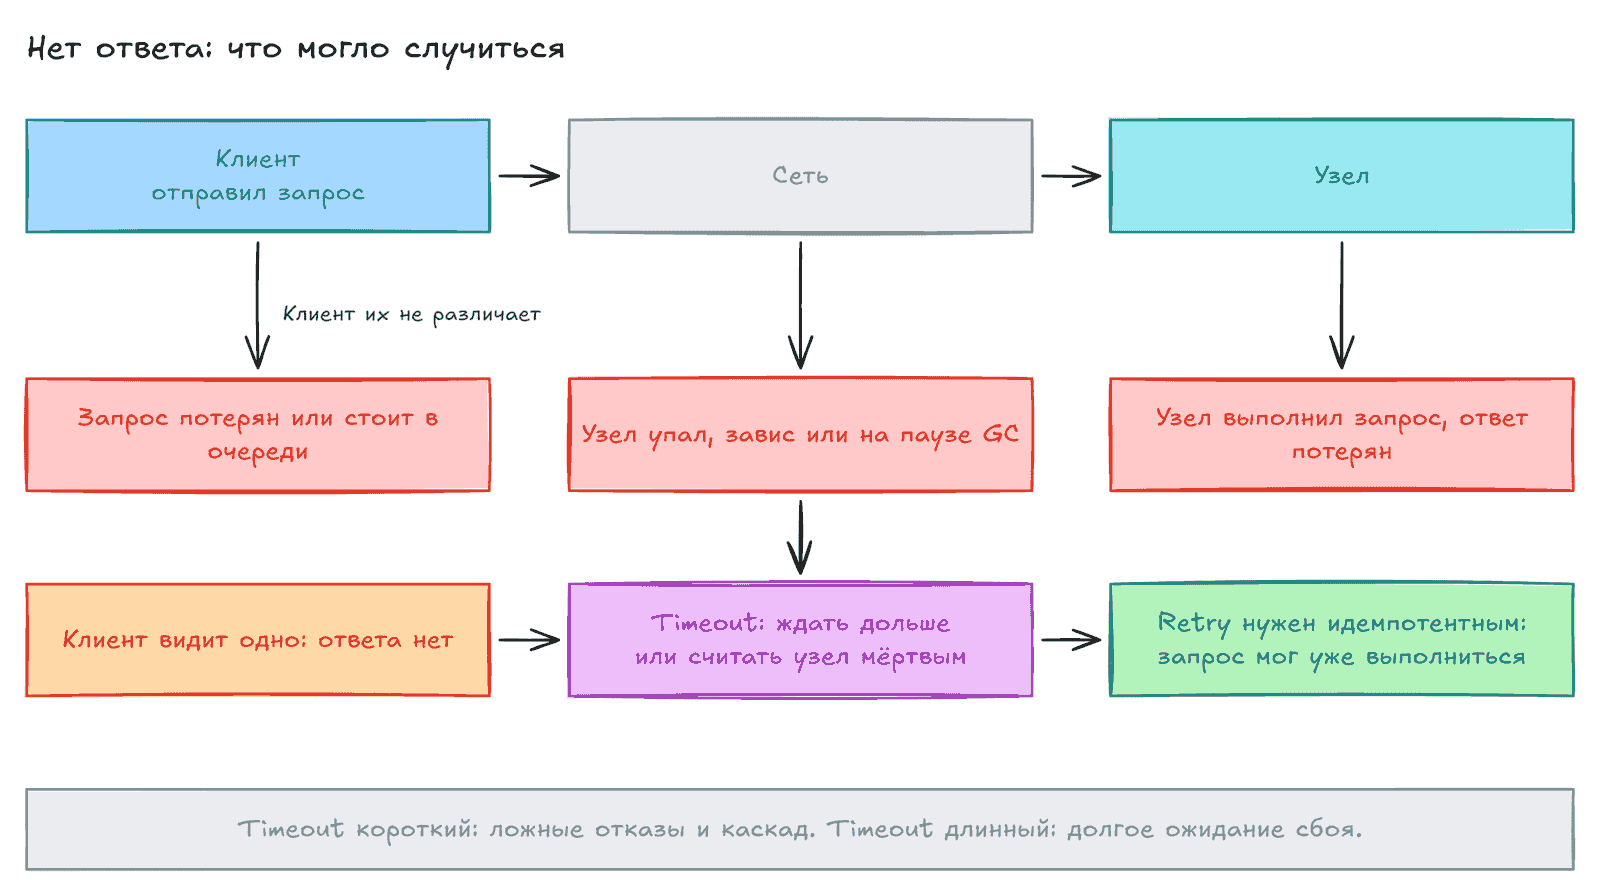
Если нет ответа, причин несколько:
- запрос потерян или стоит в очереди;
- узел упал или завис (например, пауза GC);
- узел выполнил запрос, но ответ потерян или задержан.
Клиент не может отличить эти случаи. Единственный инструмент: timeout. После timeout клиент всё равно не знает, дошёл ли запрос.
Сети ломаются чаще, чем кажется. Причина часто человеческая: неверная настройка коммутатора. Резервное оборудование помогает не от всех сбоев. Канал может работать только в одну сторону.
Обнаружение сбоев
Заголовок раздела «Обнаружение сбоев»Нужно, например, балансировщику (убрать узел из ротации) и базе с одним leader (выбрать нового). Быстрые сигналы возможны, но на них нельзя полагаться:
- ОС отвечает RST или FIN, если порт закрыт;
- скрипт сообщает о падении процесса (так делает HBase);
- коммутатор показывает отказ канала;
- роутер отвечает ICMP Destination Unreachable.
Даже TCP ACK не значит, что приложение обработало запрос. Нужен ответ от самого приложения.
Timeout и очереди
Заголовок раздела «Timeout и очереди»Выбор timeout это компромисс:
| Timeout | Плюс | Минус |
|---|---|---|
| Длинный | Меньше ложных срабатываний | Долго ждём, пока узел признан мёртвым |
| Короткий | Быстрое обнаружение | Живой узел объявлен мёртвым. Нагрузка уходит на другие узлы, возможен каскадный сбой |
Если бы сеть и узлы имели максимальную задержку d и время обработки r, timeout был бы 2d + r. Таких гарантий обычно нет.
Задержки в основном создают очереди:
- очередь в коммутаторе при одновременной отправке на один порт;
- очередь в ОС, если все ядра заняты;
- пауза виртуальной машины на десятки миллисекунд;
- flow control и повторная отправка в TCP.
UDP не повторяет пакеты и не ограничивает скорость. Он подходит там, где запоздавшие данные бесполезны (звонки).
Лучше не задавать timeout константой. Системы измеряют время ответа и jitter и подстраиваются. Пример: Phi Accrual failure detector в Akka и Cassandra.
Синхронные и асинхронные сети
Заголовок раздела «Синхронные и асинхронные сети»Телефонная сеть использует circuit: канал резервируется на весь звонок. Очередей нет, задержка ограничена.
Интернет использует packet switching. Он хорош для неравномерного (bursty) трафика и лучше использует канал. Цена: очереди и неограниченные задержки. Гарантии задержки возможны (QoS, выделенное железо), но дороже и хуже по утилизации. Переменные задержки это результат компромисса цены и пользы, а не закон природы.
Ненадёжные часы
Заголовок раздела «Ненадёжные часы»У каждого узла свои часы (кварц). Они уходят вперёд или назад (drift). Google считает drift 200 ppm. NTP синхронизирует их, но неточно.
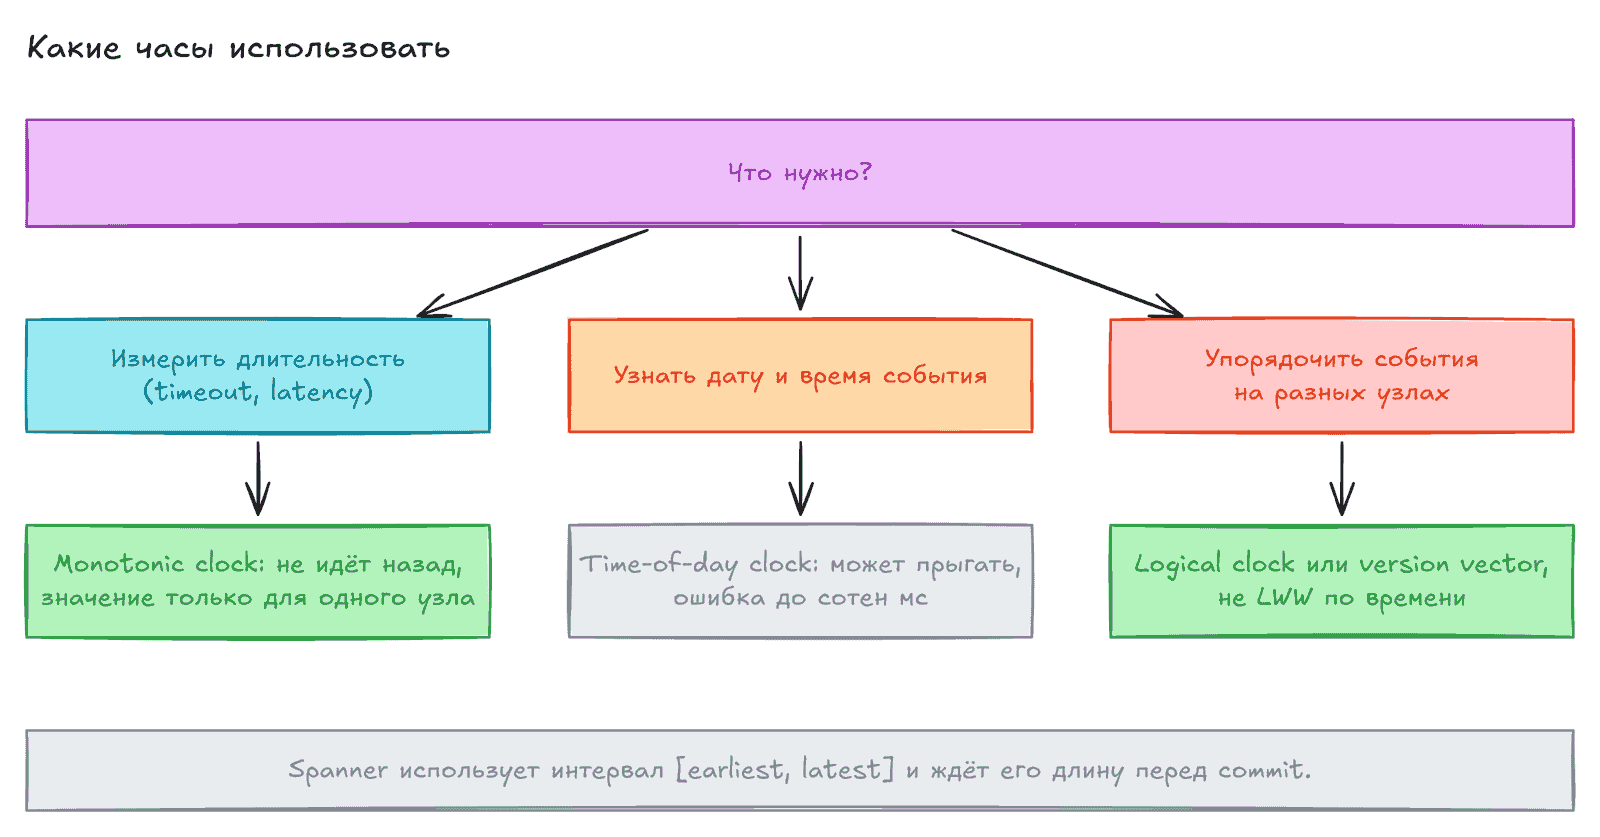
| Тип часов | Для чего | Особенности |
|---|---|---|
| Time-of-day (wall-clock) | Дата и время | Может прыгнуть назад при коррекции NTP. Не подходит для измерения длительности |
| Monotonic | Длительность, timeout | Не идёт назад. Абсолютное значение бессмысленно, сравнивать между узлами нельзя |
Проблемы синхронизации:
- ошибка NTP через интернет: не меньше десятков миллисекунд, иногда до секунды;
- firewall блокирует NTP, и никто не замечает;
- leap second ломает системы (помогает smearing: растянуть секунду на сутки);
- в виртуальных машинах часы «прыгают» при паузах;
- на устройствах пользователей время может быть неверным намеренно.
Неверные часы опасны тем, что система не падает. Она тихо теряет данные. Если вы полагаетесь на часы, мониторьте расхождение и убирайте узлы с большим drift.
Порядок событий и LWW
Заголовок раздела «Порядок событий и LWW»Last write wins (LWW) выбирает запись с самой поздней меткой времени. Cassandra и Riak так делают. Проблемы:
- запись узла с отстающими часами молча теряется;
- LWW не отличает последовательные записи от конкурентных;
- две записи могут получить одинаковый timestamp.
Безопаснее logical clocks: счётчики, которые показывают только порядок. Например, version vector.
Интервал уверенности
Заголовок раздела «Интервал уверенности»Показание часов это не точка, а интервал. Но обычные API (clock_gettime) ошибку не показывают. Исключение: TrueTime в Google Spanner. Он возвращает [earliest, latest].
Spanner использует это для snapshot isolation между датацентрами. Если интервалы двух транзакций не пересекаются, порядок известен. Поэтому перед commit Spanner ждёт длину интервала. В каждом датацентре стоят GPS или атомные часы (ошибка около 7 мс). Вне Google это почти не встречается.
Паузы процессов
Заголовок раздела «Паузы процессов»Пример: leader держит lease (блокировку с временем жизни). Код проверяет lease и обрабатывает запрос. Если между проверкой и обработкой поток встал на 15 секунд, lease уже истёк. Другой узел стал leader. Старый узел об этом не знает.
Причины пауз:
- stop-the-world GC (бывает минуты);
- приостановка и миграция виртуальной машины;
- переключение контекста и steal time;
- синхронный диск, в том числе сетевой (EBS);
- swapping и thrashing;
- SIGSTOP (например, Ctrl+Z).
Инструменты многопоточности (mutex, семафоры) не работают между узлами: нет общей памяти. Узел должен считать, что его могут остановить в любой момент.
Hard real-time (подушка безопасности в автомобиле) требует особой ОС, ограничения памяти и огромного тестирования. Для серверных систем это дорого. Вместо этого смягчают GC: выводят узел из ротации на время GC или перезапускают процессы заранее.
Знание, истина и ложь
Заголовок раздела «Знание, истина и ложь»Узел не может ничего знать наверняка. Он делает выводы из сообщений. Узел с односторонним сбоем или после долгой паузы GC может считаться мёртвым, хотя он жив. Он не может спорить с этим.
Истину определяет большинство
Заголовок раздела «Истину определяет большинство»Один узел не должен принимать важные решения. Используют quorum: большинство (2 из 3, 3 из 5). Если большинство объявило узел мёртвым, он обязан подчиниться. Два конфликтующих большинства быть не могут. При 3 узлах терпим 1 сбой, при 5 узлах 2 сбоя.
Leader, lock и fencing
Заголовок раздела «Leader, lock и fencing»Нужен «ровно один»: leader партиции, держатель lock, владелец username. Узел может ошибочно считать себя выбранным. Пример: клиент 1 уснул, lease истёк, клиент 2 начал писать в файл, клиент 1 проснулся и тоже пишет. Файл повреждён. Такая ошибка была в HBase.
Решение: fencing token. Lock-сервис отдаёт растущий номер при каждой выдаче lease. Клиент прикладывает его к каждой записи. Хранилище помнит наибольший токен и отклоняет меньшие. С ZooKeeper можно использовать zxid или cversion.
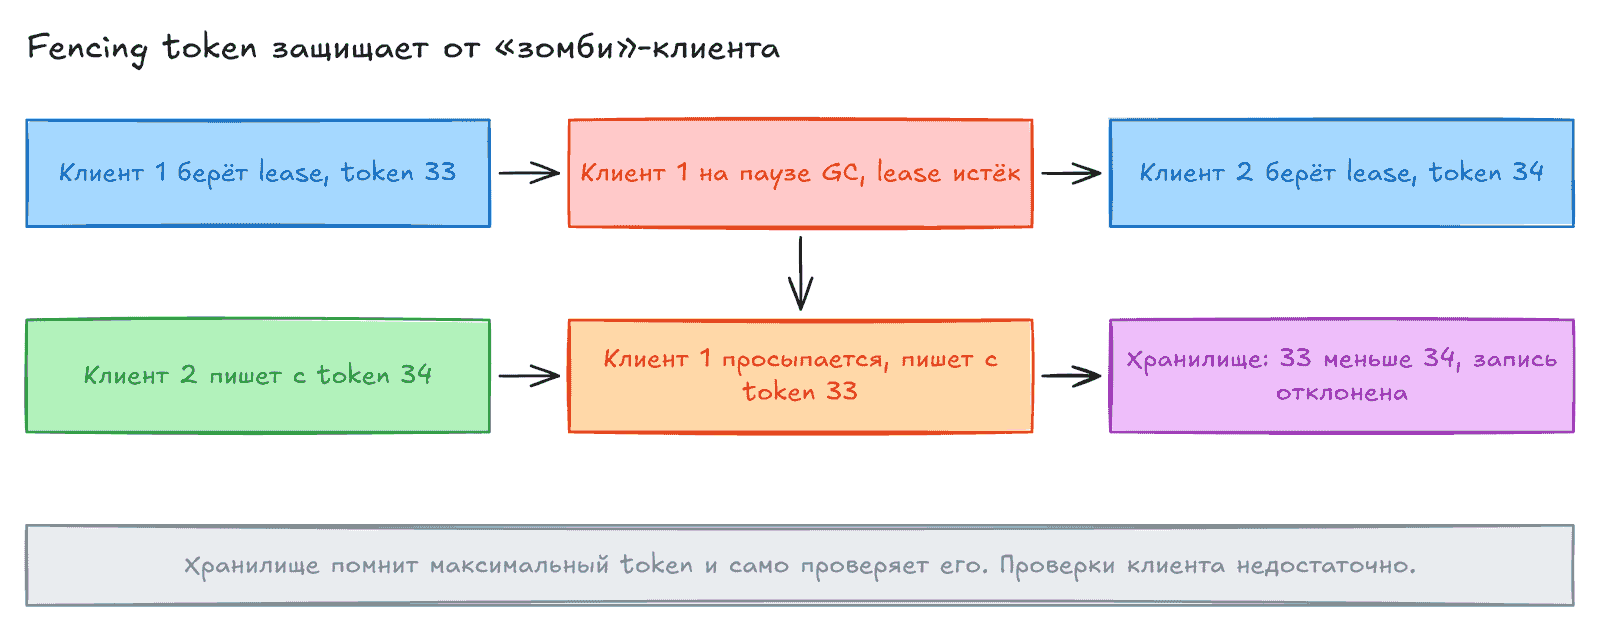
Проверку должен делать сам ресурс. Клиентам доверять нельзя.
Byzantine faults
Заголовок раздела «Byzantine faults»Byzantine fault: узел лжёт или отправляет произвольные данные. Byzantine fault tolerance нужна в авиации (радиация портит память) и в системах без доверия между участниками (блокчейн). В обычном датацентре узлы наши, и книга считает их «ненадёжными, но честными». Такие алгоритмы сложны и требуют более двух третей исправных узлов. Они не защитят от ошибки в ПО, которое стоит на всех узлах. От атак защищают аутентификация, шифрование и firewall.
Простая защита от «слабой лжи»: контрольные суммы на уровне приложения, проверка входных данных, несколько NTP-серверов.
Модели системы
Заголовок раздела «Модели системы»Алгоритмы доказывают корректность в рамках системной модели.
| Что моделируем | Варианты |
|---|---|
| Время | Synchronous (есть верхние границы). Partially synchronous (обычно как synchronous, иногда границы нарушены). Asynchronous (никаких предположений о времени) |
| Узлы | Crash-stop (упал навсегда). Crash-recovery (может вернуться, диск сохраняется, память теряется). Byzantine (любое поведение) |
Для реальных систем лучше всего подходит partially synchronous с crash-recovery.
Safety и liveness
Заголовок раздела «Safety и liveness»Корректность описывают свойствами. Пример для fencing token:
- Safety (ничего плохого): uniqueness (токены уникальны), monotonic sequence (токены растут). Нарушение необратимо. Safety должна выполняться всегда.
- Liveness (что-то хорошее случится): availability (узел получит ответ). Обычно содержит слово «eventually». Допустимы оговорки: например, только пока большинство узлов живо.
Реальность сложнее модели: диск может потерять данные, узел может «забыть» записанное. Реализация должна обрабатывать «невозможное», хотя бы вызвав оператора. Теория и тесты нужны вместе.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Partial failure | Часть системы сломана, остальная работает. Результат недетерминирован |
| Shared-nothing | Узлы не делят память и диск, общаются по сети |
| Timeout | Время, после которого узел считают недоступным. Причину сбоя не показывает |
| Phi Accrual failure detector | Детектор сбоев, который подстраивает timeout под измеренные задержки |
| Packet switching / circuit switching | Пакетная сеть (интернет) и сеть с резервом канала (телефон) |
| Time-of-day clock | Часы с датой и временем, могут прыгать |
| Monotonic clock | Часы для длительности, не идут назад |
| NTP | Протокол синхронизации часов по сети |
| Last write wins (LWW) | Побеждает запись с самым поздним временем. Теряет данные при разбежке часов |
| Logical clock | Счётчик для порядка событий без времени суток |
| TrueTime | API Google Spanner с интервалом [earliest, latest] |
| Lease | Блокировка с временем жизни |
| Fencing token | Растущий номер lease. Хранилище отклоняет записи с меньшим номером |
| Quorum | Решение большинства узлов |
| Byzantine fault | Узел лжёт или ведёт себя произвольно |
| System model | Набор допущений о времени и отказах, в рамках которых доказывают алгоритм |
| Safety / liveness | «Ничего плохого» (всегда) и «что-то хорошее случится» (eventually) |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Любой вызов по сети может не вернуть ответ. Тогда неизвестно, выполнился ли он. Делайте операции
idempotentи повторяйте безопасно. Это важно для загрузки данных, API и записи в хранилища. - Не используйте время суток для порядка событий и разрешения конфликтов. Для дедупликации и версий берите sequence number, offset, версию строки. Не
updated_atс разных серверов. - Для timeout и длительности берите monotonic clock. Следите за drift NTP на узлах кластера.
- Если процесс в пайплайне держит lock или lease (например, единственный writer), добавьте fencing token или проверку версии на стороне хранилища. Пауза GC или остановка контейнера может сделать «зомби».
- Задавайте timeout по измеренным задержкам, а не по ощущениям. Слишком короткий timeout у клиента БД или оркестратора вызывает ложные failover и перезапуски.
- Тестируйте сбои: отключение узла, медленная сеть, пауза процесса. Это дешевле, чем разбор потери данных.
- Если задача помещается на один сервер, не усложняйте её распределением.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему клиент не может отличить потерянный запрос от потерянного ответа? Что из этого следует для retry?
- Чем monotonic clock отличается от time-of-day clock? Для чего использовать каждый?
- Как fencing token защищает от клиента, который проспал свой lease? Почему проверку делает хранилище?
- Чем safety отличается от liveness? Какая из них должна выполняться всегда?
Предыдущая: Транзакции. Следующая: Согласованность и консенсус.