

The Data Warehouse Toolkit, глава 9: HR
Главная мысль: в HR главная вещь — история сотрудника. Employee dimension хранит версии профиля (SCD type 2) с датами и причиной изменения. Такая dimension сама отвечает на многие вопросы, почти как fact. Числовые события (зарплата) лежат в transaction fact. Численность — в periodic snapshot. Иерархию руководителей раскрывают в bridge table. Навыки — тоже в bridge.
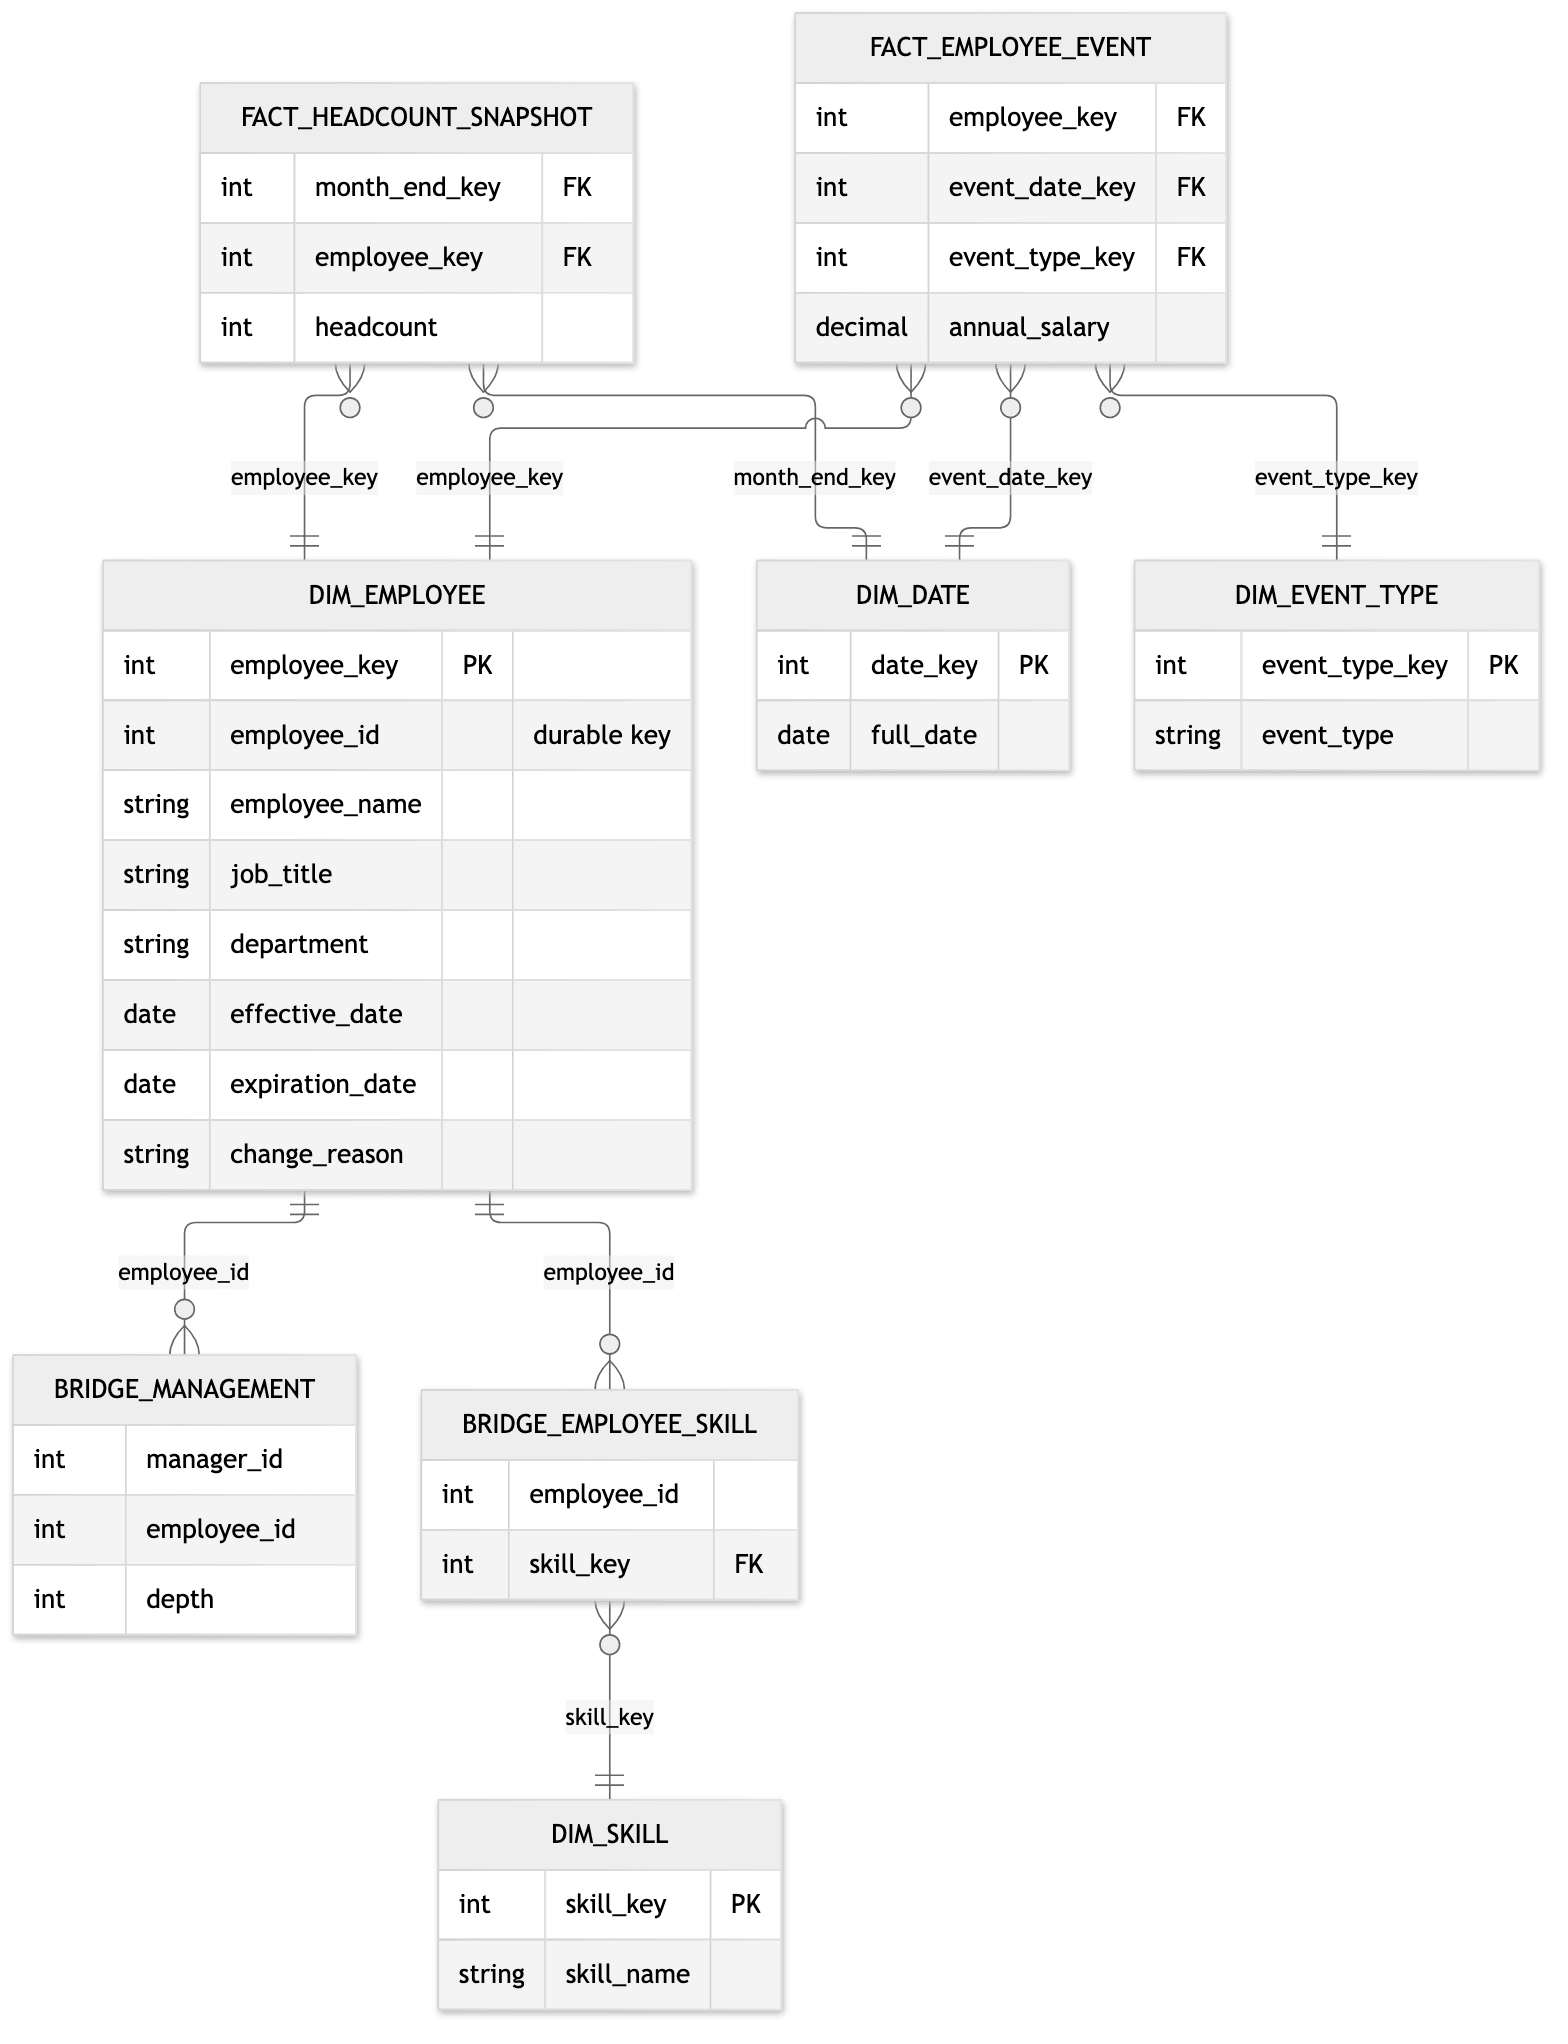
Employee dimension и история
Заголовок раздела «Employee dimension и история»- Одна строка dimension = одна версия профиля сотрудника.
- При смене должности или отдела создаётся новая строка и новый
surrogate key. Это SCD type 2. - Постоянный
employee_id— этоdurable key. Он связывает все версии. - Точные
effective_dateиexpiration_dateнужны, чтобы привязать событие к нужной версии. - Атрибуты, где история не нужна (телефон, e-mail), обновляют на месте (type 1). Это можно смешивать в одной таблице.
- В dimension часто 100 и больше атрибутов: должность, отдел, grade, тип контракта, локация, статус.
- Добавьте
change_reason: почему появилась версия (повышение, перевод, смена адреса). Тогда «сколько переводов было в году» считается по одной dimension. - Ловушка: factless fact «событие профиля», где строк столько же, сколько версий в dimension. Это дубль. Книга советует убрать его и хранить причину в dimension.
- Если источник пишет много мелких изменений за раз, соберите их в одну версию («повышение»), а не в пять.
Три fact table для HR
Заголовок раздела «Три fact table для HR»| Fact | Grain | Пример |
|---|---|---|
| Employee event (transaction) | Одно кадровое событие | Приём, повышение, перевод, увольнение |
| Headcount (periodic snapshot) | Сотрудник x конец месяца | Сколько людей работает в отделе |
| Accumulating snapshot | Один кандидат или процесс | Найм: отклик, интервью, оффер, выход |
- В event fact лежат меры: новая зарплата, размер изменения. Тип события вынесите в маленькую dimension.
- Если числовой атрибут нужно суммировать (зарплата), ему место в fact, а не в dimension.
- Headcount snapshot:
employee_count, число найма и повышений за месяц, выплаченная зарплата, дни отпуска. Версия сотрудника — на конец месяца. - Остаток отпуска — balance. Он semi-additive: по месяцам его усредняют, а не суммируют.
- Книга отдельно показывает процессы найма, льгот, оценки сотрудников и увольнений. Все они делают свои fact table на общих dimensions. Многие из них factless.
Готовые модели от вендоров
Заголовок раздела «Готовые модели от вендоров»- Вендоры HR-систем продают готовые модели DWH. Это быстрее на старте.
- Минусы: абстрактные названия (
party,attribute_1) вместо языка бизнеса. Трудно сделать conformed dimensions с остальным DWH. - Совет книги: несколько недель с бизнес-пользователями дают то же понимание, что и готовая модель.
- Помните про приватность. Зарплаты и оценки надо защищать на уровне доступа.
Иерархия руководителей
Заголовок раздела «Иерархия руководителей»- В источнике это
manager_idв строке сотрудника. Это recursive hierarchy. - Простой случай (нужен только прямой руководитель):
manager_keyв fact как role-playing dimension или атрибут в employee dimension. - Ловушка:
manager_keyкак SCD2-атрибут. Смена адреса у CEO создаёт новую версию у всех сотрудников компании. Используйте durable key руководителя или type 1. - BI-инструменты не умеют разворачивать её.
SQLумеет черезrecursive CTE. - Решение:
bridge table. Пары «руководитель - подчинённый» на любой глубине:manager_id,employee_id,depth. - Уровень 0 — сотрудник сам себе. Тогда запрос «команда с руководителем» работает одинаково.
- Для вопросов «размер команды» и «расходы отдела с вложенными» делайте
JOINfact -> bridge. - Если иерархия меняется, стройте bridge на durable keys и добавьте даты действия связи. Тогда новые строки появляются только при смене подчинения.
Навыки: skill keyword bridge
Заголовок раздела «Навыки: skill keyword bridge»- У сотрудника много навыков. Нельзя класть их в колонки: список непредсказуем.
- Решение:
dim_skillи bridgeemployee_id-skill_key. - Для поиска «все, у кого есть SQL и dbt» нужны два условия на bridge. Решают это
GROUP BY ... HAVINGилиINTERSECT. - Альтернатива: строка с ключевыми словами в dimension (
|SQL|DBT|). И «И», и «ИЛИ» пишутся однимLIKE. Но так нельзя посчитать сотрудников по каждому навыку. - Разделитель
|нужен с двух сторон. ИначеLIKE '%SQL%'найдёт иNoSQL.
Опросы и анкеты
Заголовок раздела «Опросы и анкеты»- Grain: один ответ на один вопрос одного респондента.
- Fact хранит
survey_key,question_key,response_category_key, две даты (отправлен, получен), числовой ответ. - Employee играет две роли: кто отвечает и кого оценивают (role-playing).
- Так можно анализировать любой опрос одной моделью: оценку сотрудников, удовлетворённость клиентов.
Текстовые комментарии
Заголовок раздела «Текстовые комментарии»- Свободный текст не кладите в fact. Это не degenerate dimension, он только раздувает таблицу.
- Если комментарии повторяются (хотя бы «Без комментария»), делайте comments dimension с ключом в fact.
- Если комментарий уникален для каждого события, это атрибут transaction dimension.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Durable key | Постоянный ключ сотрудника, общий для версий |
| SCD type 2 | Новая строка для каждой версии профиля |
| Periodic snapshot | Состояние на конец периода |
| Recursive hierarchy | Дерево через manager_id |
| Bridge table | Развёрнутые пары предок - потомок или many-to-many |
| Effective / expiration date | Границы действия версии |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для as-of запроса («кем он был 15 мая») соединяйте по
BETWEEN effective_date AND expiration_date. - Не считайте сотрудников по
count(*)из dimension. Версий больше, чем людей. Считайтеcount(DISTINCT employee_id). - Headcount-снимок строят заранее. Он избавляет BI от тяжёлых запросов по датам.
- Держите деньги и персональные данные в отдельных ролях доступа.
- Иерархию строят заново при каждой загрузке. Это дёшево: дерево небольшое.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём employee dimension, события, снимок, bridge
Заголовок раздела «Шаг 1. Создаём employee dimension, события, снимок, bridge»CREATE TABLE dim_date ASSELECT strftime(d, '%Y%m%d')::INT AS date_key, d AS full_dateFROM generate_series(DATE '2020-01-01', DATE '2024-12-31', INTERVAL 1 DAY) t(d);
-- SCD type 2: версия = период с одинаковым профилем. change_reason = почему появилась версияCREATE TABLE dim_employee ASSELECT * FROM (VALUES (1, 1, 'Анна', 'CEO', 'Руководство', DATE '2020-01-01', DATE '9999-12-31', 'Приём'), (2, 2, 'Борис', 'Head of Data', 'Data', DATE '2022-01-01', DATE '2024-05-31', 'Приём'), (3, 2, 'Борис', 'Director of Data', 'Data', DATE '2024-06-01', DATE '9999-12-31', 'Повышение'), (4, 3, 'Вера', 'Head of Sales', 'Sales', DATE '2021-03-01', DATE '9999-12-31', 'Приём'), (5, 4, 'Глеб', 'Analyst', 'Data', DATE '2023-03-01', DATE '2024-03-31', 'Приём'), (6, 4, 'Глеб', 'Senior Analyst', 'Data', DATE '2024-04-01', DATE '9999-12-31', 'Повышение'), (7, 5, 'Дина', 'Engineer', 'Data', DATE '2023-06-01', DATE '9999-12-31', 'Приём'), (8, 6, 'Егор', 'Engineer', 'Data', DATE '2024-02-01', DATE '2024-08-31', 'Приём'), (9, 6, 'Егор', 'Engineer', 'Sales', DATE '2024-09-01', DATE '9999-12-31', 'Перевод'), (10, 7, 'Жанна', 'Sales Manager', 'Sales', DATE '2022-05-01', DATE '9999-12-31', 'Приём'), (11, 8, 'Зина', 'Sales Rep', 'Sales', DATE '2023-01-01', DATE '2024-09-30', 'Приём')) t(employee_key, employee_id, employee_name, job_title, department, effective_date, expiration_date, change_reason);
CREATE TABLE dim_event_type ASSELECT * FROM (VALUES (1,'hire'),(2,'promotion'),(3,'transfer'),(4,'termination')) t(event_type_key, event_type);
-- grain: одно кадровое событие. employee_key = версия после событияCREATE TABLE fact_employee_event ASSELECT employee_key, strftime(event_date, '%Y%m%d')::INT AS event_date_key, event_type_key, annual_salaryFROM (VALUES (1, DATE '2020-01-01', 1, 300000), (2, DATE '2022-01-01', 1, 150000), (3, DATE '2024-06-01', 2, 200000), (4, DATE '2021-03-01', 1, 140000), (5, DATE '2023-03-01', 1, 80000), (6, DATE '2024-04-01', 2, 95000), (7, DATE '2023-06-01', 1, 90000), (8, DATE '2024-02-01', 1, 85000), (9, DATE '2024-09-01', 3, 85000), (10, DATE '2022-05-01', 1, 90000), (11, DATE '2023-01-01', 1, 60000), (11, DATE '2024-09-30', 4, 60000)) t(employee_key, event_date, event_type_key, annual_salary);
-- grain: один сотрудник x конец месяца 2024. Берём версию, действующую в этот деньCREATE TABLE fact_headcount_snapshot ASSELECT strftime(m.month_end, '%Y%m%d')::INT AS month_end_key, e.employee_key, 1 AS headcountFROM (SELECT last_day(d) AS month_end FROM generate_series(DATE '2024-01-01', DATE '2024-12-01', INTERVAL 1 MONTH) t(d)) mJOIN dim_employee e ON m.month_end BETWEEN e.effective_date AND e.expiration_date;
-- иерархия руководителей (текущая) и bridgeCREATE TABLE employee_manager ASSELECT * FROM (VALUES (1, NULL), (2, 1), (3, 1), (4, 2), (5, 2), (6, 4), (7, 3), (8, 3)) t(employee_id, manager_id);
CREATE TABLE bridge_management ASWITH RECURSIVE r AS ( SELECT employee_id AS manager_id, employee_id, 0 AS depth FROM employee_manager UNION ALL SELECT r.manager_id, em.employee_id, r.depth + 1 FROM r JOIN employee_manager em ON em.manager_id = r.employee_id)SELECT * FROM r;
CREATE TABLE dim_skill ASSELECT * FROM (VALUES (1,'SQL'),(2,'Python'),(3,'dbt'),(4,'Переговоры'),(5,'Excel')) t(skill_key, skill_name);
CREATE TABLE bridge_employee_skill ASSELECT * FROM (VALUES (2,1),(2,3),(4,1),(4,5),(5,1),(5,2),(5,3),(6,1),(6,2), (3,4),(7,4),(7,5),(8,4)) t(employee_id, skill_key);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»-- у каждого employee_id версии не пересекаются: должно вернуть 0 строкSELECT a.employee_id, a.employee_key, b.employee_key AS overlap_withFROM dim_employee aJOIN dim_employee b ON a.employee_id = b.employee_id AND a.employee_key < b.employee_key AND a.effective_date <= b.expiration_date AND b.effective_date <= a.expiration_date;
SELECT count(*) AS versions, count(DISTINCT employee_id) AS employees FROM dim_employee;Задания
Заголовок раздела «Задания»1. Численность по месяцам и по отделам. Используйте fact_headcount_snapshot. Покажите декабрь и сентябрь.
Решение
SELECT s.month_end_key, e.department, sum(s.headcount) AS headcountFROM fact_headcount_snapshot sJOIN dim_employee e USING (employee_key)WHERE s.month_end_key IN (20240930, 20241231)GROUP BY ALLORDER BY s.month_end_key, e.department;В сентябре Егор уже в Sales. В декабре нет Зины: она ушла 30 сентября, но в сентябрьский снимок ещё входит.
2. As-of запрос. Кем был каждый сотрудник на 15 мая 2024 года, и кем он стал сейчас? Не используйте is_current.
Решение
SELECT a.employee_name, a.job_title AS title_on_may_15, a.department AS dept_on_may_15, n.job_title AS title_nowFROM dim_employee aLEFT JOIN dim_employee n ON n.employee_id = a.employee_id AND n.expiration_date = DATE '9999-12-31'WHERE DATE '2024-05-15' BETWEEN a.effective_date AND a.expiration_dateORDER BY a.employee_name;У Зины title_now равен NULL: у неё нет текущей версии, она уволилась.
3. Повышения и зарплата. Для каждого повышения покажите новую зарплату и рост в процентах к прошлой зарплате этого сотрудника.
Решение
SELECT e.employee_name, t.event_type, f.event_date_key, f.annual_salary, round(100.0 * (f.annual_salary - lag(f.annual_salary) OVER w) / lag(f.annual_salary) OVER w, 1) AS raise_pctFROM fact_employee_event fJOIN dim_employee e USING (employee_key)JOIN dim_event_type t USING (event_type_key)WINDOW w AS (PARTITION BY e.employee_id ORDER BY f.event_date_key)QUALIFY t.event_type = 'promotion'ORDER BY e.employee_name;Окно считается по всем событиям. QUALIFY оставляет только повышения. Это даёт процент к предыдущей зарплате.
4. Иерархия. Для каждого руководителя покажите размер команды без него самого. Прямые подчинённые и все уровни отдельно.
Решение
SELECT m.employee_name AS manager, count(*) FILTER (WHERE b.depth = 1) AS direct_reports, count(*) FILTER (WHERE b.depth >= 1) AS whole_teamFROM bridge_management bJOIN (SELECT DISTINCT employee_id, employee_name FROM dim_employee) m ON m.employee_id = b.manager_idGROUP BY m.employee_nameHAVING count(*) FILTER (WHERE b.depth >= 1) > 0ORDER BY whole_team DESC;У Анны вся команда — 7 человек. Она видит и сотрудников уровнем ниже.
5. Навыки. Найдите сотрудников, у которых есть и SQL, и dbt. Покажите все их навыки одной строкой.
Решение
SELECT n.employee_name, string_agg(s.skill_name, ', ' ORDER BY s.skill_name) AS skillsFROM bridge_employee_skill bJOIN dim_skill s USING (skill_key)JOIN (SELECT DISTINCT employee_id, employee_name FROM dim_employee) n USING (employee_id)WHERE b.employee_id IN ( SELECT b2.employee_id FROM bridge_employee_skill b2 JOIN dim_skill s2 USING (skill_key) WHERE s2.skill_name IN ('SQL', 'dbt') GROUP BY b2.employee_id HAVING count(DISTINCT s2.skill_name) = 2)GROUP BY n.employee_nameORDER BY n.employee_name;6. Change reason. Сколько изменений профиля каждого типа было в 2024 году? Используйте только dim_employee, без fact.
Решение
SELECT change_reason, count(*) AS changesFROM dim_employeeWHERE effective_date BETWEEN DATE '2024-01-01' AND DATE '2024-12-31'GROUP BY change_reasonORDER BY changes DESC;Два повышения (Борис, Глеб), один приём (Егор), один перевод (Егор). Увольнение Зины видно по expiration_date, а не по новой версии.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему сотрудник может иметь много строк в dimension? Как считать людей?
- Чем event fact отличается от headcount snapshot?
- Зачем bridge для иерархии руководителей, если есть
manager_id? - Как найти сотрудников с двумя навыками сразу?