

Designing Data-Intensive Applications, глава 6: Партиционирование
Главная мысль: Партиционирование делит большой набор данных на части, чтобы распределить данные и нагрузку по узлам. Главная цель: равномерность и отсутствие hot spots.
Партиция в книге это то же, что shard (MongoDB, Elasticsearch), region (HBase), tablet (BigTable), vnode (Cassandra, Riak). Не путайте с network partition, это сбой сети. Каждая запись принадлежит ровно одной партиции. Партиционирование обычно сочетают с репликацией: у каждой партиции свой лидер и фолловеры на разных узлах. Схема партиционирования почти не зависит от схемы репликации.
Партиционирование данных по ключу
Заголовок раздела «Партиционирование данных по ключу»Если нагрузка неравномерна, это skew. Партиция с непропорционально высокой нагрузкой это hot spot. Случайное распределение записей по узлам избавляет от hot spots, но чтение приходится слать на все узлы.
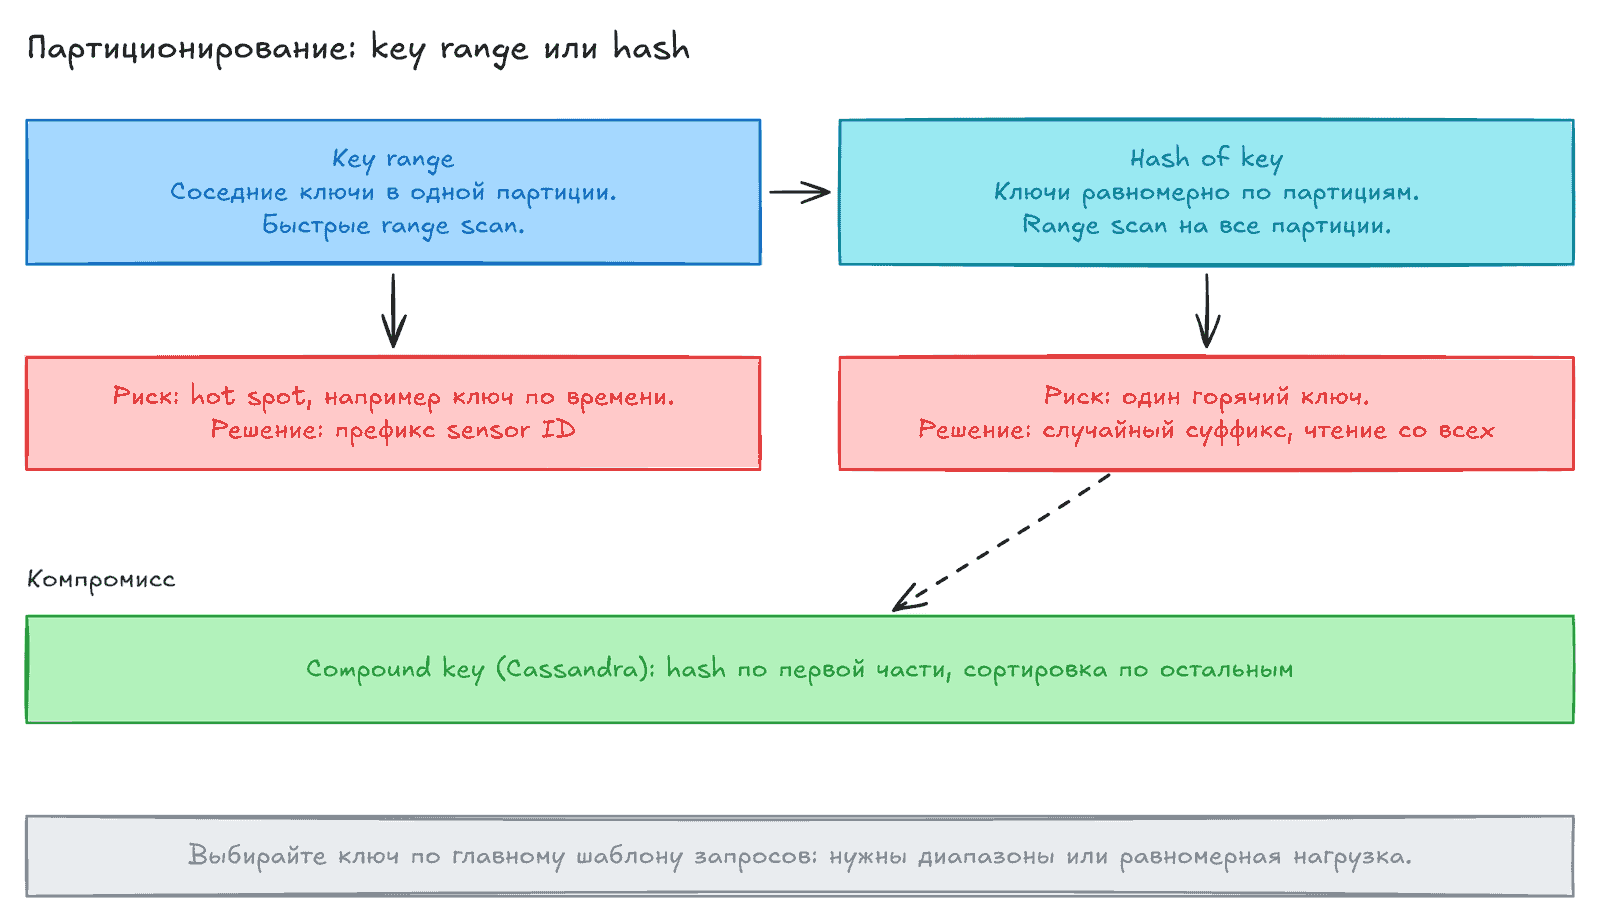
| Схема | Плюсы | Минусы | Примеры |
|---|---|---|---|
| Key range | Ключи отсортированы. Эффективные range scan | Hot spots, если ключ растёт вместе с временем | BigTable, HBase, RethinkDB, старый MongoDB |
| Hash of key | Равномерное распределение | Порядок ключей потерян. Range query идёт на все партиции | Cassandra, MongoDB (hash), Riak, Voldemort |
| Compound key | Хеш по первой части, сортировка по остальным | Диапазон по первой части невозможен | Cassandra |
Hot spot при key range. Если ключ равен timestamp, все записи идут в партицию «сегодня». Решение: поставить впереди другое поле, например имя датчика. Тогда запрос по нескольким датчикам требует отдельных запросов.
Hash partitioning. Хеш-функция не обязана быть криптографической (Cassandra и MongoDB используют MD5). Каждой партиции даётся диапазон хешей. Термин consistent hashing книга советует не использовать: он путает и плохо работает в БД. Говорите «hash partitioning».
Compound key в Cassandra. Ключ (user_id, update_timestamp): пользователь определяет партицию, внутри неё записи отсортированы по времени. Удобно для связи «один ко многим».
Горячий ключ. Хеш не спасает, если все запросы идут к одному ключу (например, известный пользователь с миллионами подписчиков). Большинство систем не лечат это автоматически. Приложение добавляет к ключу случайное число (например, 00-99) и распределяет записи по 100 ключам. Тогда чтение должно читать все 100 ключей и объединять. Нужно отслеживать, какие ключи разделены.
Партиционирование и вторичные индексы
Заголовок раздела «Партиционирование и вторичные индексы»Вторичный индекс ищет значения (цвет, марка), а не уникальный ключ. Он не ложится на партиции сам. Есть два подхода.
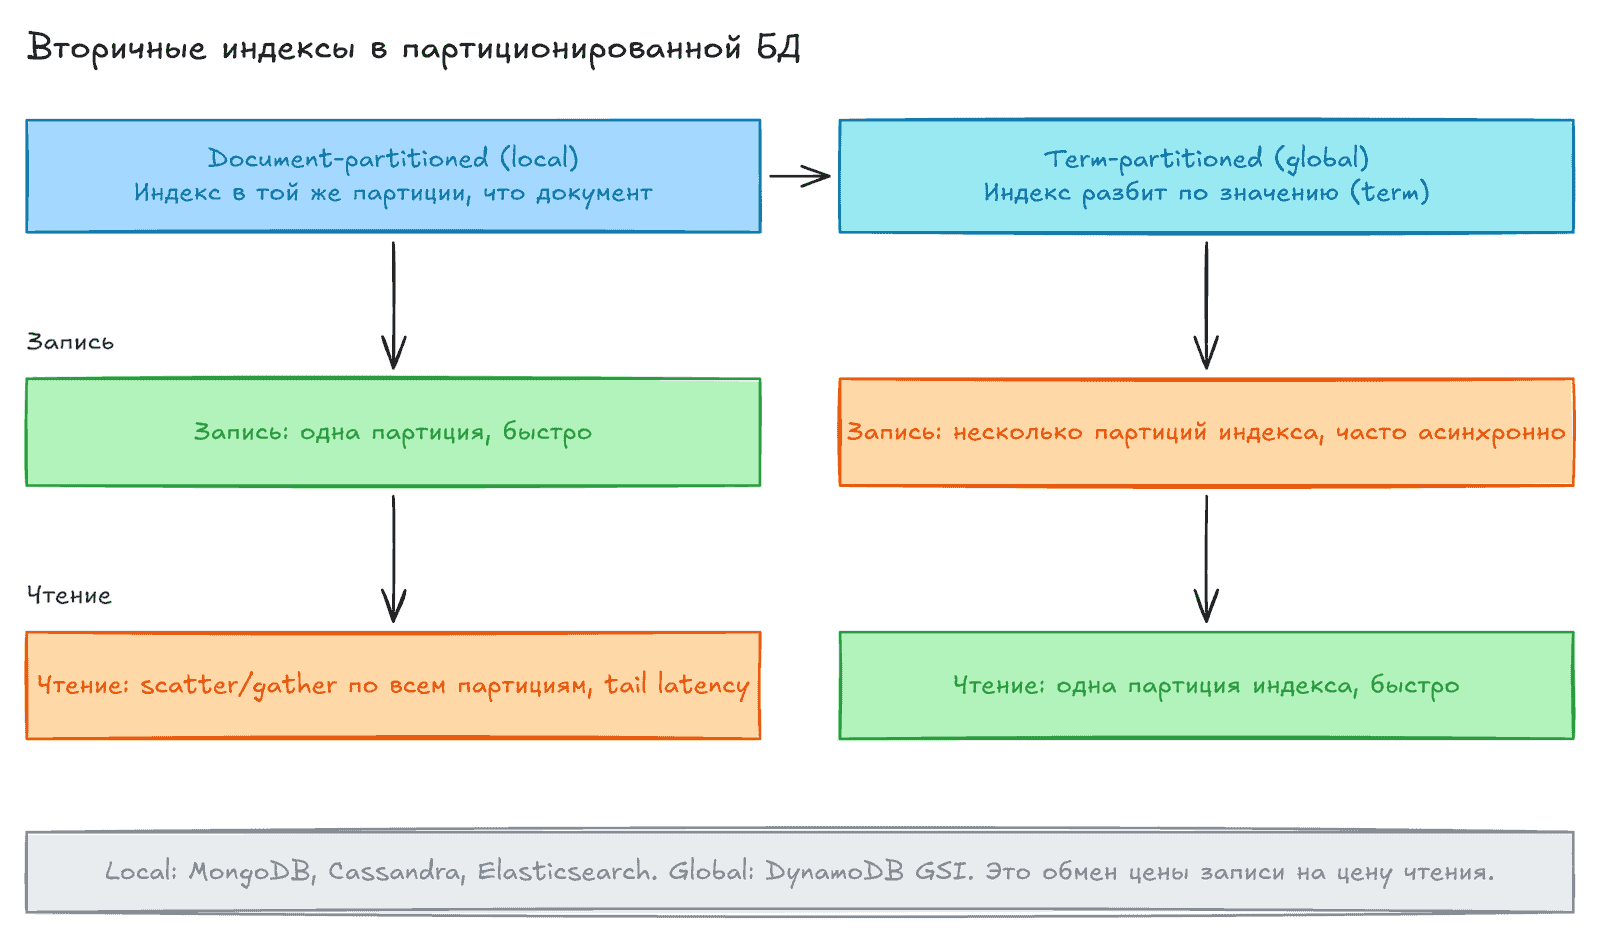
| Document-partitioned (local) | Term-partitioned (global) | |
|---|---|---|
| Где индекс | В той же партиции, что документы | Отдельно, разбит по значению term (или его хешу) |
| Запись | Затрагивает одну партицию | Затрагивает несколько партиций индекса |
| Чтение | scatter/gather по всем партициям, растёт tail latency | Одна партиция индекса |
| Свежесть | Всегда согласован с данными | Обновляется часто асинхронно |
| Примеры | MongoDB, Cassandra, Elasticsearch, SolrCloud, VoltDB | DynamoDB global secondary indexes, поиск в Riak, Oracle DWH |
Разбиение global-индекса по самому term удобно для range scan (цена). Разбиение по хешу term даёт ровную нагрузку. Синхронный global-индекс требует распределённой транзакции, поэтому его обычно обновляют асинхронно. Тогда чтение сразу после записи может не увидеть изменение.
Rebalancing партиций
Заголовок раздела «Rebalancing партиций»Rebalancing это перенос данных между узлами. Он нужен при росте нагрузки, росте данных и отказе узла. Требования: нагрузка справедливо распределена, база принимает запросы во время переноса, переносится минимум данных.
| Стратегия | Суть | Плюсы и минусы |
|---|---|---|
hash mod N | Номер узла = хеш по модулю числа узлов | Плохо. При смене N переезжает почти всё |
| Fixed number of partitions | Много партиций заранее, узлы забирают целые партиции | Просто. Число партиций надо выбрать с запасом. Слишком много партиций дают лишние расходы. Riak, Elasticsearch, Couchbase, Cassandra с версии 1.2 |
| Dynamic partitioning | Партиция делится при превышении размера и сливается при уменьшении | Число партиций следует за объёмом. Пустая база стартует с одной партиции, поэтому нужен pre-splitting. HBase, RethinkDB, MongoDB |
Cassandra до версии 1.2 использовала одну большую партицию на узел со случайными границами. Добавлять узлы было дорого и нагрузка распределялась плохо, поэтому от этого отказались.
Автоматически или вручную. Автоматика удобна, но непредсказуема. Rebalancing нагружает сеть и узлы. Вместе с автоматическим детектором отказов возможен каскад: медленный узел сочтён мёртвым, нагрузка уходит на другие, они тоже замедляются. Поэтому часто нужен человек в цикле. Couchbase, Riak и Voldemort предлагают план, но ждут подтверждения.
Маршрутизация запросов (request routing)
Заголовок раздела «Маршрутизация запросов (request routing)»Клиент должен знать, к какому узлу идти. Это общая задача service discovery.
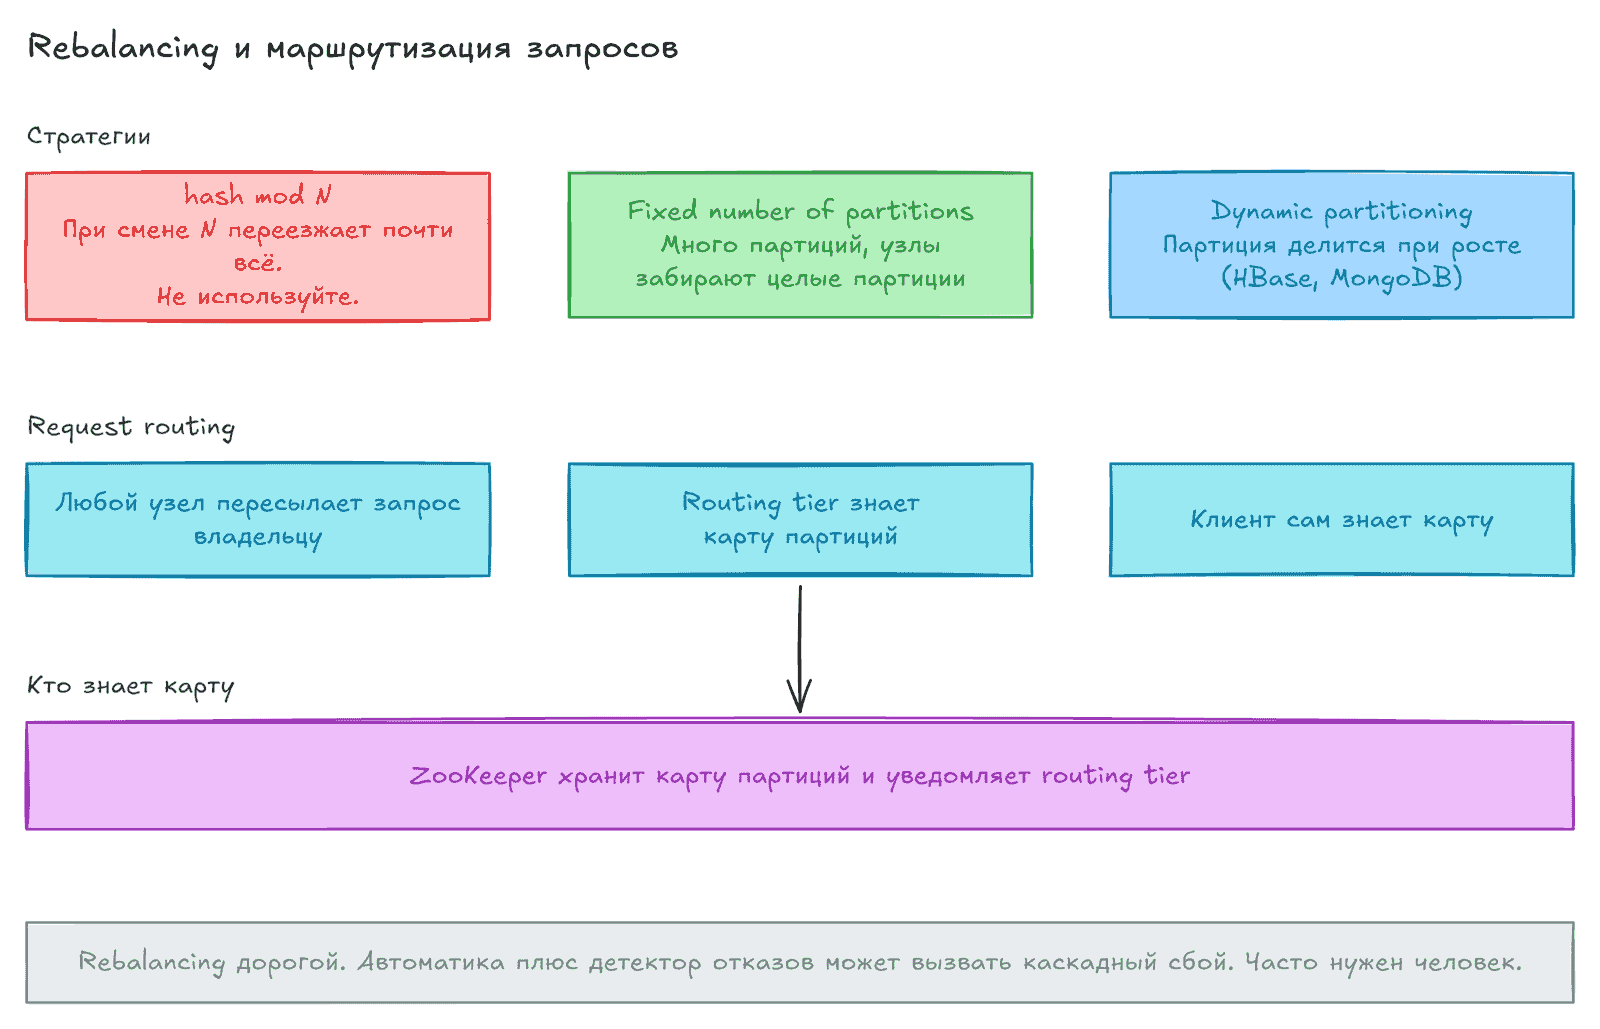
- Клиент обращается к любому узлу. Узел сам пересылает запрос владельцу партиции.
- Запросы идут в routing tier, он знает карту партиций и перенаправляет (partition-aware load balancer).
- Клиент сам знает карту и подключается напрямую.
Главная проблема: как все участники узнают об изменении карты. Многие системы используют сервис координации ZooKeeper. Узлы регистрируются в нём, routing tier подписывается на изменения. Так делают HBase, SolrCloud, Kafka. LinkedIn Espresso использует Helix. MongoDB имеет свой config server и mongos как routing tier. Cassandra и Riak используют gossip protocol между узлами и маршрутизацию через любой узел. IP-адреса меняются реже, чем карта партиций, поэтому часто хватает DNS.
Параллельное выполнение запросов
Заголовок раздела «Параллельное выполнение запросов»Простые NoSQL-хранилища поддерживают чтение и запись по одному ключу и scatter/gather. Системы MPP (massively parallel processing) для аналитики сложнее. Оптимизатор разбивает запрос с join, фильтрами и агрегацией на этапы и выполняет их параллельно на разных узлах. Больше всего выигрывают запросы, сканирующие большие части данных. Детали в главе 10.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Partition / shard | Часть данных, лежащая на одном узле |
| Skew | Неравномерное распределение данных или нагрузки |
| Hot spot | Партиция с непропорционально высокой нагрузкой |
| Key range partitioning | Партиция владеет непрерывным диапазоном ключей |
| Hash partitioning | Партиция владеет диапазоном хешей ключа |
| Compound primary key | Составной ключ: часть определяет партицию, часть порядок |
| Local (document-partitioned) index | Индекс внутри партиции документа |
| Global (term-partitioned) index | Индекс, разбитый отдельно, по term |
| Scatter/gather | Запрос ко всем партициям с объединением результатов |
| Rebalancing | Перенос партиций между узлами |
| Pre-splitting | Создание начальных партиций в пустой БД |
| Request routing | Выбор узла для запроса |
| ZooKeeper | Сервис координации, хранит карту партиций |
| Gossip protocol | Узлы обмениваются информацией о состоянии кластера |
| MPP | Параллельное выполнение запросов в аналитических БД |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте ключ партиции под запросы. Партиционирование по дате в таблице событий создаёт hot spot на последней партиции. Добавьте ещё одно поле (источник, user ID).
- Партиции в хранилищах и lakehouse. Партиционирование по дате удобно для чтения диапазонов и удаления старых данных. Слишком мелкие партиции дают много маленьких файлов и расходов.
- Следите за skew. Один ключ с огромным числом строк тормозит join и агрегации. Решение: salting (случайный суффикс), но читать придётся со всех частей.
- Считайте цену вторичных индексов. Local-индекс удешевляет запись, но удорожает чтение. Global-индекс наоборот и может отставать.
- Не используйте
hash mod N. Берите фиксированное число партиций или динамическое деление. - Rebalancing в продакшене. Планируйте его вне пиков и не включайте слепое автоматическое. Следите за сетью и нагрузкой.
- Партиционирование это основа и для потоков. Партиции Kafka подчиняются тем же правилам: порядок только внутри партиции, ключ определяет партицию.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем key range partitioning отличается от hash partitioning? Когда выбрать каждый?
- Почему timestamp как первая часть ключа создаёт hot spot? Как это исправить?
- Какая разница между local и global вторичным индексом по цене записи и чтения?
- Почему
hash mod Nплох для rebalancing? Какие две стратегии лучше?
Предыдущая: Репликация. Следующая: Транзакции.