

Fundamentals of Data Engineering, глава 5: Источники данных
Главная мысль: Источники данных (source systems) обычно не в вашей власти. Но их устройство определяет, как вы будете забирать, хранить и считать данные. Нужно понимать, как источник создаёт данные, и договариваться с его владельцами.
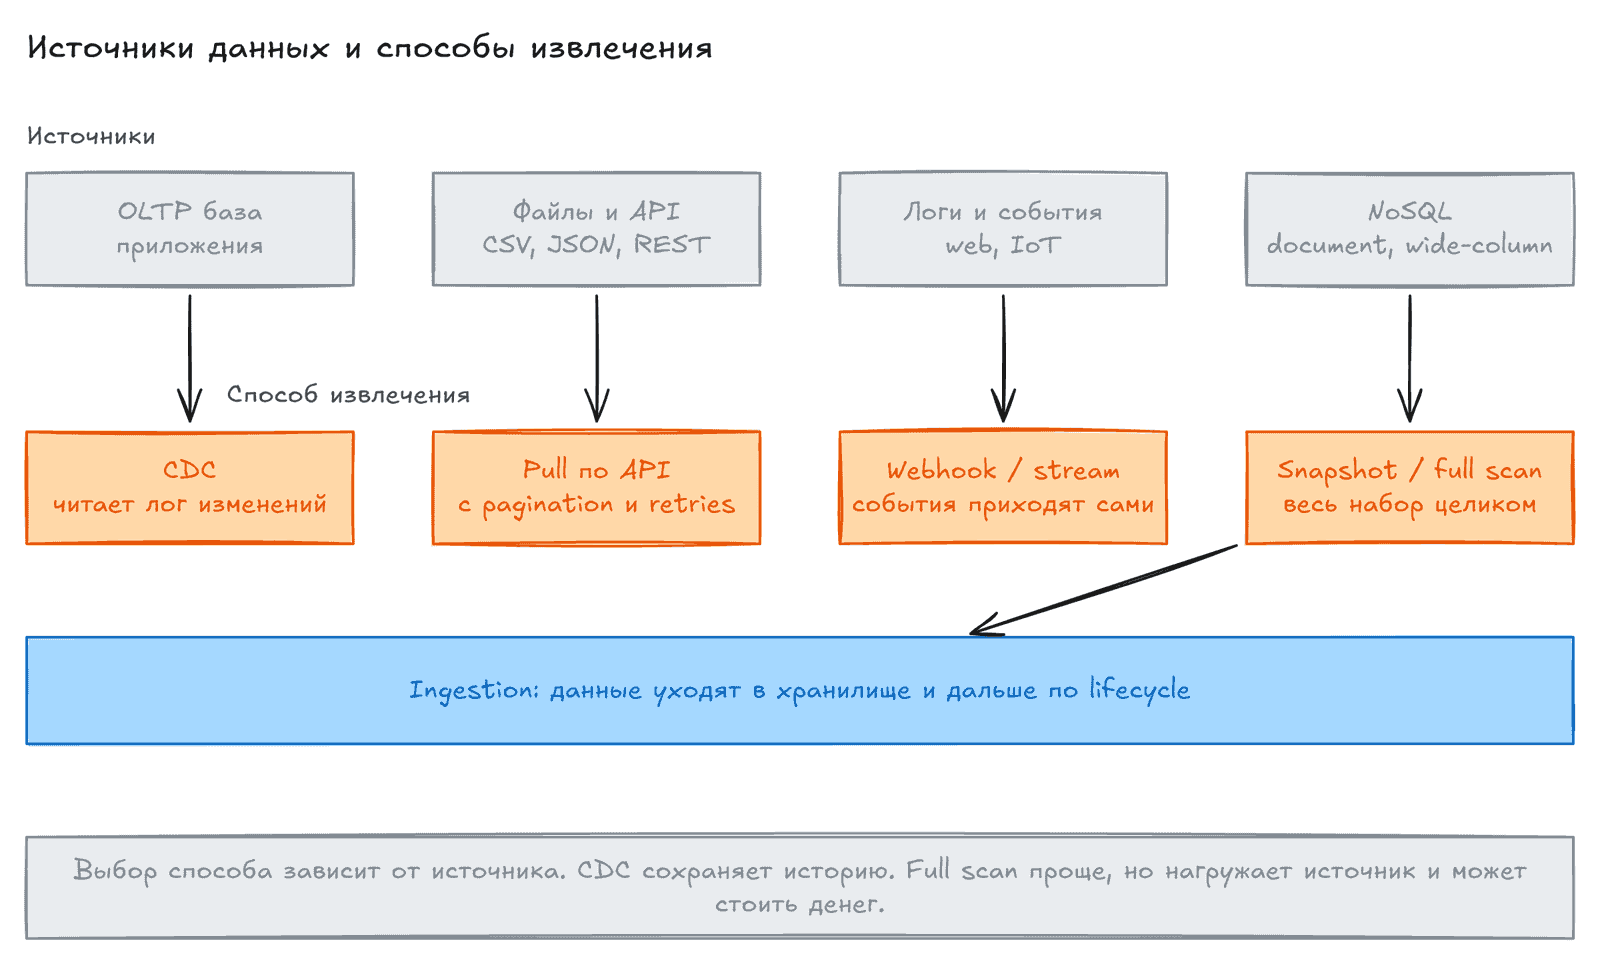
Основные идеи
Заголовок раздела «Основные идеи»| Источник | Что важно знать |
|---|---|
| Файлы | Excel, CSV, TXT, JSON, XML. Универсальный способ обмена. Есть у структурированных, полуструктурированных и неструктурированных данных |
| API | Стандартный обмен между системами. На практике часто сложны, нужен свой код и поддержка |
| OLTP (online transaction processing) | База приложения. Много быстрых чтений и записей отдельных строк |
| OLAP (online analytical processing) | База для больших аналитических запросов. Плохо ищет отдельные записи. Из неё тоже читают: для ML и reverse ETL |
| CDC (change data capture) | Каждое изменение (insert, update, delete) как событие. Репликация почти в реальном времени |
| Логи | Записи о событиях системы |
| Очереди и потоки | Сообщения между системами |
OLTP и ACID
Заголовок раздела «OLTP и ACID»OLTP-база хранит состояние приложения, например баланс счёта. Она держит тысячи операций в секунду.
ACID означает atomicity, consistency, isolation, durability. Это гарантии:
- Atomicity. Набор изменений применяется целиком или не применяется совсем. Пример: перевод денег между счетами.
- Consistency. Чтение возвращает последнюю записанную версию.
- Isolation. Параллельные изменения дают тот же результат, что и последовательные.
- Durability. Подтверждённые данные не теряются даже при отключении питания.
Не все базы дают ACID. Ослабление гарантий (например, eventual consistency) повышает скорость и масштаб. Нужно знать, какая модель у вашего источника.
Аналитика прямо на OLTP работает у небольших компаний. Но она не масштабируется. Тяжёлые запросы мешают приложению. Приложения, которые сочетают транзакции и аналитику, книга называет data application.
Минимум в логе: кто, что произошло, когда.
| Кодирование | Свойства |
|---|---|
| Binary | Компактно и быстро. Пример: логи баз данных |
| Semistructured | Текст, чаще JSON. Читается машиной, но нужен свой код разбора |
| Plain text | Вывод консоли. Нет стандарта, разбирать сложно |
Также важны resolution (сколько деталей события записано) и level (какие события пишутся: все или только ошибки).
Write-ahead log базы хранит каждую операцию до подтверждения записи. По нему база восстанавливается после сбоя. По нему же работает CDC.
Шаблоны хранения изменений
Заголовок раздела «Шаблоны хранения изменений»| Шаблон | Как работает | Минус |
|---|---|---|
| CRUD (create, read, update, delete) | Запись обновляется на месте. История теряется | Для истории нужен snapshot или CDC |
| Insert-only | Новая версия записи вставляется с timestamp | Таблица растёт. Текущее значение ищется через MAX(timestamp), это дорого |
Сообщения и потоки
Заголовок раздела «Сообщения и потоки»- Message — отдельный сигнал от одной системы к другой. После доставки он удаляется из очереди.
- Stream — упорядоченный append-only лог событий. Хранится неделями или месяцами. Можно агрегировать и перечитывать с нужной точки.
Платформы потоков можно использовать и для сообщений. Часто сообщения копят в потоке для последующей аналитики.
Типы времени
Заголовок раздела «Типы времени»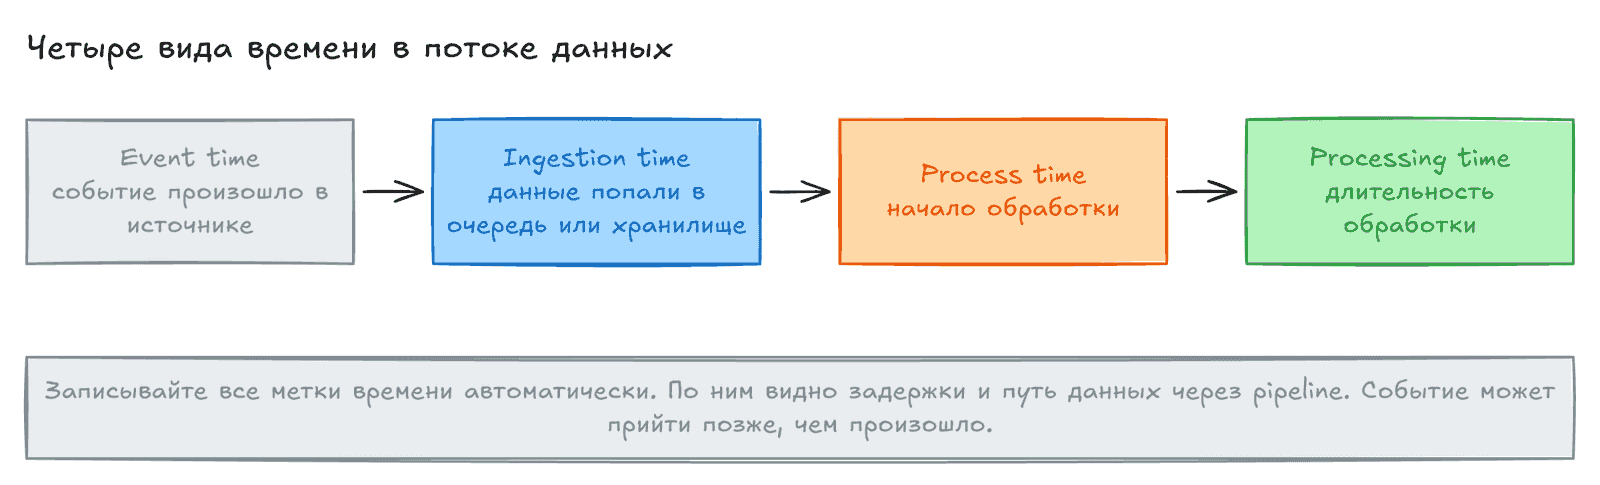
- Event time — когда событие произошло в источнике.
- Ingestion time — когда оно попало в систему приёма.
- Process time — когда его обработали.
- Processing time — сколько длилась обработка.
Записывайте все эти метки автоматически. Так видно путь данных и задержки.
Базы данных: на что смотреть
Заголовок раздела «Базы данных: на что смотреть»Для любой базы выясните: как она ищет данные (индексы: B-tree, LSM), есть ли optimizer, как масштабируется (horizontal или vertical), какая модель данных, как работает CRUD, какая consistency.
Реляционные базы (RDBMS)
Заголовок раздела «Реляционные базы (RDBMS)»- Данные в таблицах со строками и колонками, у всех строк одна схема.
- Primary key уникален. Foreign key связывает таблицы.
- Нормализация убирает дубли данных.
- Обычно ACID. Хорошо подходят для часто меняющегося состояния приложения.
- Задача data engineer: как сохранить состояние во времени.
NoSQL отказывается от части свойств RDBMS (строгая consistency, joins, фиксированная схема) ради скорости, масштаба и гибкости.
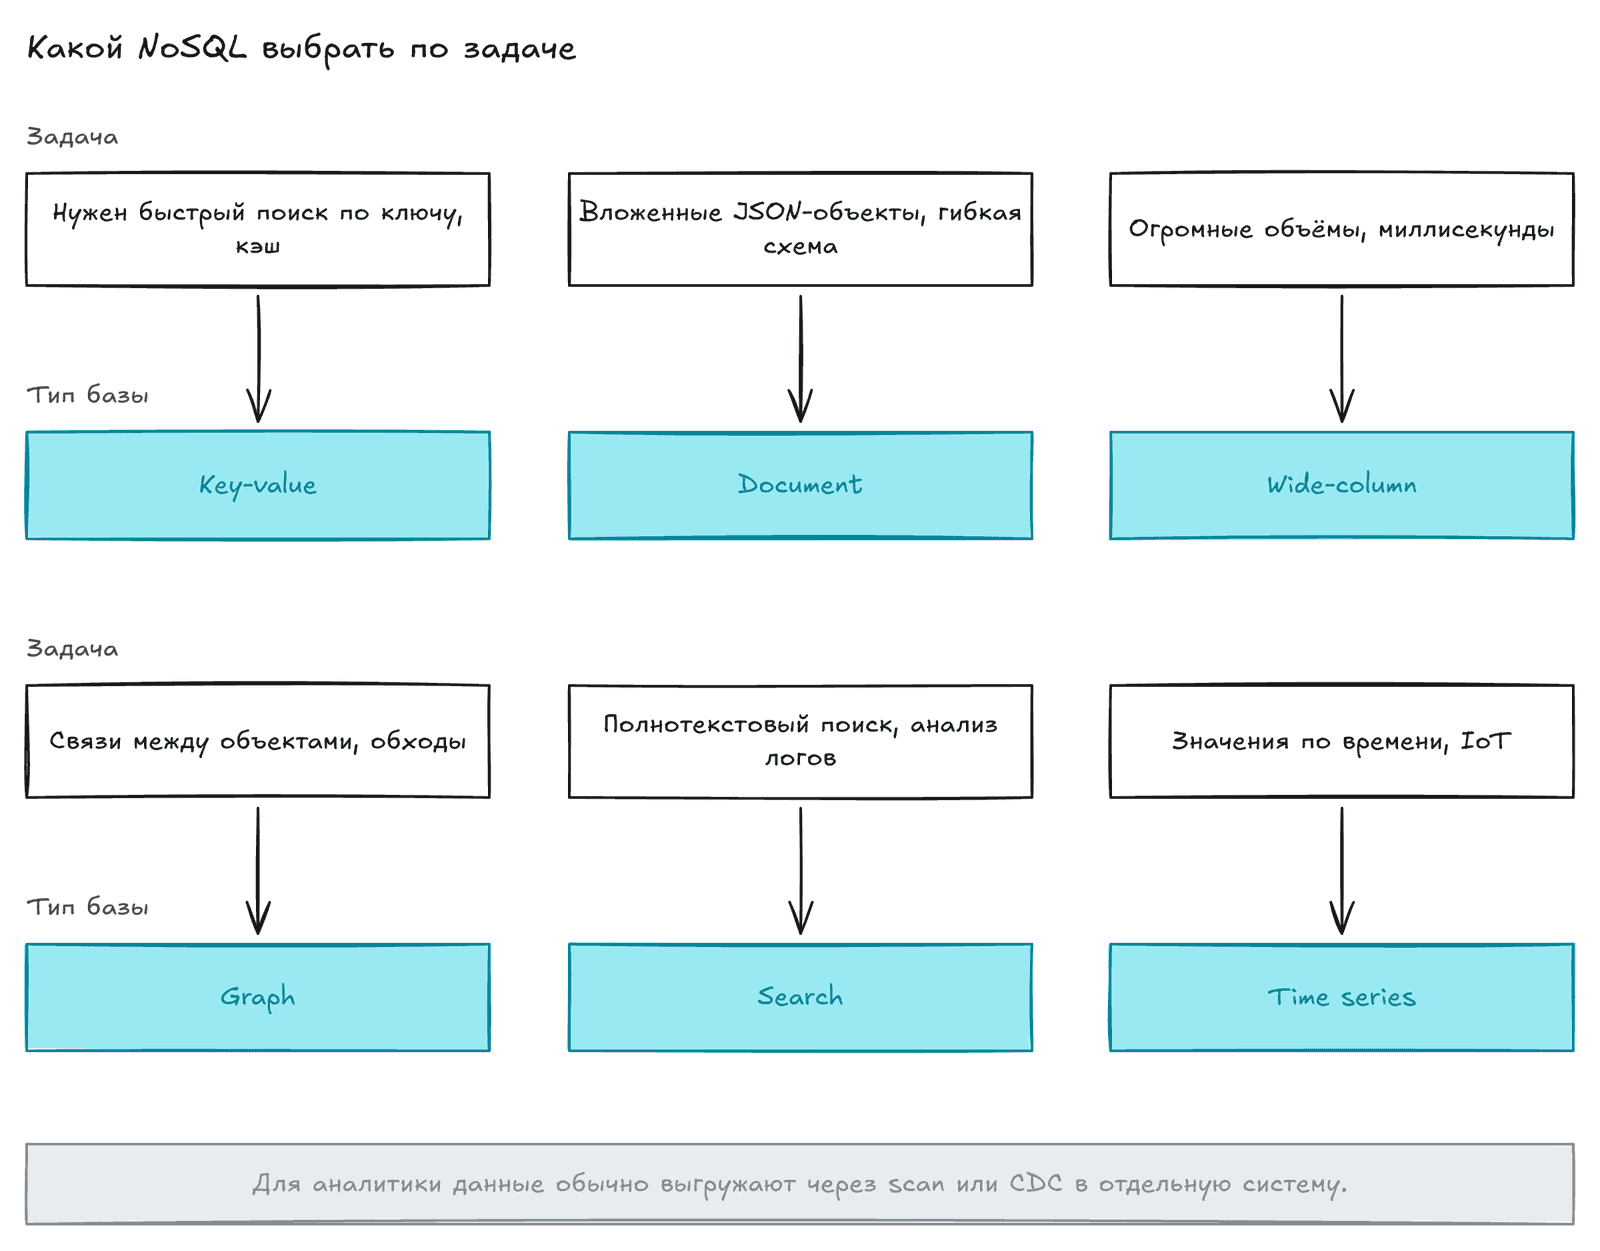
| Тип | Для чего | Что учесть при извлечении |
|---|---|---|
| Key-value | Кэши сессий, быстрый поиск по ключу | Хранилище в памяти может быть временным |
| Document | Вложенные JSON-документы в collections | Нет joins, схема не навязана. Смена схемы ломает загрузку. Обычно нет ACID. Полный scan замедляет базу и может стоить денег |
| Wide-column | Огромные объёмы, миллионы запросов в секунду, задержка до 10 мс | Один индекс (row key). Сложные запросы делают во внешней системе. Данные берут scan или CDC |
| Graph | Связи между объектами: узлы и рёбра | Можно переложить в строки, анализировать на месте или взять специальный инструмент |
| Search | Текстовый поиск и анализ логов (Elasticsearch, Solr, Algolia) | Данные для KPI-отчётов нужно выгружать |
| Time series | Значения по времени: IoT, метрики, fintech | Мало joins, хорош для операционной аналитики, не для BI |
| Тип | Суть |
|---|---|
| REST | Доминирующий подход. Построен на HTTP-методах. Каждый вызов независим (stateless). Нужно знать предметную область |
| GraphQL | Язык запросов от Facebook. Несколько моделей данных за один запрос. Ответ повторяет форму запроса |
| Webhooks | Источник сам вызывает ваш HTTP endpoint при событии. Их называют reverse API |
| RPC и gRPC | Вызов процедуры на удалённой системе. gRPC работает на Protocol Buffers и HTTP/2, он эффективнее по CPU и трафику |
Для REST часто есть client libraries и готовые коннекторы. Но для многих API всё равно придётся писать и поддерживать свой код: разобрать структуру, выбрать способ синхронизации.
Data sharing и сторонние данные
Заголовок раздела «Data sharing и сторонние данные»- Data sharing: владелец открывает данные арендаторам (tenants) в облачном хранилище или warehouse. Можно фильтровать строки и колонки. Внутри компании это помогает децентрализации, например data mesh.
- Data marketplace: место, где поставщики продают данные.
- Third-party data: данные организаций и госорганов. Доступ через API, data sharing или скачивание файла.
- Типичная цепочка: данные из CRM, scoring модель, затем reverse ETL обратно в CRM.
Очереди сообщений и event-streaming платформы
Заголовок раздела «Очереди сообщений и event-streaming платформы»Message queue
Заголовок раздела «Message queue»Асинхронная передача небольших сообщений между системами по модели publish/subscribe. Получатель подтверждает приём, и сообщение удаляется. Очередь развязывает сервисы и сглаживает пики нагрузки.
Что учесть:
- Порядок. Часто он нестрогий. SQS standard даёт best effort, SQS FIFO даёт сильные гарантии, но дороже. Проектируйте систему так, чтобы порядок не был обязателен.
- Доставка. Exactly once или at least once. При at least once возможны дубли.
- Idempotent. Обработка сообщения несколько раз даёт тот же результат, что один раз. Это защита от дублей.
- Масштаб. Очереди масштабируются горизонтально. Цена: дубли и нестрогий порядок.
Event-streaming platform
Заголовок раздела «Event-streaming platform»Событие состоит из key, value и timestamp. Платформа хранит события и позволяет перечитать их с прошлого момента.
- Topic — набор связанных событий (например, заказы). У topic может быть много producers и consumers.
- Partition — часть потока для параллельной обработки. Сообщения с одним partition key попадают в одну partition.
- Hotspotting — перекос, когда одна partition получает непропорционально много сообщений. Выбирайте ключ, который распределяет нагрузку равномерно. Плохой ключ: штат США при IoT-устройствах.
- Fault tolerance — поток хранится на нескольких узлах. Запись не теряется при отказе узла.
С кем работать
Заголовок раздела «С кем работать»Есть два типа stakeholders:
- Systems stakeholders строят и поддерживают источник: разработчики, внешние поставщики.
- Data stakeholders владеют данными и доступом: IT, data governance.
Нужна обратная связь с ними. Схема или данные изменятся, и вы должны узнать об этом заранее.
- Data contract — письменное соглашение между владельцем источника и командой приёма. В нём: какие данные, метод (full или incremental), частота, контакты. Хранить лучше в репозитории или wiki.
- SLA — ожидания от источника. SLO — измеримая цель, например аптайм 99%.
Undercurrents для источников
Заголовок раздела «Undercurrents для источников»| Область | Вопросы |
|---|---|
| Security | Шифрование при хранении и передаче. VPN или публичный интернет. Секреты в менеджере ключей. Можно ли доверять источнику |
| Data management | Governance, quality, schema, master data, privacy, регуляторные ограничения |
| DataOps | Автоматизация (развязать с автоматизацией источника), observability (аптайм, schema, качество), incident response и backfill |
| Data architecture | Reliability, durability, availability, кто отвечает за систему |
| Orchestration | Расписание данных, общие инструменты вроде Kubernetes или Airflow. Баланс между интеграцией и сильной связанностью |
| Software engineering | Сеть, authentication и authorization, access patterns (pagination, retries, timeouts), parallelization, deployment |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Source system | Система, где данные возникают |
| OLTP | База для частых быстрых операций над записями |
| OLAP | Система для больших аналитических запросов |
| ACID | Набор гарантий транзакций |
| CDC | Захват каждого изменения в базе |
| Write-ahead log | Лог операций, записанный до подтверждения |
| Insert-only | Шаблон: новые версии вместо обновления |
| Event time / ingestion time | Время события и время приёма |
| Idempotent | Повтор операции не меняет результат |
| Partition key | Ключ распределения сообщений по partitions |
| Hotspotting | Перекос нагрузки на одну partition |
| Data contract | Соглашение об извлечении данных из источника |
| Webhook | Вызов вашего endpoint из источника при событии |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Прочитайте документацию источника. Узнайте, как он пишет, коммитит и индексирует данные.
- Не запускайте тяжёлую аналитику на production OLTP. Используйте реплику, CDC или выгрузку.
- Для истории изменений берите CDC или insert-only. Простой snapshot теряет промежуточные версии.
- Делайте обработку idempotent. Дубли и нарушенный порядок в очередях неизбежны.
- Пишите event, ingestion и process time. Иначе трудно разобрать задержки.
- Заключите data contract или хотя бы устное соглашение. Настройте уведомления об изменении схемы.
- Храните секреты в менеджере. Не кладите их в код и репозиторий.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему аналитические запросы на OLTP не масштабируются?
- Чем message queue отличается от stream?
- Как выбрать partition key и чем опасен hotspotting?
- Что должно быть в data contract с владельцем источника?
Предыдущая: Выбор технологий. Следующая: Хранение.