

The Data Warehouse Toolkit, глава 20: Разработка ETL
Главная мысль: ETL разрабатывают по шагам. Сначала план и стратегии. Потом историческая загрузка dimensions и facts. Потом инкрементальная загрузка, которая работает без людей и безопасно перезапускается.
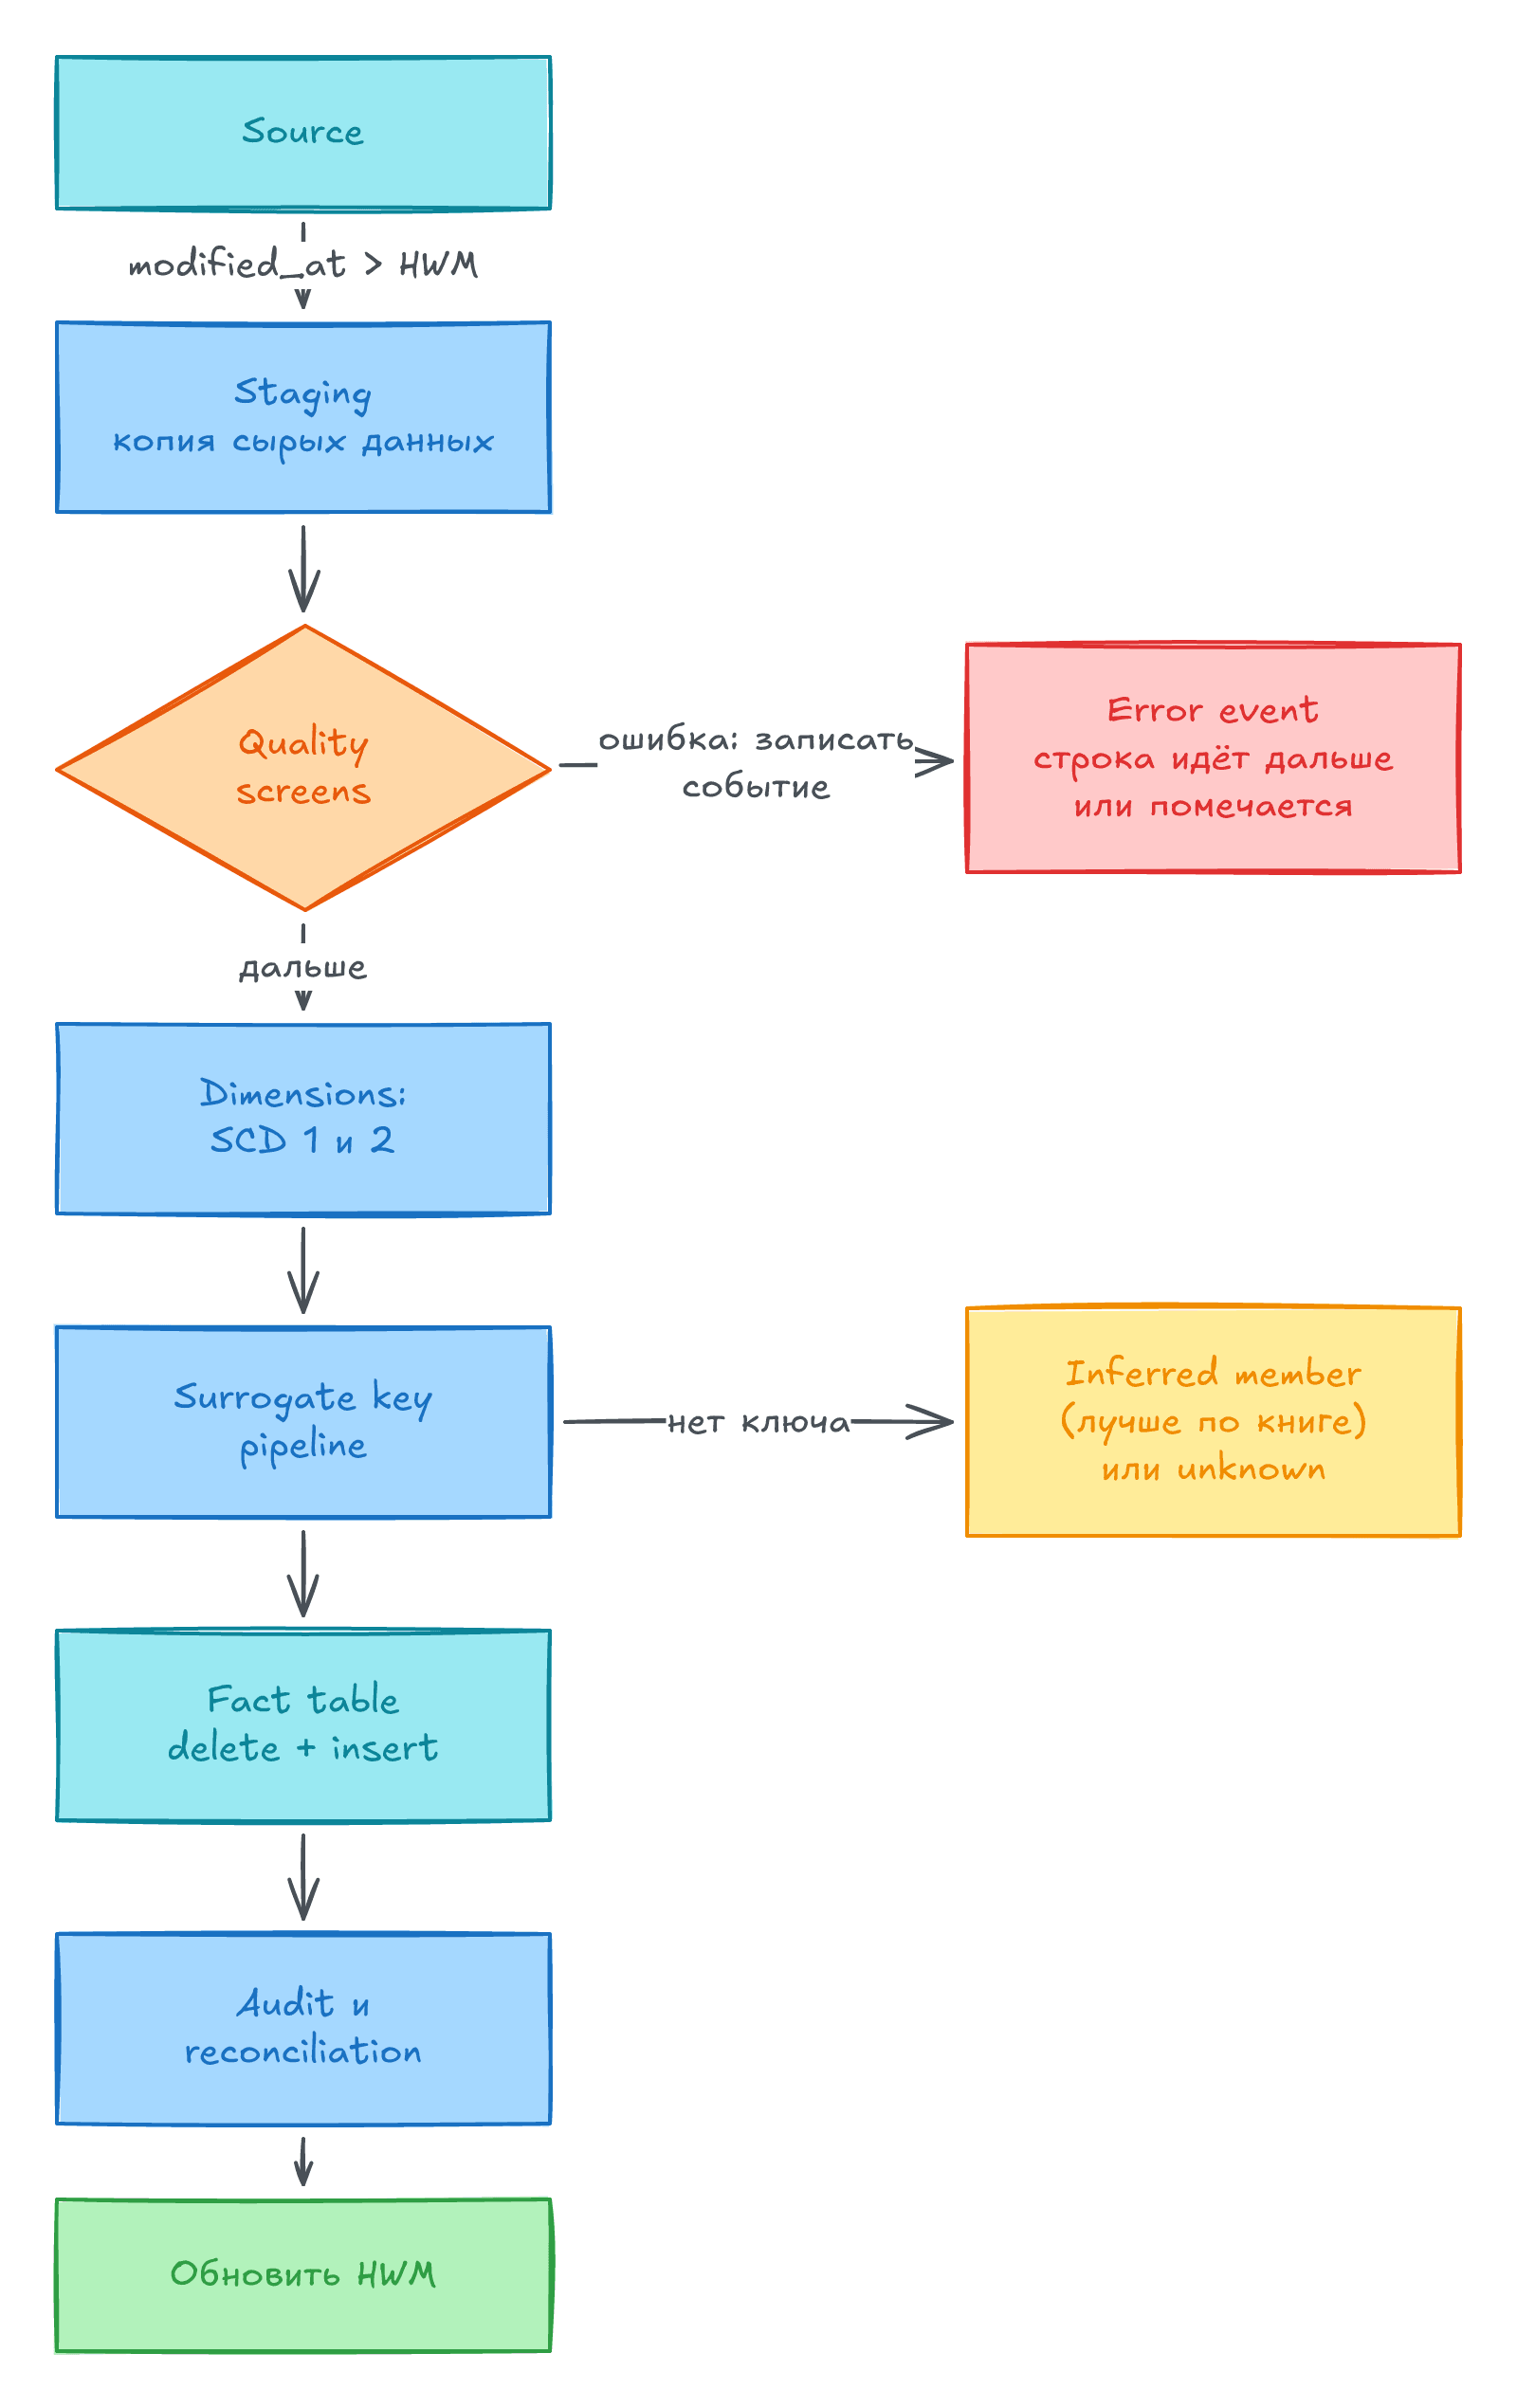
10 шагов
Заголовок раздела «10 шагов»| Шаг | Что делаем |
|---|---|
| 1. High-level plan | Схема: источники, цели, потоки данных |
| 2. Выбор ETL tool | Решаем до детального плана. Иначе придётся переделывать. Выгода от инструмента приходит в следующих фазах, не в первой |
| 3. Default strategies | Общие правила для всех таблиц |
| 4. Drill down по таблицам | Детальный план для каждой целевой таблицы |
| 5. Историческая загрузка dimensions | Чистка, ключи, загрузка |
| 6. Историческая загрузка facts | Большой объём, surrogate key pipeline |
| 7. Инкрементальные dimensions | Новые и изменённые строки, SCD |
| 8. Инкрементальные facts | Автоматическая загрузка, late arriving |
| 9. Агрегаты и OLAP | Пересчёт после загрузки |
| 10. Работа и автоматизация | Расписание, обработка ошибок, lights-out |
Шаги 1-4. План
Заголовок раздела «Шаги 1-4. План»- Перед дизайном ETL должны быть готовы логическая модель, план архитектуры и черновой source-to-target mapping.
- Подумайте, где будет работать преобразование: на источнике, на целевой системе или на отдельной платформе. И какую нагрузку можно создать на источник.
- Начните с простой схемы: источники слева, цели справа.
- Default strategies — общие ответы на вопросы:
- как извлекаем данные из каждого источника (файл, поток, чтение логов);
- как архивируем извлечённые данные (минимум месяц);
- как проверяем качество dimensions и особенно facts;
- как применяем изменения атрибутов dimensions (SCD);
- как выполняем требования к доступности: когда готов каждый источник, порядок задач;
- как помечаем каждую строку audit-информацией;
- как устроена staging area.
- Для каждой целевой таблицы дальше пишут отдельный план: источники, правила, порядок загрузки. Dimensions грузятся раньше facts.
- Проверьте, что иерархии чистые. Надёжнее всего иерархии, которые источник хранит в нормализованных таблицах с FK. Иерархию из Excel нужно чистить или признать, что это не иерархия.
- Попросите sandbox-копию источника. Там можно исследовать данные, не нагружая production.
Шаг 5. Историческая загрузка dimensions
Заголовок раздела «Шаг 5. Историческая загрузка dimensions»Dimension с одним источником — самый простой случай. Но даже он требует чистки.
| Задача | Пример |
|---|---|
| Простые преобразования | Тип данных, регистр, пробелы. NULL в dimension заменяйте значением по умолчанию |
| Объединение источников | Клиенты из CRM и из биллинга |
| Расшифровка кодов | M в «Мужской» |
| Проверка связей «многие к одному» | Один бренд — одна категория. Иначе иерархия сломана |
| Присвоение surrogate keys | После dedup. Key map «natural key → surrogate key» храните в staging, он нужен для facts |
| Загрузка | Строка Unknown в каждый dimension |
- Начинайте с простых type 1 dimensions. Потом type 2.
- Историю type 2 восстановить трудно, иногда невозможно. Бизнес хочет историю до запуска хранилища, а не с даты запуска.
- После восстановления истории проставьте даты окончания без разрывов. Если grain дат — день, конец старой версии = день до начала новой.
- Грузите bulk loader: без логирования, отсортированный файл,
TRUNCATEперед полной перезаливкой. - Date dimension и другие статические dimensions строят один раз, часто в таблице. Бизнес должен их утвердить.
Шаг 6. Историческая загрузка facts
Заголовок раздела «Шаг 6. Историческая загрузка facts»- Главная проблема — объём. Зато таблица ещё не в production. Загрузка может идти несколько дней.
- Извлекайте только полезные для бизнеса строки. Не берите всё подряд.
- Считайте audit statistics: число строк, суммы. Они должны сходиться с отчётами источника. Если точно не сходится, объясните разницу.
- Специальное значение вроде
-1в fact замените на настоящийNULL.NULLв мерах — нормально. FK в fact — всегдаNOT NULL. - Все facts одного grain. Итоги за год в дневной fact-таблице нужно убрать.
- Surrogate key pipeline — последний шаг перед загрузкой. Dimensions к этому моменту уже обработаны. Для type 2 используйте
BETWEENпо датам версии. - В исторической загрузке ошибки ссылочной целостности разбирают вручную: загрузку останавливают и исправляют dimension или фильтр извлечения.
- Audit key добавляют сразу до или после pipeline.
- Для больших таблиц: отключить FK и индексы, загрузить по партициям в параллель, включить индексы и FK.
Шаг 7. Инкрементальные dimensions
Заголовок раздела «Шаг 7. Инкрементальные dimensions»- Если можно, берите из источника только изменённые строки. Иначе берите снимок целиком и сравнивайте.
- Новые строки: ищем natural key в dimension. Нет — новая строка.
- Изменённые строки: сравниваем колонки или hash type 1 и hash type 2.
- Тип 1 меняет значение на месте. Тип 2 закрывает версию и добавляет новую.
- Удаление в источнике не значит удаление в dimension. На эту строку ссылаются факты.
- Дата начала новой версии — день, когда изменение стало известно. Дата окончания текущей — дальняя дата.
Шаг 8. Инкрементальные facts
Заголовок раздела «Шаг 8. Инкрементальные facts»Инкрементальная загрузка должна быть полностью автоматической.
- Extract и checkpoint качества. Сырые данные пишут в staging. Это архив и точка перезапуска. Тут же считают метрики качества.
- Transformations и surrogate key pipeline. Для строк без ключа нужна автоматическая политика:
| Политика | Когда подходит |
|---|---|
| Остановить загрузку | Почти никогда |
| Отбросить строку | Если пропуск означает «данные не нужны» |
| Записать в error table | Нужен процесс разбора. Не подходит для финансов, где нужны все строки |
| Inferred member (dummy-строка на этот natural key) | Лучший вариант. Позже строку обновляют как type 1 |
| Один unknown member на всех | Не рекомендуется: все неизвестные ключи сливаются в одну строку |
- Late arriving facts. Загрузка идёт после полуночи, но данные могут быть старше. Для type 2 dimension берите версию на дату события.
- Загрузка. Fast load обычно требует пустую таблицу или таблицу без индексов. Поэтому для инкремента часто подходит обычный insert. Если fact разбит на партиции и инкремент идёт в пустую партицию, используйте fast load. Дневные партиции потом объединяют в месячные.
- Snapshot facts. Transaction fact — только insert. Periodic snapshot грузят в конце месяца. Текущий месяц можно перезаливать каждый день, удобно при месячных партициях. Accumulating snapshot — много update, но таблица маленькая.
Если загрузка не успевает, есть три пути:
- грузить чаще: ночью вместо раз в месяц. Часть чистки можно делать в течение дня;
- обрабатывать параллельно: независимые задачи или параллельное выполнение в базе. Учитывайте общие ресурсы, иначе параллельность не ускорит;
- parallel structures: грузить в offline-партицию, таблицу или сервер и быстро переключать на рабочую.
Шаги 9-10. Агрегаты и работа системы
Заголовок раздела «Шаги 9-10. Агрегаты и работа системы»- Агрегаты и OLAP пересчитывают после загрузки facts. Месячный агрегат требует обновления текущего месяца.
- Type 1 изменение атрибута ломает все агрегаты по этому атрибуту. Их нужно перестроить.
- Агрегаты всегда должны совпадать с детальными данными.
- ETL должен работать без людей:
- расписание задач с зависимостями;
- автоматическая обработка предсказуемых ошибок (ранний факт,
NULLв поле); - понятные действия при непредсказуемых ошибках;
- уведомления и точки перезапуска.
- Все метрики операций пишите в таблицы. Это основа для мониторинга и reconciliation.
Real-time
Заголовок раздела «Real-time»Если спросить «нужен real-time?», почти все скажут «да». Такой ответ бесполезен. Книга делит запросы на три класса.
- Instantaneous: экран показывает текущее состояние источника. Обычно это EII: запросы идут прямо в источник.
- Intra-day: обновление много раз в день, micro-batch. Нужен поток изменений: message queue, лог, триггеры.
- Daily: данные на конец прошлого дня, после сверки в источнике. Самый надёжный вариант.
| Daily | Intra-day | Instantaneous | |
|---|---|---|---|
| Способ | Batch ETL | Micro-batch | Streaming |
| Данные | Reconciled | Provisional | Provisional |
| Проверки качества | Column, structure, business rule | Column и structure | Только column |
| Итоговые числа | Финальные | Исправляются ночью | Могут меняться |
Правило: чем ниже latency, тем меньше проверок качества. Низкая задержка даёт более грязные данные.
Компромиссы при real-time:
- заменить batch-файлы потоком из message queue или лога. Но такие данные сырые: неполные транзакции, неразрешённые ключи;
- ограничить quality screens column screens. Structure и business rule screens не успевают;
- публиковать ранние facts со старыми копиями dimensions (или с пустыми версиями). Позже dimensions обновятся;
- убрать staging. Тогда обсудите с руководством backup, восстановление, архив и compliance;
- добавить real-time partition в presentation area. Та же структура, что у fact, почти без индексов, в памяти. Для transaction fact в ней данные с полуночи. Для monthly snapshot это текущий месяц, в конце месяца его присоединяют к основной таблице.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| High-water mark | Граница последней загруженной записи. Следующий запуск берёт всё новее |
| Idempotent load | Повторный запуск даёт тот же результат |
| Reconciliation | Сверка счётчиков и сумм между источником и хранилищем |
| Surrogate key pipeline | Замена natural keys на surrogate keys в fact |
| Inferred member | Заглушка в dimension для раннего факта |
| Late arriving fact | Событие, которое пришло позже срока |
| Real-time partition | Временная часть fact для свежих данных |
| Lights-out | Работа ETL без участия человека |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Храните HWM в таблице управления. Обновляйте его только после успешной загрузки.
- Берите HWM из данных (
max(modified_at)из staging), а не из часов. Иначе пропуски и дубли. - Делайте загрузку idempotent: удалите строки по бизнес-ключу и вставьте заново. Тогда любой перезапуск безопасен. В
dbtэто стратегияdelete+insertилиmergeдля incremental. - Пишите счётчики каждой загрузки в audit-таблицу. Сверяйте источник и хранилище.
- Не теряйте строки без ключа. Книга советует inferred member (см. практику главы 19). В практике ниже для простоты используем unknown member и пишем событие в error table.
- Не обещайте real-time без уточнения. Спросите, какое решение принимается и как быстро.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Решения тоже запускайте по порядку: каждое использует результат предыдущего.
Шаг 1. Источник, dimension и таблицы управления
Заголовок раздела «Шаг 1. Источник, dimension и таблицы управления»CREATE TABLE src_customer ASSELECT * FROM (VALUES ('C1', 'Иван', 'Москва'), ('C2', 'Анна', 'Казань'), ('C3', 'Олег', 'Самара')) t(customer_id, name, city);
CREATE TABLE src_orders ( order_id INT, customer_id VARCHAR, order_date DATE, amount DECIMAL(12,2), modified_at TIMESTAMP);
INSERT INTO src_orders VALUES (1, 'C1', DATE '2024-05-01', 100.00, TIMESTAMP '2024-05-01 10:00:00'), (2, 'C2', DATE '2024-05-01', 50.00, TIMESTAMP '2024-05-01 11:00:00'), (3, 'C3', DATE '2024-05-02', 70.00, TIMESTAMP '2024-05-02 09:00:00');
-- dimension со строкой Unknown (ключ 0)CREATE TABLE dim_customer ASSELECT 0 AS customer_key, NULL::VARCHAR AS customer_id, 'Unknown' AS name, 'Unknown' AS cityUNION ALLSELECT row_number() OVER (ORDER BY customer_id), customer_id, name, city FROM src_customer;
-- таблицы управления и аудитаCREATE TABLE etl_control ASSELECT 'orders' AS table_name, TIMESTAMP '1900-01-01' AS high_water_mark, 0 AS last_batch_id;
CREATE TABLE etl_batch_log ( batch_id INT, table_name VARCHAR, rows_extracted INT, rows_loaded INT, rows_unknown_member INT, new_hwm TIMESTAMP);
CREATE TABLE error_event (batch_id INT, order_id INT, reason VARCHAR);
-- grain: один заказCREATE TABLE fact_orders ( order_id INT, customer_key INT, order_date DATE, amount DECIMAL(12,2), batch_id INT);Задания
Заголовок раздела «Задания»1. Историческая загрузка. Загрузите все заказы в fact_orders через surrogate key lookup. Запишите строку в etl_batch_log. Сдвиньте high-water mark на максимальное modified_at.
Решение
CREATE TABLE stg_orders ASSELECT * FROM src_ordersWHERE modified_at > (SELECT high_water_mark FROM etl_control WHERE table_name = 'orders');
INSERT INTO fact_ordersSELECT s.order_id, coalesce(d.customer_key, 0), s.order_date, s.amount,       (SELECT last_batch_id + 1 FROM etl_control)FROM stg_orders sLEFT JOIN dim_customer d ON d.customer_id = s.customer_id;
INSERT INTO etl_batch_logSELECT c.last_batch_id + 1, 'orders',       (SELECT count(*) FROM stg_orders),       (SELECT count(*) FROM fact_orders WHERE batch_id = c.last_batch_id + 1),       (SELECT count(*) FROM fact_orders WHERE batch_id = c.last_batch_id + 1 AND customer_key = 0),       (SELECT max(modified_at) FROM stg_orders)FROM etl_control c;
UPDATE etl_controlSET high_water_mark = (SELECT max(modified_at) FROM stg_orders),    last_batch_id = last_batch_id + 1;
SELECT * FROM etl_control;SELECT * FROM etl_batch_log;
HWM стал 2024-05-02 09:00:00. В fact три строки.
2. Инкрементальная загрузка. В источнике на следующий день: заказ 2 исправлен (сумма 55), появились заказ 4 и заказ 5. У заказа 5 клиент C9 ещё не известен. Загрузите только новое. Для заказа 2 удалите старую версию и вставьте новую. Клиента, которого нет в dimension, отправьте на unknown member и запишите событие в error_event.
Решение
-- изменения в источнике (источник правят на месте)UPDATE src_ordersSET amount = 55.00, modified_at = TIMESTAMP '2024-05-03 08:00:00'WHERE order_id = 2;
INSERT INTO src_orders VALUES    (4, 'C1', DATE '2024-05-03', 120.00, TIMESTAMP '2024-05-03 09:00:00'),    (5, 'C9', DATE '2024-05-03',  30.00, TIMESTAMP '2024-05-03 10:00:00');
-- 1) staging: только строки новее HWMCREATE OR REPLACE TABLE stg_orders ASSELECT * FROM src_ordersWHERE modified_at > (SELECT high_water_mark FROM etl_control WHERE table_name = 'orders');
-- 2) очистка прошлой попытки этого batch и старых версий заказовDELETE FROM fact_orders WHERE order_id IN (SELECT order_id FROM stg_orders);DELETE FROM error_event WHERE batch_id = (SELECT last_batch_id + 1 FROM etl_control);
-- 3) события качестваINSERT INTO error_eventSELECT (SELECT last_batch_id + 1 FROM etl_control), s.order_id, 'клиент не найден в dim_customer'FROM stg_orders sLEFT JOIN dim_customer d ON d.customer_id = s.customer_idWHERE d.customer_key IS NULL;
-- 4) fact через surrogate key pipelineINSERT INTO fact_ordersSELECT s.order_id, coalesce(d.customer_key, 0), s.order_date, s.amount,       (SELECT last_batch_id + 1 FROM etl_control)FROM stg_orders sLEFT JOIN dim_customer d ON d.customer_id = s.customer_id;
-- 5) audit и HWMDELETE FROM etl_batch_log WHERE batch_id = (SELECT last_batch_id + 1 FROM etl_control);INSERT INTO etl_batch_logSELECT c.last_batch_id + 1, 'orders',       (SELECT count(*) FROM stg_orders),       (SELECT count(*) FROM fact_orders WHERE batch_id = c.last_batch_id + 1),       (SELECT count(*) FROM fact_orders WHERE batch_id = c.last_batch_id + 1 AND customer_key = 0),       (SELECT max(modified_at) FROM stg_orders)FROM etl_control c;
UPDATE etl_controlSET high_water_mark = (SELECT max(modified_at) FROM stg_orders),    last_batch_id = last_batch_id + 1WHERE EXISTS (SELECT 1 FROM stg_orders);
SELECT * FROM fact_orders ORDER BY order_id;SELECT * FROM etl_batch_log ORDER BY batch_id;SELECT * FROM error_event;
В batch 2 попали три строки: 2, 4 и 5. Fact содержит пять заказов. Заказ 2 имеет сумму 55, дубля нет. Заказ 5 получил ключ 0.
3. Idempotent re-run. Представьте, что загрузка упала после записи в fact, но до обновления HWM. Повторите шаги загрузки fact для тех же данных в stg_orders. Покажите, что число строк не изменилось. Потом покажите, что обычный INSERT без DELETE создал бы дубли.
Решение
SELECT count(*) AS rows_before FROM fact_orders;
-- повтор: delete по ключу и insertDELETE FROM fact_orders WHERE order_id IN (SELECT order_id FROM stg_orders);INSERT INTO fact_ordersSELECT s.order_id, coalesce(d.customer_key, 0), s.order_date, s.amount,       (SELECT last_batch_id FROM etl_control)FROM stg_orders sLEFT JOIN dim_customer d ON d.customer_id = s.customer_id;
SELECT count(*) AS rows_after, count(DISTINCT order_id) AS distinct_orders FROM fact_orders;
-- что было бы без DELETE: проверка на дубли в grainSELECT count(*) AS rows_if_plain_insertFROM (    SELECT order_id FROM fact_orders    UNION ALL    SELECT order_id FROM stg_orders);
Было 5 строк, осталось 5. Без DELETE стало бы 8 строк, и три заказа дублировались бы.
4. Reconciliation. Сверьте источник и fact: число строк, сумму и построчные расхождения. Затем сверьте etl_batch_log с fact.
Решение
-- итоги источника и хранилищаSELECT 'source' AS side, count(*) AS rows_cnt, sum(amount) AS total FROM src_ordersUNION ALLSELECT 'fact', count(*), sum(amount) FROM fact_orders;
-- построчные расхождения (должно вернуть 0 строк)SELECT coalesce(s.order_id, f.order_id) AS order_id, s.amount AS src_amount, f.amount AS fact_amountFROM src_orders sFULL OUTER JOIN fact_orders f USING (order_id)WHERE s.order_id IS NULL OR f.order_id IS NULL OR s.amount <> f.amount;
-- журнал и фактическое число строк по batchSELECT l.batch_id, l.rows_loaded,       (SELECT count(*) FROM fact_orders f WHERE f.batch_id = l.batch_id) AS rows_in_factFROM etl_batch_log lORDER BY l.batch_id;
Расхождений нет: 5 строк, сумма 375.00. Но rows_in_fact для batch 1 равно 2, а в журнале 3. Заказ 2 из batch 1 был перезаписан в batch 2. Это нормально. Журнал отражает то, что загрузили тогда. Для сверки с источником используйте итоги.
5. Late arriving dimension. В источнике появился клиент C9. Добавьте его в dim_customer и исправьте строки fact, которые указывали на unknown member.
Решение
INSERT INTO src_customer VALUES ('C9', 'Мария', 'Омск');
INSERT INTO dim_customerSELECT (SELECT max(customer_key) FROM dim_customer) + row_number() OVER (ORDER BY customer_id),       customer_id, name, cityFROM src_customerWHERE customer_id NOT IN (SELECT customer_id FROM dim_customer WHERE customer_id IS NOT NULL);
-- нужно знать исходный natural key: берём его из источникаUPDATE fact_orders fSET customer_key = d.customer_keyFROM src_orders s, dim_customer dWHERE f.customer_key = 0  AND s.order_id = f.order_id  AND d.customer_id = s.customer_id;
SELECT f.order_id, f.customer_key, d.name, d.cityFROM fact_orders fJOIN dim_customer d USING (customer_key)ORDER BY f.order_id;
Заказ 5 теперь указывает на клиента «Мария». Для такого исправления в fact нужен natural key заказа в staging или в источнике. Поэтому хранение сырых данных важно. Это и есть минус unknown member: ключи в fact приходится переписывать. С inferred member строка fact сразу получила бы свой ключ, а позже обновилась бы только строка dimension.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему HWM лучше брать из данных, а не из времени запуска?
- Что значит idempotent load и как
DELETEпередINSERTего обеспечивает? - Какие политики есть для строки fact без совпадения в dimension? Какую выбрать?
- Почему при низкой latency данные менее качественные?
- Зачем нужна reconciliation, если загрузка завершилась без ошибок?