

Designing Data-Intensive Applications, глава 11: Потоковая обработка
Главная мысль: большинство данных приходит непрерывно, и stream processing обрабатывает каждое событие сразу, а не раз в сутки. Основа этого подхода: лог событий, который можно перечитать, и состояние, которое выводится из лога.
От пакетов к потокам
Заголовок раздела «От пакетов к потокам»- В главе 10 вход ограничен (
bounded): есть начало и конец. Пакетная обработка делит данные на куски по часу или дню. - В реальности данные не заканчиваются (
unbounded). Суточный пакет даёт задержку в сутки. - Stream processing убирает фиксированные куски. Каждое событие обрабатывается, когда оно произошло.
Event— небольшая неизменяемая запись о том, что случилось, с временем. Её создаёт producer, читают один или несколько consumers. Связанные события группируются вtopic.
Как передавать события
Заголовок раздела «Как передавать события»Опрос базы данных (polling) дорог при низкой задержке. Лучше, когда consumer получает уведомление. Для этого есть три подхода.
| Подход | Примеры | Особенность |
|---|---|---|
| Прямая передача | UDP multicast, ZeroMQ, StatsD, webhooks | Быстро, но сообщения теряются, если consumer недоступен |
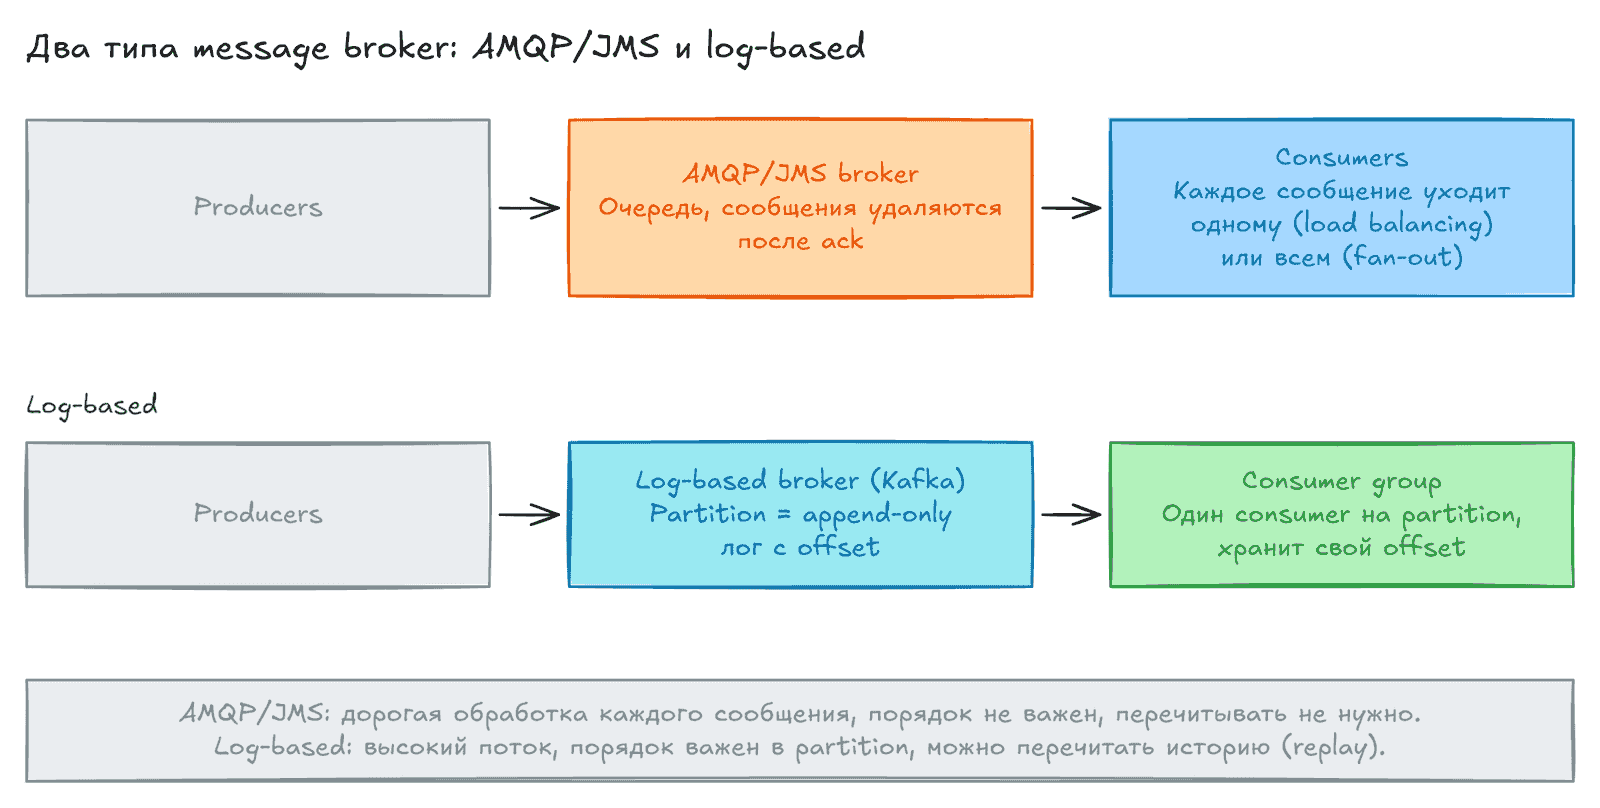
| AMQP/JMS broker | RabbitMQ, ActiveMQ, IBM MQ | Очередь. Сообщение удаляется после подтверждения |
| Log-based broker | Kafka, Amazon Kinesis, DistributedLog | Лог на диске. Сообщения хранятся, их можно перечитать |
Два вопроса помогают различать системы:
- Что будет, если producer быстрее consumer? Варианты: потерять сообщения, буферизовать в очереди,
backpressure(заблокировать producer). - Что будет при сбое узлов? Надёжность требует записи на диск или репликации, а это стоит скорости.
AMQP/JMS-брокеры
Заголовок раздела «AMQP/JMS-брокеры»- Load balancing: каждое сообщение идёт одному из consumers. Подходит для дорогой обработки.
- Fan-out: каждое сообщение идёт всем consumers.
- Acknowledgement: consumer подтверждает обработку. Без подтверждения broker отдаёт сообщение другому consumer.
- Побочный эффект: redelivery вместе с load balancing меняет порядок сообщений.
- Чтение разрушающее: после ack сообщение удалено. Новый consumer не увидит прошлые данные.
Log-based брокеры
Заголовок раздела «Log-based брокеры»Идея: надёжное хранение как в базе данных плюс уведомления как в messaging.
- Лог — append-only последовательность записей. Он делится на
partition(см. главу 6). - Внутри partition каждому сообщению присвоен
offset. Порядок гарантирован только внутри partition. - Fan-out простой: consumers читают лог независимо.
- Load balancing идёт по partition. Один consumer в группе читает partition целиком.
- Broker хранит только offset каждого consumer. Это дешевле, чем ack на каждое сообщение.
- Старые сегменты лога удаляются. Лог работает как большой кольцевой буфер на диске: часы, дни или недели истории.
- Медленный consumer влияет только на себя. Нужно следить за отставанием (
consumer lag). - Replay: можно запустить копию consumer со вчерашним offset и записать результат в другое место. Это похоже на перезапуск пакетного задания.
| Условие | Что выбрать |
|---|---|
| Дорогая обработка, порядок не важен, параллелизм на уровне сообщения | AMQP/JMS |
| Большой поток, быстрая обработка, порядок важен, нужен replay | Log-based |
Ограничения log-based: число consumers в группе не больше числа partition. Одно медленное сообщение блокирует остальные в partition (head-of-line blocking).
Базы данных и потоки
Заголовок раздела «Базы данных и потоки»Запись в базу данных тоже событие. Replication log — это поток событий записи. Если все реплики применяют одни и те же события в одном порядке, они приходят к одному состоянию (state machine replication).
Синхронизация систем
Заголовок раздела «Синхронизация систем»В реальном приложении данные лежат в нескольких местах: OLTP-база, cache, search index, data warehouse. Их нужно держать согласованными.
- Периодический дамп (ETL): медленно, это batch.
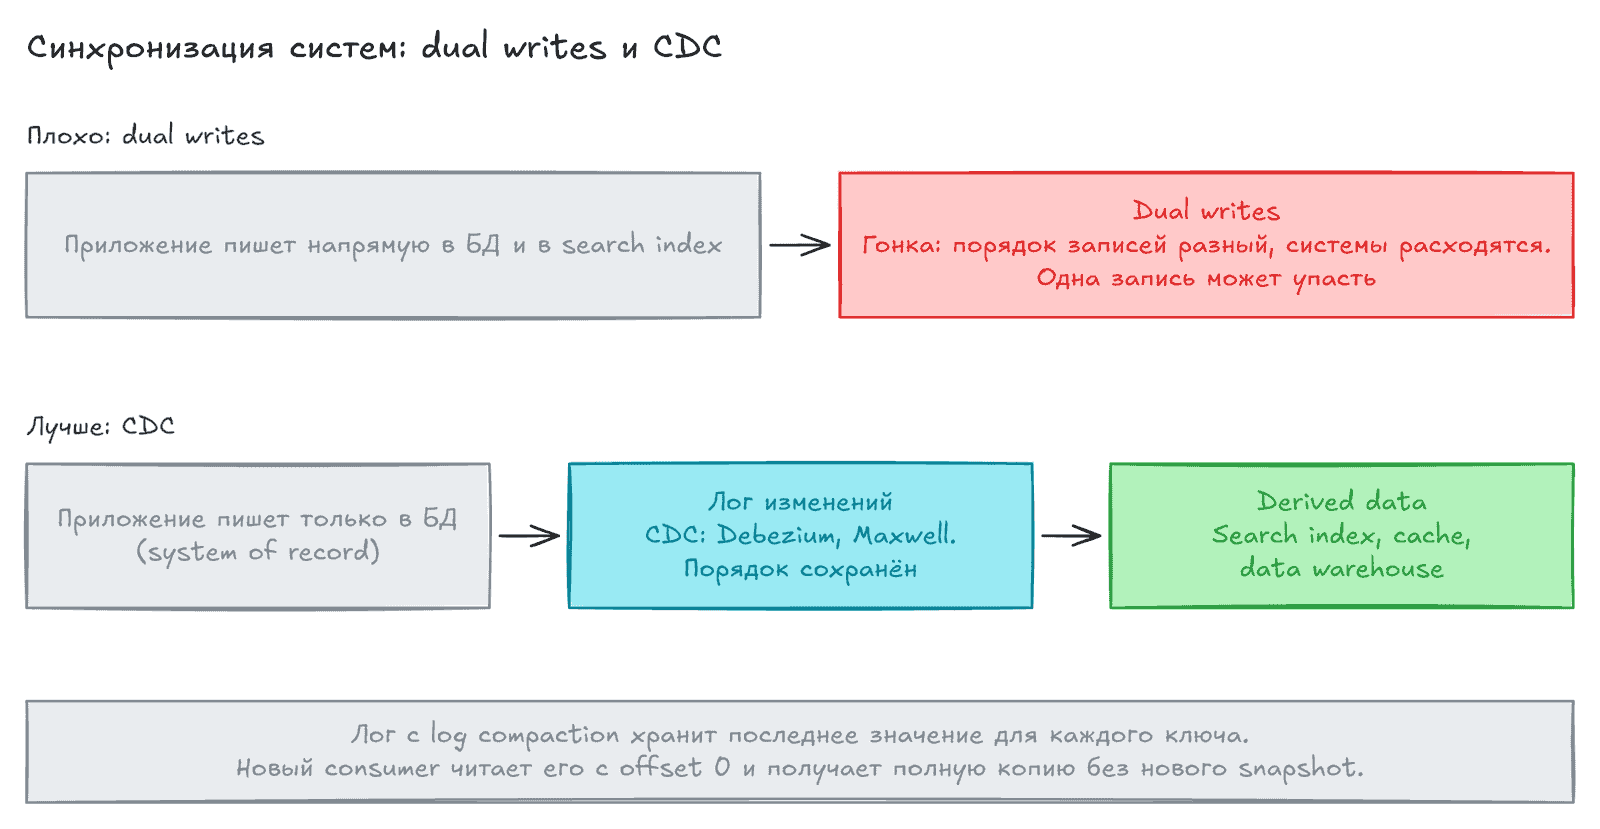
- Dual writes: приложение пишет в каждую систему само. Проблемы: гонка (две системы видят записи в разном порядке и расходятся навсегда) и частичный сбой (одна запись прошла, другая нет).
- CDC: одна система главная, остальные следуют за её логом.
Change data capture (CDC)
Заголовок раздела «Change data capture (CDC)»CDC — наблюдение за всеми изменениями базы и отправка их в виде потока.
- База (
system of record) становится leader, derived data systems становятся followers. - Log-based broker хорошо подходит для передачи, потому что сохраняет порядок.
- Способы реализации: триггеры (хрупко, дорого) или разбор replication log (надёжнее, но сложны schema changes).
- Инструменты: Debezium и Maxwell для MySQL, GoldenGate для Oracle, Databus (LinkedIn), Kafka Connect.
- CDC асинхронный. Медленный consumer не тормозит базу, но появляется
replication lag. - Initial snapshot: если полной истории нет, нужен согласованный snapshot с известным offset лога.
- Log compaction: для каждого ключа остаётся последнее значение. Размер лога зависит от размера данных, а не от числа записей. Новый consumer читает лог с offset 0 и получает полную копию без нового snapshot. Это поддерживает Kafka.
Event sourcing
Заголовок раздела «Event sourcing»Идея из Domain-Driven Design: приложение хранит неизменяемые события как основу состояния.
| CDC | Event sourcing | |
|---|---|---|
| Уровень | Низкий: изменения строк | Высокий: намерения пользователя |
| Приложение | Меняет данные как обычно, не знает о CDC | Явно пишет события в лог |
| Compaction | Работает: последнее значение ключа | Невозможна: нужна вся история |
- Текущее состояние выводится из лога детерминированной функцией. Для скорости делают snapshots, но это только оптимизация.
Command— запрос, который ещё можно отклонить. После проверки он становитсяevent, то есть фактом. Consumer не может отклонить событие. Проверка идёт синхронно до записи.- Состояние и лог не противоречат друг другу. Состояние — результат применения событий. Лог — история изменений.
- Плюсы неизменяемых событий: аудит, лёгкое восстановление после ошибки в коде, больше информации (например, добавил товар и убрал).
- Из одного лога можно построить несколько read-представлений. Это идея
CQRS: форма записи и форма чтения разделены. Спор о нормализации теряет значение. - Минус: consumers асинхронные, поэтому пользователь может не увидеть свою запись сразу (
read your own writes). - Плюс для конкурентности: событие описывает действие целиком, и достаточно одной атомарной записи в лог.
- Удаление: иногда данные нужно удалить физически (приватность). Тогда нужна «excision», а не новое событие. Это трудно: копии лежат в backup, на SSD и в других местах.
Обработка потоков
Заголовок раздела «Обработка потоков»Что делать с потоком:
- Записать в хранилище (база, cache, search index).
- Показать людям (alerts, dashboard).
- Обработать в другой поток (operator или job).
Отличие от batch: поток не кончается. Нельзя сортировать целиком, sort-merge join не работает, и перезапуск «с начала» может быть невозможен.
Применения
Заголовок раздела «Применения»| Задача | Суть |
|---|---|
| Complex event processing (CEP) | Поиск паттернов событий. Запросы хранятся, события «пролетают» мимо них |
| Stream analytics | Агрегаты по окнам: частота, среднее, перцентили. Часто приближённые алгоритмы (HyperLogLog, bloom filter), но поток сам по себе не неточный |
| Materialized views | Поддержка cache, индекса, состояния. Нужна вся история, а не окно |
| Search on streams | Хранятся поисковые запросы, документы проходят через них |
Frameworks: Storm, Spark Streaming, Flink, Samza, Kafka Streams, Google Cloud Dataflow. Actor-фреймворки и RPC — не stream processing: их общение временное и произвольное.
Время и окна
Заголовок раздела «Время и окна»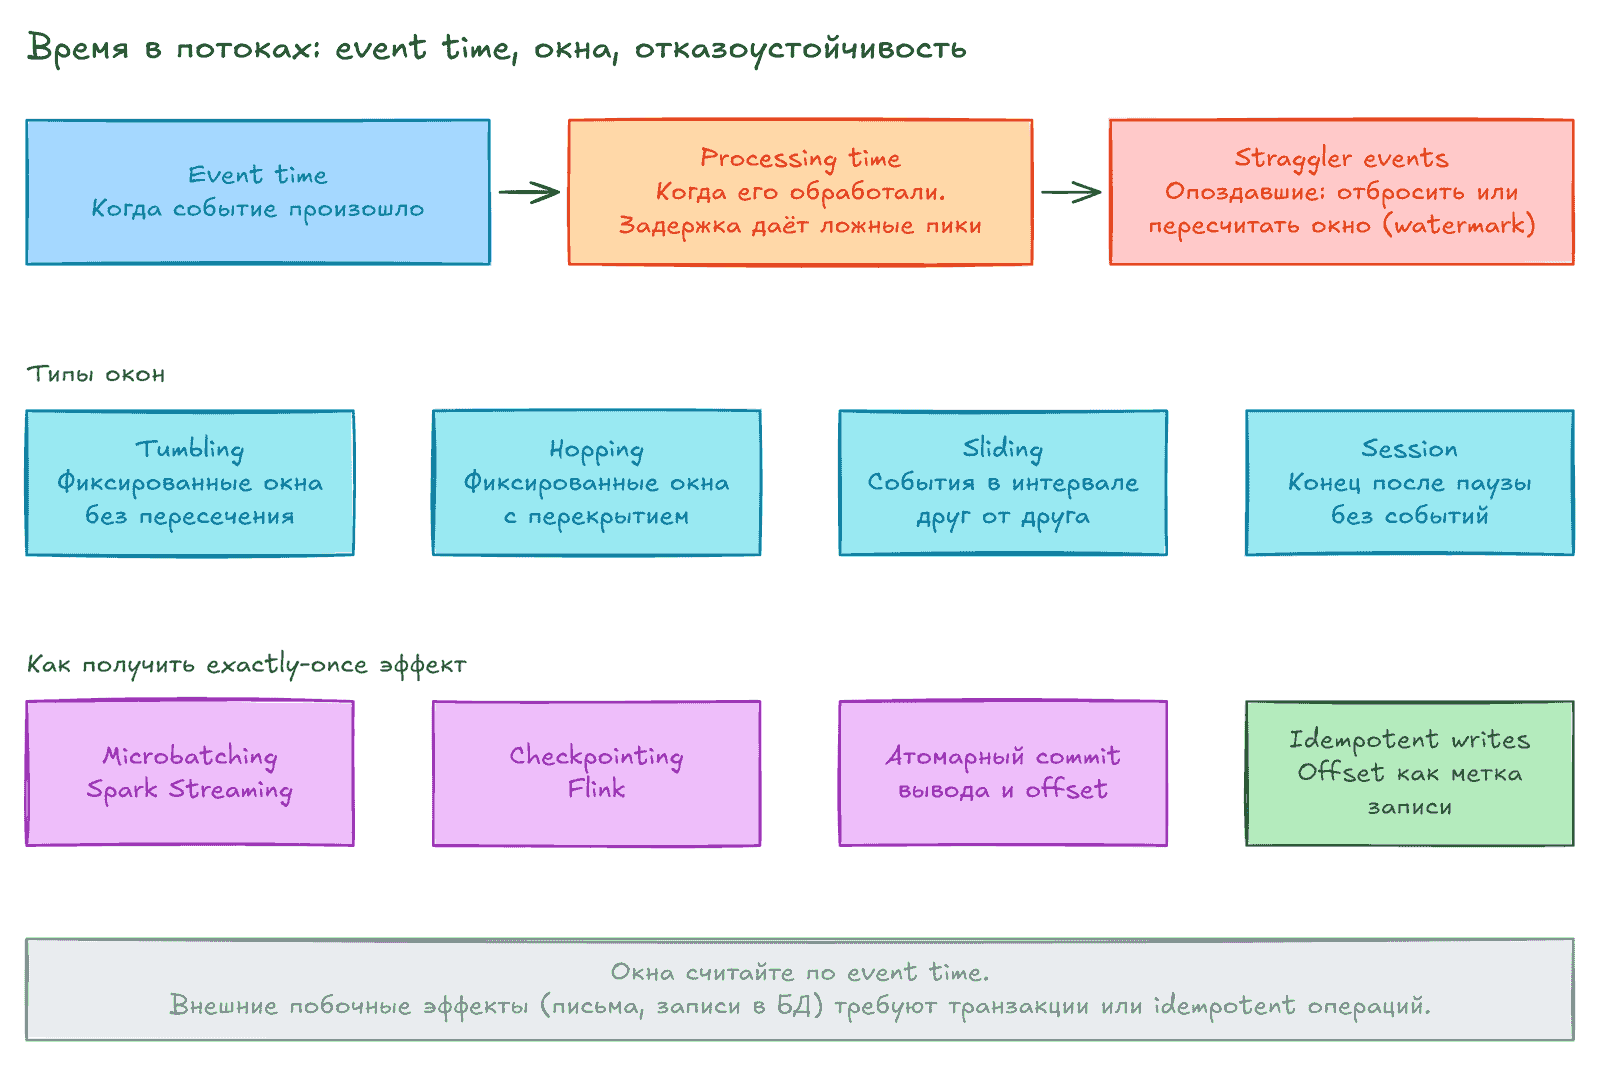
Event time— когда событие произошло.Processing time— когда его обработали.- Если считать по processing time, после перезапуска или задержки появится ложный пик: накопленные события обработаны разом.
- Нельзя быть уверенным, что окно получило все события. Опоздавшие события называются
stragglers. Два варианта: отбросить и считать метрику потерь, или пересчитать окно и выдать поправку.Watermarkсообщает, что событий старше времени t больше не будет, но гарантии нет. - Часы устройства пользователя ненадёжны. Решение: писать три времени (событие и отправка по часам устройства, получение по часам сервера) и оценить сдвиг.
| Окно | Описание |
|---|---|
| Tumbling | Фиксированная длина, без пересечения. Событие в одном окне |
| Hopping | Фиксированная длина с перекрытием (5 минут, шаг 1 минута) |
| Sliding | Все события в пределах интервала друг от друга |
| Session | Без фиксированной длины. Заканчивается после паузы пользователя |
Stream joins
Заголовок раздела «Stream joins»Нужно хранить состояние одной стороны и обращаться к нему по событиям другой.
| Join | Пример | Как работает |
|---|---|---|
| Stream-stream (window join) | Поиск и клик по session ID | Хранятся события окна (например, час), индексированные по session ID |
| Stream-table (enrichment) | Событие активности + профиль пользователя | Локальная копия таблицы, обновляется через CDC |
| Table-table | Tweets + follows, timeline | Поддержка materialized view запроса с join |
Порядок событий важен. События разных потоков не упорядочены между собой. Тогда join недетерминирован: повторный запуск может дать другой результат (вопрос «с каким состоянием на какой момент соединять»).
Отказоустойчивость
Заголовок раздела «Отказоустойчивость»В batch неудачные задачи перезапускаются, а вывод отбрасывается. Результат как будто каждая запись обработана ровно один раз (exactly-once semantics). В потоке нельзя ждать конца задачи.
| Приём | Суть |
|---|---|
| Microbatching | Поток режется на маленькие пакеты (около секунды). Используется в Spark Streaming. Окно привязано к processing time |
| Checkpointing | Периодические снимки состояния. Flink. После сбоя возврат к последнему checkpoint |
| Атомарный commit | Вывод, изменения состояния и сдвиг offset применяются вместе. Dataflow, планы для Kafka |
| Idempotence | Повтор операции даёт тот же эффект. Пример: писать вместе со значением offset сообщения |
- Microbatching и checkpointing дают exactly-once только внутри framework. Письмо, запись во внешнюю базу случаются дважды при повторе.
- Idempotence требует: тот же порядок при повторе (log-based broker), детерминированная обработка, один писатель. При failover нужен
fencing. - Состояние (агрегаты, таблицы для join) нужно восстановимо. Варианты: удалённое хранилище (медленно), локальное с репликацией (Flink пишет snapshots в HDFS, Samza и Kafka Streams пишут изменения в compacted topic Kafka) или пересчёт из входного потока.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Event | Неизменяемая запись о том, что произошло |
| Topic / partition | Группа связанных событий / часть лога |
| Offset | Номер сообщения в partition |
| Backpressure | Блокировка producer, пока consumer не успевает |
| Log-based broker | Broker с логом на диске, сообщения можно перечитать |
| CDC | Поток изменений базы данных |
| Log compaction | Хранение только последнего значения для каждого ключа |
| Event sourcing | Состояние выводится из неизменяемых событий |
| CQRS | Раздельные формы данных для записи и чтения |
| Event time / processing time | Время события / время обработки |
| Watermark | Сигнал, что событий старше времени t больше не будет |
| Exactly-once semantics | Эффект как при однократной обработке |
| Idempotence | Повтор операции не меняет результат |
| Materialized view | Предвычисленное представление, обновляемое при изменениях |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Не делайте dual writes в базу и в другие системы. Берите CDC (например, Debezium и Kafka) и стройте derived data из лога.
- Для пайплайнов выбирайте log-based broker, если нужны порядок, высокий поток и replay. Для очереди задач хватит AMQP-брокера.
- Мониторьте
consumer lagи срок хранения лога. Если consumer отстал дальше срока хранения, данные потеряны. - Ключ partition определяет порядок. События одной сущности отправляйте с одним ключом.
- Считайте окна по event time, продумайте опоздавшие события и метрику их потерь. Не доверяйте часам клиента.
- Делайте записи в приёмник idempotent (upsert по ключу или offset). Тогда повторная обработка безопасна.
- Для чувствительных данных заранее продумайте физическое удаление: неизменяемый лог и backup это усложняют.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем log-based broker отличается от AMQP/JMS и когда выбрать каждый?
- Почему dual writes приводят к расхождению систем и как CDC решает проблему?
- Чем event time отличается от processing time и что делать с опоздавшими событиями?
- Какие приёмы дают exactly-once эффект и почему внешние побочные эффекты остаются проблемой?
Предыдущая: 10. Пакетная обработка. Следующей главы нет.