

Fundamentals of Data Engineering, глава 9: Выдача данных
Главная мысль: выдача данных (serving) — последний этап жизненного цикла. Данные ценны, только если им доверяют и если они вызывают действие. Начинайте с пользователя и сценария, а не с технологии.
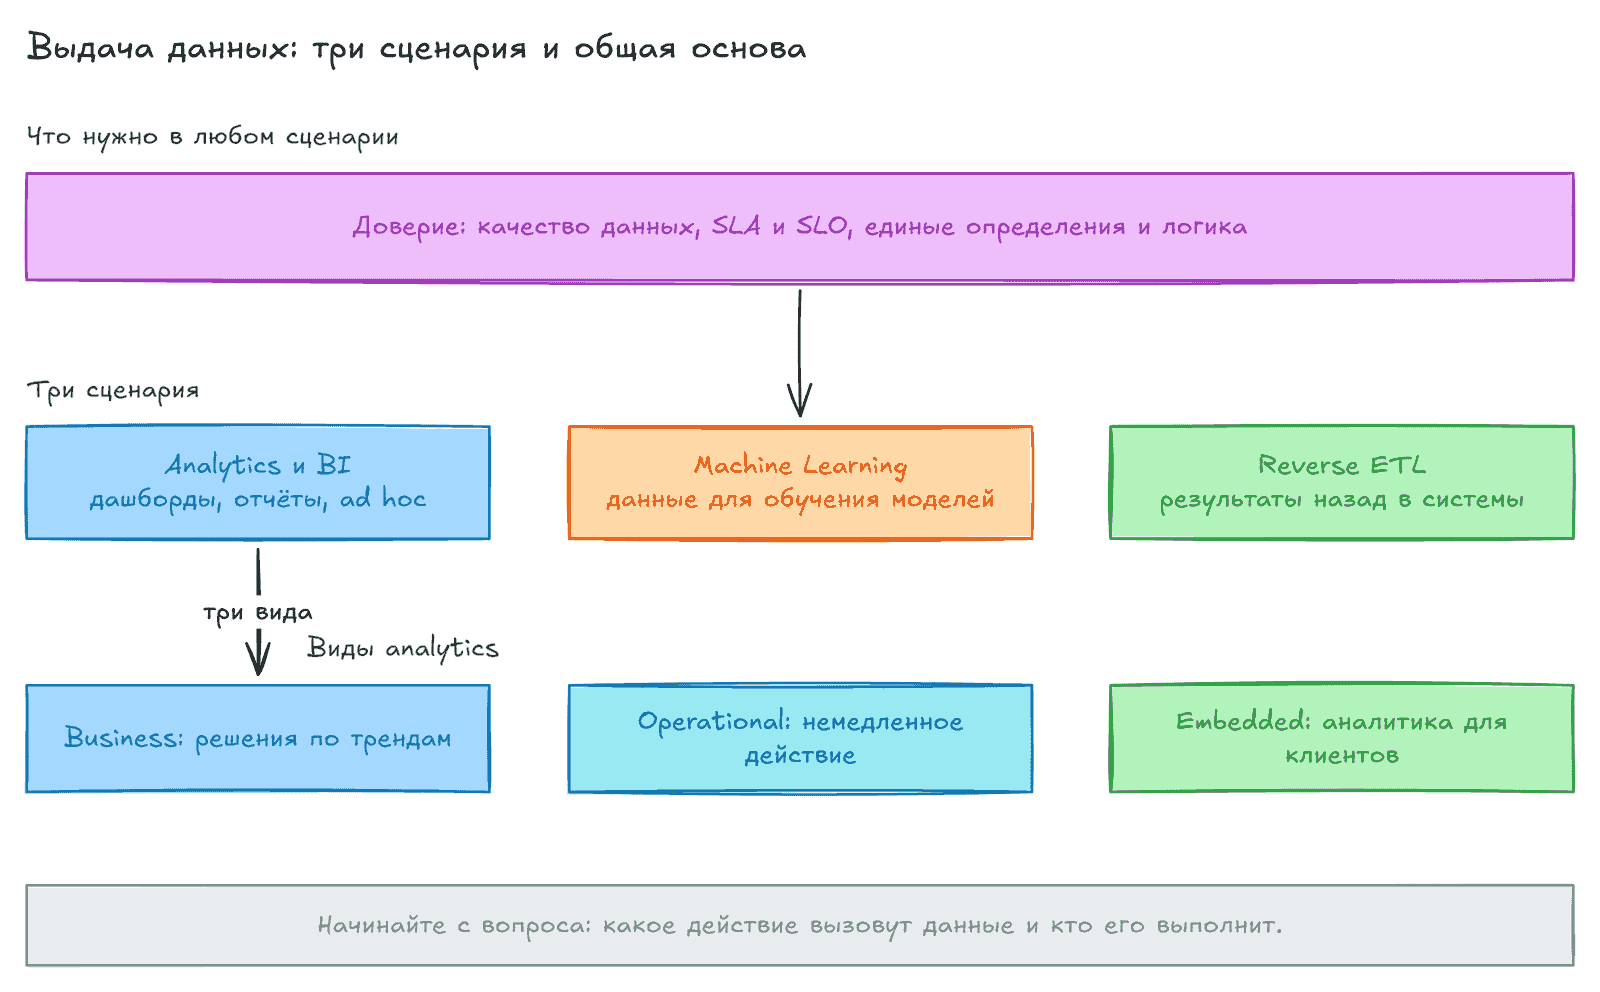
Общие соображения
Заголовок раздела «Общие соображения»| Тема | Суть |
|---|---|
| Trust (доверие) | Главное условие. Потеря доверия убивает проект, вернуть его очень трудно. Помогают data validation и data observability |
| SLA и SLO | SLA — обещание потребителю. SLO — как измеряем его выполнение (например, uptime пайплайна). Нужна постоянная коммуникация |
| Use case и пользователь | Спрашивайте: какое действие вызовут данные, кто его сделает, можно ли автоматизировать |
| Data product | Продукт, который помогает достичь цели с помощью данных. Думайте в терминах «jobs to be done». Хорошему продукту нужна обратная связь |
| Self-service | Часто остаётся желанием. Работает для правильной аудитории и с ограничениями. Руководителю обычно нужен готовый дашборд |
| Data definitions и logic | Определения (кто такой customer) и формулы метрик нужно записать в data catalog и системы, а не держать «в голове» |
| Data mesh | Каждая доменная команда сама готовит и выдаёт данные другим |
Analytics
Заголовок раздела «Analytics»Перед выдачей определите тип аналитики.
| Тип | Цель | Время | Пример |
|---|---|---|---|
| Business analytics | Решения по трендам | Обычно batch | Дашборды, отчёты, ad hoc анализ |
| Operational analytics | Немедленное действие | Реальное время | Мониторинг приложения, оповещения |
| Embedded analytics | Метрики для клиентов внутри продукта | Низкая latency | Дашборд продавца на платформе |
- Business analytics. Данные чаще выдают из warehouse или lake. Частота загрузки задаёт предел частоты дальше по цепочке. Если есть потребители потока, принимайте данные как stream.
- Operational analytics. Граница с business analytics стирается. Главный вопрос: что вы сделаете с потоковыми данными. Данные без действия отвлекают.
- Embedded analytics. Вы отвечаете за базу под приложением. Нужны три вещи: низкая latency данных, быстрые запросы, высокая concurrency. Стартапы начинают с обычных транзакционных баз, потом переходят на специализированные.
Machine Learning
Заголовок раздела «Machine Learning»Границы между data engineer, data scientist и ML engineer зависят от компании. Data engineer не обязан знать ML глубоко. Но базу знать полезно:
- виды обучения: supervised, unsupervised;
- классификация и регрессия, time series;
- классические методы или deep learning (не всегда нужен deep learning);
- AutoML или ручная модель;
- данные для ML превращаются в числа: кодирование категорий, featurization;
- batch или online обучение, результаты в реальном времени или пакетом;
- feature store, ML observability,
data cascades; - где обучать: локально, на кластере, на GPU.
Способы выдачи для analytics и ML
Заголовок раздела «Способы выдачи для analytics и ML»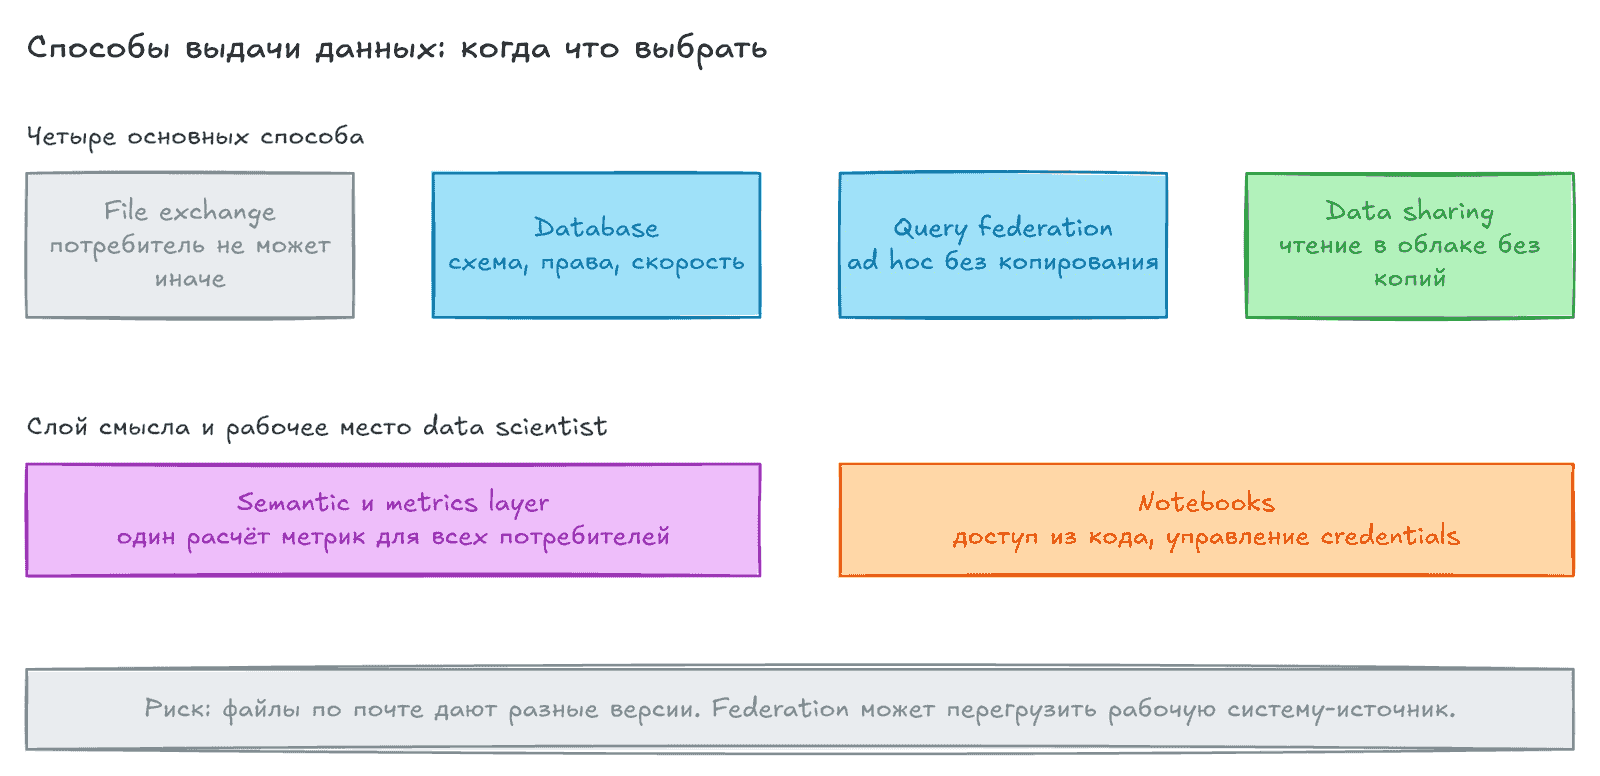
| Способ | Когда подходит | Риски |
|---|---|---|
| File exchange | Потребитель не умеет иначе | Файл по почте даёт разные версии, отозвать доступ нельзя |
| Database (OLAP) | Нужны схема, права на уровне таблиц, строк, колонок, скорость | Стоимость и производительность. Разделяйте кластеры по нагрузкам |
| Streaming и operational DB | Запросы по истории и свежим данным | Нужен опыт со streaming |
| Query federation | Ad hoc анализ без копирования, источник под контролем | Нагрузка на живые системы-источники |
| Data sharing | Обмен внутри компании и с партнёрами в облаке | Превращается в задачу доступа и безопасности |
- Database. Некоторые BI-системы хранят копию данных. Другие используют
query pushdown: генерируют SQL и выполняют в базе. Compute и storage разделены, поэтому для каждой нагрузки можно выделить свой warehouse и бюджет. - Federation. Инструменты: Trino, Presto, Starburst. Подходит, чтобы проверить идею до построения пайплайна.
- Semantic и metrics layer. Хранит бизнес-логику один раз и используется везде. Примеры: LookML в Looker, dbt. Решает вопрос «верны ли эти числа».
- Notebooks. Data scientist подключается из кода (Jupyter, pandas). Данные в памяти ноутбука ограничены. Дальше идут облачные ноутбуки, Dask, Ray, Spark и платформы ML. Credentials нельзя хранить в коде.
Reverse ETL
Заголовок раздела «Reverse ETL»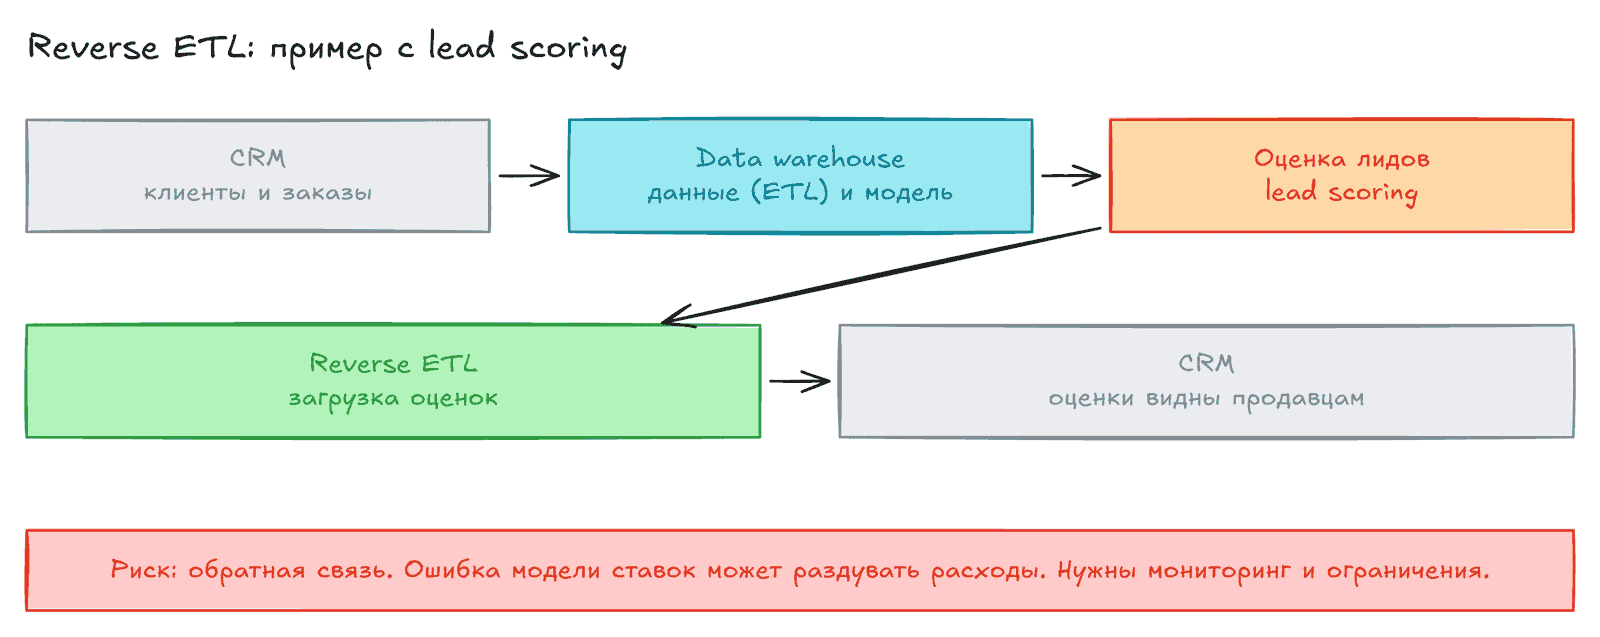
Reverse ETL — загрузка обработанных данных из OLAP-системы обратно в рабочие системы. Пример: оценки лидов возвращаются в CRM, где работают продавцы. Это снижает трение для пользователя.
- Можно написать своё решение или взять готовое (open source или managed). Рынок меняется быстро.
- Авторы шутя называют это
bidirectional load and transform(BLT). - Риск: обратная связь. Ошибка модели ставок может быстро потратить много денег. Нужны мониторинг и ограничения.
С кем вы работаете
Заголовок раздела «С кем вы работаете»Data analysts, data scientists, MLOps и ML engineers, бизнес. Data engineer поддерживает их и отвечает за качество данных, а не за их интерпретацию. В растущей компании нужно разделять обязанности. При data mesh каждая доменная команда берёт часть задач выдачи.
Сквозные темы на этапе выдачи
Заголовок раздела «Сквозные темы на этапе выдачи»- Security. Здесь самая большая поверхность атаки.
Least privilegeдля людей и систем, доступ только на чтение, фильтрованные представления для multitenant. Удаляйте неиспользуемые data products. - Data management. Обратная связь от пользователей. Для чувствительных данных используйте обезличивание. Semantic layer и моделирование дают единый источник правды.
- DataOps. Следите за health данных, latency, качеством, доступом, версиями данных и моделей, uptime. Код в version control, окружения dev, test, prod.
- Data architecture. Цикл обратной связи должен быть быстрым. Переводите работу data scientists с ноутбуков на общие облачные системы.
- Orchestration. Централизованная даёт единые стандарты, но один плохой DAG может остановить всё. Децентрализованная даёт автономию, но усложняет координацию между командами.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Serving | Выдача данных потребителям |
| Data product | Продукт, который достигает цели с помощью данных |
| SLA / SLO | Обещание потребителю / измеримая цель выполнения |
| Business / operational / embedded analytics | Аналитика для решений / для немедленного действия / для клиентов в приложении |
| Query federation | Один запрос к нескольким системам без их копирования |
| Query pushdown | Выполнение логики BI как SQL внутри базы |
| Semantic / metrics layer | Единое место определения метрик и бизнес-логики |
| Reverse ETL | Возврат обработанных данных в рабочие системы |
| Data sharing | Чтение данных в облаке без копирования |
| Least privilege | Минимально нужный доступ |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начинайте с вопроса: кто пользователь и какое действие вызовут данные.
- Пропишите SLA и SLO с потребителями и проверяйте их выполнение.
- Держите определения и метрики в semantic layer или dbt, а не в отдельных запросах.
- Для reverse ETL добавьте мониторинг и ограничения против runaway-цикла.
- Раздельные warehouse или кластеры для ETL и для аналитики. Так проще считать бюджет.
- Следите за использованием отчётов и отключайте ненужные.
- Договоритесь с data scientists о хранении credentials и о переезде с ноутбуков в облако.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему доверие считается главным условием выдачи данных?
- Чем operational analytics отличается от business analytics?
- Когда query federation лучше, чем загрузка данных в warehouse?
- Какой риск несёт reverse ETL и как его снизить?
Предыдущая: Запросы, моделирование, трансформация. Следующая: Безопасность и приватность.