

Designing Data-Intensive Applications, глава 3: Хранение и извлечение
Главная мысль: базы данных хранят данные двумя главными способами. Log-structured движки (LSM-tree) оптимизированы под запись. B-tree оптимизированы под предсказуемое чтение и обновление. Аналитике нужен третий подход: колоночное хранение.
Индекс и его цена
Заголовок раздела «Индекс и его цена»Самая простая база: файл, в который только дописывают строки. Запись быстрая. Чтение медленное, потому что нужно просматривать весь файл.
Чтобы читать быстро, нужен индекс. Это дополнительная структура рядом с данными.
- Индекс ускоряет чтение.
- Каждый индекс замедляет запись.
- Поэтому базы не индексируют всё само. Индексы выбирает разработчик по типичным запросам.
Hash index и сегменты
Заголовок раздела «Hash index и сегменты»Простой вариант: хеш-таблица в памяти, где ключ указывает на смещение в файле. Так работает Bitcask (Riak).
- Файл делят на сегменты. Старые сегменты сжимают через compaction: остаётся последнее значение каждого ключа.
- Удаление пишется как tombstone (метка удаления).
- Для восстановления нужны снимки хеш-таблицы и checksum для битых записей.
- Ограничения: все ключи должны помещаться в память. Запросы по диапазону неэффективны.
Дописывание лучше перезаписи: последовательная запись быстрее случайной, а восстановление после сбоя проще.
SSTable и LSM-tree
Заголовок раздела «SSTable и LSM-tree»SSTable (Sorted String Table) это сегмент, отсортированный по ключу. Это даёт три плюса:
- Слияние сегментов простое, как в mergesort, даже если файлы больше памяти.
- Индекс в памяти может быть разреженным: один ключ на несколько КБ.
- Блоки можно сжимать.
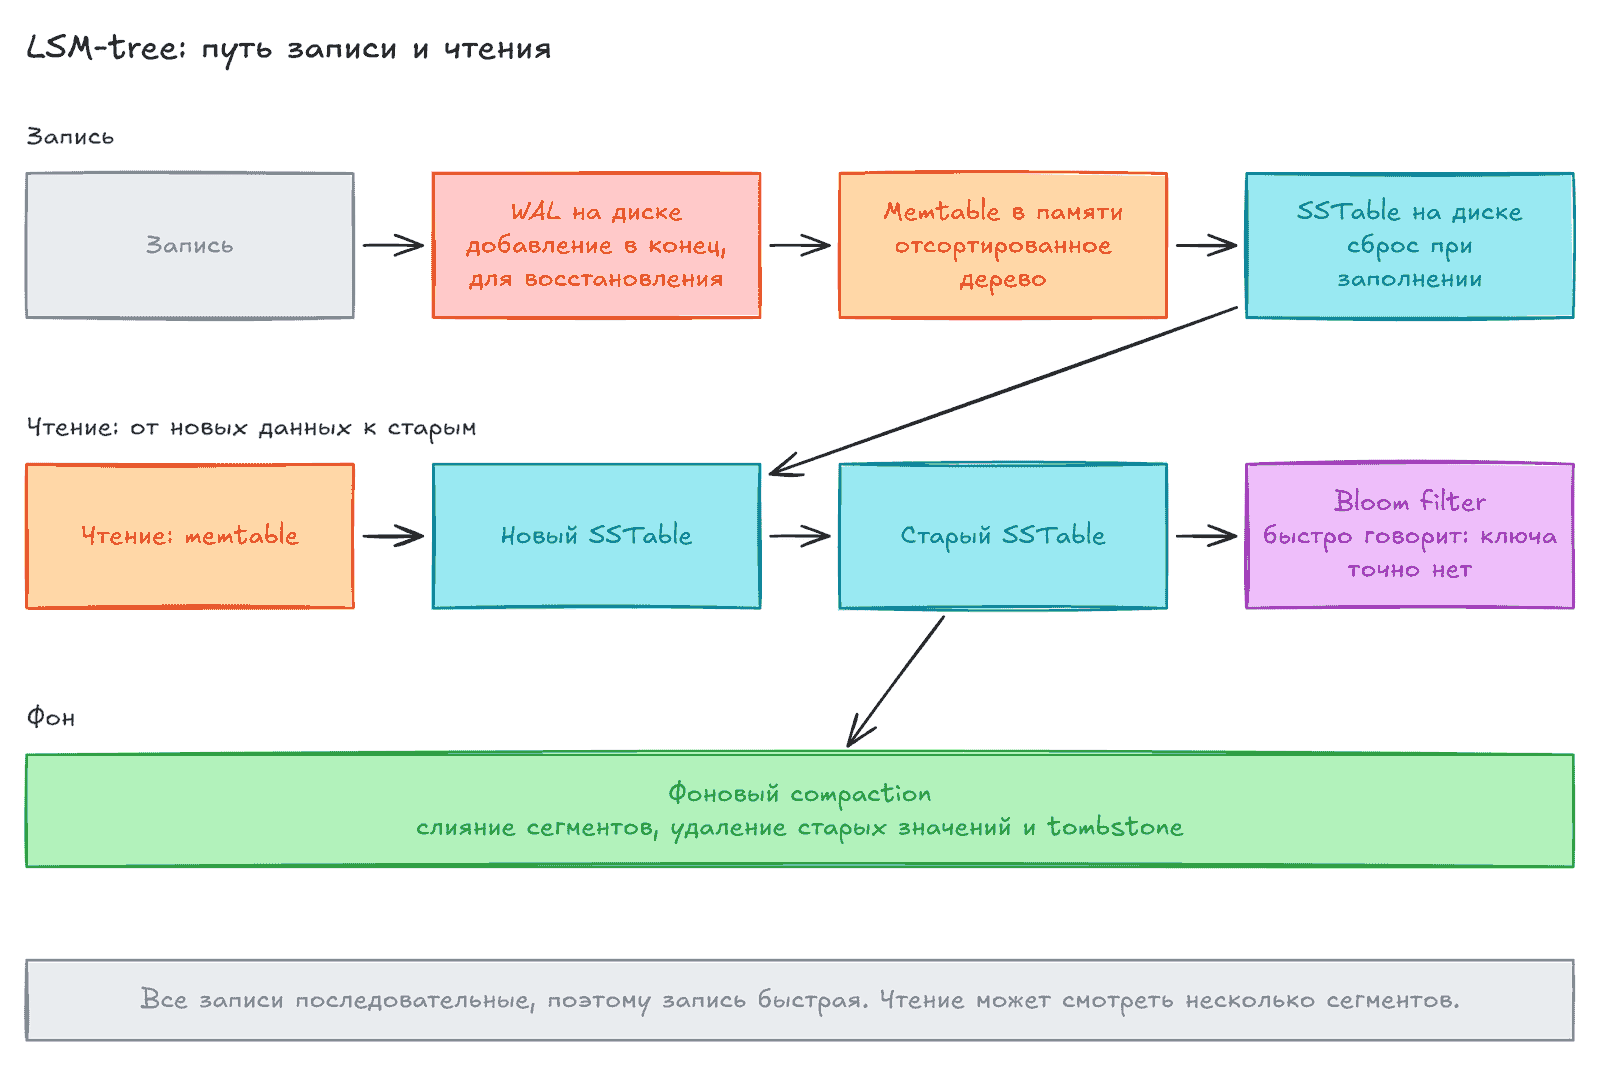
LSM-tree (Log-Structured Merge-tree) работает так:
- Запись попадает в memtable, отсортированное дерево в памяти.
- Для защиты от сбоя та же запись идёт в WAL на диске.
- Когда memtable заполнена, её сбрасывают на диск как новый SSTable.
- Чтение ищет ключ в memtable, потом в сегментах от новых к старым.
- Фоновый compaction сливает сегменты.
Чтение отсутствующего ключа медленное. Для этого используют Bloom filter: структура, которая точно говорит, что ключа нет. LSM используют LevelDB, RocksDB, Cassandra, HBase. Lucene (Elasticsearch, Solr) использует похожую идею.
B-tree (с 1970 года) это стандартный индекс почти всех реляционных баз.
- Данные делятся на страницы фиксированного размера, обычно 4 КБ.
- Страницы образуют дерево. Поиск идёт от корня к листу за O(log n) шагов.
- Обновление: страница перезаписывается на месте.
- Если страница переполнена, она делится на две. Дерево остаётся сбалансированным.
Для защиты от сбоя при делении страниц есть WAL (write-ahead log, redo log). Изменение сначала пишется в лог. Некоторые базы (LMDB) используют copy-on-write вместо WAL.
B-tree и LSM-tree
Заголовок раздела «B-tree и LSM-tree»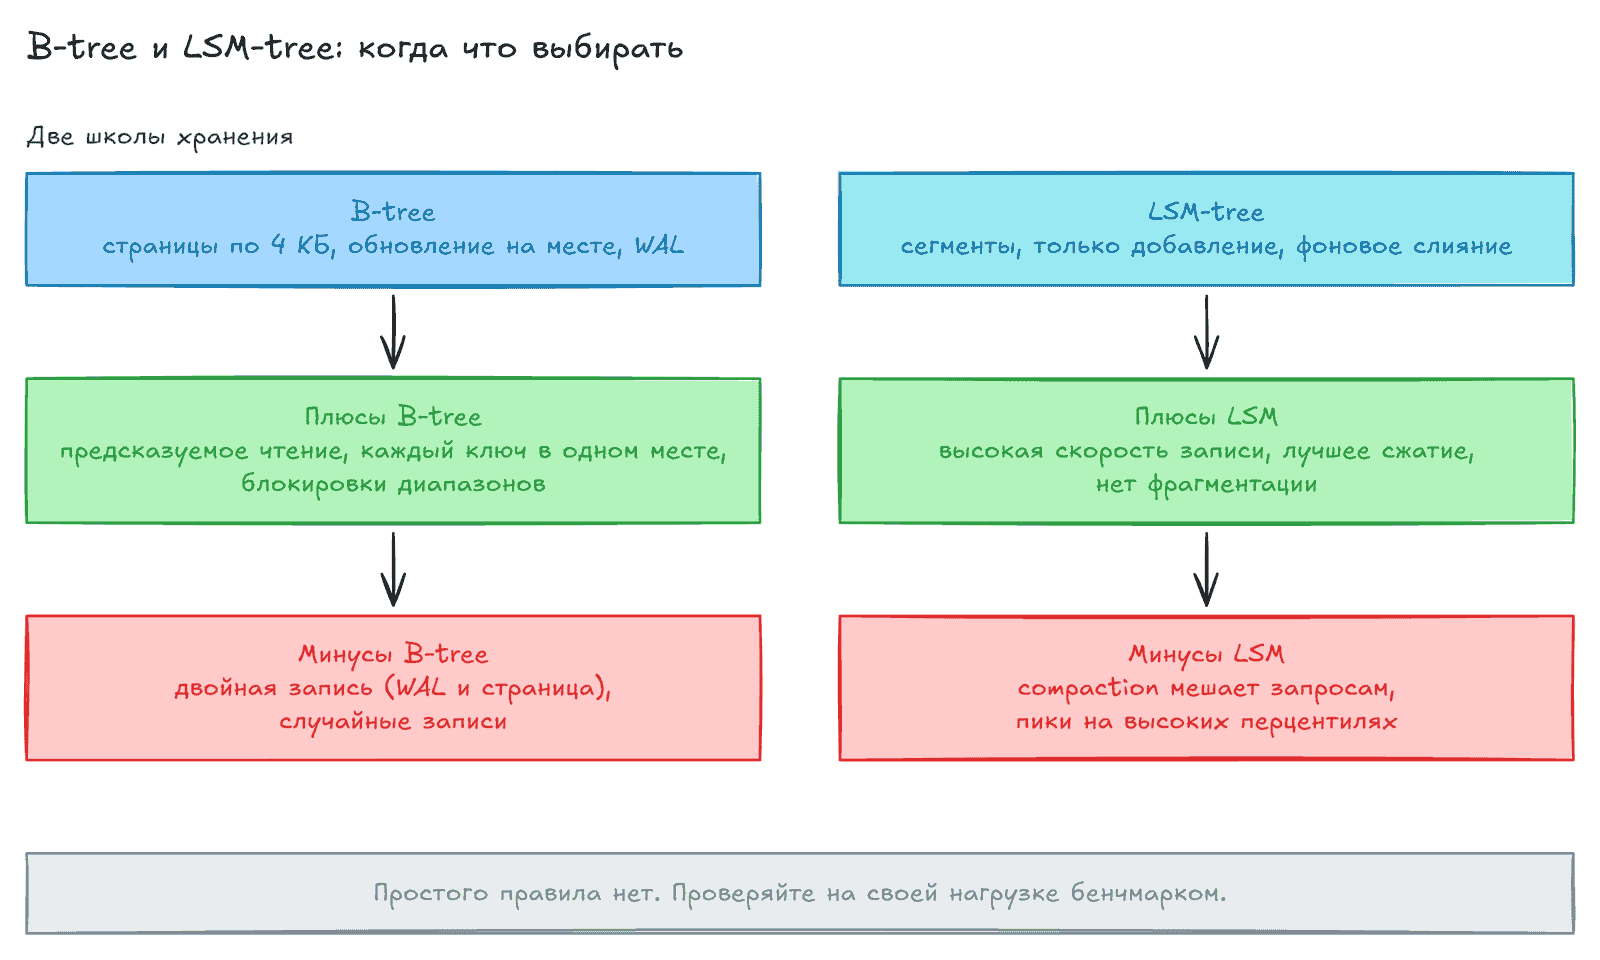
| Критерий | B-tree | LSM-tree |
|---|---|---|
| Запись | Случайная, на месте | Последовательная, высокая пропускная способность |
| Чтение | Обычно быстрее и предсказуемее | Нужно смотреть несколько сегментов |
| Write amplification | Данные пишутся в WAL и в страницу | Данные переписываются при compaction |
| Задержки | Стабильные | Compaction может дать пики на высоких перцентилях |
| Ключ | Одна копия | Несколько копий в разных сегментах |
| Транзакции | Блокировки по диапазону ключей удобно привязать к дереву | Сложнее |
| Зрелость | Очень зрелые | Моложе, популярны в новых системах |
Простого правила нет. Проверяйте на своей нагрузке.
Другие индексы
Заголовок раздела «Другие индексы»- Secondary index: ключи не уникальны. Значение это список идентификаторов строк или ключ плюс идентификатор строки.
- Heap file: данные лежат отдельно, индекс хранит ссылку. Экономит место при нескольких индексах.
- Clustered index: строка хранится прямо в индексе. В InnoDB (MySQL) первичный ключ всегда clustered.
- Covering index: часть колонок хранится в индексе. Часть запросов обходится без обращения к таблице.
- Concatenated index: несколько колонок в одном ключе. Порядок важен: индекс по (фамилия, имя) не поможет искать по имени.
- Multi-dimensional index (R-tree, PostGIS): для гео-данных и запросов по нескольким диапазонам.
- Fuzzy index (Lucene): поиск слов с опечатками по edit distance.
In-memory базы
Заголовок раздела «In-memory базы»Когда память дешевеет, данные можно держать целиком в RAM. Memcached только кэш. VoltDB, MemSQL, Redis, RAMCloud держат данные в памяти и добавляют долговечность через лог, снимки или реплики.
Выигрыш не в том, что нет чтения с диска. ОС и так кэширует блоки. Выигрыш в том, что не нужно кодировать структуры для диска. Redis также даёт структуры вроде очередей с приоритетом и множеств.
OLTP и OLAP
Заголовок раздела «OLTP и OLAP»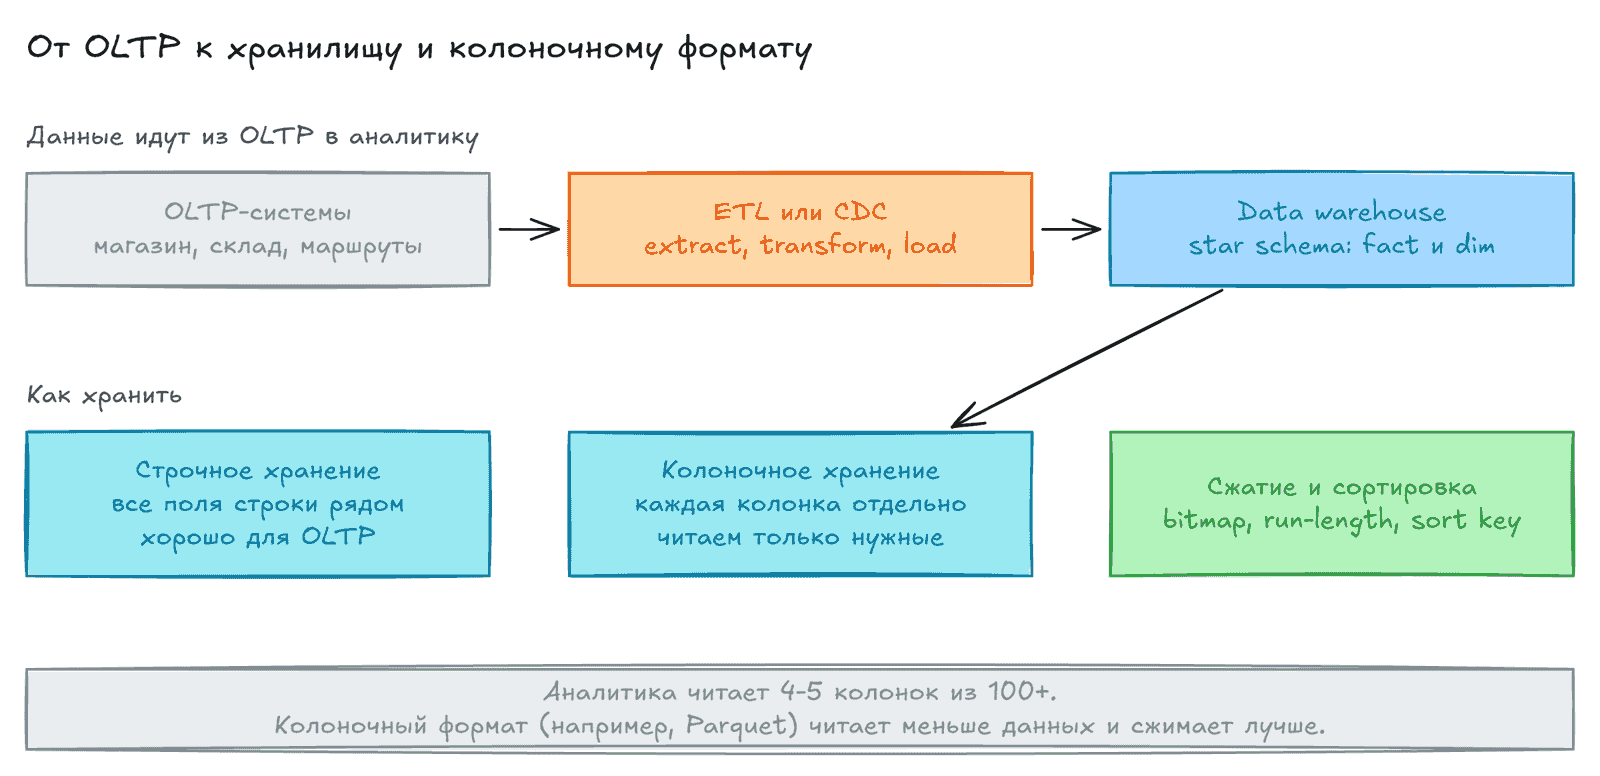
| Свойство | OLTP | OLAP |
|---|---|---|
| Чтение | Мало записей по ключу | Агрегаты по многим записям |
| Запись | Случайная, малая задержка | Bulk-загрузка (ETL) или поток событий |
| Пользователь | Клиент через приложение | Аналитик |
| Что хранит | Текущее состояние | История событий |
| Объём | ГБ - ТБ | ТБ - ПБ |
| Узкое место | Время поиска на диске | Пропускная способность диска |
Аналитику выносят в отдельный data warehouse. Причины: тяжёлые запросы мешают OLTP, а хранилище можно оптимизировать под аналитику. Данные попадают в него через ETL (extract, transform, load) из дампов или потока изменений.
Схемы для аналитики
Заголовок раздела «Схемы для аналитики»- Star schema: в центре fact table (события: покупка, клик), вокруг dimension tables (кто, что, где, когда).
- Snowflake schema: измерения делятся на подизмерения. Более нормализована, но аналитикам обычно проще star.
- Таблицы фактов могут быть очень большими и иметь 100+ колонок. Даты тоже часто хранят как dimension (например, признак праздника).
Колоночное хранение
Заголовок раздела «Колоночное хранение»Запрос читает 4-5 колонок из 100+. Строчный движок всё равно читает строки целиком. Колоночный хранит каждую колонку отдельно и читает только нужные. Порядок строк во всех колонках одинаков. Пример формата: Parquet.
Сжатие. Значения в колонке часто повторяются.
- Bitmap encoding: для каждого значения свой битовый массив. Если значений много, массивы сжимают через run-length encoding.
- Запросы
INиANDпревращаются в побитовые OR и AND над массивами.
Скорость CPU. Сжатые блоки колонки помещаются в кэш L1. Используются SIMD и vectorized processing.
Сортировка. Сортируют строки целиком, а не колонки по отдельности. Первый sort key сжимается лучше всех. Например, сортировка по дате ускоряет запросы по периоду. Vertica хранит данные в нескольких порядках сортировки.
Запись. Вставка в середину сжатых колонок дорогая. Решение: LSM-подход. Записи копятся в памяти, потом сливаются с колонками на диске пачкой.
Materialized views и data cube
Заголовок раздела «Materialized views и data cube»- Materialized view: копия результата запроса на диске. Обычный view это только сохранённый запрос.
- Нужно обновлять при изменении данных. Поэтому в OLTP их редко используют.
- Data cube (OLAP cube): сетка предрасчитанных агрегатов по измерениям. Быстро для типовых запросов, но нет гибкости. Хранилища держат сырые данные, а кубы используют для ускорения.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Log, append-only | Файл, в который только дописывают |
| Compaction | Слияние сегментов, остаётся последнее значение ключа |
| Tombstone | Метка удаления ключа в логе |
| SSTable | Сегмент, отсортированный по ключу |
| Memtable | Отсортированная структура в памяти перед сбросом на диск |
| LSM-tree | Индекс из SSTable с фоновым слиянием |
| Bloom filter | Структура, которая точно говорит, что ключа нет |
| B-tree | Дерево страниц фиксированного размера, обновление на месте |
| WAL | Лог изменений для восстановления после сбоя |
| Write amplification | Одна запись приводит к нескольким записям на диск |
| Clustered / covering index | Данные или часть колонок хранятся в самом индексе |
| OLTP / OLAP | Транзакционная и аналитическая нагрузка |
| Star schema | Fact table в центре и dimension tables вокруг |
| Column-oriented storage | Значения одной колонки лежат вместе |
| Materialized view / data cube | Предрасчитанные результаты и агрегаты |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте движок по нагрузке. Много записей: смотрите на LSM (Cassandra, RocksDB). Много точечных чтений и транзакций: B-tree (PostgreSQL, MySQL).
- Не запускайте тяжёлую аналитику на боевой OLTP-базе. Используйте реплику или warehouse.
- Для аналитики храните данные в колоночных форматах (Parquet) и в колоночных хранилищах. Выбирайте sort key под частые фильтры, например дату.
- Каждый лишний индекс замедляет запись. Удаляйте неиспользуемые.
- Моделируйте warehouse как fact и dimension. Храните сырые факты, агрегаты добавляйте как ускорение.
- Не доверяйте общим бенчмаркам. Тестируйте на своих данных.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему LSM-tree быстро пишет, и какую цену платит за это при чтении?
- Зачем B-tree нужен WAL?
- Чем OLTP отличается от OLAP по шаблону доступа и по узкому месту?
- Почему колоночное хранение хорошо сжимается и как сортировка помогает этому?
Предыдущая: Модели данных и языки запросов. Следующая: Кодирование и эволюция схем.