

Designing Data-Intensive Applications, глава 2: Модели данных и языки запросов
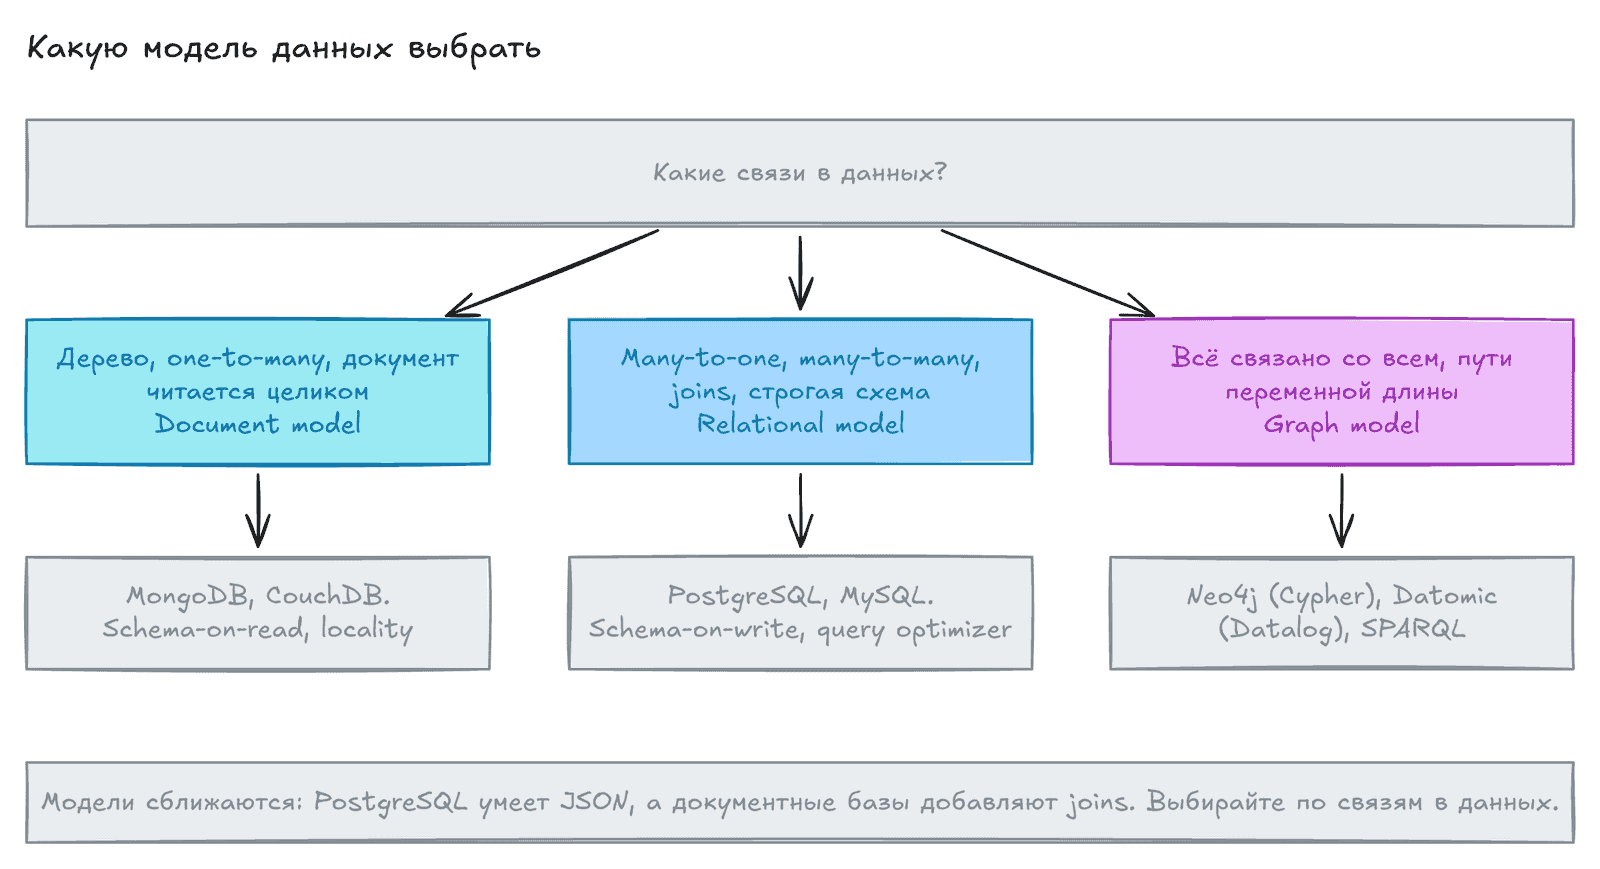
Главная мысль: модель данных определяет, что в приложении просто, а что неудобно. Relational, document и graph модели подходят для разных типов связей между данными.
Слои моделей
Заголовок раздела «Слои моделей»Приложения строятся слоями. Каждый слой выражает данные через слой ниже:
- Разработчик моделирует реальный мир через объекты и структуры данных.
- Их хранят в универсальной модели: JSON/XML, таблицы или граф.
- Авторы базы решают, как представить это в байтах на диске и в памяти.
- Ещё ниже инженеры по железу.
Каждая модель встраивает предположения об использовании. Одни операции быстрые, другие неудобные. Поэтому модель нужно выбирать осознанно.
Relational и document модели
Заголовок раздела «Relational и document модели»Relational model (Codd, 1970): данные лежат в отношениях (таблицах), то есть в наборах строк. Она захватила рынок бизнес-обработки: транзакции и пакетные отчёты. Позже она обобщилась на веб, e-commerce и SaaS.
NoSQL — не одна технология. Слово появилось как хештег для встречи в 2009 году. Причины выбора NoSQL:
- нужна масштабируемость и высокая нагрузка на запись;
- предпочтение открытого ПО;
- специальные операции, которых нет в relational модели;
- ограничения схемы раздражают.
Идея polyglot persistence: relational базы будут жить рядом с разными нереляционными хранилищами.
Object-relational mismatch
Заголовок раздела «Object-relational mismatch»Объекты в коде и таблицы в базе не совпадают. Это называют impedance mismatch. ORM (ActiveRecord, Hibernate) уменьшают шаблонный код, но не скрывают разницу полностью.
Пример: резюме. Один пользователь имеет много мест работы, учёбы и контактов (one-to-many). Варианты хранения:
- нормализованные таблицы с foreign key;
- типы XML и JSON в самой строке (PostgreSQL, DB2, Oracle, SQL Server);
- JSON как текст в одном столбце (внутри не искать).
JSON-документ хранит всё дерево в одном месте. У него лучше locality: одним запросом без JOIN читается весь профиль.
Many-to-one и many-to-many
Заголовок раздела «Many-to-one и many-to-many»Хранить название региона как ID, а не как строку, полезно. Нет дублирования. Нет рассинхрона при переименовании. Есть единый стиль, локализация и лучший поиск. Это и есть идея normalization.
Но ссылки на общие сущности — это many-to-one и many-to-many. Для документных баз это слабое место: JOIN-ы часто отсутствуют или слабые. Join приходится делать в коде приложения. Данные со временем становятся связаннее: организации как сущности, рекомендации между пользователями. Тогда документная модель становится неудобной.
История повторяется
Заголовок раздела «История повторяется»В 1970-х господствовала IMS от IBM с hierarchical model: дерево записей. Она, как документные базы, хорошо справлялась с one-to-many, но плохо с many-to-many и без JOIN. Появились два решения:
| Модель | Как устроена | Итог |
|---|---|---|
| Network (CODASYL) | Запись может иметь несколько родителей. Доступ только по access path, как указатели. Разработчик вручную помнит пути | Код сложный и хрупкий. Менять модель данных трудно. Модель исчезла |
| Relational | Таблицы открыты. Query optimizer сам выбирает путь и индексы | Новый индекс не требует менять запросы. Модель победила |
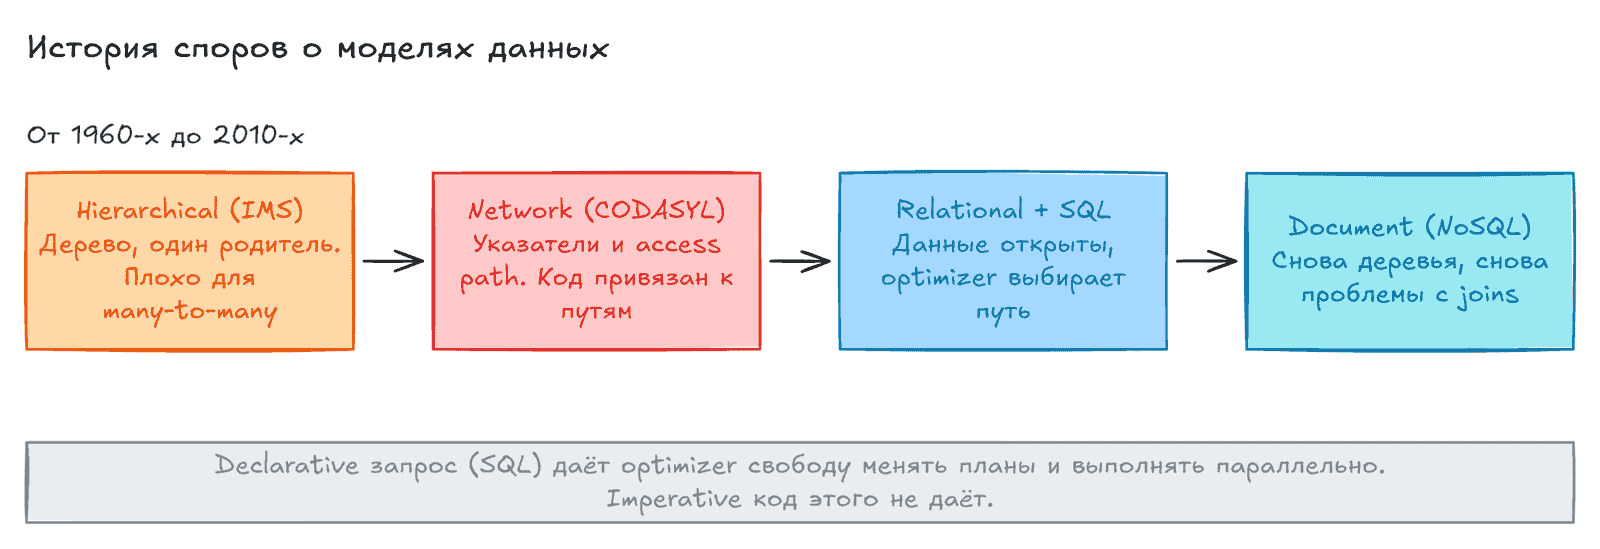
Документные базы вернулись к иерархии для вложенных записей. Для ссылок на другие документы они используют identifier (document reference), как foreign key. Он разрешается при чтении через join или дополнительные запросы. Путь CODASYL они не повторяют.
Сравнение сегодня
Заголовок раздела «Сравнение сегодня»| Критерий | Document | Relational |
|---|---|---|
| Данные | Дерево, документ читается целиком | Many-to-one, many-to-many |
| Joins | Слабые или нет | Сильные |
| Схема | Гибкая (schema-on-read) | Явная (schema-on-write) |
| Locality | Хорошая, если нужен весь документ | Требует нескольких lookup или JOIN |
Правило книги: для сильно связанных данных документная модель неудобна, relational приемлема, graph естественна.
Schema flexibility. “Schemaless” вводит в заблуждение. Структура всё равно предполагается кодом. Точнее: schema-on-read (структура неявная, проверяется при чтении, как динамическая типизация) и schema-on-write (база проверяет данные, как статическая типизация). Schema-on-read выгодна, если данные разнородны или структура задаётся внешней системой. Если у всех записей одинаковая структура, схема полезна как документация и защита. Смена схемы в SQL (ALTER TABLE) обычно быстрая. Исключение, по книге, MySQL: он копирует таблицу, и это может занять часы. UPDATE на большой таблице медленный в любой базе.
Locality. Документ хранится как одна строка (JSON, BSON). Это выгодно, когда нужен почти весь документ. Но база читает документ целиком, даже если нужна малая часть. При изменении документ обычно перезаписывается целиком. Поэтому документы лучше держать небольшими. Locality есть и в других системах: Spanner (interleaved tables), Oracle (multi-table index cluster), column family в Bigtable (Cassandra, HBase).
Конвергенция. Relational базы добавляют JSON и XML (PostgreSQL с 9.3, DB2). Документные добавляют joins (RethinkDB). Гибрид хорош: модели дополняют друг друга.
Языки запросов
Заголовок раздела «Языки запросов»Declarative язык (SQL) описывает, какие данные нужны. Imperative код описывает, как их получить по шагам. Преимущества declarative:
- короче и проще;
- скрывает детали: база может улучшить производительность без смены запросов;
- нет гарантий порядка, поэтому у optimizer больше свободы;
- проще выполнять параллельно на многих ядрах и машинах.
Книга показывает ту же идею на CSS: селектор li.selected > p декларативен и сам обновляется, а код на DOM API длиннее и хрупок.
MapReduce
Заголовок раздела «MapReduce»MapReduce — модель между declarative и imperative. Логика задаётся двумя функциями, map и reduce, которые framework вызывает сам. Они должны быть pure functions: используют только входные данные, не делают запросов, без побочных эффектов. Тогда их можно запускать где угодно, в любом порядке и повторять при сбое. Подробнее в главе 10.
Недостаток: нужны две согласованные функции, и у optimizer меньше возможностей. Поэтому MongoDB добавила декларативный aggregation pipeline. Вывод книги: NoSQL-система может случайно изобрести SQL заново.
Graph-like модели
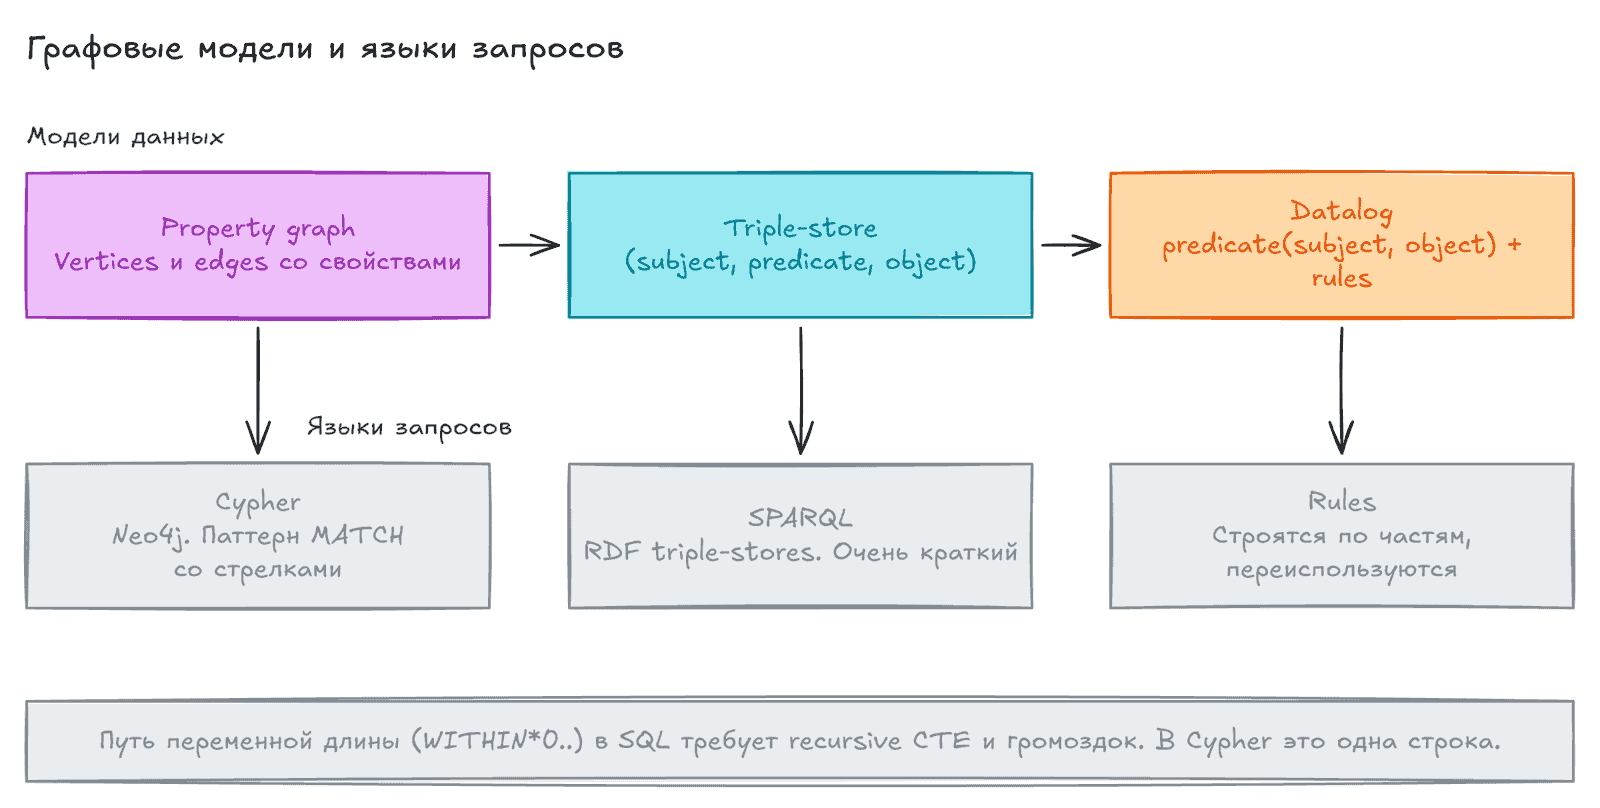
Заголовок раздела «Graph-like модели»Если many-to-many связи частые, естественна graph model. Граф состоит из vertices (узлы) и edges (рёбра). Примеры: социальные сети, веб-граф, дорожные сети. Графы также хранят разнородные объекты в одном хранилище (Facebook: люди, места, события, комментарии). Алгоритмы: кратчайший путь, PageRank.
Property graph
Заголовок раздела «Property graph»Vertex: id, входящие и исходящие рёбра, свойства (key-value). Edge: id, tail и head vertex, label, свойства. Реализации: Neo4j, Titan, InfiniteGraph. Это можно хранить в двух таблицах (vertices и edges) с индексами по tail_vertex и head_vertex.
Свойства модели:
- любая вершина может иметь ребро к любой другой, схема не ограничивает;
- рёбра легко обходить вперёд и назад;
- разные label позволяют хранить разные виды связей в одном графе.
Графы хороши для evolvability. Они легко выражают разные структуры (страны с разными регионами), разную детализацию (город в одном случае, штат в другом) и новые факты.
Cypher и SQL
Заголовок раздела «Cypher и SQL»Cypher (Neo4j) — декларативный язык с паттерном со стрелками. Запрос “кто родился в США и живёт в Европе” использует путь переменной длины :WITHIN*0.. (“ноль и более рёбер”). В SQL число JOIN обычно известно заранее. Для переменной длины нужны recursive common table expressions (WITH RECURSIVE). В книге тот же запрос занимает 4 строки на Cypher и 29 на SQL. Вывод: разные модели рассчитаны на разные задачи.
Graph и CODASYL не одно и то же:
- в графе нет схемы, ограничивающей связи;
- к вершине можно обратиться по id или индексу, не только по пути;
- нет порядка вершин и рёбер;
- есть декларативные языки.
Triple-store и SPARQL
Заголовок раздела «Triple-store и SPARQL»В triple-store всё хранится как (subject, predicate, object). Если object — значение, это свойство. Если object — другая вершина, это ребро. Это почти то же, что property graph, другими словами. Реализации: Datomic, AllegroGraph. Формат Turtle, стандарт RDF. Semantic web не оправдал надежд, но триплеты полезны как внутренняя модель. Predicate в RDF часто URI, чтобы данные разных источников не конфликтовали.
SPARQL предшествует Cypher, паттерны Cypher заимствованы оттуда. Запрос на нём ещё короче.
Datalog
Заголовок раздела «Datalog»Datalog старше SPARQL и Cypher (исследовался в 1980-х). Данные записываются как predicate(subject, object). Вы определяете rules, которые выводят новые predicates из данных и других правил. Правила можно комбинировать и использовать повторно, даже рекурсивно. Используется в Datomic и Cascalog (запросы к Hadoop). Сложнее для разовых запросов, но лучше справляется со сложными данными.
- Данные начинались с иерархии. Для many-to-many придумали relational model.
- NoSQL пошёл в двух направлениях: document (связи редки) и graph (всё связано со всем).
- Document и graph базы обычно не навязывают схему. Это облегчает изменения.
- Одна модель может эмулировать другую, но неудобно. Поэтому нет универсального решения.
- Моделей больше, чем здесь: геномные базы, полнотекстовый поиск, физика частиц.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Data model | Способ представить данные: таблицы, документы, граф |
| Impedance mismatch | Несовпадение объектов в коде и таблиц в базе |
| ORM | Библиотека, которая переводит между объектами и таблицами |
| Normalization | Убрать дублирование: значение хранится в одном месте, остальное ссылки |
| Denormalization | Намеренное дублирование данных ради скорости чтения |
| One-to-many / many-to-many | Типы связей между записями |
| Polyglot persistence | Разные хранилища для разных задач в одной системе |
| Hierarchical / network model | Старые модели: дерево и граф с указателями (IMS, CODASYL) |
| Access path | Путь от записи к записи, по которому надо идти вручную |
| Query optimizer | Часть базы, сама выбирающая план запроса |
| Schema-on-read / schema-on-write | Схема проверяется при чтении / при записи |
| Locality | Связанные данные лежат рядом |
| Declarative / imperative | Описать результат / описать шаги |
| MapReduce | Модель пакетной обработки из функций map и reduce |
| Property graph | Граф из вершин и рёбер со свойствами |
| Triple-store | Хранение фактов как (subject, predicate, object) |
| Cypher, SPARQL, Datalog | Языки запросов к графам |
| Recursive CTE | WITH RECURSIVE: рекурсивный запрос в SQL |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте модель по связям в данных. Дерево: документ. Много общих справочников и many-to-many: relational. Сложные цепочки связей: graph.
- Schema-on-read не отменяет схему. Она просто живёт в коде. Для пайплайнов фиксируйте контракт полей, иначе ломаются потребители.
- Нормализуйте справочники и храните ID. Денормализуйте осознанно и решите, кто поддерживает согласованность копий.
- Для аналитики с JSON-событиями полезны полуструктурированные типы в хранилище (JSON в PostgreSQL и аналогах). Но пересчитывайте в колонки то, по чему фильтруете.
- Предпочитайте declarative запросы (SQL): их оптимизирует движок и параллелит. Пишите imperative код, только если декларации не хватает.
- Рекурсивные иерархии (категории, оргструктура, lineage) в SQL делайте через recursive CTE. Если обходов много, подумайте о graph базе.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему документная модель хорошо хранит резюме, но плохо справляется с рекомендациями между пользователями?
- Чем schema-on-read отличается от schema-on-write? Когда нужна первая?
- Почему declarative запрос проще оптимизировать и выполнять параллельно?
- Почему запрос с путём переменной длины в SQL намного длиннее, чем в Cypher?
Предыдущая: Надёжность, масштабируемость, сопровождаемость. Следующая: Хранение и извлечение.