

AI Engineering, глава 10: Архитектура AI-приложения и обратная связь
Главная мысль: AI-приложение растёт по шагам. Каждый новый блок решает одну проблему, но добавляет сложность и новые точки отказа. Поэтому нужны observability и user feedback: они показывают, что ломается и как улучшать продукт.
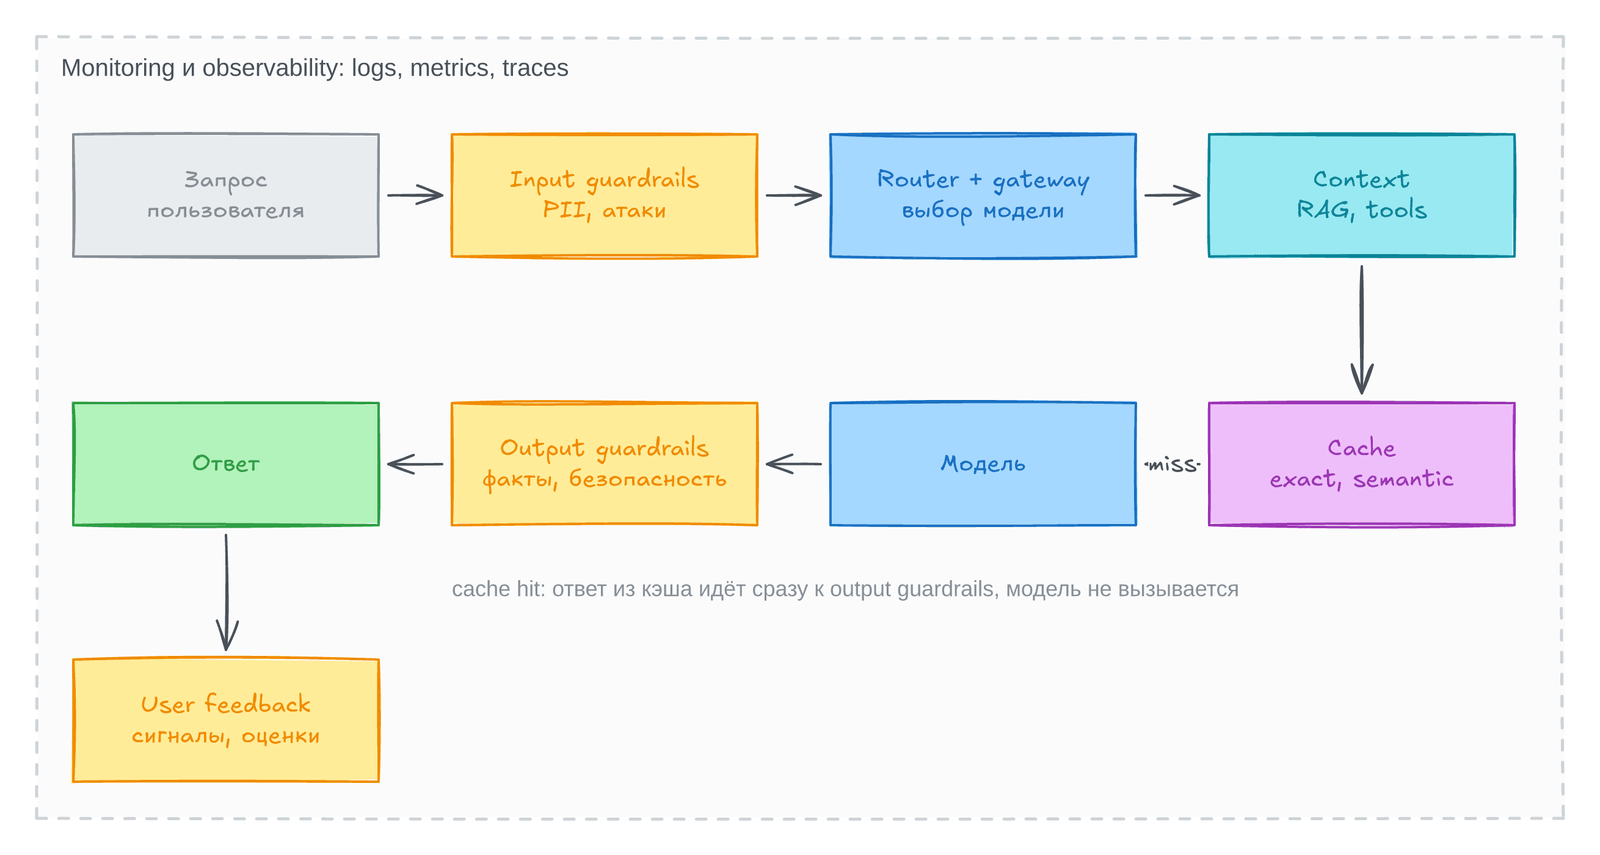
Архитектура по шагам
Заголовок раздела «Архитектура по шагам»Старт: запрос идёт в модель, ответ возвращается. Нет контекста, защиты и оптимизации.
| Шаг | Что добавляем | Какую проблему решаем |
|---|---|---|
| 1 | Context (RAG, tools) | Модель не знает ваших данных |
| 2 | Guardrails на входе и выходе | Утечки данных, плохие ответы |
| 3 | Router и gateway | Много моделей, высокая цена |
| 4 | Cache | Latency и стоимость |
| 5 | Agent patterns, write actions | Сложные задачи, действия во внешнем мире |
Шаг 1. Контекст
Заголовок раздела «Шаг 1. Контекст»Контекст строят через retrieval (текст, картинки, таблицы) и tools (поиск, внутренние API). Автор называет это feature engineering для foundation model. Провайдеры дают это из коробки, но с лимитами: на число файлов, размер chunk, параллельные вызовы.
Шаг 2. Guardrails
Заголовок раздела «Шаг 2. Guardrails»Guardrails защищают вас и пользователей. Они бывают двух видов.
Input guardrails закрывают два риска:
- утечка приватных данных во внешний API;
- вредные prompt, которые взламывают систему.
Утечки идут из prompt сотрудников, системного prompt и из tools, которые достают данные из внутренних баз.
Что делают с чувствительными данными (PII, ключевые слова, лица):
- блокируют весь запрос;
- маскируют данные. Например, телефон заменяют на
[PHONE NUMBER]. В ответе модели плейсхолдер возвращают обратно через PII reverse map.
Output guardrails ловят плохие ответы и задают правила, что делать дальше.
| Тип сбоя | Примеры |
|---|---|
| Качество | Битый формат (невалидный JSON), галлюцинации, просто плохой ответ |
| Безопасность | Токсичный текст, утечка PII, вызов опасных tools, риск для бренда |
Следите и за false refusal rate. Слишком строгая система блокирует нормальные запросы и злит людей.
Что делать при сбое: retry (модель вероятностная, но это latency и cost), параллельные вызовы (берём лучший ответ), передача человеку (злость в сообщениях, много ходов).
Компромиссы: guardrails добавляют latency. В режиме streaming частичный ответ проверить трудно, плохой текст может уйти раньше блокировки. Self-hosted модель не шлёт данные наружу, поэтому input guardrails нужны реже.
Шаг 3. Router и gateway
Заголовок раздела «Шаг 3. Router и gateway»Router выбирает, куда отправить запрос. Обычно это intent classifier.
Пример для support-бота:
| Intent | Куда |
|---|---|
| Сброс пароля | Страница FAQ |
| Ошибка в счёте | Живой оператор |
| Техническая проблема | Специальная модель |
| Неясный запрос (“заморозить”) | Уточняющий вопрос |
Router даёт специализированные модели, экономию (простое идёт в дешёвую модель) и отказ без вызова модели на запросы не по теме.
Router может выбирать и следующее действие агента. Он должен быть быстрым и дешёвым: часто это маленькая модель. Если у моделей разные лимиты контекста, контекст обрезают или берут модель побольше. Чаще всего порядок такой: routing, retrieval, generation, scoring.
Model gateway - единая точка доступа к моделям.
- Единый интерфейс к разным провайдерам и self-hosted моделям. Если API изменилось, правят только gateway.
- Access control: люди получают доступ к gateway, а не ключи провайдера.
- Fallback: другая модель или retry при rate limit и сбоях API.
Шаг 4. Cache
Заголовок раздела «Шаг 4. Cache»Это system cache. Про KV cache и prompt cache говорилось в главе 9. Их обычно даёт провайдер.
| Вид | Как работает | Риск |
|---|---|---|
| Semantic cache | Ответ берётся и для похожего запроса (embedding + vector search + порог similarity) | Ложное совпадение, нужен подбор порога, лишняя нагрузка |
Заметки:
- Cache полезен для долгих запросов: retrieval, SQL, web search. Хранят в памяти, Redis или PostgreSQL, с политикой вытеснения (LRU, LFU, FIFO).
- Не кэшируйте личные запросы (“статус моего заказа”) и зависящие от времени (“погода”).
- Опасность утечки. Вопрос про возврат товара выглядит общим. Но ответ зависит от статуса клиента. Если ответ клиента X попал в общий cache, клиент Y увидит его данные.
- Автор сомневается в пользе semantic cache. Он стоит делать, только если доля попаданий высокая.
Шаг 5. Agent patterns и write actions
Заголовок раздела «Шаг 5. Agent patterns и write actions»- Поток может иметь циклы и ветки: система видит, что ответ не решил задачу, и делает новый поиск.
Write actionsменяют внешний мир: письмо, заказ, перевод денег. Риск растёт. Давайте такой доступ очень осторожно.
Monitoring и observability
Заголовок раздела «Monitoring и observability»Чем сложнее система, тем нужнее observability. Её закладывают с начала, не после запуска.
- Monitoring - следить за внешними показателями системы.
- Observability - уметь понять внутреннее состояние по логам и метрикам без нового кода.
Три метрики из DevOps: MTTD (как быстро заметили проблему), MTTR (как быстро исправили), CFR (доля изменений, которые ломают продукт). Высокий CFR может значить слабую evaluation pipeline. Проблемы из прода должны попадать в eval.
Метрики
Заголовок раздела «Метрики»Метрика нужна, чтобы увидеть сбой. Сначала решите, какие сбои вы ловите, потом выбирайте метрики.
| Что ловим | Примеры метрик |
|---|---|
| Галлюцинации | Следует ли ответ из контекста |
| Безопасность | Токсичность, PII на входе и выходе, частота срабатывания guardrails, доля отказов |
| Поведение пользователей | Остановка генерации, число ходов, токены на вход и выход |
| Latency | TTFT, TPOT, общее время |
| Стоимость | Число запросов, токены, hit rate cache, запросы в секунду (rate limit) |
Советы:
- Сравнивайте метрики с
north star(DAU, подписки). Не связанные с ним метрики, возможно, не нужны. - Считайте по выборке или по всем запросам.
- Делайте срезы: пользователь, релиз, версия prompt, тип запроса, время.
Логи и traces
Заголовок раздела «Логи и traces»- Метрики показывают, что что-то сломалось. Логи показывают, что именно.
- Логи должны быть доступны быстро. Если они приходят с задержкой 15 минут, проблему 5-минутной давности вы не разберёте.
- Правило: логируйте всё. Конфигурацию (модель, endpoint, temperature, top-p), запрос пользователя, итоговый prompt, ответ, промежуточные шаги, вызовы tools и их вывод. Добавляйте теги и ID.
- Объём логов быстро растёт. Для анализа есть AI-инструменты. Но раз в день смотрите данные из прода вручную: так меняется ваше понимание “хорошего” ответа.
- Trace склеивает события одного запроса в цепочку: что получили, какие документы нашли, какой prompt ушёл, сколько заняло время и стоило. По trace видно, на каком шаге сбой: запрос обработан неверно, контекст нерелевантный или модель ошиблась.
Drift detection
Заголовок раздела «Drift detection»Источники drift:
- Системный prompt изменился незаметно: обновили шаблон или коллега поправил опечатку. Это легко поймать простой проверкой.
- Поведение пользователей меняется. Они учатся писать запросы, например просят отвечать короче. Метрика длины ответа падает, и причину видно не сразу.
- Модель за API обновилась без объявления. У Voiceflow после перехода на новую версию GPT-3.5-turbo качество упало на 10%.
Orchestration AI-пайплайна
Заголовок раздела «Orchestration AI-пайплайна»Orchestrator задаёт, как компоненты работают вместе. Две части:
- Определение компонентов: модели, источники данных, tools, инструменты eval и monitoring.
- Chaining: шаги от запроса до результата.
Пример цепочки: обработать запрос, достать данные, собрать prompt, получить ответ, оценить его. Если ответ хороший, вернуть. Иначе передать человеку.
Orchestrator следит за форматом данных между шагами и сообщает об ошибках потока.
Заметки:
- Это не
Airflow: цель здесь другая, обработка одного запроса пользователя. - Независимые шаги запускайте параллельно (router и удаление PII).
- Инструменты: LangChain, LlamaIndex, Haystack.
- Сначала соберите приложение без orchestrator. Внешний инструмент прячет детали и усложняет отладку.
User feedback
Заголовок раздела «User feedback»Для AI-продукта feedback особенно важен. Это ваши собственные данные и конкурентное преимущество: основа data flywheel (глава 8). Feedback нужен для оценки, для обучения будущих моделей и для персонализации. Это пользовательские данные, поэтому нужна приватность и прозрачность: люди должны знать, как их данные используются.
Как извлекать conversational feedback
Заголовок раздела «Как извлекать conversational feedback»Явный feedback: лайк и дизлайк, звёзды, вопрос “Решили ли мы проблему?”. Его понимать проще, но его мало, и он смещён: недовольные пишут чаще.
Неявный feedback богаче, но шумнее. Диалог даёт много сигналов.
| Сигнал | Что может значить |
|---|---|
| Остановил генерацию, ушёл из приложения | Диалог идёт плохо |
| ”Нет, …” или “Я имел в виду …” | Ответ неверный |
| Перефразировал запрос | Модель не поняла намерение |
| ”Ты уверен?”, “Покажи источники” | Не хватает деталей или нет доверия |
| Правка ответа пользователем | Сильный сигнал, что ответ неточен |
| Жалоба: неверно, неполно, слишком длинно | Показывает, как именно бот подводит |
| Длина и повторы в диалоге | Зависит от продукта. Длинный диалог с повторами значит, что пользователь застрял |
| Regeneration | Недоволен ответом или хочет варианты (особенно в творческих задачах) |
| Удалил, переименовал, поделился диалогом | Удаление обычно плохо, переименование: хороший диалог с плохим заголовком. Поделиться можно по обеим причинам |
Важно: каждая правка пользователя даёт пару для preference data (исходный ответ проигрывает, исправленный выигрывает). Смысл сигнала зависит от продукта, поэтому изучайте пользователей.
Как проектировать feedback
Заголовок раздела «Как проектировать feedback»Когда собирать:
- в начале: калибровка, лучше необязательная, с нейтральным значением по умолчанию;
- при сбое: дать отклонить ответ, повторить, сменить модель, написать словами, позвать человека;
- при низкой уверенности модели: показать два варианта на выбор;
- при успехе: спорно. Apple не советует просить такой feedback, но он помогает найти ценные функции. Можно спрашивать 1% пользователей.
Как собирать:
- Встраивайте feedback в рабочий процесс. Copilot: Tab принимает подсказку, продолжение печати отклоняет её. Оба действия дают сигнал.
- Следите за ясностью интерфейса. В форме Luma сердитый emoji стоял на месте оценки в пять звёзд, и люди выбирали его по ошибке.
Ограничения feedback
Заголовок раздела «Ограничения feedback»| Проблема | Суть | Что делать |
|---|---|---|
| Leniency bias | Люди ставят оценки добрее, чем думают | Смотрите распределение оценок. Дайте описательные варианты вместо цифр |
| Position и preference bias | Первый вариант и длинный ответ выбирают чаще | Меняйте порядок, изучайте feedback на смещения |
| Degenerate feedback loop | Модель влияет на показ, показ влияет на feedback, смещение растёт | Показывайте разное, контролируйте перекос |
Про degenerate loop. Видео выше в рейтинге получает больше кликов, и система верит, что оно лучшее. Похожий процесс может превратить приложение для картинок в “кошачий рай”. Модель, обученная на человеческом feedback, также склонна к sycophancy: она говорит то, что хочет слышать пользователь.
Feedback улучшает продукт, но без понимания ограничений вредит.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- AI gateway стал отдельным продуктом. LiteLLM, облачные шлюзы и шлюзы в Databricks или Snowflake дают роутинг, лимиты, логи и учёт стоимости.
- Observability по стандарту. OpenTelemetry описывает semantic conventions для GenAI: модель, токены, стоимость, вызовы tools. Langfuse, Arize, Braintrust и другие собирают traces агентов.
- Архитектура агентов. К схеме главы добавились MCP-серверы, sandbox для кода и подтверждение рискованных действий человеком.
- Evals в продакшене. Часть трафика оценивает LLM-судья онлайн. Feedback и оценки идут в warehouse как обычные данные.
- Архитектура «по шагам» из главы работает. Начинайте с простого и добавляйте блоки по мере проблем.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Router | Выбирает модель или действие, часто через intent classifier |
| Trace | Полный путь одного запроса по шагам |
| Input guardrails | Защита на входе: PII, вредные prompt |
| Model gateway | Единая точка доступа к моделям: доступ, лимиты, fallback |
| Exact cache | Кэш для точно совпадающих запросов |
| Semantic cache | Кэш по похожести embedding |
| Observability | Возможность понять сбой по логам, метрикам и traces |
| MTTD, MTTR, CFR | Время обнаружения, время исправления, доля неудачных изменений |
| Drift | Незаметное изменение prompt, пользователей или модели |
| Degenerate feedback loop | Модель усиливает свои же смещения через feedback |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Логи LLM - это данные. Пишите запросы, итоговый prompt, ответ, версию prompt, модель, токены, latency и cost в таблицы warehouse. Логируйте с ID запроса, чтобы связать шаги trace.
- Метрики AI считайте в dbt. Модели для cost по дням, hit rate cache, доли отказов и невалидного формата, срезы по версии prompt и релизу.
- Feedback идёт в eval-датасет. Плохие диалоги, правки и дизлайки превращайте в тестовые случаи. Правки дают пары для finetuning, если пользователь согласен.
- Cache и drift. Включайте в ключ cache пользователя или права доступа. Ставьте алерт на смену prompt и версии модели.
- PII не должна попасть во внешний API. Если вы строите контекст из warehouse, фильтруйте колонки до запроса. Маскирование на входе дешевле, чем разбор инцидента.
- Смотрите распределение оценок, а не среднее. Проверяйте leniency и position bias до того, как использовать feedback для обучения.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- В каком порядке вы добавите блоки к простой схеме “запрос, модель, ответ” и какую проблему решает каждый?
- Почему semantic cache рискованнее exact cache? Как cache может раскрыть данные другого пользователя?
- Чем observability отличается от monitoring? Что дают метрики, логи и traces по отдельности?
- Какие сигналы в диалоге говорят о плохом ответе и почему неявный feedback шумный? Как возникает degenerate feedback loop?
Предыдущая: Inference optimization. Следующая: Обзор книги.