

Fundamentals of Data Engineering, глава 7: Приём данных
Главная мысль: ingestion (приём данных) это перенос данных из источника в хранилище. Здесь data engineer впервые активно проектирует pipeline. Выбор зависит от частоты, объёма, формата и надёжности источника.
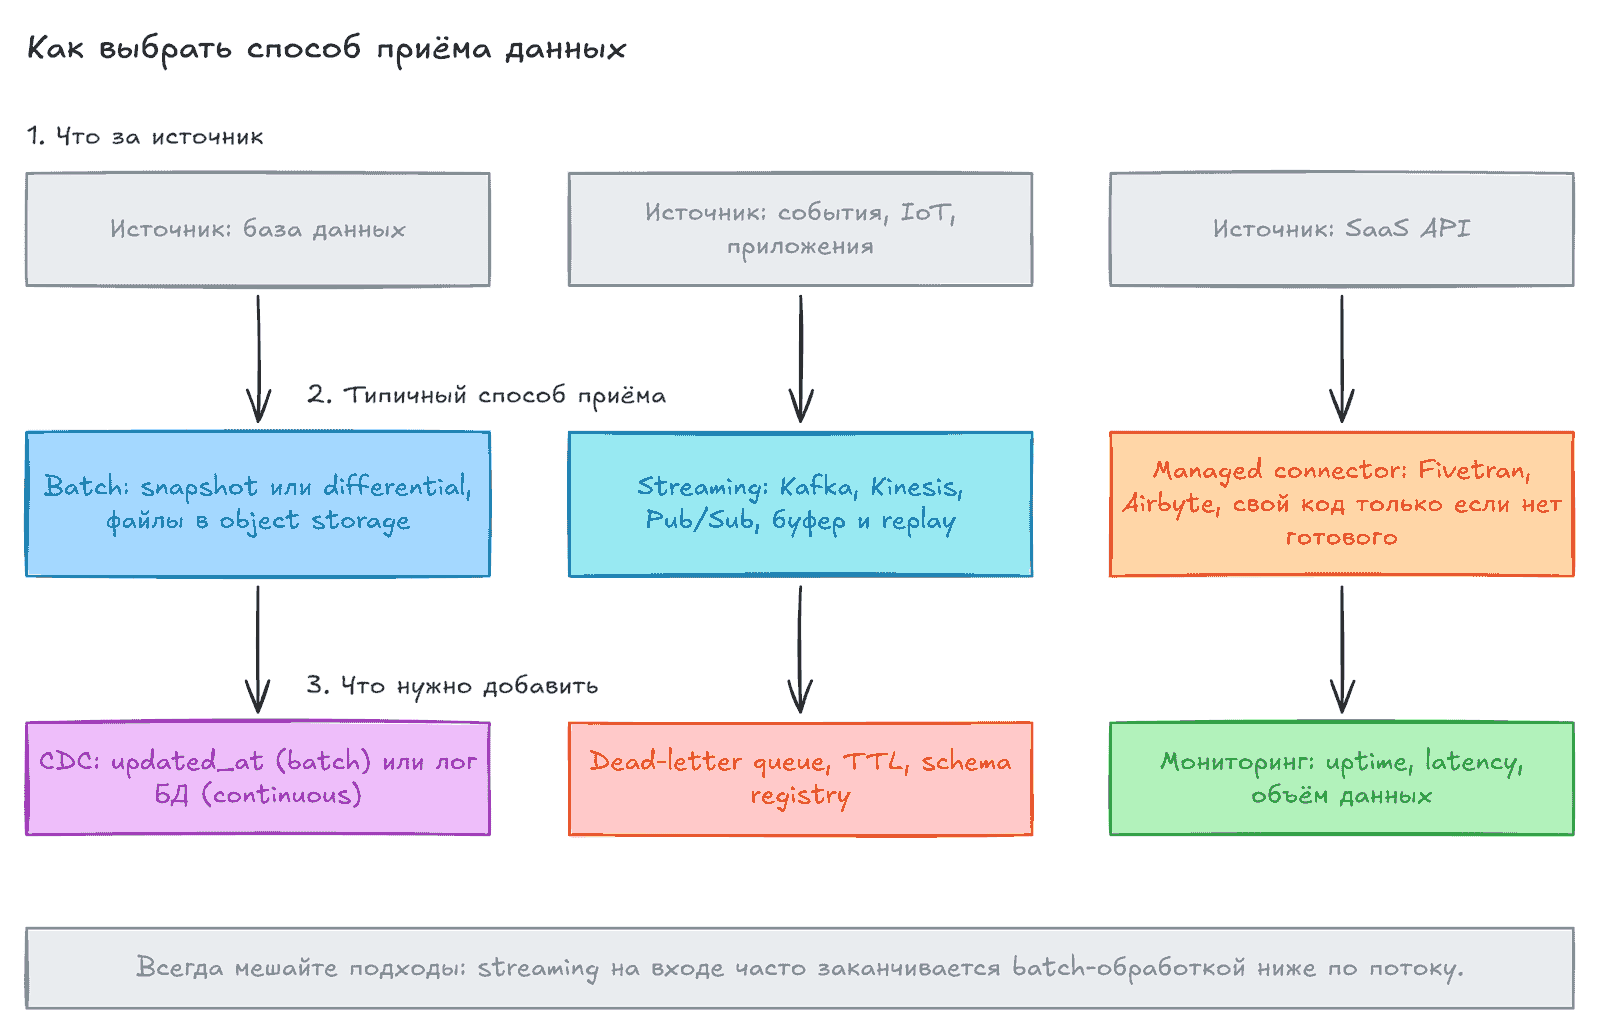
Что такое ingestion
Заголовок раздела «Что такое ingestion»- Ingestion переносит данные из точки A в точку B. Data integration объединяет данные из разных источников в новый набор.
Data pipelineэто архитектура, системы и процессы, которые двигают данные через весь жизненный цикл. Это может быть классический ETL или облачный набор сервисов.- Не держитесь за одну философию. Выбирайте инструмент под задачу.
Что учесть при проектировании
Заголовок раздела «Что учесть при проектировании»Сначала ответьте на вопросы: зачем нужны данные, куда они идут, как часто обновляются, какой объём и формат, хорошего ли они качества.
| Аспект | Суть |
|---|---|
| Bounded / unbounded | Любые данные в реальности unbounded (поток). Bounded это набор, ограниченный, например, временем |
| Frequency | Batch, micro-batch или streaming. “Real-time” всегда near real-time. Ниже по потоку обычно остаётся batch |
| Synchronous / asynchronous | Синхронные шаги жёстко зависят друг от друга: сбой одного останавливает всё. Асинхронные работают по событиям и проще масштабируются |
| Serialization | Приёмник должен уметь десериализовать данные (см. приложения) |
| Throughput | Нужен буфер для пиков и backfill после сбоя. Лучше managed service |
| Reliability и durability | Uptime плюс сохранность данных. Баланс с ценой: полная защита всегда дорога |
| Payload | Kind (тип и формат), shape, size, schema, metadata |
| Push / pull / poll | Источник отправляет, приёмник читает, или приёмник периодически проверяет изменения |
Schema и metadata
Заголовок раздела «Schema и metadata»- Сложность не в подключении к БД, а в понимании схемы. ORM часто создаёт неочевидные структуры.
- Источник меняет схему: новая колонка, смена типа, переименование. Автоматическое обновление таблиц помогает, но может сломать downstream.
- Нужны оповещения об изменениях и общение с владельцами источника.
Schema registryхранит версии схем сообщений для producers и consumers.- Без metadata данные теряют ценность. Так бывает с data swamp.
Batch ingestion
Заголовок раздела «Batch ingestion»- Бывает по времени (раз в сутки) или по размеру (блок событий в object storage).
- Snapshot или differential. Snapshot читает всё состояние. Differential (incremental) читает только изменения. Snapshot проще, поэтому его часто выбирают.
- File-based export. Источник сам выгружает файлы (push). Доступ к БД не нужен. Обмен через object storage, SFTP, SCP, EDI.
- ETL и ELT. Extract может быть и push. Load зависит от схемы и нагрузки на приёмник.
- Размер батча. Много мелких insert и update плохо работают в колоночных базах. Знайте ограничения инструмента. Например, BigQuery лучше принимает данные через stream buffer.
- Data migration. Сложнее всего перенести подключения pipeline, а не данные. Сначала тест на выборке, чтобы найти различия схем.
Message и stream ingestion
Заголовок раздела «Message и stream ingestion»| Тема | Что важно |
|---|---|
| Schema evolution | Schema registry, dead-letter queue, договорённости с командами источника |
| Late-arriving data | Event time не равно ingestion time. Задайте cutoff, после которого поздние данные не берутся |
| Ordering и multiple delivery | Сообщения могут прийти не по порядку и больше одного раза (at-least-once) |
| Replay | Перечитать историю за период. Есть в Kafka, Kinesis, Pub/Sub. RabbitMQ обычно удаляет прочитанное |
| TTL | Срок жизни события. Слишком короткий теряет данные. Слишком длинный копит backlog |
| Message size | Kinesis до 1 MB. Kafka по умолчанию 1 MB, настраивается |
| Consumer pull / push | Kafka и Kinesis только pull. Pub/Sub и RabbitMQ умеют и push |
| Location | Ближе к источнику лучше по задержке. Но egress между регионами дорог |
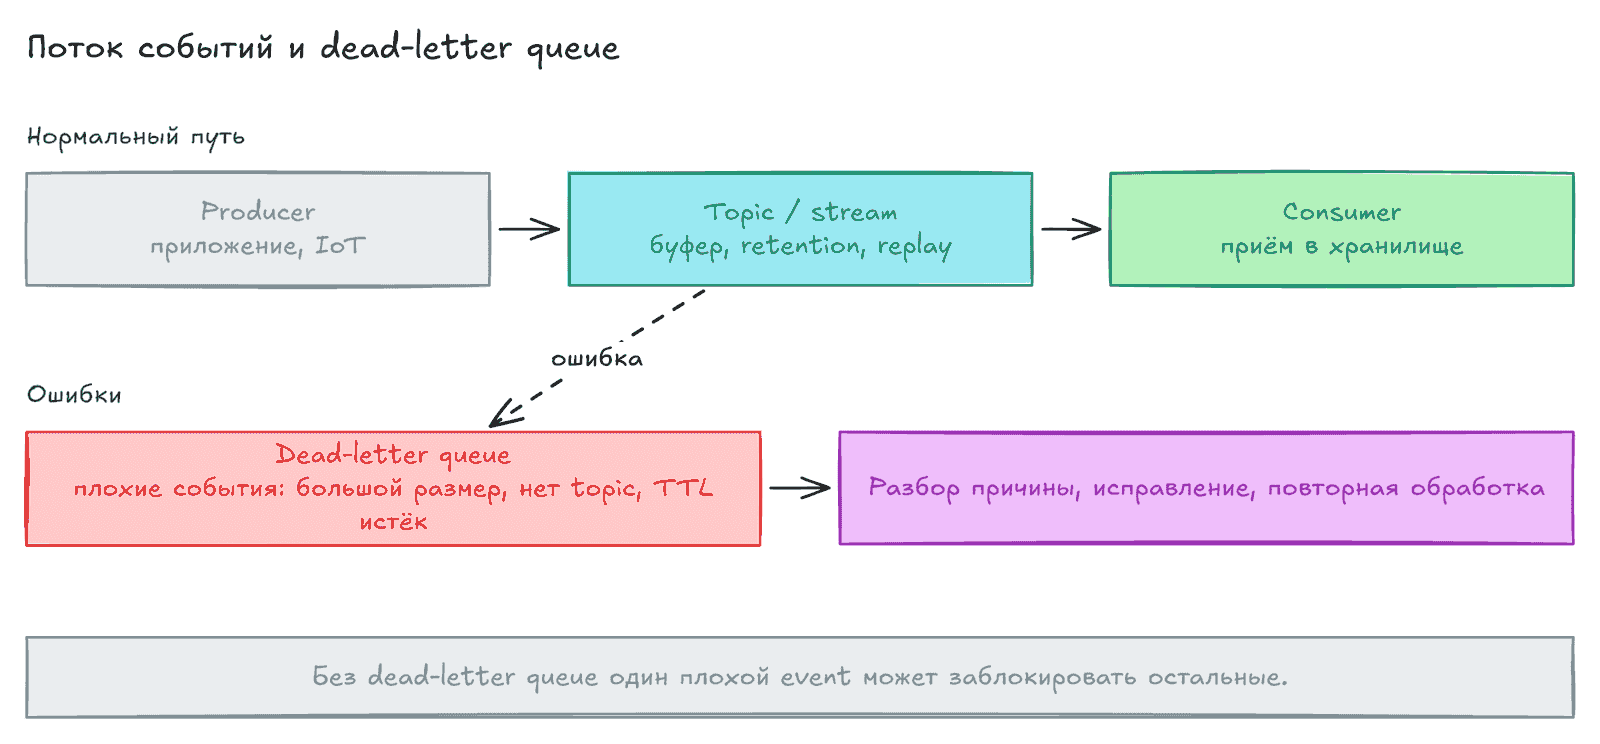
Dead-letter queue отделяет проблемные события. Так они не блокируют остальные. Их потом разбирают и обрабатывают повторно.
Способы приёма данных
Заголовок раздела «Способы приёма данных»- Прямое подключение (JDBC/ODBC). Читает строки по сети. Плохо работает с nested данными и колоночными БД. Параллельные соединения ускоряют, но нагружают источник. Лучше связать с object storage и orchestration.
- CDC (change data capture). Приём изменений из БД.
- API. Единого стандарта нет. Используйте клиентские библиотеки, managed connectors и data sharing. Свой код пишите, когда готового нет. Тогда нужны version control, тесты и orchestration.
- Message queue и event streaming. Данные могут идти нелинейно: publish, consume, republish. Нужны partitions, ресурсы и autoscaling. Лучше managed.
- Managed data connectors (Fivetran, Airbyte, Matillion). Это рутина, лучше отдать её.
- Object storage. Самый удобный и безопасный способ обмена файлами. Есть signed URL для временного доступа.
- EDI. Старые способы вроде почты и флешек. Хотя бы автоматизируйте: почтовый сервер сохраняет файл в storage и запускает pipeline.
- Файловая выгрузка из БД. Большие сканы нагружают источник. Разбивайте по диапазонам ключей или читайте с read replica.
- Форматы файлов. CSV ненадёжен: разделители, кавычки, нет схемы. Autodetect не для production. Parquet, Avro, Arrow, ORC хранят схему и nested данные.
- Shell и SSH. Shell подходит для простых скриптов. SSH это протокол, не стратегия. Базу не открывайте в интернет, используйте bastion host.
- SFTP и SCP. Часто нужны из-за партнёров. Требуют анализа безопасности.
- Webhooks. “Обратные API”: провайдер сам вызывает ваш endpoint. Такие схемы хрупкие. Лучше собирать из готовых сервисов.
- Web interface и web scraping. Ручные выгрузки ненадёжны. Scraping имеет юридические и этические риски, а HTML часто меняется.
- Transfer appliance. Для 100 TB и больше данные проще отправить физическим устройством. Только для разовых миграций.
- Data sharing. Вы читаете данные провайдера, но не владеете ими. Строго говоря, это не ingestion.
CDC подробнее
Заголовок раздела «CDC подробнее»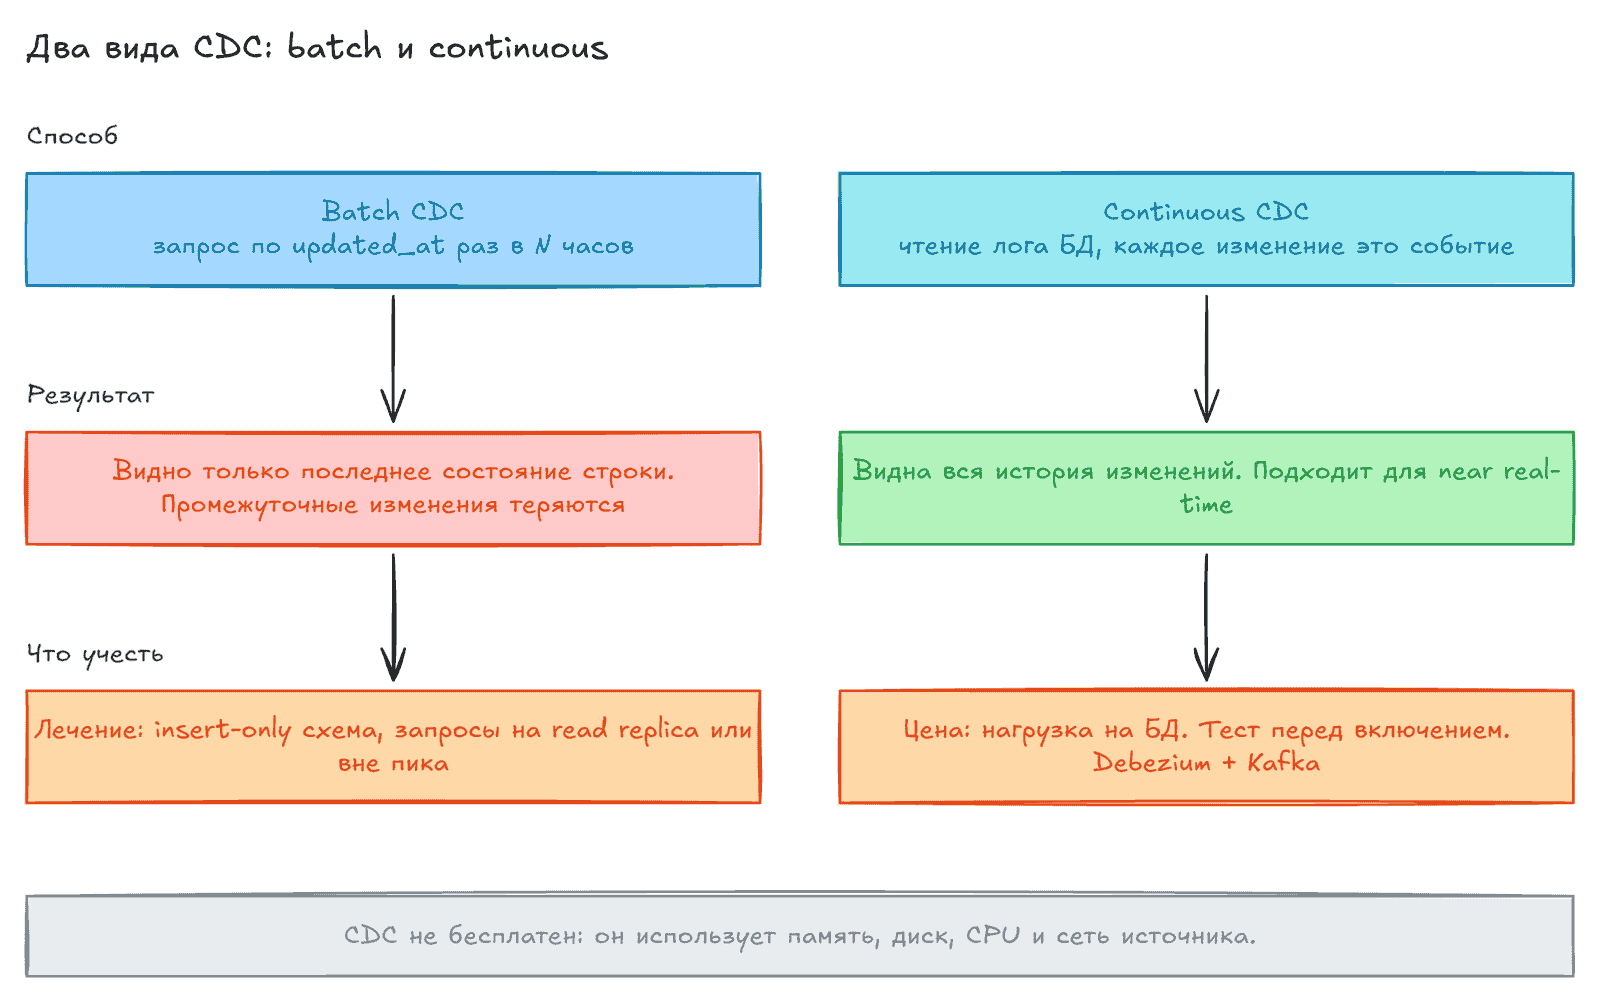
- Batch CDC фильтрует по полю
updated_at. Видно только последнее состояние строки. - Continuous CDC читает лог БД (например, через Debezium и Kafka). Каждое изменение становится событием.
- Синхронная replication держит копию полностью синхронной. Нужен тот же тип БД. Read replica снимает нагрузку.
- Асинхронная replication слабее связана и отправляет события в несколько приёмников.
- CDC потребляет ресурсы источника. Тестируйте до включения в production.
С кем работать
Заголовок раздела «С кем работать»- Upstream. Software engineers обычно не видят data engineers как стороннюю заинтересованную сторону. Начните с общения. Привлекайте product managers.
- Downstream. Помните о бизнесе, например о маркетинге. Часто простая автоматизация даёт больше пользы, чем сложный streaming.
Undercurrents
Заголовок раздела «Undercurrents»- Security. Шифруйте данные при передаче. Внутри VPC используйте secure endpoints. Между облаком и on-premises нужен VPN или private connection.
- Data management. Лучше не собирать чувствительные данные вообще. Если нужны, применяйте tokenization или hash при приёме (с salt). Работайте по принципу touchless production и broken-glass процессу. Не полагайтесь на шифрование как на волшебное средство.
- Schema changes. Ни бюрократия, ни полностью автоматический пересоздаваемый приёмник не идеальны. Идея: версии таблиц, как ветки в Git.
- DataOps. Мониторьте uptime, latency, объём данных и разные виды времени. Тихие регрессии данных опаснее громких. Нужны тесты качества.
- Orchestration. Cron хрупок. Нужен оркестратор, который запускает весь граф задач.
- Software engineering. Используйте version control, review, тесты. Держите код слабо связанным с источником и приёмником.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Ingestion | Перенос данных из источника в хранилище |
| Data pipeline | Архитектура, системы и процессы для движения данных |
| Bounded / unbounded data | Ограниченный набор или бесконечный поток |
| Payload | Набор данных, который вы принимаете |
| Schema registry | Хранилище версий схем сообщений |
| CDC | Приём изменений из БД |
| Dead-letter queue | Очередь для событий, которые не удалось принять |
| TTL | Максимальное время жизни события |
| Replay | Повторное чтение событий за период |
| Webhook | Источник сам вызывает ваш endpoint |
| Transfer appliance | Физическое устройство для переноса больших объёмов |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с источника и случая использования. Потом выбирайте batch или streaming.
- Не пишите свой коннектор, если есть managed. Экономьте время на значимых задачах.
- Для streaming настройте dead-letter queue, TTL, schema registry и правило для поздних данных.
- Включайте CDC и большие выгрузки только после согласования с владельцами источника. Лучше читать с read replica.
- Не принимайте чувствительные поля без необходимости.
- Мониторинг и оповещения нужны с первого дня.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем batch CDC отличается от log-based CDC и какие данные теряет первый?
- Зачем нужен dead-letter queue?
- Почему CSV плохо подходит для production ingestion?
- Когда лучше использовать transfer appliance, а когда managed connector?
Предыдущая: Хранение. Следующая: Запросы, моделирование, трансформация.