

AI Engineering, глава 6: RAG и агенты
Главная мысль: Модели нужен правильный контекст для каждого запроса. RAG достаёт этот контекст из внешних данных. Агент идёт дальше: он сам выбирает инструменты, планирует шаги и проверяет результат.
В прошлой главе мы писали инструкции. Они одинаковы для всех запросов. Контекст другой для каждого запроса. Автор сравнивает его с feature engineering в классическом ML: мы даём модели данные, нужные для ответа.
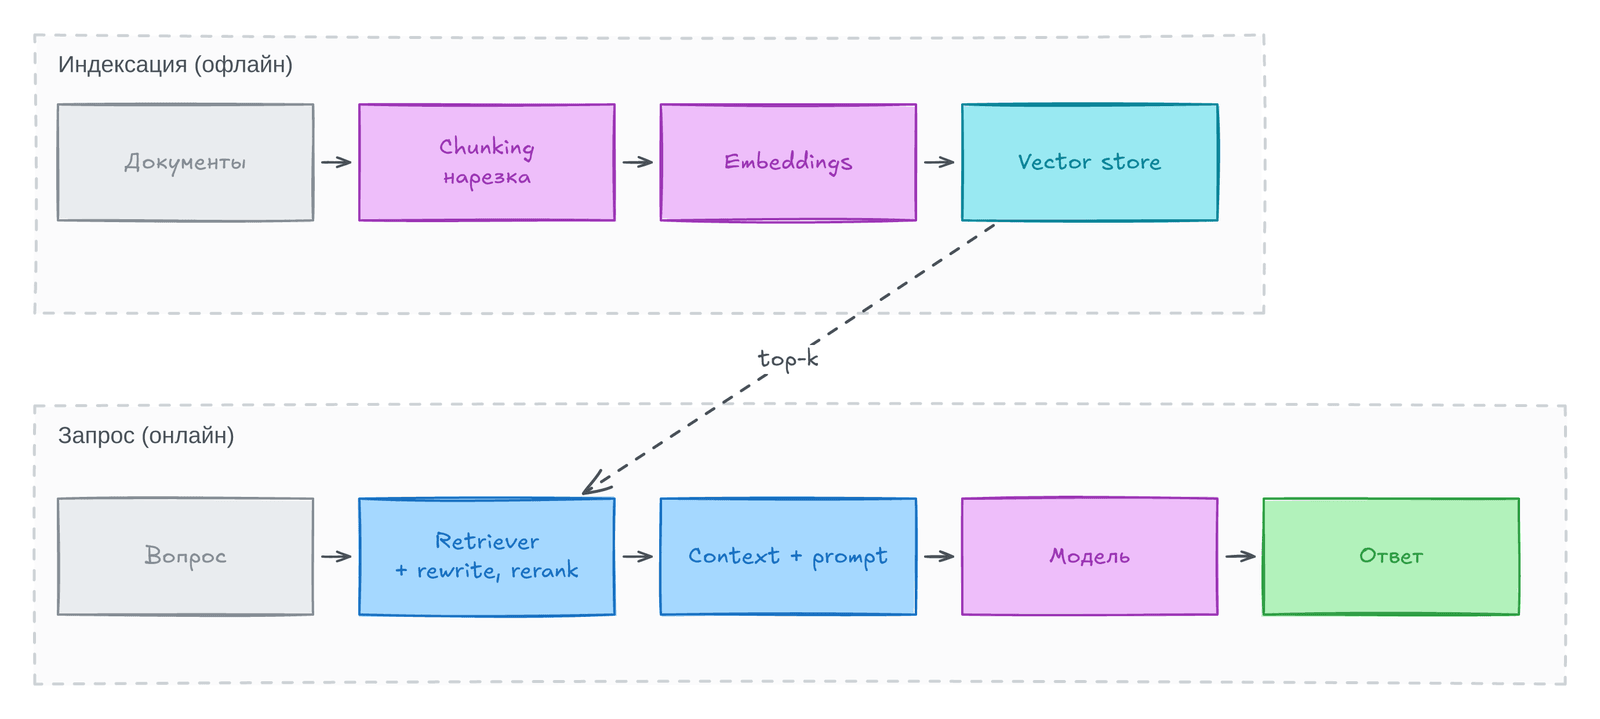
RAG: как он устроен
Заголовок раздела «RAG: как он устроен»Система RAG (retrieval-augmented generation) состоит из двух частей:
- Retriever находит нужные куски данных во внешнем хранилище.
- Generator (модель) пишет ответ по этим кускам и вопросу.
У retriever две функции. Indexing готовит данные заранее (offline). Querying ищет по запросу (online). Способ индексации зависит от способа поиска.
Пример: бот поддержки получает вопрос про экспорт в Parquet. Retriever берёт страницу про тарифы, модель отвечает по ней.
Зачем RAG, если контекст моделей растёт: данных всегда больше, чем влезет в контекст. Длинный контекст модель использует плохо. Каждый токен стоит денег и добавляет latency.
Если база знаний меньше 200 000 токенов (около 500 страниц), Anthropic советует класть её в prompt целиком, без RAG.
Retrieval: как искать
Заголовок раздела «Retrieval: как искать»Retrieval считает, насколько каждый документ подходит к запросу. Идея старая: на ней стоят поисковики. BM25 остаётся сильной базой для сравнения. Слово «документ» ниже значит и chunk.
Term-based и embedding-based
Заголовок раздела «Term-based и embedding-based»| Term-based (lexical) | Embedding-based (semantic) | |
|---|---|---|
| Как ищет | По ключевым словам | По близости смысла |
| Примеры | BM25, Elasticsearch | Embedding model + vector database |
| Скорость и цена | Быстро и дёшево | Дороже: embeddings, хранение, vector search |
| Сильная сторона | Точные термины, коды ошибок, названия продуктов | Живые формулировки запросов |
| Слабая сторона | Не понимает смысл: «transformer» найдёт и фильм | Может «размыть» точные ключи вроде кода ошибки |
| Улучшение | Мало настроек | Можно дообучить модель и retriever |
Как работает term-based поиск:
TF(term frequency): чем чаще слово в документе, тем документ важнее.IDF(inverse document frequency): чем в большем числе документов слово, тем оно менее информативно. Слова «для» и «при» почти не важны.TF-IDFобъединяет обе идеи.BM25добавляет поправку на длину документа.- Данные хранят в
inverted index: слово -> список документов.
Как работает embedding-based поиск:
- Chunks превращают в embeddings. Их кладут в
vector database. - Запрос превращают в embedding той же моделью.
- Находят
kближайших векторов.
Точный перебор (k-NN) медленный. На больших данных используют ANN (approximate nearest neighbor): HNSW, IVF, LSH, product quantization. Библиотеки: FAISS, ScaNN, Hnswlib. Любая БД, которая хранит векторы, может быть vector database.
Hybrid search
Заголовок раздела «Hybrid search»В production обычно сочетают оба метода.
- Последовательно: дешёвый retriever берёт кандидатов, точный и дорогой выбирает лучших. Второй шаг называют
reranking. - Параллельно: несколько retrievers дают свои рейтинги. Их сливают, например, через
RRF(reciprocal rank fusion). Документ получает сумму1 / (k + rank)по всем рейтингам. Обычноk = 60.
Улучшение и оценка retrieval
Заголовок раздела «Улучшение и оценка retrieval»Chunking
Заголовок раздела «Chunking»Документ режут на части. Это сильно влияет на качество.
- Единицы: символы, слова, предложения, абзацы, токены модели.
- Рекурсивно: разделы, потом абзацы, потом предложения.
- По типу данных: код, пары «вопрос-ответ».
- Нужен
overlap, иначе фраза порвётся посередине. - Chunk не должен быть больше контекста generator и embedding model.
- Chunking по токенам: при смене tokenizer нужна переиндексация.
| Размер chunk | Плюс | Минус |
|---|---|---|
| Меньше | В контекст влезает больше разных кусков | Теряется общий смысл. Больше векторов, больше стоимость, медленнее поиск |
| Больше | Больше смысла в одном куске | Меньше разнообразия в контексте |
Лучшего размера для всех нет. Нужны эксперименты.
Reranking
Заголовок раздела «Reranking»Reranking уточняет порядок кандидатов. Он нужен, чтобы уместить меньше документов в контекст. Можно ранжировать и по времени: для новостей, почты, бирж свежие данные важнее. В контексте порядок важен меньше, чем в поиске. Но модели лучше видят начало и конец контекста.
Query rewriting
Заголовок раздела «Query rewriting»Запрос в диалоге часто неполный. После вопроса «Какой тариф у Acme?» пользователь пишет «А у Globex?». В поиск это отправлять нельзя. Модель переписывает запрос: «Какой тариф у Globex?» Если данных не хватает («тариф его партнёра»), модель должна сказать, что вопрос не решить, и не выдумывать ответ.
Contextual retrieval
Заголовок раздела «Contextual retrieval»Идея: добавить к каждому chunk контекст, чтобы его проще было найти.
- Метаданные: теги, ключевые слова, сущности. Код ошибки в метаданных помогает найти chunk, даже если он стал embedding.
- Вопросы, на которые отвечает chunk. Для статьи «Как сбросить пароль» это «не могу войти», «забыл пароль».
- Контекст документа. Anthropic просит модель написать 50-100 токенов о том, где chunk стоит в документе, и добавляет их в начало chunk.
Оценка retrieval
Заголовок раздела «Оценка retrieval»Context precision: какая доля найденных документов релевантна.Context recall: какая доля всех релевантных документов найдена. Для неё нужно знать релевантность всех документов в базе, поэтому её считают реже.- Для порядка в выдаче:
NDCG,MAP,MRR. - Embeddings оценивают бенчмарками
MTEBиBEIR. Для vector search смотрятrecall,QPS, время построения и размер индекса.
Нужен evaluation set: запросы и документы с метками релевантности (люди или AI judge). Retriever хорош, если помогает получить хороший итоговый ответ. Оценивают и части, и систему целиком.
Цена: основная latency RAG уходит на генерацию, поиск добавляет немного. Но embeddings нужно пересчитывать при смене данных, а расходы на vector database бывают от пятой части до половины расходов на model API.
RAG не только для текста
Заголовок раздела «RAG не только для текста»- Multimodal RAG. Retriever ищет и картинки: по метаданным (подписи, теги) или по содержимому. Для второго нужна multimodal embedding model, например
CLIP. - Табличные данные (text-to-SQL). Вопрос: «Сколько единиц товара продано за 7 дней?» Модель по схеме пишет SQL, система выполняет его, модель формулирует ответ. Если схемы не влезают в контекст, нужен шаг выбора таблиц.
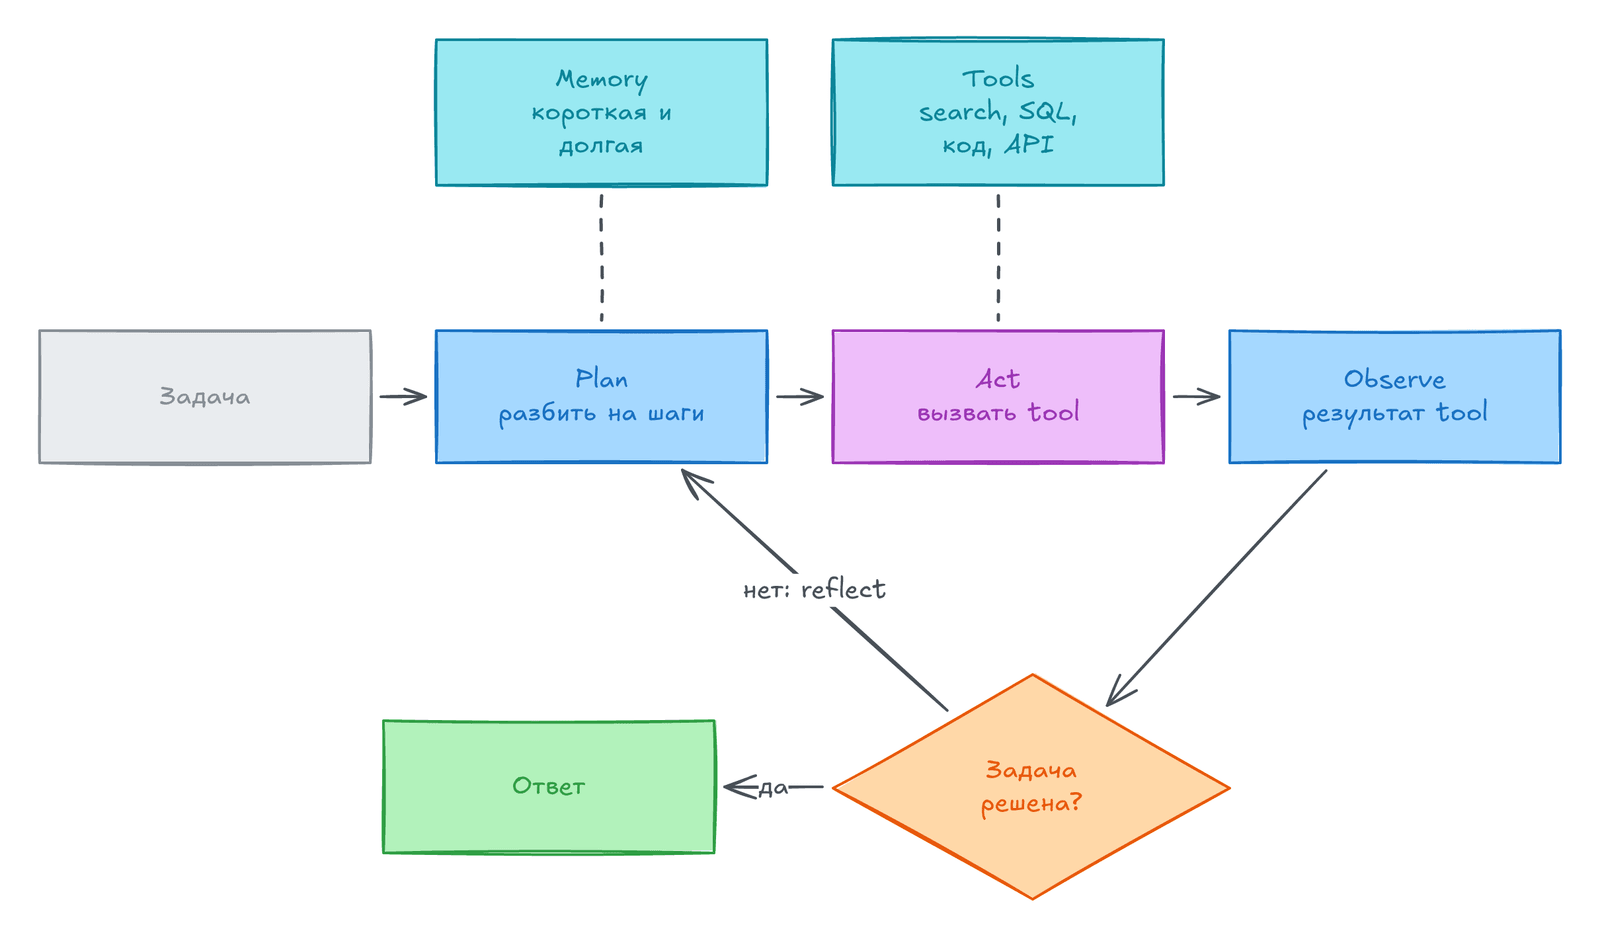
Агент (agent) воспринимает среду (environment) и действует в ней. Его определяют среда и набор действий. Действия расширяют tools. RAG с text-to-SQL уже простой агент: «сгенерировать SQL», «выполнить SQL», «ответить».
Агентам нужны более сильные модели. Ошибки накапливаются: при точности 95% на шаг после 10 шагов остаётся около 60%, после 100 шагов около 0,6%. Ставки тоже выше: агент может менять данные.
| Тип | Что делает | Примеры |
|---|---|---|
| Knowledge augmentation | Даёт контекст | Text/image retriever, SQL executor, inventory API, Slack, почта, web browsing |
| Capability extension | Закрывает слабости модели | Калькулятор, календарь, конвертер единиц, переводчик, code interpreter, OCR |
| Write actions | Меняют данные | Изменить таблицу, отправить письмо, сделать платёж |
- Модель плохо считает. Калькулятор дешевле, чем учить модель арифметике.
Code interpreterделает агента аналитиком, но несёт риск code injection.- Web browsing не даёт модели устареть, но открывает путь для плохого контента.
- Агент с 13 инструментами (Chameleon) обошёл GPT-4 без инструментов на нескольких бенчмарках.
Write actionsсамые опасные. Не давайте ненадёжной модели права, которых не дали бы стажёру, например удалять production-базу. Нужны защита и подтверждение человеком.
Planning
Заголовок раздела «Planning»План (plan) это шаги для достижения цели при заданных ограничениях. Этапы: plan generation (task decomposition), reflection на план, execution, reflection на результат. Если цель не достигнута, строят новый план.
- Отделяйте план от выполнения. Иначе агент может часами выполнять бессмысленный план за ваши деньги. План проверяют эвристиками (нет такого инструмента, слишком много шагов) или AI judge.
- Intent classifier определяет, чего хочет пользователь. Он помогает выбрать инструменты и отсечь запросы вне задач агента (
IRRELEVANT). - Человек может проверять или выполнять часть плана. Рискованные действия лучше подтверждать.
- Умеет ли LLM планировать? Спор открыт. Автор считает, что LLM может быть частью планировщика.
Function calling. Многие API поддерживают вызов инструментов:
- Описываете инструменты: имя, параметры, документация.
- Для запроса выбираете режим:
required,noneилиauto. - Модель возвращает имя функции и аргументы. Вы вызываете её сами.
Проверяйте значения параметров: модель может угадать их неверно.
Granularity. Детальный план сложно составить, но легко выполнить. Общий план наоборот. Выход: hierarchical planning. План на естественном языке («получить дату») не ломается при переименовании tool, но нужен переводчик в команды.
Control flow. Бывает sequential, parallel, if и for loop. У агента их определяет модель. Параллельность снижает latency. Проверьте, что framework её поддерживает.
Reflection. ReAct чередует Thought, Act, Observation до конца задачи. Reflexion добавляет evaluator и самоанализ: после неудачи агент объясняет причину и строит новый план. Reflection легко внедрить и она помогает, но стоит токенов и времени.
Tool selection. Больше инструментов дают больше возможностей, но агенту сложнее выбирать, а описания занимают контекст. Что делать:
- делайте
ablation: уберите tool. Если качество не упало, tool не нужен; - ищите tools, на которых агент часто ошибается, и упрощайте их;
- смотрите частоту вызовов. Частые пары можно слить в один tool.
Failure modes и оценка агента
Заголовок раздела «Failure modes и оценка агента»| Тип сбоя | Пример |
|---|---|
| Invalid tool | План вызывает bing_search, которого нет |
| Valid tool, invalid parameters | lbs_to_kg(a, b), а параметр один |
| Valid tool, wrong values | Вместо 120 передано 100 |
| Goal failure | План не решает задачу или нарушает бюджет |
| Reflection error | Агент решил, что закончил, хотя нет (расселил 40 из 50 человек) |
| Tool failure | Инструмент верный, но выдал плохой результат (неверный SQL) |
| Inefficiency | Верный результат, но слишком много шагов и денег |
Как оценивать:
- Соберите planning dataset: пары
(task, tool inventory). Для каждой задачи получите K планов. - Считайте долю валидных планов и вызовов, число попыток до валидного плана, частоту каждого типа ошибок.
- Тестируйте каждый tool отдельно. Логируйте все вызовы и их вывод.
- Меряйте число шагов, цену и время действий. Сравнивайте с человеком: что дёшево ему, может быть дорого для AI.
Memory это механизмы, которыми модель хранит и использует информацию. Они нужны RAG и агентам, потому что информации больше, чем контекст.
| Вид | Что это | Когда использовать |
|---|---|---|
| Internal knowledge | Знания в весах модели. Меняются только при обновлении модели | Информация, нужная почти всем запросам. Закладывают через training или finetuning |
| Short-term memory | Контекст модели. Быстрый, но ограниченный. Не живёт между задачами | Данные текущей задачи |
| Long-term memory | Внешнее хранилище, как в RAG. Живёт между задачами. Данные можно удалить без смены модели | Редкие данные |
Memory помогает не терять данные при переполнении контекста, помнить пользователя между сессиями и хранить структуру. Две функции: memory management (что хранить и удалять) и memory retrieval (достать нужное из long-term, как в RAG).
Стратегии для short-term:
FIFO: удалять самое старое. Просто, но начало диалога иногда самое важное.Summary: сжать диалог в краткое резюме, следить за именованными сущностями.Reflection: после каждого действия модель решает, добавить информацию, слить или заменить устаревшую.- При конфликте данных: оставить новое или спросить модель. Зависит от задачи.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- MCP (Model Context Protocol). Открытый протокол от Anthropic (ноябрь 2024). Стал стандартом для подключения tools и данных к моделям. Его поддерживают OpenAI, Google, Microsoft. Есть MCP-серверы для баз данных, BI и облаков.
- Agentic search вместо классического RAG. Coding agents часто ищут без vector store: grep, чтение файлов, SQL. Агент сам решает, что найти. Vector RAG остаётся для больших коллекций текста.
- Агенты в продакшене. Есть SDK для агентов у OpenAI, Anthropic, Google. Агенты работают в браузере и на компьютере (computer use).
- Память агентов стала функцией продукта. Долгая память есть в ChatGPT, Claude, coding agents. Идеи из главы (короткая и долгая память) это и описывают.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| RAG | Достать данные из внешнего хранилища и дать их модели как контекст |
| Retriever / generator | Часть, что ищет данные / часть, что пишет ответ |
| Chunking | Разбиение документов на куски для индекса |
| Vector database | Хранилище векторов с быстрым поиском ближайших |
| BM25 | Term-based алгоритм ранжирования. Сильная база для сравнения |
| Hybrid search | Term-based и embedding-based вместе |
| Reranking | Повторная сортировка кандидатов точным методом |
| Query rewriting | Переписывание запроса, чтобы он был понятен без диалога |
| Context precision / recall | Доля релевантных среди найденных / доля найденных среди релевантных |
| Agent | Система, что воспринимает среду и действует через tools |
| Function calling | Вызов инструментов моделью через API |
| Memory | Internal knowledge, short-term (контекст) и long-term (внешнее хранилище) |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Retrieval это data pipeline. Индексация: загрузка, очистка, chunking, embeddings, запись в index. Нужны расписание, версии, алерты и lineage, как в любом пайплайне.
- Инкрементальные обновления. Пересчёт embeddings стоит денег. Обновляйте только изменённые chunks, как
incrementalмодель вdbt. При смене embedding model или tokenizer нужна полная переиндексация. - Свой evaluation set. Запросы, документы и метки релевантности хранят как таблицы в warehouse. Версионируйте их. Считайте precision и recall по расписанию.
- Не начинайте с vector database. Сначала BM25 или полнотекстовый поиск как база. Потом hybrid. Векторы в PostgreSQL или warehouse могут хватить.
- Text-to-SQL опирается на ваш слой данных. Чистые имена колонок, описания в
dbtdocs, понятные grain и метрики делают модель точнее. Давайте ей отдельный read-only доступ к витринам, а не к сырым таблицам. - Write actions под контролем. Права только на нужные таблицы, подтверждение человека, лог каждого вызова.
- Стоимость агента. Считайте шаги, токены и время на задачу. Складывайте их в таблицу логов, как метрики пайплайна.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему RAG нужен, даже если у модели очень длинный контекст?
- Чем term-based retrieval отличается от embedding-based? Почему в production часто берут hybrid?
- Как размер chunk влияет на качество, стоимость и скорость поиска?
- Какие виды сбоев бывают у агента и как измерить каждый?
Предыдущая: Prompt engineering. Следующая: Finetuning.