

AI Engineering, глава 4: Оценка AI-систем
Главная мысль: AI-приложение без оценки опасно. Вы не знаете, помогает оно или вредит. Поэтому сначала решите, как вы будете оценивать, и только потом строите. Публичные benchmarks помогают отсеять плохие модели. Лучшую модель для вашей задачи найдёт только ваш собственный evaluation pipeline.
Evaluation-driven development
Заголовок раздела «Evaluation-driven development»Автор сравнивает идею с test-driven development. Сначала критерии оценки. Потом приложение.
- Приложение, которое работает, но его качество никто не знает, хуже, чем приложение, которое не запустили. Его дорого поддерживать и ещё дороже выключать.
- В production чаще живут задачи с ясной метрикой: рекомендации, fraud detection, генерация кода (код проходит тесты), классификация.
- Минус: можно искать только там, где легко мерить, и пропустить хорошие идеи.
- Автор считает: оценка это главное узкое место внедрения AI.
Критерии оценки
Заголовок раздела «Критерии оценки»Критерии делят на четыре категории.
| Категория | Вопрос | Как обычно проверяют |
|---|---|---|
| Domain-specific capability | Умеет ли модель то, что нужно (код, SQL, право, язык)? | Exact evaluation, functional correctness, benchmarks |
| Generation capability | Ответ верный, безопасный, связный? | AI judge, классификаторы, сверка с источником |
| Instruction-following | Модель делает то, что просили, и в нужном формате? | Автопроверки формата, чек-листы да/нет |
| Cost and latency | Быстро ли и сколько стоит? | Метрики latency, цена за токен |
Domain-specific capability
Заголовок раздела «Domain-specific capability»- Модель умеет только то, чему научилась. Если языка не было в training data, задачу он не решит.
- Код проверяют по
functional correctness: запрос выполнился, результат верный. - Корректности мало. Для SQL-ассистента важны ещё время выполнения и память. Запрос может быть верным, но читать всю таблицу.
- Для не-кода часто берут multiple choice (MCQ). Их просто проверить. Но результат зависит от мелочей формулировки. И MCQ проверяют умение выбрать, а не написать. Для summarization и перевода они слабы.
Generation capability
Заголовок раздела «Generation capability»Старые метрики NLG (fluency, coherence) сегодня менее важны, ведь тексты моделей почти как человеческие. Нужны новые, прежде всего две.
Factual consistency. Ответ не должен выдумывать факты (hallucination).
| Вид | С чем сравниваем | Примеры задач |
|---|---|---|
| Local | С данным контекстом | Summary документа, бот по политикам компании, выводы из данных |
| Global | С общими знаниями | Общий чат-бот, fact-checking |
- Простой способ: AI judge получает документ и ответ и говорит, есть ли противоречие.
SelfCheckGPT: модель отвечает несколько раз. Если ответы расходятся, исходный ответ, вероятно, выдуман. Дорого.SAFE: ответ делят на отдельные утверждения, каждое проверяют через поиск.Textual entailment(NLI): для пары (контекст, утверждение) выбирают одно из трёх: следует, противоречит, нейтрально. Для этого есть маленькие специальные модели.- Совет: изучите, на каких запросах модель врёт чаще. Обычно это редкие темы и вопросы о том, чего не было. Усиливайте benchmark такими запросами.
- Для RAG это ключевой критерий: ответ должен следовать найденному контексту.
Safety. Вред бывает разный: грубая речь, опасные советы, hate speech, насилие, стереотипы, политический перекос.
- Общие AI judge ловят многое. Специальные классификаторы токсичности меньше, быстрее и дешевле.
- Benchmarks:
RealToxicityPrompts,BOLD.
Instruction-following
Заголовок раздела «Instruction-following»- Если модель плохо следует инструкциям, лучший prompt не поможет.
- Пример: классификатор должен вернуть
NEGATIVE,POSITIVEилиNEUTRAL, а модель пишетANGRY. Тональность она понимает, но инструкцию не соблюдает. - Особенно важно для structured output (JSON, regex). Ответ “Это верно” сломает следующий шаг пайплайна.
- Трудно отделить от domain capability. Модель не умеет задачу или не поняла просьбу? Причиной может быть и плохой prompt.
IFEvalпроверяет 25 типов инструкций, которые легко проверить кодом: ключевые слова, длина, число пунктов, JSON.INFOBenchдобавляет стиль, тон, ограничения по теме. Для каждой инструкции пишут список вопросов да/нет. Их проверяет человек или AI judge. Оценка равна доле выполненных критериев.- Совет: стройте свой набор инструкций. Если нужен YAML, проверяйте YAML.
Cost and latency
Заголовок раздела «Cost and latency»- Нужен баланс качества, скорости и цены. Часто берут модель хуже, но дешевле и быстрее.
- Сначала разделите требования на must-have и nice-to-have. Пользователи всегда хотят быстрее, но высокая latency часто лишь раздражает.
- Метрики latency:
time to first token,time per token,time per query. Обычно смотрят P90. - API берёт плату за токены, цена почти не зависит от объёма. У self-hosting стоимость кластера фиксирована, при большом объёме цена за токен падает.
- Полезно вести таблицу: критерий, метрика, жёсткий порог, идеальное значение.
Выбор модели
Заголовок раздела «Выбор модели»Workflow выбора
Заголовок раздела «Workflow выбора»- Hard attributes: нельзя или не хотите менять. Лицензия, размер, политика данных, контроль.
- Soft attributes: можно улучшить. Точность, токсичность, factual consistency.
- Одно и то же свойство может быть разным. Latency у чужого API это hard. У своей модели это soft.
- Улучшения трудно оценить заранее. Точность выросла с 20% до 70% после разбивки задачи на два шага. Но бывает, что модель не удаётся спасти за недели.
Четыре шага, они повторяются по кругу: (1) отфильтровать модели по hard attributes; (2) выбрать кандидатов по публичным benchmarks; (3) прогнать их через свой evaluation pipeline; (4) мониторить в production и собирать feedback (глава 10). Ранний выбор может измениться: хотели open source, он не дотянул, идёте к API.
Build vs buy: open source или API
Заголовок раздела «Build vs buy: open source или API»Open weight: веса опубликованы, данных обучения нет. Так большинство “open source” моделей.Open model: опубликованы и данные.- Проверьте лицензию: разрешено ли коммерческое использование, есть ли лимиты (у Llama 700M MAU), можно ли обучать другие модели на выходе (distillation).
Семь осей для решения:
| Ось | Model API | Self-hosting |
|---|---|---|
| Data privacy | Данные уходят к провайдеру. Политика может измениться | Данные остаются у вас |
| Data lineage и copyright | Контракт может защитить от рисков | Меньше проверок происхождения данных, риск на вас |
| Performance | Самая сильная модель чаще закрытая | Лучшие open модели обычно чуть слабее |
| Functionality | Есть scaling, function calling, structured output. Часто нет logprobs | Есть logprobs и промежуточные данные. Остальное надо строить самим |
| Cost | Платите за токены. На большом объёме дорого | Нужны люди, время, GPU |
| Control | Rate limits, правила провайдера, risk потери доступа, изменения без анонса | Можно “заморозить” модель, проверять изменения |
| On-device | Не работает без сети | Возможно, но сложно |
- Одну модель дают разные API. Качество и цена отличаются. Берите стандартный формат API, чтобы легко сменить модель.
- Закрытые модели меняются без предупреждения. Ваши prompts могут сломаться незаметно.
Публичные benchmarks и leaderboards
Заголовок раздела «Публичные benchmarks и leaderboards»Benchmarks тысячи. Для запуска нескольких сразу есть evaluation harness (например lm-evaluation-harness, больше 400 benchmarks).
- Они берут небольшой набор benchmarks. Причина: оценка стоит вычислений. Полный
HELMдля 30 моделей стоил порядка 80-100 тысяч долларов. - Наборы разные. Hugging Face и HELM пересекаются только в двух benchmarks. Сравнивать ранги нельзя.
- Корреляция важна. Если два benchmarks почти совпадают (например
MMLU,ARC-C,WinoGrande), второй мало что добавляет.TruthfulQAкоррелирует слабее: умнее не значит правдивее. - Агрегация: Hugging Face берёт среднее (все benchmarks равны). HELM берёт mean win rate (как часто модель лучше другой).
Свой leaderboard:
- Выберите benchmarks под нужные способности. Проверьте, что каждому можно верить: опубликовать benchmark может кто угодно.
- Если оценки модели нет в публичной таблице, запустите сами.
- Приведите шкалы к общему виду и задайте веса по важности.
Цель этого шага: выбрать небольшой набор моделей для проверки на своих данных. Топ leaderboard не гарантирует успех. Один и тот же апдейт модели одним приложениям вредит, другим помогает.
Data contamination
Заголовок раздела «Data contamination»Data contamination: модель видела данные оценки при обучении. Тогда она запоминает ответы, и оценка завышена.
- Чаще всего случайно: интернет-скрейпинг захватил benchmark. Бывает и из общего источника (учебники).
- Обнаружение:
n-gram overlap(совпадение цепочек, например из 13 токенов) точнее, но нужен доступ к обучающим данным.Perplexityдешевле: слишком низкая на тесте подозрительна. - Публичный benchmark отсеивает слабые модели. Лучшую для вас он не найдёт.
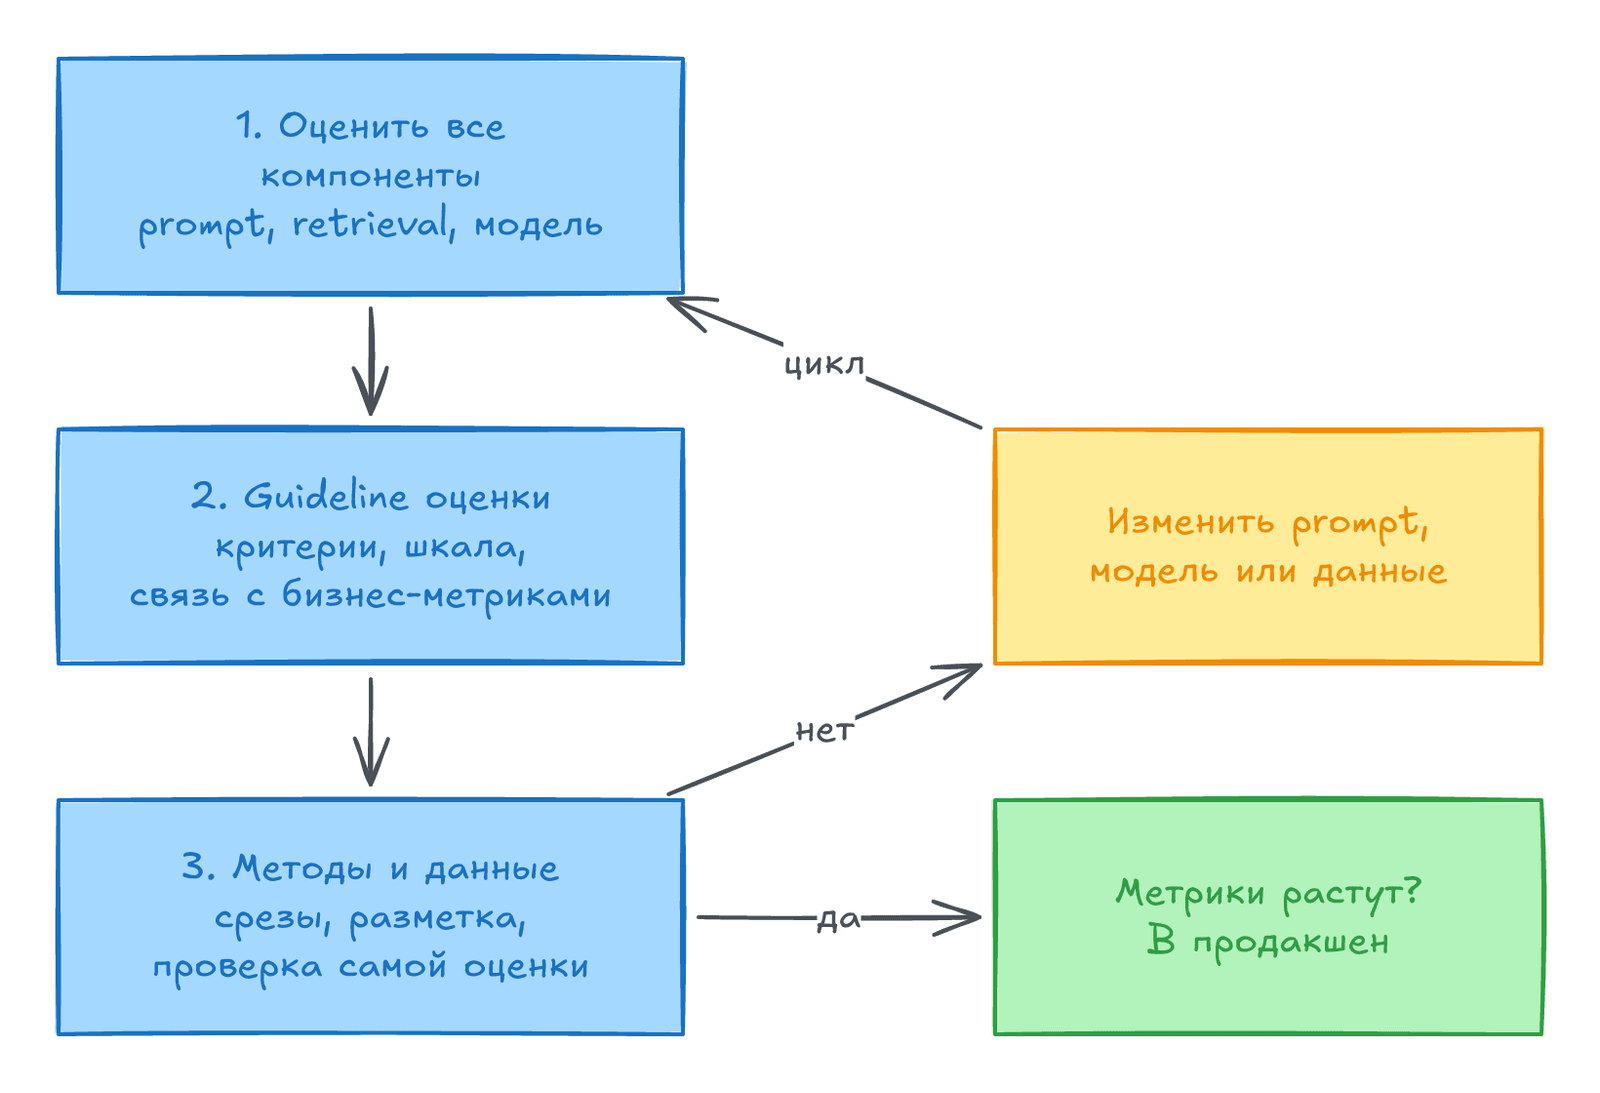
Проектирование evaluation pipeline
Заголовок раздела «Проектирование evaluation pipeline»Шаг 1. Оцените все компоненты системы
Заголовок раздела «Шаг 1. Оцените все компоненты системы»Оценивайте итог и каждый промежуточный шаг отдельно. Иначе вы не узнаете, где ломается система.
Пример: пайплайн достаёт текущего работодателя из PDF резюме.
- Шаг A: PDF в текст. Проверка: насколько текст похож на исходный.
- Шаг B: текст в имя работодателя. Проверка: accuracy на правильно извлечённом тексте.
Два уровня оценки в диалоговых системах:
- Per turn: качество каждого ответа.
- Per task: решена ли задача и за сколько ходов. Это важнее для пользователя. Решение за два хода и за двадцать это разный продукт.
Шаг 2. Создайте evaluation guideline
Заголовок раздела «Шаг 2. Создайте evaluation guideline»Самый важный шаг. Нечёткий guideline даёт нечёткие оценки.
- Опишите не только что приложение должно делать, но и что не должно. Например: бот поддержки не отвечает на вопросы о выборах. Как вы узнаёте такой запрос и как бот реагирует?
- “Верно” не значит “хорошо”. Ответ “вы нам не подходите” может быть правдой, но бесполезен. Хороший ответ объясняет разрыв и что делать.
- Определите критерии. Пример для бота поддержки: relevance, factual consistency, safety. По опросу LangChain, команды используют в среднем 2.3 критерия.
- Выберите шкалу: 0/1, 1-5, 0-1 или
-1/0/1(противоречит, нейтрально, следует). - Напишите rubric с примерами для каждой оценки. Дайте её людям. Если им трудно следовать, уточните. Эта rubric потом пригодится для разметки training data.
Связь с бизнес-метриками. Метрика модели сама по себе мало говорит. Свяжите её с эффектом.
Идея: factual consistency 80% значит, что можно автоматизировать около 30% запросов. При 90% это около 50%. При 98% около 90%. Цифры условные, пример из книги.
- Определите
usefulness threshold: минимум, ниже которого приложение бесполезно. - Погоня за engagement-метриками (DAU, число диалогов) может сделать продукт навязчивым.
Шаг 3. Определите методы и данные
Заголовок раздела «Шаг 3. Определите методы и данные»Методы.
- Разным критериям нужны разные методы: classifier для токсичности, semantic similarity для relevance, AI judge для factual consistency.
- Методы можно комбинировать. Дешёвый classifier на 100% данных. Дорогой AI judge на 1%.
- Используйте logprobs, если есть. Они показывают уверенность модели.
- Автоматические метрики по максимуму. Но и ручная оценка нужна, в том числе в production. LinkedIn вручную смотрит до 500 диалогов в день.
Данные.
- Нужны размеченные примеры для каждого компонента и критерия. Берите реальные production данные. Метки: естественные, от людей или от AI.
- Делайте
slicing: разбейте данные на подмножества и смотрите результат по каждому. Это нужно, чтобы найти bias, отладить сбои и увидеть, что улучшать. Simpson's paradox: модель A может быть лучше B в каждой группе, но хуже в сумме. Общая цифра обманывает.- Держите несколько evaluation sets: распределение production, известные ошибки системы, типичные ошибки пользователей (опечатки), запросы вне области (out-of-scope).
Сколько данных.
-
Проверка размера: сделайте несколько
bootstrapвыборок из вашего набора (с возвратом). Если результаты сильно скачут (70% и 90%), набор мал. -
Чтобы доказать, что новая версия лучше, нужно тем больше примеров, чем меньше разница. Правило OpenAI: разница в 3 раза меньше требует выборку в 10 раз больше.
-
Оценка OpenAI для 95% confidence: разница 30% нужно около 10 примеров, 10% около 100, 3% около 1 000, 1% около 10 000.
Оцените сам pipeline
Заголовок раздела «Оцените сам pipeline»- Даёт ли он правильные сигналы? Лучшие ответы получают лучшие оценки? Лучшие метрики дают лучший бизнес-результат?
- Надёжен ли он? Два запуска дают одинаковый результат? Для AI judge ставьте
temperature = 0и держите конфигурацию постоянной. - Коррелируют ли метрики? Идеальная корреляция значит, что одна метрика лишняя. Нулевая значит либо находка, либо недоверие к метрикам.
- Сколько стоит evaluation (cost и latency)? Пропускать оценку ради скорости рискованно.
Iterate. Критерии будут меняться. Но не слишком часто, иначе результаты нельзя сравнивать во времени. Логируйте всё, что влияет на оценку: данные, rubric, prompt и настройки AI judge.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Старые benchmarks насыщены. MMLU и подобные почти не различают топовые модели. Сейчас смотрят на SWE-bench Verified (код), GPQA Diamond (наука), Humanity’s Last Exam, ARC-AGI-2, τ-bench и Terminal-Bench (агенты).
- Open-weight модели догнали. DeepSeek, Qwen, gpt-oss близки к закрытым моделям. Выбор «API или self-hosting» стал реальным для многих задач.
- Цены за токен сильно упали. Цифры стоимости из книги устарели. Но reasoning модели тратят больше токенов на ответ. Считайте цену на задачу, а не на токен.
- Evaluation-driven development подтвердился. Это главный совет книги, и в 2026 году он работает ещё лучше.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Evaluation-driven development | Сначала критерии оценки, потом разработка |
| Domain-specific capability | Умение модели в вашей области (код, SQL, язык) |
| Factual consistency | Ответ не противоречит контексту или фактам |
| Textual entailment (NLI) | Следует ли утверждение из контекста: следует, противоречит, нейтрально |
| Hard / soft attributes | Что нельзя менять / что можно улучшить |
| Open weight | Веса открыты, данные обучения нет |
| Leaderboard | Рейтинг моделей по набору benchmarks |
| Data contamination | Данные оценки попали в обучение модели |
| Evaluation guideline / rubric | Критерии и шкала оценки с примерами |
| Slicing | Оценка по подмножествам данных |
| Simpson’s paradox | Общий итог противоположен итогам по группам |
| Bootstrap | Повторные выборки с возвратом для проверки стабильности оценки |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Evaluation set это таблица. Храните в warehouse: запрос, ожидаемый ответ, метки, срезы, версия rubric. Версионируйте как любой датасет.
- Берите примеры из production логов. Это самые честные данные. Следите за PII и политикой хранения.
- Считайте метрики по срезам. Это обычный
GROUP BYпо тарифу, каналу, длине запроса, теме. Одна общая цифра может скрыть провал в одном срезе. - Оценивайте компоненты отдельно. Для RAG отдельно смотрите retrieval и генерацию. Для text-to-SQL отдельно смотрите корректность и стоимость запроса в вашем warehouse.
- Логируйте каждый прогон. Версия модели, prompt, данных, rubric, настройки judge. Без этого результаты нельзя сравнить, как без версии
dbtмодели. - Считайте стоимость оценки. AI judge на всех данных может стоить больше самого приложения. Комбинируйте дешёвые проверки на всём и дорогие на выборке.
- Не верьте одному benchmark. Используйте публичные только для отбора кандидатов. Решение принимайте на своих данных.
- Проверяйте размер выборки. Маленький набор даёт шумные метрики. Решение “новый prompt лучше” на 50 примерах ничего не доказывает.
- Закладывайте смену модели. Закрытая модель меняется без анонса. Запускайте регрессионный набор после каждого обновления.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие четыре категории критериев предлагает автор? Приведите пример каждой для SQL-ассистента.
- Чем local factual consistency отличается от global? Как её проверить в RAG-системе?
- По каким осям сравнивают model API и self-hosting? Что из этого hard, а что soft attribute?
- Что такое data contamination и почему лучшая модель в leaderboard может не подойти вашей задаче?
Предыдущая: Основы оценки моделей. Следующая: Prompt engineering.