

AI Engineering, глава 3: Методы оценки
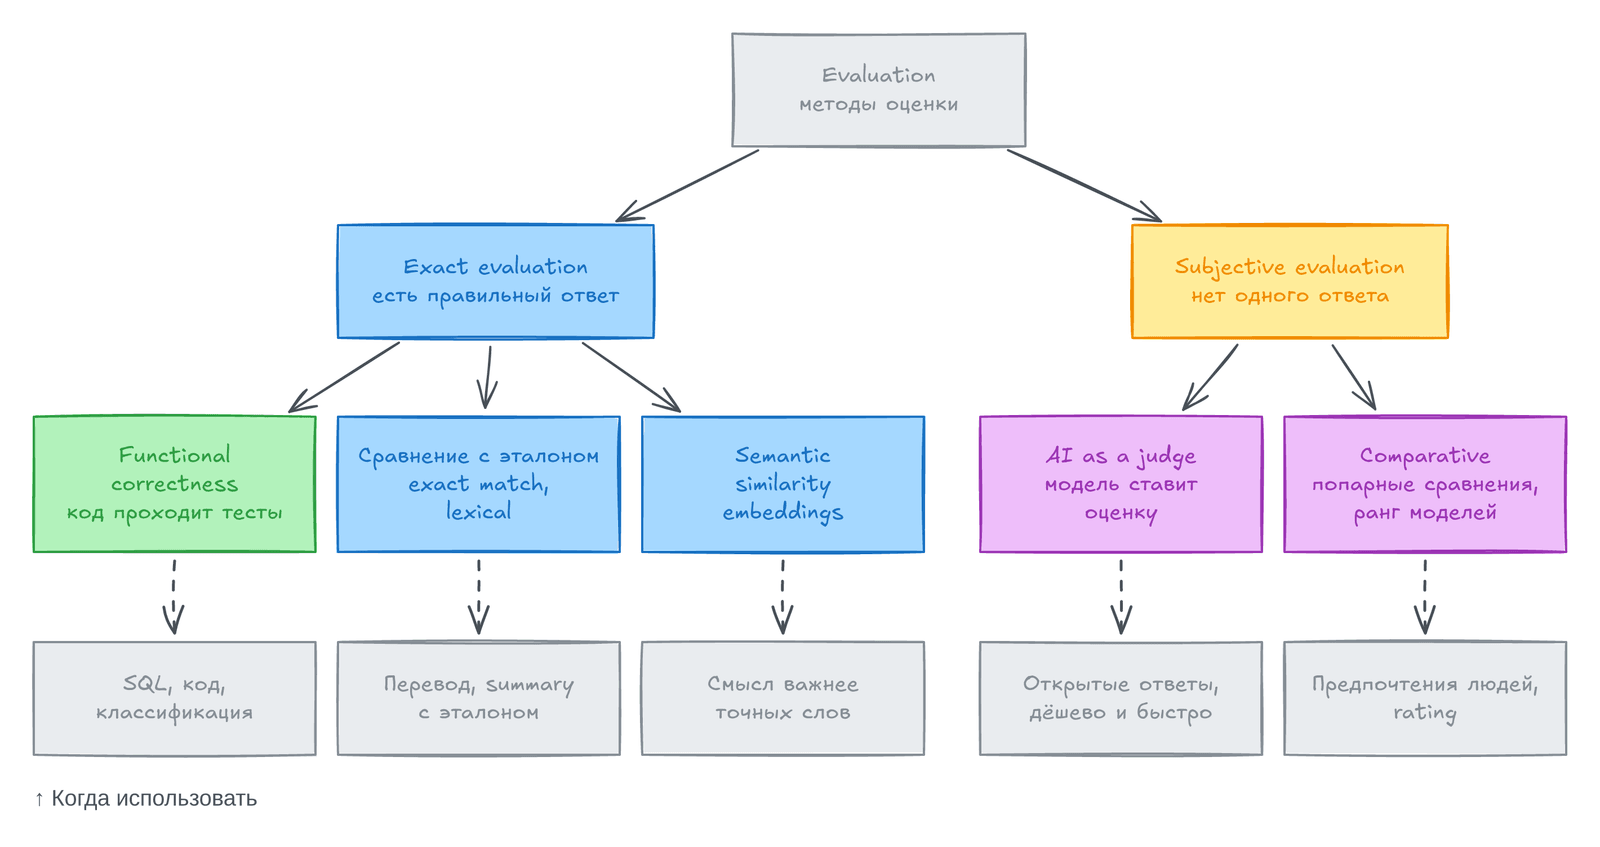
Главная мысль: Оценка foundation model сложнее, чем оценка обычной ML-модели, потому что ответы открытые. Есть два типа методов. Exact evaluation даёт однозначный результат. Subjective evaluation зависит от судьи. Хорошая оценка использует оба типа.
Автор называет оценку главным препятствием при создании AI-приложений. Ошибки AI уже стоили денег: чат-бот авиакомпании дал пассажиру неверную информацию, и компанию обязали выплатить компенсацию. Без контроля качества риски могут быть больше пользы.
Оценку нельзя смотреть отдельно от системы. Сначала найдите, где система может сломаться. Потом направьте оценку туда. Метрики без этого знания не помогут.
Почему оценивать foundation model трудно
Заголовок раздела «Почему оценивать foundation model трудно»| Причина | Что это значит |
|---|---|
| Модели умнее | Ошибку первоклассника видит каждый. Ошибку в сложном рассуждении видят единицы. Связная, но неверная сводка выглядит хорошо |
| Ответ открытый | Для одного вопроса есть много верных ответов. Полный список эталонов составить нельзя |
| Модель как black box | Часто нет данных об архитектуре и обучении. Остаётся смотреть только на ответы |
| Benchmarks устаревают | Benchmark насыщается (saturated), когда модели набирают почти максимум. GLUE (2018) насытился за год, и появился SuperGLUE. MMLU заменяет MMLU-Pro |
| Широкая область | Для универсальной модели нужно ещё искать задачи, которые она вдруг умеет решать |
Инвестиций в оценку мало. Инструментов для оценки меньше, чем для обучения и оркестрации. Многие команды смотрят на ответы глазами и держат несколько случайных промптов. Для старта это сойдёт. Для развития приложения это не работает.
Метрики языковой модели
Заголовок раздела «Метрики языковой модели»Многие foundation models выросли из language models. Качество языковой части обычно связано с качеством на реальных задачах. Поэтому полезно знать четыре близкие метрики. Если знаешь одну, можно посчитать остальные.
| Метрика | Что измеряет |
|---|---|
entropy | Сколько информации в среднем несёт один токен. Чем выше, тем труднее предсказать следующий токен |
cross entropy | Насколько модели трудно предсказывать следующий токен в этом датасете |
perplexity | Экспонента от cross entropy. Грубо: между сколькими вариантами токена модель «колеблется» |
BPC / BPB | Cross entropy на символ / на байт. Нужны, чтобы сравнивать модели с разной токенизацией |
Как это связано
Заголовок раздела «Как это связано»- Пример с языком из 4 токенов (верх-лево, верх-право, низ-лево, низ-право). Нужно 2 бита на токен. Entropy равна 2.
- Cross entropy модели зависит от двух вещей: насколько предсказуемы сами данные и насколько выученное распределение отличается от настоящего.
- Если cross entropy равна 2 бита, perplexity равна
2^2 = 4. Модель выбирает как бы из 4 равных вариантов. - Frameworks (PyTorch, TensorFlow) считают в
nat(натуральный логарифм), а не в битах. ТогдаPPL = e^H. Из-за путаницы бит и nat часто публикуют именно perplexity. - Токены у моделей разные, поэтому «бит на токен» сравнивать нельзя. Если токен в среднем 2 символа и модель тратит 4 бита на токен, то BPC равна 2. BPB делает сравнение ещё честнее: оно не зависит от кодировки символов.
Как считать perplexity
Заголовок раздела «Как считать perplexity»Нужны вероятности (logprobs) каждого следующего токена. Не все коммерческие API их отдают. Мини-пример: модель дала четырём токенам вероятности 0.5, 0.25, 0.5, 0.125.
-
Биты на токен:
log2от обратной величины, то есть 1, 2, 1, 3. Среднее:7 / 4 = 1.75. -
Perplexity:
2^1.75 ≈ 3.36. -
Структурные данные (HTML) дают меньшую perplexity. Больше словарь и короче контекст дают большую.
Для чего ещё нужна perplexity:
- Оценка силы модели. Большие модели в отчёте GPT-2 стабильно показывали меньшую perplexity.
- Поиск data contamination. Низкая perplexity на тексте benchmark говорит, что модель, вероятно, видела его при обучении. Тогда результату на benchmark меньше веры.
- Дедупликация. Новые данные добавляют, только если их perplexity высокая. Значит, модель их ещё не знает.
- Поиск аномалий. Нелепый текст («кошка дом глаз идти») имеет высокую perplexity.
Предупреждение: после SFT и RLHF perplexity обычно растёт. Модель лучше решает задачи, но хуже предсказывает токены. Quantization тоже может менять perplexity неожиданно. Для post-trained моделей эта метрика плохо подходит.
Exact evaluation
Заголовок раздела «Exact evaluation»Exact evaluation даёт однозначный вердикт. Раздел про открытую генерацию, а не про классификацию.
Functional correctness
Заголовок раздела «Functional correctness»Проверяем, делает ли система то, что должна. Это самая важная метрика приложения. Но автоматизировать её удаётся не всегда.
- Генерация кода. Запускаем код на тестах. Так работают HumanEval и MBPP.
- Text-to-SQL. Запускаем сгенерированный запрос и сравниваем результат с ожидаемым. Так устроены Spider, BIRD-SQL, WikiSQL.
- Задачи с измеримой целью. Бот для игры или планировщик нагрузки: смотрим на счёт или экономию энергии.
Метрика pass@k: для каждой задачи модель делает k решений. Задача решена, если хотя бы одно проходит все тесты. Метрика равна доле решённых задач. Пример: 10 задач, 5 решены при k = 3, значит pass@3 = 50%. Чем больше k, тем выше метрика.
Сравнение с эталоном (reference-based)
Заголовок раздела «Сравнение с эталоном (reference-based)»Если проверить функцию нельзя, сравниваем ответ с эталоном. Данные имеют вид (вход, эталонные ответы). Эталоны пишут люди или AI. Человек потом проверяет их. Проверять дешевле, чем писать с нуля.
| Метод | Как работает | Когда подходит | Слабое место |
|---|---|---|---|
| Exact match | Ответ совпадает с одним из эталонов. Результат 0 или 1 | Короткие точные ответы: факт, число, выбор из списка | На длинных ответах почти не работает. Вариант «ответ содержит эталон» может принять неверное |
| Lexical similarity | Считает пересечение слов, n-gram или edit distance (вставка, удаление, замена). Метрики: BLEU, ROUGE, METEOR++, TER, CIDEr | Перевод, подписи к картинкам | Нужен широкий набор эталонов. Хороший ответ получит низкий балл, если похожего эталона нет |
| Semantic similarity | Текст превращают в embedding, потом считают cosine similarity. Метрики: BERTScore, MoverScore | Свободный текст, где важен смысл | Зависит от качества embedding. Дороже по расчёту |
Примеры слабых мест:
- Exact match: вопрос «В каком году вышел релиз 2.0?». Ответ «в марте 2019, а релиз 2.0 был в 2021» содержит верный год, но неверен по смыслу.
- Lexical similarity: «Таблицу можно удалить» и «Таблицу нельзя удалить» почти совпадают по словам, но смысл противоположный. И наоборот, «как дела» и «что нового» не имеют общих слов.
- На HumanEval у верных и неверных решений BLEU был похожий. Значит, оптимизировать BLEU не то же самое, что оптимизировать правильность.
- Сами эталоны бывают плохими. Организаторы WMT 2023 нашли много плохих эталонных переводов.
Embeddings в двух словах
Заголовок раздела «Embeddings в двух словах»Embedding — это вектор чисел, который передаёт смысл данных. Обычно длина от 100 до 10 000. Для близких по смыслу текстов векторы ближе. Cosine similarity равна 1 для одинаковых и -1 для противоположных векторов.
AI as a judge
Заголовок раздела «AI as a judge»AI as a judge (LLM-as-a-judge): одна модель оценивает ответ другой. Идея старая, но стала практичной около 2020 года, после GPT-3. Это один из самых частых методов оценки в production. В отчёте LangChain за 2023 год 58% оценок на платформе делали AI judges.
Почему это популярно:
- Быстро, просто и дешевле людей. Не нужен эталон. Судья может объяснить решение.
- Критерии любые: правильность, токсичность, повторы, галлюцинации, роль персонажа.
- На MT-Bench GPT-4 совпадал с людьми в 85% случаев. Люди между собой совпадали в 81%.
Как строить судью.
Три базовых вида промпта:
- Оценить один ответ по вопросу (например, балл от 1 до 5).
- Сравнить ответ с эталоном: совпадает или нет.
- Сравнить два ответа: какой лучше, A или B.
Что должно быть в промпте судьи:
- Задача: что оценивать.
- Критерии: чем детальнее, тем лучше.
- Шкала: класс (хорошо/плохо), дискретные числа (1-5) или непрерывные (0-1).
- Примеры ответов с разными баллами и причины.
Советы из практики: классы лучше чисел, узкая шкала (1-5) лучше широкой, примеры в промпте повышают качество.
Судья — это система: модель + промпт + параметры sampling. Меняете любую часть, получаете другого судью.
Ограничения:
| Проблема | В чём суть |
|---|---|
| Непоследовательность | Судья вероятностный. Один и тот же вход может дать разные баллы. Примеры в промпте подняли согласованность GPT-4 с 65% до 77.5%. Но стабильность не равна точности: судья может стабильно ошибаться. Больше примеров дороже: в опыте выход вырос в 4 раза |
| Нестандартные критерии | Faithfulness в MLflow (шкала 1-5), Ragas (0 или 1) и LlamaIndex (YES/NO) измеряется по-разному. Баллы нельзя сравнивать |
| Дрейф судьи | Если в этом месяце изменили промпт судьи, рост с 90% до 92% ничего не доказывает |
| Цена и latency | Если генерирует и судит GPT-4, счёт примерно удваивается. Три критерия дают 4 вызова вместо 1. Если судить до показа ответа, растёт latency |
| Смещения (bias) | Смотрите ниже |
| Приватность | С проприетарным судьёй вы отправляете данные вовне |
Совет автора: не доверяйте судье, если не видите его модель и промпт.
Как снизить цену: слабая модель как судья, или проверка только части ответов (sampling). Чем больше доля проверки, тем выше доверие и тем выше цена.
Смещения судей:
Self-bias: модель любит свои ответы. GPT-4 выигрывал у себя на 10% чаще, Claude-v1 на 25%.Position bias: чаще выбирается первый ответ. Лечится повтором теста с другим порядком. У людей наоборот: чаще выбирают последний (recency bias).Verbosity bias: длинный ответ нравится больше, даже с ошибками. У сильных моделей смещение слабее.
Какую модель брать в судьи
Заголовок раздела «Какую модель брать в судьи»- Сильнее оцениваемой. Логично, но у самой сильной модели судьи нет. Часто сильная модель проверяет малую долю ответов, а дешёвая генерирует.
- Такая же. Self-evaluation полезна. Если модель сомневается в своём ответе, он, вероятно, неверный. Критика помогает улучшить ответ.
- Слабее. Открытый вопрос. Лучше работают сильные судьи. Маленькие специализированные судьи на узком критерии могут быть надёжнее большого универсала.
Три вида специализированных судей:
| Вид | Вход | Выход |
|---|---|---|
| Reward model | prompt + ответ | Оценка качества (Cappy: 0..1, 360 млн параметров) |
| Reference-based judge | ответ + эталон | Сходство или качество (BLEURT, Prometheus) |
| Preference model | prompt + 2 ответа | Какой лучше (PandaLM, JudgeLM) |
Вывод автора: AI judge нужно дополнять exact-методами и оценкой человека.
Comparative evaluation
Заголовок раздела «Comparative evaluation»Часто нужен не балл, а рейтинг моделей: какая лучше для вас. Есть два пути.
| Подход | Как работает |
|---|---|
| Pointwise | Оцениваем каждую модель отдельно по баллам, затем сортируем |
| Comparative | Модели сравнивают друг с другом. Рейтинг строят из результатов сравнений |
Для субъективных ответов сравнить два ответа проще, чем поставить балл каждому. Так работает Chatbot Arena (LMSYS): пользователь видит два анонимных ответа и голосует.
Как строят рейтинг
Заголовок раздела «Как строят рейтинг»- Каждое сравнение называется
match. Судья выбирает победителя (допустимы ничьи). Win rateA над B: доля матчей, где выиграл A.- Алгоритмы превращают матчи в баллы:
Elo,Bradley-Terry,TrueSkill. Идея пришла из спорта и игр. - Arena перешла с Elo на Bradley-Terry: Elo зависел от порядка оценщиков и промптов.
- Рейтинг считается верным, если модель выше по рейтингу чаще выигрывает у модели ниже. Это задача прогноза будущих матчей. Эталонного рейтинга нет.
- Comparative evaluation не равна A/B-тесту. В A/B пользователь видит одну модель. Здесь он видит несколько сразу.
Трудности
Заголовок раздела «Трудности»| Проблема | Суть |
|---|---|
| Масштаб | Число пар растёт квадратично. В январе 2024 у LMSYS было 57 моделей и 244 тыс. сравнений. Это около 153 на пару. Нужны умные алгоритмы подбора пар |
| Транзитивность | Алгоритмы предполагают: A лучше B, B лучше C, значит A лучше C. Для людей это не всегда верно |
| Новые и приватные модели | Новая модель меняет весь рейтинг. Для внутренней модели нужен свой leaderboard |
| Стандарты и качество | Кто угодно задаёт любой промпт. Люди не проверяют факты и выбирают красивые ответы. В выборке Arena было много простых промптов вроде «Hi» (0.55%). Они плохо различают модели |
| Нет контекста вашего продукта | Рейтинг не скажет, как модель будет работать в вашей RAG-системе |
| Не все вопросы про предпочтения | На вопрос о факте голосовать за вариант опасно. Это даёт неверный сигнал для обучения |
Как собирать сигнал лучше: фильтровать сложные промпты, обучать оценщиков, встроить сравнение в продукт или использовать AI-судью.
От сравнения к абсолютному качеству
Заголовок раздела «От сравнения к абсолютному качеству»Comparative evaluation говорит, какая модель лучше. Она не говорит, достаточно ли она хороша. Возможны три случая: B хорошая, а A плохая; обе плохие; обе хорошие.
Пример: модель A решает 70% обращений в поддержку. Модель B выигрывает у неё в 51% матчей. Сколько обращений решит B, непонятно. Нельзя посчитать, стоит ли B двойной цены.
Но у метода есть будущее:
- Людям проще сравнить два ответа, чем поставить балл. Метод не насыщается и его трудно обмануть.
- Он дополняет offline benchmarks и online A/B-тесты.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Chatbot Arena теперь LMArena. Проект вышел из LMSYS и стал отдельной компанией. Идея попарных сравнений осталась.
- AI as a judge стал стандартом. Почти все eval-инструменты (Braintrust, Langfuse, промышленные eval-фреймворки) дают LLM-судью из коробки. Проблемы из главы (bias, нестабильность) никуда не делись.
- Для reasoning моделей perplexity ещё менее полезна. Важнее проверка итогового ответа: тесты, точное совпадение, верифицируемая награда.
- Оценка агентов. Оценивают не один ответ, а весь путь: какие tools вызваны, сколько шагов, сколько стоило. Это тема, которой в книге почти нет.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Entropy | Средняя информация в токене. Мера непредсказуемости языка |
| Cross entropy | Насколько трудно модели предсказывать токены датасета |
| Perplexity | 2^cross entropy. Неопределённость модели при выборе следующего токена |
| BPC / BPB | Бит на символ / на байт. Сравнимы между токенизациями |
| Functional correctness | Система делает то, что нужно (тесты, исполнение) |
pass@k | Доля задач, где хотя бы одно из k решений прошло все тесты |
| Embedding | Вектор, который передаёт смысл данных |
| AI as a judge | Модель оценивает ответы другой модели |
| Self-bias / position bias / verbosity bias | Смещения судьи: к своим ответам, к первому, к длинному |
| Win rate | Доля матчей, выигранных A у B |
| Elo / Bradley-Terry | Алгоритмы рейтинга по парным сравнениям |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с exact-проверок. Для text-to-SQL ассистента запускайте запрос и сравнивайте результат с ожидаемой таблицей. Это дешёвая и надёжная метрика, её легко встроить в CI.
- Эталонный набор — это данные. Храните пары
(вход, эталон)в warehouse с версией. Добавляйте столбцы: источник эталона (человек или AI), кто проверил, дата. Тестовые данные должны лежать отдельно от обучающих. - Версионируйте судью. Сохраняйте модель, текст промпта и параметры в каждой строке результата. Иначе рост метрики нельзя объяснить. Нужна таблица
judge_versionsи ключ в таблице оценок. - Считайте стоимость оценки. Один AI judge на каждый ответ удваивает счёт за API. Несколько критериев умножают его. Выбирайте
samplingи храните долю проверенных ответов. - Проверяйте судью на людях. Раз в период берите выборку, размечайте вручную и считайте согласие. Следите за position и verbosity bias: меняйте порядок ответов в тесте.
- Не доверяйте публичным leaderboards для своей задачи. Они не знают ваших данных и вашего retrieval. Соберите свой маленький набор из реальных запросов, например, поиска по data catalog.
- Embeddings нужны не только для RAG. Cosine similarity помогает искать дубли в данных, группировать запросы и находить аномалии. Это обычная работа с векторами в pipeline.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему open-ended задачи труднее оценивать, чем классификацию? Как это влияет на выбор метода?
- Что означает perplexity, равная 4? Почему perplexity плохо подходит для моделей после
RLHF? - Когда exact match работает хорошо, а когда нужно переходить к semantic similarity? Чем semantic similarity тоже ограничена?
- Назовите три смещения AI judge и способ снизить каждое. Почему судью надо версионировать?
Предыдущая: Понимание foundation models. Следующая: Оценка AI-систем.