

Designing Data-Intensive Applications, глава 9: Согласованность и консенсус
Главная мысль: Чтобы система переживала сбои из главы 8, нужны общие абстракции с чёткими гарантиями. Главная из них, consensus: все узлы согласны в одном решении, и оно не меняется. Сильные гарантии стоят производительности и доступности.
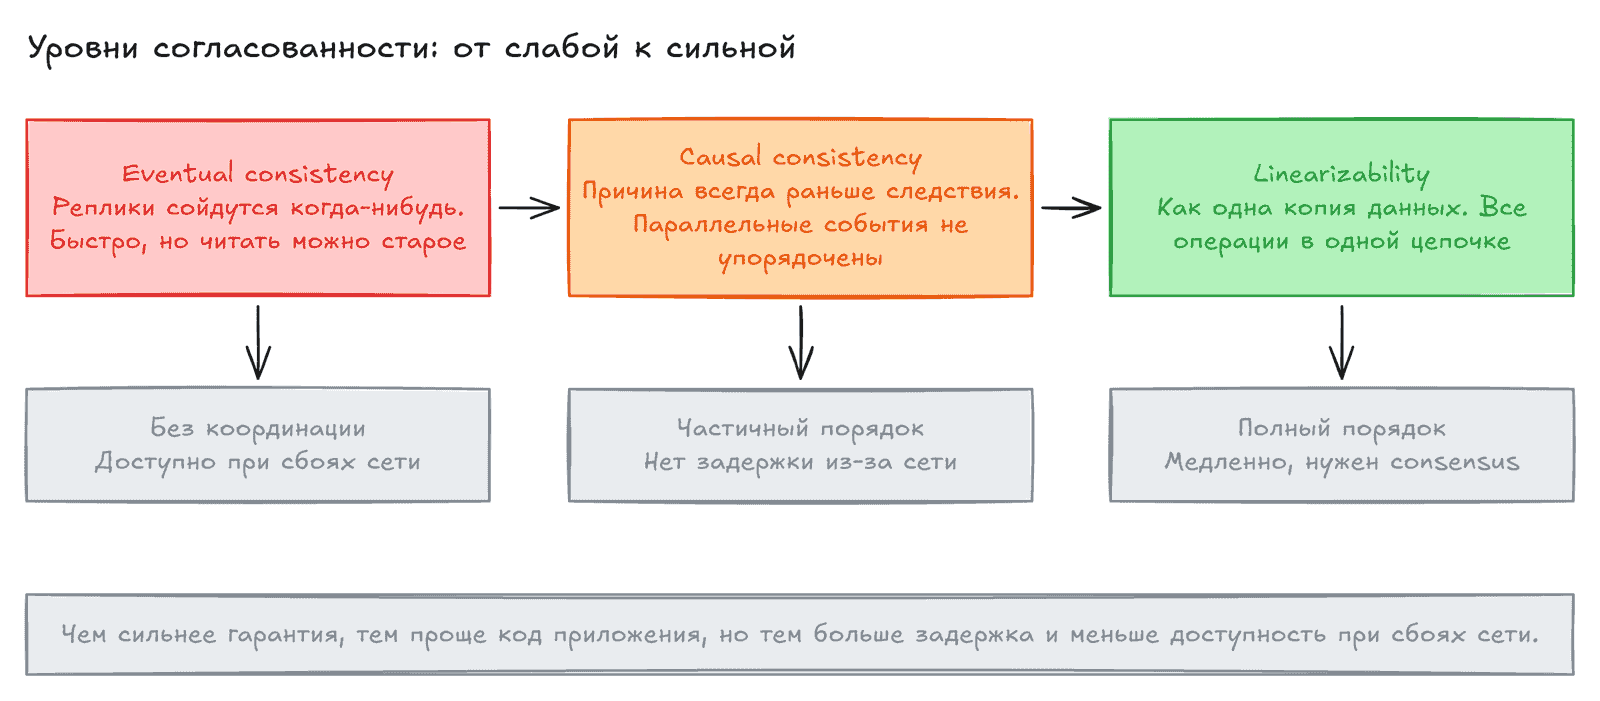
Гарантии согласованности
Заголовок раздела «Гарантии согласованности»Большинство реплицируемых баз дают только eventual consistency: если перестать писать, реплики когда-нибудь сойдутся. Это слабая гарантия. Она не говорит, когда. До этого чтение может вернуть старое значение или ничего.
- Ошибки такого рода редко видны в тестах. Они проявляются при сбое сети или высокой конкурентности.
- Более сильные модели проще в использовании, но медленнее и менее устойчивы к сбоям.
- Согласованность реплик и изоляция транзакций (глава 7) решают разные задачи. Первая про координацию копий, вторая про гонки между транзакциями.
Linearizability
Заголовок раздела «Linearizability»Идея: система ведёт себя так, будто есть одна копия данных, а каждая операция атомарна. Это гарантия свежести (recency). Если клиент прочитал новое значение, все следующие чтения (любых клиентов) тоже видят его.
Правила для одного регистра:
- Чтение до начала записи возвращает старое значение.
- Чтение после конца записи возвращает новое.
- Чтение, пересекающееся с записью, может вернуть любое. Но после первого нового значения старое возвращаться уже не может.
Linearizability и serializability
Заголовок раздела «Linearizability и serializability»| Linearizability | Serializability | |
|---|---|---|
| Что это | Гарантия свежести для одного объекта | Изоляция транзакций |
| Область | Один регистр | Несколько объектов в транзакции |
| Защищает от write skew | Нет | Да |
База может давать обе гарантии: это strict serializability. 2PL и actual serial execution обычно линеаризуемы. SSI нет: он читает из снимка.
Где linearizability нужна
Заголовок раздела «Где linearizability нужна»- Locks и leader election. Все узлы должны одинаково видеть владельца lock. Иначе будет split brain. ZooKeeper и etcd решают это через consensus.
- Uniqueness constraints. Уникальное имя пользователя, баланс не ниже нуля, одно место на рейсе. Нужно одно актуальное значение.
- Несколько каналов связи. Пример: web server кладёт файл в хранилище и пишет в очередь. Resizer читает сообщение раньше, чем файл реплицировался, и берёт старую версию.
Иногда можно обойтись без неё. Ограничение нарушают, а потом исправляют: извиняются, возвращают деньги, берут штраф. Это compensating transaction.
Какая репликация линеаризуема
Заголовок раздела «Какая репликация линеаризуема»| Подход | Linearizable? |
|---|---|
| Single-leader | Потенциально: читать с лидера или sync-фолловера. Но узел может ошибочно считать себя лидером |
| Consensus (ZooKeeper, etcd) | Да |
| Multi-leader | Нет: конфликты решаются после записи |
| Leaderless (Dynamo-стиль) | Скорее нет, даже со строгим quorum (w + r > n). LWW по часам и sloppy quorum точно ломают её |
Linearizable compare-and-set в leaderless-модели невозможен без consensus.
Цена и CAP
Заголовок раздела «Цена и CAP»Если сеть между датацентрами оборвана, у linearizable системы два выхода: ждать или вернуть ошибку. Реплики, потерявшие связь, становятся недоступны. Нелинеаризуемая система (например, multi-leader) продолжает работать, но может отдавать старое.
- CAP лучше читать так: при сетевой партиции выбирайте между linearizability и доступностью. Деление на CP и AP автор советует не использовать.
- CAP узкая: одна модель и один вид сбоя. Практической пользы у неё мало.
- Главная цена не в сбоях, а в скорости. Даже память многоядерного CPU не линеаризуема ради производительности. Время ответа linearizable операций не меньше неопределённости задержек сети.
Порядок и причинность
Заголовок раздела «Порядок и причинность»Порядок событий связан с causality: причина раньше следствия, вопрос раньше ответа, строка создаётся раньше обновления.
| Порядок | Параллельные операции | |
|---|---|---|
| Causal order | Частичный (partial order) | Есть, они несравнимы |
| Linearizability | Полный (total order) | Нет, одна цепочка |
Linearizability сильнее causal consistency: она всегда сохраняет причинность. Но causal consistency самая сильная модель, которая не замедляется из-за сети и доступна при сбоях. Многим системам хватает именно её.
Sequence numbers и Lamport timestamps
Заголовок раздела «Sequence numbers и Lamport timestamps»Отслеживать все причинные связи дорого. Вместо этого операциям дают номера, согласованные с причинностью.
- В single-leader лог репликации уже даёт такой порядок.
- Без лидера номера делают так: чётные и нечётные, часы, блоки номеров. Все три способа не согласованы с причинностью.
- Lamport timestamp = пара (counter, node ID). Каждый узел и клиент помнит максимальный counter и шлёт его с каждым запросом. Узел, получив больший counter, догоняет его. Так порядок согласован с причинностью.
- Lamport timestamps дают полный порядок, но не отличают параллельные операции от зависимых. Для этого нужны version vectors.
Почему timestamps недостаточно
Заголовок раздела «Почему timestamps недостаточно»Для уникального имени пользователя мало знать порядок постфактум. Узлу нужно решить сейчас, а он не знает, что делают другие узлы. Нужно знать, когда порядок окончательно зафиксирован. Это решает total order broadcast.
Total order broadcast
Заголовок раздела «Total order broadcast»Протокол обмена сообщениями между узлами. Две гарантии:
- Reliable delivery: если сообщение дошло до одного узла, оно дойдёт до всех.
- Totally ordered delivery: все узлы получают сообщения в одном порядке.
Порядок фиксируется в момент доставки. Нельзя вставить сообщение в прошлое. Поэтому он сильнее timestamps.
Это по сути append-only лог. Где используется:
- репликация базы (
state machine replication); - serializable транзакции через детерминированные stored procedures;
- lock-сервис с fencing token (в ZooKeeper это
zxid).
Total order broadcast асинхронный: нет гарантии, когда сообщение дойдёт. Linearizability даёт свежесть. Но одно строится из другого.
Linearizable CAS через лог:
- Добавить в лог сообщение с заявкой на имя.
- Дождаться, пока оно вернётся к вам.
- Если ваше сообщение первое по этому имени, вы выиграли. Иначе abort.
Так получаются linearizable записи. Чтения нужно пускать через лог, делать sync() или читать с синхронной реплики.
Total order broadcast через linearizable счётчик: на каждое сообщение делаем increment-and-get и берём номер. В отличие от Lamport, номера идут без пропусков. Получатель видит дыру и ждёт.
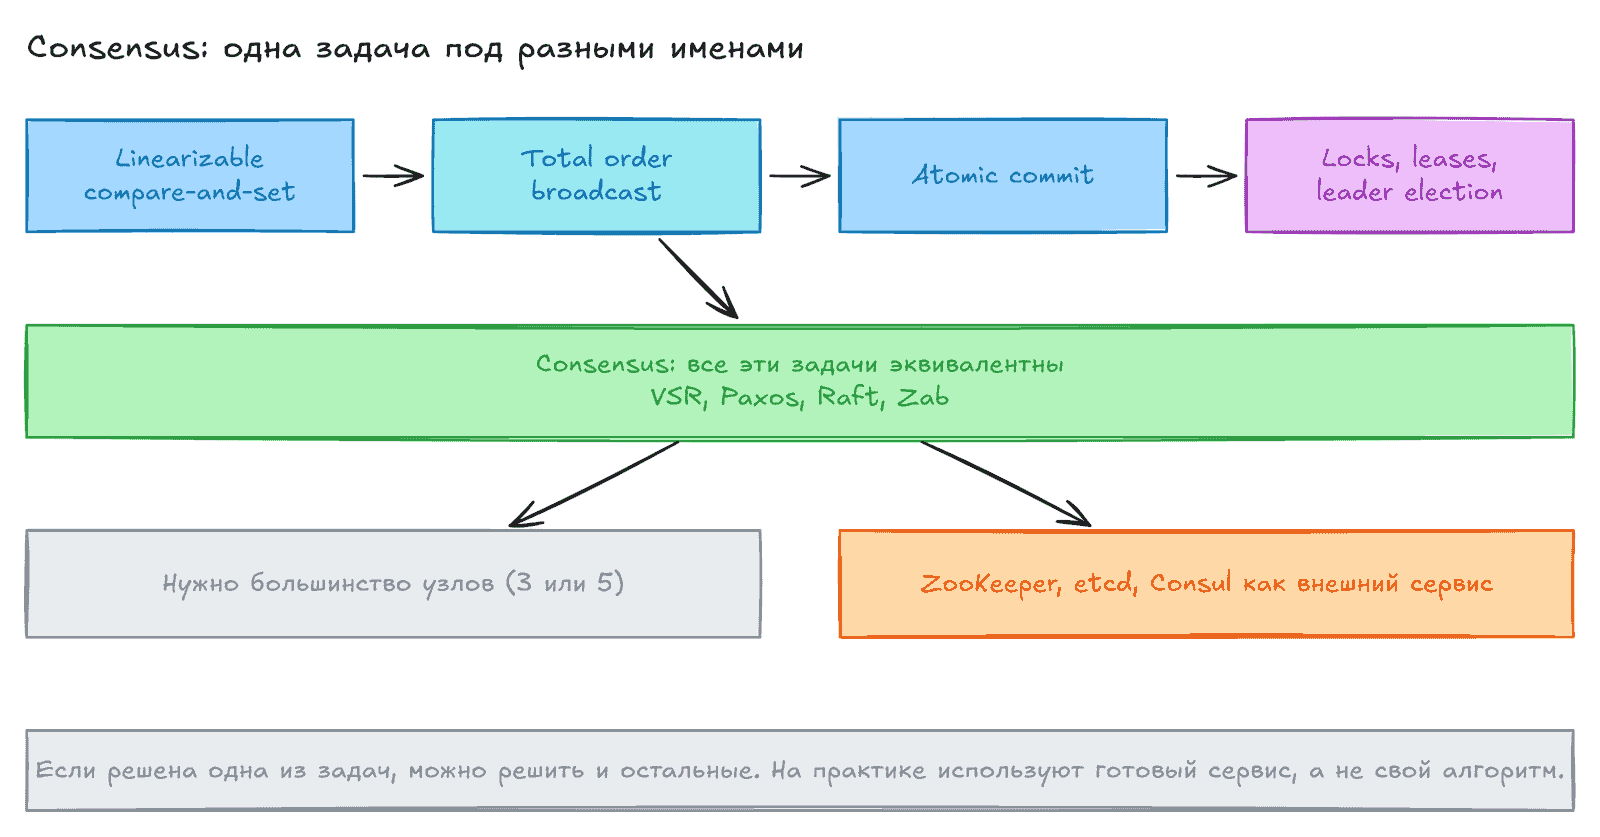
Оба пути приводят к consensus: все эти задачи эквивалентны.
Распределённые транзакции и consensus
Заголовок раздела «Распределённые транзакции и consensus»Consensus: несколько узлов договариваются об одном значении. Нужен для выбора лидера и для atomic commit.
FLP-результат говорит, что consensus невозможен в очень узкой модели (без таймаутов). На практике с таймаутами или случайностью он достижим.
Atomic commit и 2PC
Заголовок раздела «Atomic commit и 2PC»На одном узле commit атомарен: данные пишутся на диск, потом commit record. Решающий момент один.
На нескольких узлах нельзя просто разослать commit. Часть узлов закоммитит, часть откатится. Commit необратим: другие уже читают данные.
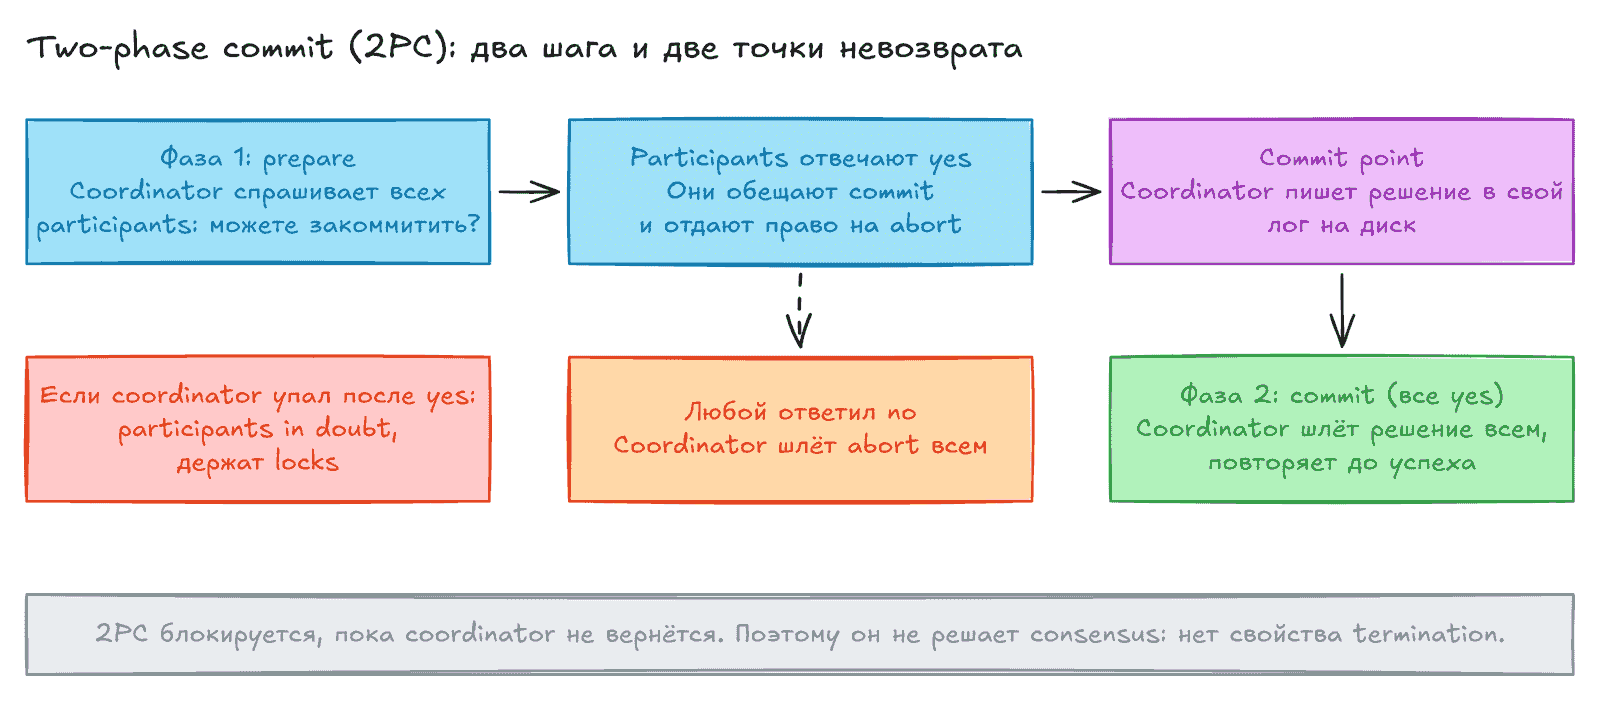
Two-phase commit (2PC):
- Application получает глобальный transaction ID и работает с узлами как обычно.
Coordinatorшлётprepareвсем participants.- Участник, ответив yes, обещает закоммитить при любых условиях. Он уже не может сделать abort сам.
- Coordinator решает и пишет решение в лог (
commit point). - Coordinator шлёт commit или abort и повторяет до успеха.
Две точки невозврата: ответ yes и решение coordinator. Они дают атомарность.
2PC и 2PL не связаны. Первый про atomic commit, второй про изоляцию.
Сбой coordinator
Заголовок раздела «Сбой coordinator»Participant с yes не знает исхода. Он in doubt и ждёт. Самому решить нельзя: другой мог получить иное решение. Поэтому 2PC называют blocking: он ждёт возврата coordinator. 3PC не помогает: ему нужна ограниченная задержка сети.
Locks держатся всё время сомнения. Другие транзакции блокируются. Бывают и осиротевшие транзакции, которые решает только администратор вручную. В XA для этого есть heuristic decisions, но они, по сути, нарушают атомарность.
Distributed transactions на практике
Заголовок раздела «Distributed transactions на практике»| Тип | Особенности |
|---|---|
| Database-internal (VoltDB, FoundationDB, MySQL NDB) | Один софт, оптимизации возможны, работает неплохо |
| Heterogeneous (XA, JTA) | Разные системы, минимум общего, много проблем |
Плюс XA: можно подтвердить сообщение из очереди и записать в БД одной транзакцией. Так получают exactly-once обработку. Побочные эффекты (например, email) должны уметь тот же протокол.
Минусы:
- coordinator сам как база: без репликации он single point of failure;
- приложение перестаёт быть stateless: лог coordinator нужен для восстановления;
- XA не находит deadlocks между системами и не работает с SSI;
- для commit нужны все участники, поэтому сбои усиливаются.
Fault-tolerant consensus
Заголовок раздела «Fault-tolerant consensus»Свойства алгоритма:
- Uniform agreement: никто не решает иначе.
- Integrity: узел решает один раз.
- Validity: решение было кем-то предложено.
- Termination: каждый живой узел когда-нибудь решает.
Первые три безопасность (safety), четвёртое живость (liveness). Termination требует, чтобы работало большинство узлов. Safety сохраняется всегда. Византийские сбои здесь не рассматриваются. 2PC не удовлетворяет termination.
Известные алгоритмы: Viewstamped Replication, Paxos, Raft, Zab. Они решают последовательность значений, то есть реализуют total order broadcast. В Paxos это Multi-Paxos.
Как избежать «чтобы выбрать лидера, нужен лидер»: протоколы вводят epoch number (term в Raft). В каждой эпохе лидер уникален. При конфликте побеждает больший номер. Для каждого решения лидер просит голоса большинства (quorum). Узел голосует, только если не знает лидера с большей эпохой.
Отличие от 2PC: нужно большинство, а не все. Есть и процедура восстановления после смены лидера.
Ограничения consensus:
- это синхронная репликация, значит, медленнее;
- нужно большинство: 3 узла терпят 1 сбой, 5 терпят 2;
- изолированное меньшинство не работает;
- состав узлов обычно фиксирован;
- таймауты вызывают частые выборы при нестабильной сети;
- у Raft есть неприятные случаи с одним плохим сетевым каналом.
Сервисы координации
Заголовок раздела «Сервисы координации»ZooKeeper и etcd хранят малый объём данных в памяти и реплицируют его через total order broadcast. Прикладной код редко обращается к ним напрямую. Их используют HBase, Hadoop YARN, Kafka.
| Возможность | Зачем |
|---|---|
| Linearizable atomic operations | Lock через CAS, чаще как lease |
| Total ordering | zxid как fencing token |
| Failure detection | Сессии с heartbeat, ephemeral nodes |
| Event notifications | Подписка вместо polling |
Типичные задачи: выбор лидера, распределение партиций по узлам, service discovery, membership. Для service discovery consensus не обязателен: DNS работает и без него. Данные в ZooKeeper меняются медленно. Состояние приложения в нём не хранят.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Eventual consistency | Реплики сойдутся, но неизвестно когда |
| Linearizability | Система ведёт себя как одна копия данных |
| Serializability | Транзакции выглядят выполненными по очереди |
| Compare-and-set (CAS) | Атомарная запись, если текущее значение равно ожидаемому |
| CAP | При сетевой партиции выбор между linearizability и доступностью |
| Causal consistency | Сохранён порядок причина-следствие |
| Total order / partial order | Полный порядок и порядок, где часть событий несравнима |
| Lamport timestamp | Пара (counter, node ID), согласованная с причинностью |
| Total order broadcast | Все узлы получают все сообщения в одном порядке |
| Two-phase commit (2PC) | Протокол atomic commit на нескольких узлах |
| In doubt | Участник сказал yes и ждёт решения coordinator |
| XA | Стандарт 2PC между разными системами |
| Consensus | Узлы договариваются об одном решении |
| Epoch number | Номер эпохи лидера (term в Raft, ballot в Paxos) |
| Quorum | Большинство узлов, нужное для решения |
| Fencing token | Растущий номер, защищающий от устаревшего владельца lock |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Не считайте реплики или quorum в Cassandra и Riak linearizable. Если нужна уникальность или CAS, берите систему с лидером или consensus.
- Для pipeline с несколькими каналами (файлы плюс очередь) проверяйте порядок. Читатель может увидеть сообщение раньше данных.
- Не строите межсистемные транзакции через XA без нужды. Чаще работают log и CDC плюс идемпотентная обработка. Это тема глав 10 и 11.
- Не пишите свой алгоритм выбора лидера. Используйте ZooKeeper, etcd или Consul. Для кластера берите 3 или 5 узлов.
- Следите за in-doubt транзакциями и locks, если 2PC всё же используется. Coordinator надо реплицировать и бэкапить его лог.
- Если ограничения можно нарушить и исправить (возврат, извинение), это проще и дешевле строгих ограничений.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем linearizability отличается от serializability? Может ли быть одна без другой?
- Почему Lamport timestamps не хватает для уникальности имени пользователя?
- Почему 2PC блокируется при падении coordinator, а Raft нет?
- Какие задачи эквивалентны consensus? Почему для service discovery он не нужен?
Предыдущая: Проблемы распределённых систем. Следующая: Пакетная обработка.