

The Data Warehouse Toolkit, глава 14: Здравоохранение
Главная мысль: в медицине у одного события много значений одной dimension. У визита несколько диагнозов. Для этого нужен bridge table. Счёт на лечение проходит этапы, поэтому его хранят как accumulating snapshot с ролями дат.
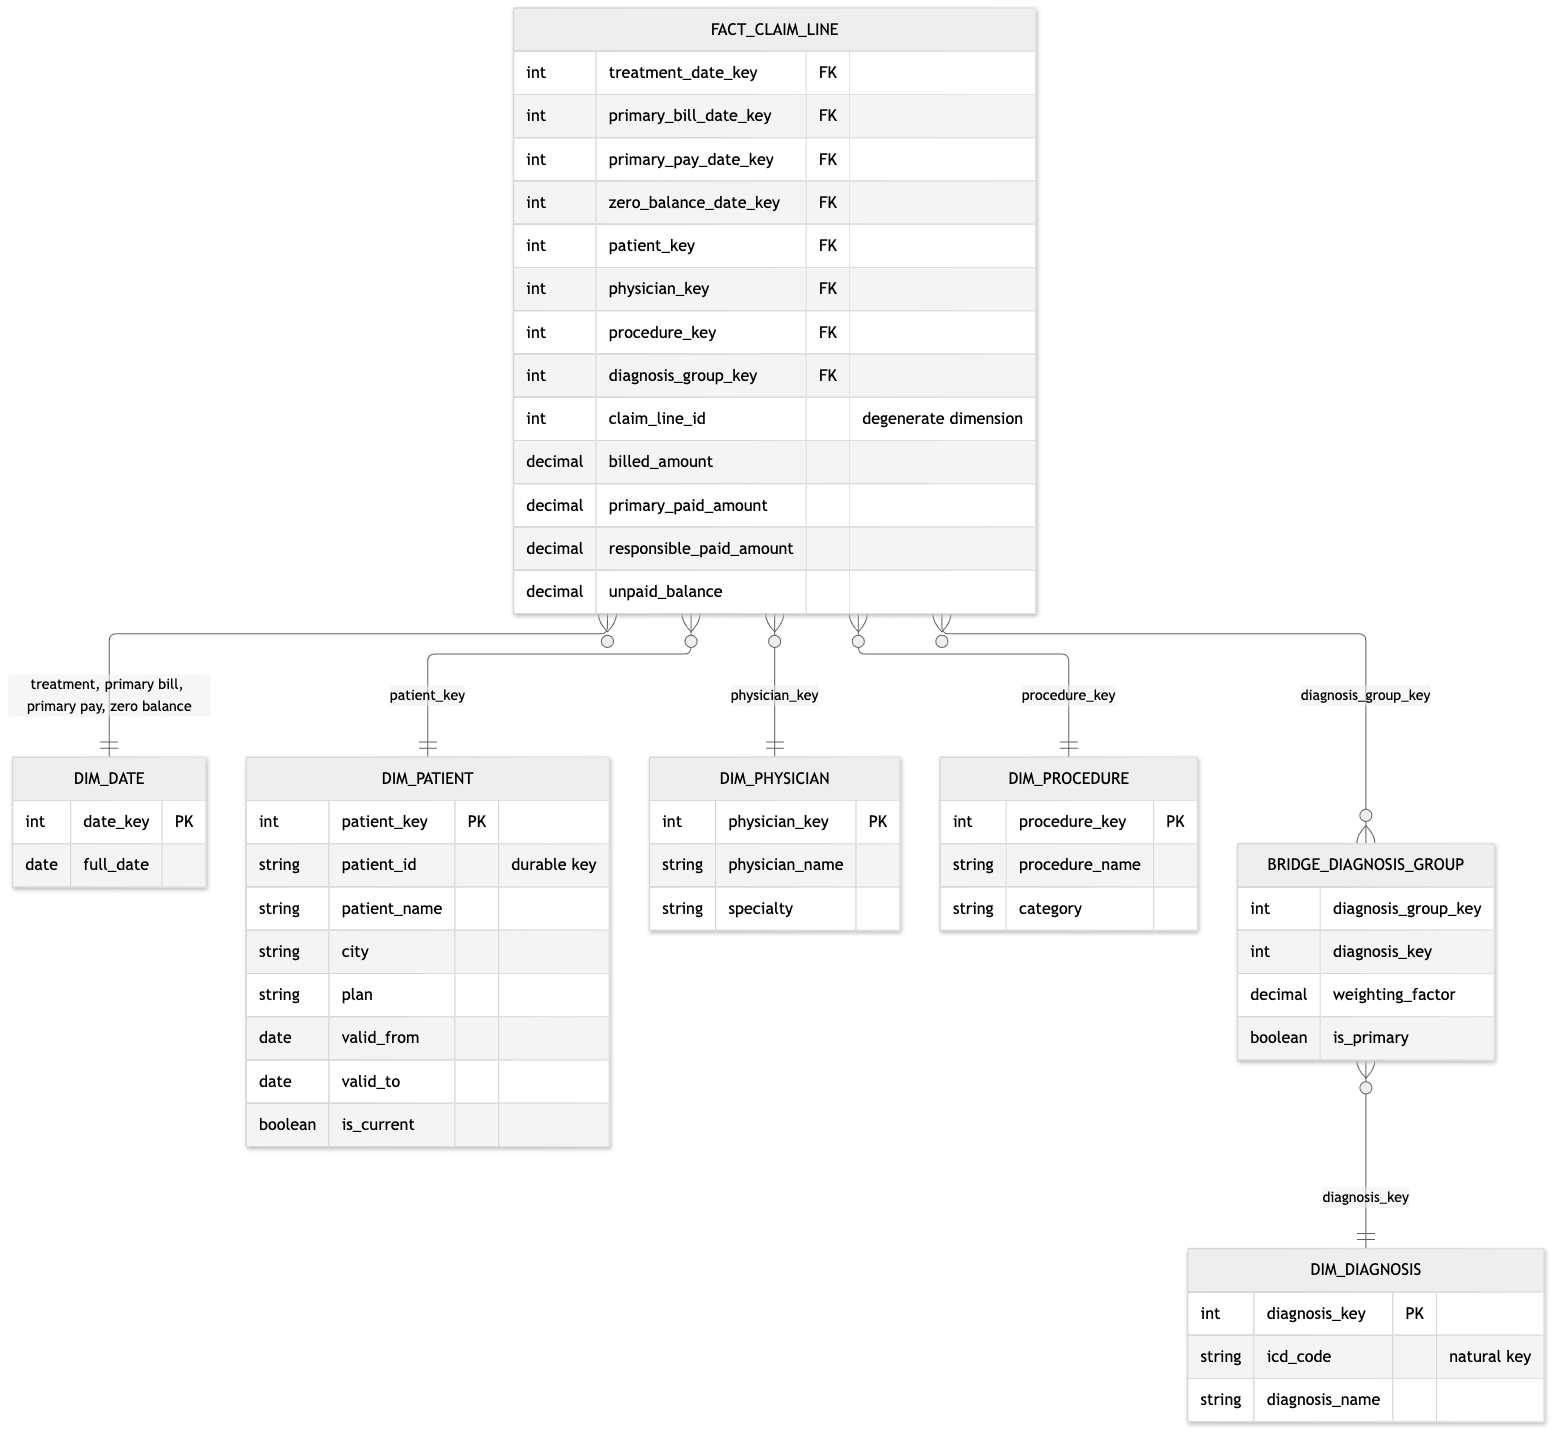
Два мира данных
Заголовок раздела «Два мира данных»| Мир | Что в нём | Пример |
|---|---|---|
| Административный | Счета, claims, оплаты | Сколько выставлено и оплачено |
| Клинический | Записи врача, анализы, назначения | Результаты лабораторных тестов |
Провайдеры (больницы) и плательщики (страховые) сближаются: страховым нужны клинические данные, больницам нужны деньги.
Главная conformed dimension здесь — пациент. Её трудно собрать: единого идентификатора нет, а закон (HIPAA в США) строго защищает данные. Коды диагнозов (ICD) и процедур (CPT, HCPCS) задаёт индустрия, поэтому эти dimensions получаются стандартными.
Основные dimensions: дата, пациент, ответственная сторона, работодатель, план, плательщик, врач, процедура, оборудование, анализ, лекарство, диагноз, учреждение.
Claim как accumulating snapshot
Заголовок раздела «Claim как accumulating snapshot»Организация выставляет счета и следит за оплатой. Для этого есть три варианта grain.
| Grain | Подходит для |
|---|---|
| Transaction | Каждая запись о счёте и оплате |
| Periodic snapshot | Долгие процессы: счета, полисы |
| Accumulating snapshot | Короткий процесс с этапами: счёт → оплата → закрытие |
Для claims выбрали accumulating snapshot. Одна строка — одна строка медицинского счёта (claim line).
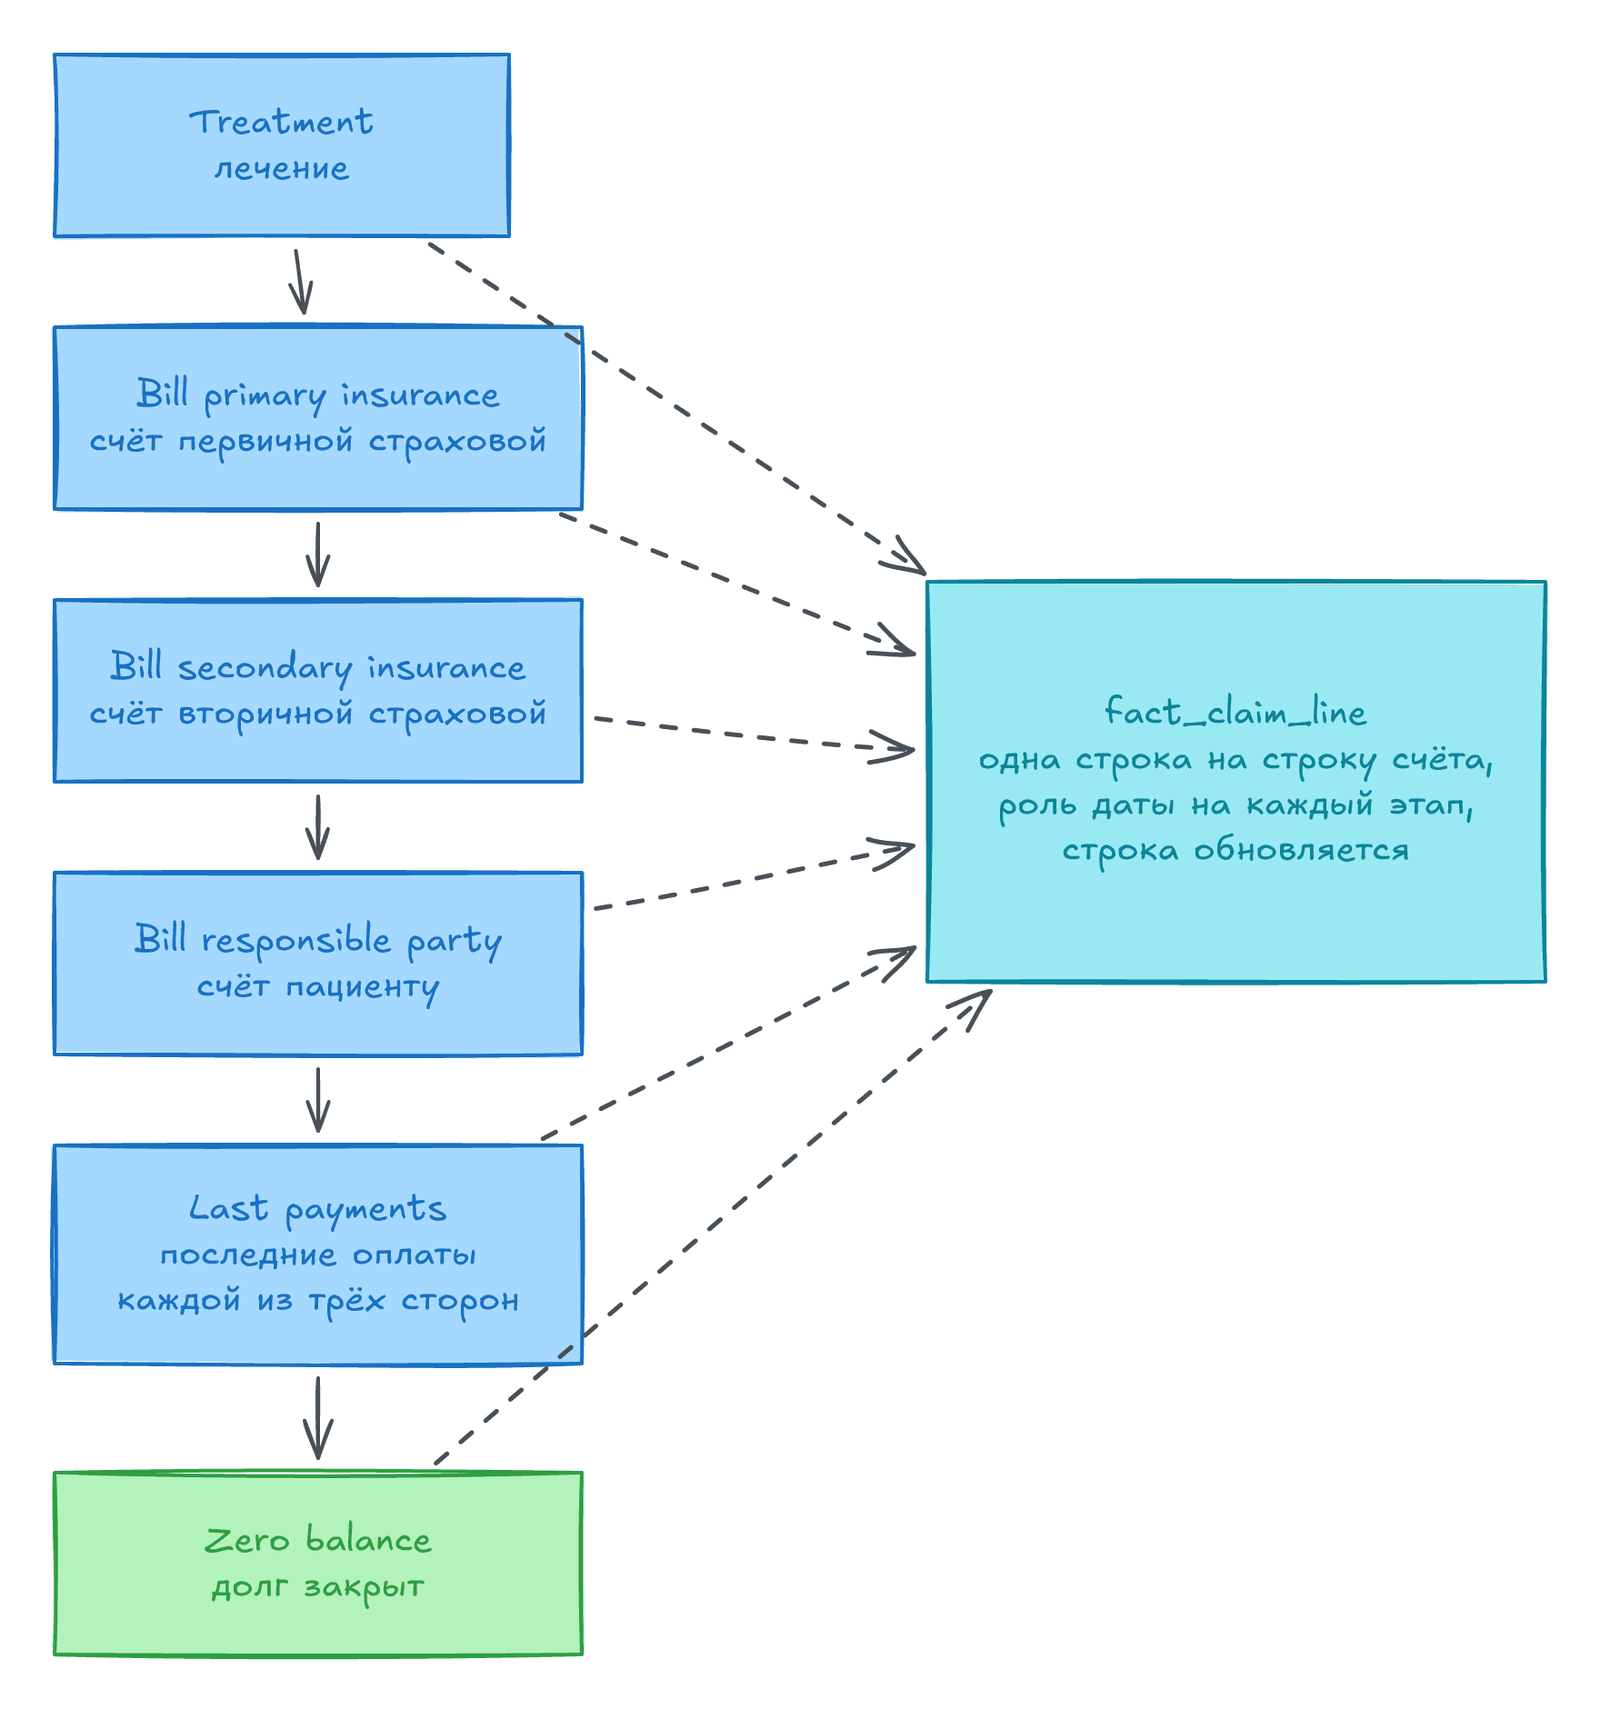
Стандартные даты в книге:
- дата лечения;
- счёт первичной страховой;
- счёт вторичной страховой;
- счёт ответственной стороне (пациенту);
- последние оплаты каждой из трёх сторон;
- дата нулевого баланса.
Каждая дата — отдельная роль одной dim_date. Строка создаётся при первом счёте. Потом её обновляют, когда приходят оплаты.
Role playing есть не только у дат. Врач может играть две роли (направивший и лечащий), страховая — две (первичная и вторичная). Каждая роль — свой foreign key и свой view.
Что в строке:
| Часть | Что внутри |
|---|---|
| Dimensions | Пациент, врач, организация врача, процедура, учреждение, основной диагноз, страховые, работодатель |
| Facts | Выставлено, оплачено первичной и вторичной страховой, оплачено пациентом, в коллекшн, списано, остаток |
| Lags | Дни от счёта до первой оплаты и до нулевого баланса |
Заметки:
- Необычные случаи (несколько оплат на одну строку, одна оплата на несколько строк) accumulating snapshot не описывает. Для них нужны отдельные transaction-таблицы.
- Остаток и итог оплаты — вычисляемые факты.
- Неизвестные даты указывают на строку «Unknown» в
dim_date. - Если строки перестают меняться, партиционирование по дате лечения помогает хранить данные плотно.
Multivalued dimension: диагнозы
Заголовок раздела «Multivalued dimension: диагнозы»В момент визита у пациента несколько диагнозов. У пожилого пациента их может быть 20.
Что не работает:
- Три колонки
diagnosis_1,diagnosis_2,diagnosis_3. Диагнозы не роли. Их больше трёх. BI не знает, по какой колонке фильтровать.
Что работает:
- В fact лежит
diagnosis_group_key. - Bridge table хранит по строке на каждый диагноз в группе.
- Bridge соединён с
dim_diagnosis.
Если ключ группы нужен для модельного инструмента, между fact и bridge можно вставить таблицу diagnosis_group.
| Подход | Когда |
|---|---|
weighting_factor в bridge | Бизнес согласен с правилом распределения. Сумма весов группы равна 1 |
| Без весов | Правила нет. Отчёт отвечает на вопрос «сколько выставлено по случаям с диабетом» (impact) |
Impact-отчёт считает деньги несколько раз. Это нормально, если все понимают. В медицине веса диагнозов определить почти невозможно, кроме основного диагноза. Если веса не нужны бизнесу, не добавляйте их.
Тот же приём — для команды хирургов у сложной операции: ключ группы и bridge.
Sparse facts: measurement type dimension
Заголовок раздела «Sparse facts: measurement type dimension»Лабораторные результаты очень разные: гемоглобин, глюкоза, холестерин. Колонка на каждый показатель даёт много NULL.
Решение: одна колонка observed_value и dimension measurement_type. В ней название, единица и допустимый диапазон. Строка есть только если измерение было.
| Плюс | Минус |
|---|---|
| Новый тип — новая строка, а не новая колонка | Строк в fact больше |
Нет NULL | Арифметика между двумя показателями требует двух строк |
| Подходит для разреженных данных | Нельзя смешивать единицы в одной сумме |
Если измерения заполнены плотно, вернитесь к обычным колонкам.
Прочие приёмы главы
Заголовок раздела «Прочие приёмы главы»| Тема | Решение |
|---|---|
| Свободный текст (заметки врача) | Не в fact. Отдельная dimension комментариев или атрибут transaction-dimension. Это не degenerate dimension |
| Изображения | Имя файла (JPEG) в fact или blob в базе. Файл доступен другим программам, но папку с файлами надо синхронизировать с fact |
| Койки и помещения | Factless periodic snapshot (статус каждой койки в полночь), transaction (занята / освобождена) или timespan fact с датой начала и конца |
| Supertype и subtype для счетов | Счета стационара (facility charges) и врачей в клинике (professional charges) разные. Для стационара свой fact: врач в двух ролях (admitting, attending), две группы диагнозов (при поступлении и при выписке) |
| Команда хирургов | Главный врач — FK в fact. Остальные — через group key и bridge |
| Retroactive changes | Late arriving facts и dimensions. В медицине это частый случай, а не исключение |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Claim line | Одна строка медицинского счёта |
| Accumulating snapshot | Строка с историей процесса. Обновляется |
| Role-playing dimension | Одна dimension в нескольких ролях (много дат) |
| Multivalued dimension | У одного события несколько значений dimension |
| Bridge table | Связь many-to-many. Хранит группу значений |
| Weighting factor | Доля метрики для одной строки bridge |
| Impact analysis | Отчёт с повторным счётом: каждое значение получает всю сумму |
| Measurement type dimension | Описание типа измерения для sparse facts |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с вопроса: «Одна строка fact — что это?» Для claims: одна строка счёта, не один визит.
- Bridge всегда проверяйте:
sum(weighting_factor)по группе должна быть 1, если вы используете веса. - Отчёт по диагнозу без весов может превысить итог. Подпишите его как «impact».
- SCD type 2 в
dim_patientнужен, чтобы видеть профиль пациента на момент лечения. Для «текущего профиля» используйте durable key. - В
dbtaccumulating snapshot — incremental-модель сmergeпо id строки счёта.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки ниже идут по порядку.
Шаг 1. Создаём схему
Заголовок раздела «Шаг 1. Создаём схему»CREATE TABLE dim_date ASSELECT 0 AS date_key, NULL::DATE AS full_dateUNION ALLSELECT strftime(d, '%Y%m%d')::INT, d::DATEFROM generate_series(DATE '2025-01-01', DATE '2025-06-30', INTERVAL 1 DAY) t(d);
CREATE MACRO date_key_or_unknown(d) AS coalesce(strftime(d, '%Y%m%d')::INT, 0);
-- SCD type 2: patient_id это durable key, patient_key это surrogate key версииCREATE TABLE dim_patient ASSELECT * FROM (VALUES (1, 'P1', 'Анна', 'Москва', 'Basic', DATE '2024-01-01', DATE '2025-03-14', false), (2, 'P1', 'Анна', 'Казань', 'Basic', DATE '2025-03-15', DATE '9999-12-31', true), (3, 'P2', 'Борис', 'Москва', 'Basic', DATE '2024-01-01', DATE '9999-12-31', true), (4, 'P3', 'Вера', 'Самара', 'Basic', DATE '2024-01-01', DATE '2025-04-30', false), (5, 'P3', 'Вера', 'Самара', 'Premium', DATE '2025-05-01', DATE '9999-12-31', true)) t(patient_key, patient_id, patient_name, city, plan, valid_from, valid_to, is_current);
CREATE TABLE dim_physician ASSELECT * FROM (VALUES (1, 'Д-р Смирнов', 'Cardiology'), (2, 'Д-р Орлова', 'Endocrinology'), (3, 'Д-р Кузнецов','General')) t(physician_key, physician_name, specialty);
CREATE TABLE dim_procedure ASSELECT * FROM (VALUES (1, 'Consultation', 'Evaluation'), (2, 'ECG', 'Diagnostics'), (3, 'Blood test', 'Lab'), (4, 'Echocardiography', 'Diagnostics')) t(procedure_key, procedure_name, category);
CREATE TABLE dim_diagnosis ASSELECT * FROM (VALUES (1, 'I50.9', 'Heart failure'), (2, 'I10', 'Hypertension'), (3, 'E11.9', 'Type 2 diabetes'), (4, 'N18', 'Chronic kidney disease'), (5, 'J45', 'Asthma')) t(diagnosis_key, icd_code, diagnosis_name);
-- bridge: группа диагнозов; вес группы суммируется в 1CREATE TABLE bridge_diagnosis_group ASSELECT * FROM (VALUES (1, 1, 0.6, true), (1, 2, 0.4, false), (2, 3, 1.0, true), (3, 3, 0.5, true), (3, 2, 0.3, false), (3, 4, 0.2, false), (4, 5, 1.0, true)) t(diagnosis_group_key, diagnosis_key, weighting_factor, is_primary);
-- источник: claim lines (NULL = события ещё не было)CREATE TABLE stg_claim_line ASSELECT * FROM (VALUES (1, 1, 1, 1, 1, DATE '2025-02-10', 200, DATE '2025-02-12', 160, DATE '2025-02-28', 40, DATE '2025-03-10'), (2, 1, 1, 2, 1, DATE '2025-02-10', 300, DATE '2025-02-12', 240, DATE '2025-02-28', 60, DATE '2025-03-20'), (3, 2, 1, 4, 1, DATE '2025-04-02', 500, DATE '2025-04-04', 400, DATE '2025-04-25', 0, NULL), (4, 3, 2, 3, 2, DATE '2025-03-01', 120, DATE '2025-03-03', 96, DATE '2025-03-20', 24, DATE '2025-04-01'), (5, 3, 2, 1, 3, DATE '2025-04-15', 220, DATE '2025-04-17', NULL, NULL, 0, NULL), (6, 4, 3, 1, 4, DATE '2025-03-20', 90, DATE '2025-03-22', 72, DATE '2025-04-05', 18, DATE '2025-04-20'), (7, 5, 3, 1, 4, DATE '2025-05-10', 90, DATE '2025-05-12', 90, DATE '2025-05-30', 0, DATE '2025-05-30'), (8, 3, 2, 2, 3, DATE '2025-05-05', 350, DATE '2025-05-07', 280, DATE '2025-05-27', 0, NULL)) t(claim_line_id, patient_key, physician_key, procedure_key, diagnosis_group_key, treatment_date, billed_amount, primary_bill_date, primary_paid_amount, primary_pay_date, responsible_paid_amount, zero_balance_date);
-- grain: одна строка счёта (claim line). Неизвестные даты = ключ 0CREATE TABLE fact_claim_line ASSELECT claim_line_id, patient_key, physician_key, procedure_key, diagnosis_group_key, date_key_or_unknown(treatment_date) AS treatment_date_key, date_key_or_unknown(primary_bill_date) AS primary_bill_date_key, date_key_or_unknown(primary_pay_date) AS primary_pay_date_key, date_key_or_unknown(zero_balance_date) AS zero_balance_date_key, billed_amount, coalesce(primary_paid_amount, 0) AS primary_paid_amount, responsible_paid_amount, billed_amount - coalesce(primary_paid_amount, 0) - responsible_paid_amount AS unpaid_balanceFROM stg_claim_line;
-- sparse facts: одна строка на одно измерениеCREATE TABLE dim_measurement_type ASSELECT * FROM (VALUES (1, 'Hemoglobin', 'g/dL', 12.0, 16.0), (2, 'Glucose', 'mg/dL', 70.0, 100.0), (3, 'LDL', 'mg/dL', 0.0, 130.0)) t(measurement_type_key, measurement_name, unit, normal_low, normal_high);
CREATE TABLE fact_lab_result ASSELECT * FROM (VALUES ('E1', 1, 20250210, 1, 13.1), ('E1', 1, 20250210, 2, 98.0), ('E2', 3, 20250301, 1, 14.2), ('E2', 3, 20250301, 2, 160.0), ('E2', 3, 20250301, 3, 140.0), ('E3', 4, 20250320, 1, 11.0), ('E4', 5, 20250510, 2, 110.0), ('E4', 5, 20250510, 3, 90.0)) t(lab_event_id, patient_key, date_key, measurement_type_key, observed_value);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»-- веса в каждой группе должны давать 1SELECT diagnosis_group_key, round(sum(weighting_factor), 2) AS weight_sumFROM bridge_diagnosis_groupGROUP BY diagnosis_group_keyORDER BY diagnosis_group_key;
-- 8 claim lines. Общая сумма выставленного равна 1 870SELECT count(*) AS claim_lines, sum(billed_amount) AS billed FROM fact_claim_line;Задания
Заголовок раздела «Задания»1. Выставлено по диагнозам. Сначала без весов (impact), потом с весами. Сравните итоги с общей суммой 1 870.
Решение
SELECT d.diagnosis_name, sum(f.billed_amount) AS billed_impact, round(sum(f.billed_amount * b.weighting_factor), 2) AS billed_weightedFROM fact_claim_line fJOIN bridge_diagnosis_group b USING (diagnosis_group_key)JOIN dim_diagnosis d USING (diagnosis_key)GROUP BY d.diagnosis_nameORDER BY billed_weighted DESC;Итог impact-колонки больше 1 870, потому что одна строка счёта попадает в несколько диагнозов. Итог взвешенной колонки равен 1 870.
Веса здесь учебные. Книга предупреждает: в медицине правило весов почти никогда нельзя обосновать. На практике чаще используют impact-отчёт или только основной диагноз (задание 2).
2. Только основной диагноз. Получите ещё один отчёт без перекоса: используйте is_primary. Итог должен быть 1 870.
Решение
SELECT d.diagnosis_name, count(*) AS claim_lines, sum(f.billed_amount) AS billedFROM fact_claim_line fJOIN bridge_diagnosis_group b USING (diagnosis_group_key)JOIN dim_diagnosis d USING (diagnosis_key)WHERE b.is_primaryGROUP BY d.diagnosis_nameORDER BY billed DESC;3. Accumulating snapshot. Найдите открытые claim lines (нулевой баланс не наступил). Посчитайте возраст долга на 2025-06-01 и средний срок от счёта до первой оплаты. Используйте role-playing alias для dim_date.
Решение
-- открытые счета и возрастSELECT f.claim_line_id, f.unpaid_balance,       DATE '2025-06-01' - b.full_date AS days_since_billingFROM fact_claim_line fJOIN dim_date b ON b.date_key = f.primary_bill_date_keyWHERE f.zero_balance_date_key = 0ORDER BY days_since_billing DESC;
-- средний lag от счёта до оплатыSELECT round(avg(p.full_date - b.full_date), 1) AS avg_days_bill_to_paymentFROM fact_claim_line fJOIN dim_date b ON b.date_key = f.primary_bill_date_keyJOIN dim_date p ON p.date_key = f.primary_pay_date_keyWHERE f.primary_pay_date_key <> 0;
Строка 5 ещё не оплачена. Её даты оплаты равны 0 (Unknown), и она не входит во второй запрос.
4. SCD type 2. Покажите выставленную сумму по городу пациента на момент лечения. Потом по текущему городу (через durable key patient_id). Сравните.
Решение
-- город на момент лечения (ключ версии в fact)SELECT p.city AS city_at_treatment, sum(f.billed_amount) AS billedFROM fact_claim_line fJOIN dim_patient p USING (patient_key)GROUP BY p.cityORDER BY billed DESC;
-- текущий город (durable key)SELECT cur.city AS current_city, sum(f.billed_amount) AS billedFROM fact_claim_line fJOIN dim_patient p   ON p.patient_key = f.patient_keyJOIN dim_patient cur ON cur.patient_id = p.patient_id AND cur.is_currentGROUP BY cur.cityORDER BY billed DESC;
Анна переехала из Москвы в Казань. Первые счета остаются за Москвой в первом отчёте и переходят в Казань во втором.
5. Sparse facts. Покажите результаты анализов, вне нормы (measurement_type хранит диапазон). Потом соберите по каждому событию одну строку: колонки для гемоглобина и глюкозы.
Решение
-- вне нормыSELECT r.lab_event_id, p.patient_name, m.measurement_name, r.observed_value, m.unitFROM fact_lab_result rJOIN dim_measurement_type m USING (measurement_type_key)JOIN dim_patient p USING (patient_key)WHERE r.observed_value NOT BETWEEN m.normal_low AND m.normal_highORDER BY r.lab_event_id, m.measurement_name;
-- одна строка на событиеSELECT r.lab_event_id,       max(r.observed_value) FILTER (WHERE m.measurement_name = 'Hemoglobin') AS hemoglobin,       max(r.observed_value) FILTER (WHERE m.measurement_name = 'Glucose')    AS glucoseFROM fact_lab_result rJOIN dim_measurement_type m USING (measurement_type_key)GROUP BY r.lab_event_idORDER BY r.lab_event_id;
Не складывайте observed_value без measurement_type. Единицы разные.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему для claims выбрали accumulating snapshot, а не transaction fact?
- Чем bridge table для диагнозов лучше трёх колонок
diagnosis_1..3? - Когда weighting factor нужен, а когда его лучше не добавлять?
- Какие минусы у measurement type dimension?