

AI Engineering — конспект книги
AI Engineering: Building Applications with Foundation Models — книга Chip Huyen (O’Reilly, декабрь 2024). Она учит строить приложения на готовых foundation models: от выбора модели и оценки качества до RAG, агентов, finetuning и архитектуры продукта. В книге 10 глав.
Это собственный пересказ, а не перевод. За полным текстом, примерами и ссылками на исследования идите в оригинал. Схемы нарисованы заново по содержанию глав.
Зачем читать
Заголовок раздела «Зачем читать»- Одна карта AI-стека. Книга связывает prompt, RAG, finetuning, оценку и inference в одну систему.
- Оценка — в центре. Две главы про evaluation. Без оценки нельзя выбрать модель и понять, стало ли лучше.
- Данные решают. Глава про dataset engineering близка к работе дата-инженера: качество, дедупликация, синтетика.
- Не про один продукт. Модели меняются каждый месяц. Принципы остаются.
- Решения про стоимость. Latency, cost, build vs buy, когда finetune, а когда RAG.
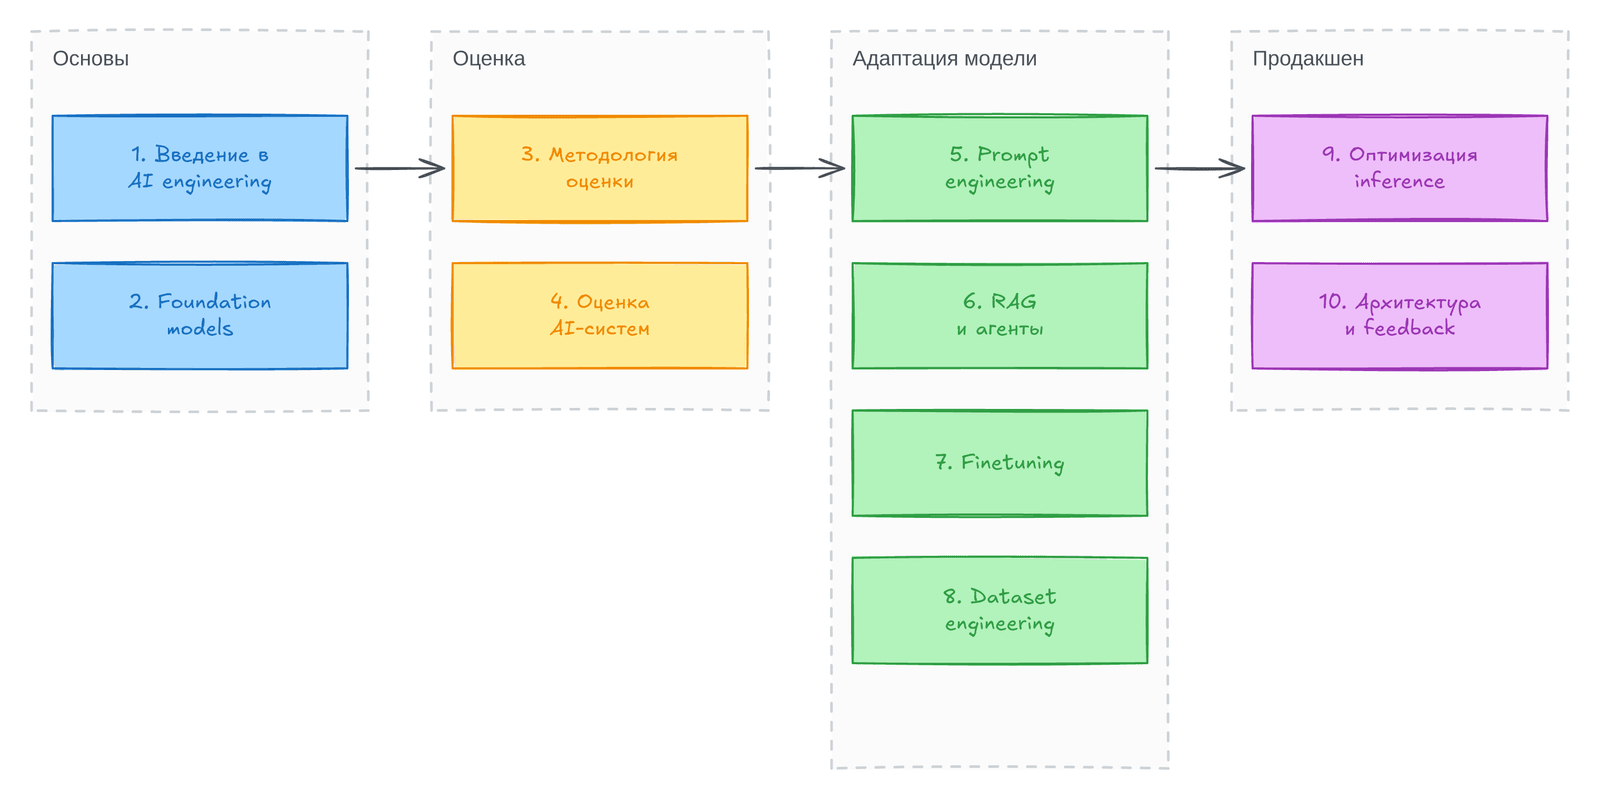
Как устроена книга
Заголовок раздела «Как устроена книга»| Блок | Главы | О чём |
|---|---|---|
| Основы | 1–2 | Что такое AI engineering, как устроены foundation models |
| Оценка | 3–4 | Методы evaluation, выбор модели, пайплайн оценки |
| Адаптация модели | 5–8 | Prompt, RAG и агенты, finetuning, данные |
| Продакшен | 9–10 | Оптимизация inference, архитектура, обратная связь |
Главные идеи
Заголовок раздела «Главные идеи»| Идея | Где разбирается |
|---|---|
| Порядок адаптации: prompt, потом RAG, потом finetuning | Глава 7 |
| Finetune для формы, RAG для фактов | Глава 6, глава 7 |
| Сначала оценка, потом разработка (evaluation-driven development) | Глава 4 |
| Модель вероятностная, поэтому нужны sampling-настройки и проверки | Глава 2 |
| Качество данных важнее их количества | Глава 8 |
| Prefill и decode: две разные фазы inference | Глава 9 |
| Архитектура растёт шагами: context, guardrails, router, cache | Глава 10 |
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Главные идеи не устарели: оценка в центре, данные важнее модели, порядок prompt → RAG → finetuning. Устарели примеры моделей, цены и часть инструментов. В конце каждой главы есть раздел «Что изменилось к 2026 году».
| Тема | Что изменилось | Глава |
|---|---|---|
| Модели | Reasoning models и test-time compute. RL с проверяемой наградой (RLVR). MoE стал нормой | 2 |
| Оценка | MMLU насыщен. LMArena вместо LMSYS. Новые benchmarks для кода и агентов | 3, 4 |
| Контекст | Context engineering. Контекст 1M токенов. Structured output по JSON schema | 5 |
| Агенты | MCP стал стандартом. Coding agents. Agentic search рядом с vector RAG | 6 |
| Обучение | Reinforcement fine-tuning. Synthetic data с автоматической проверкой | 7, 8 |
| Serving | FP8 и FP4, disaggregated prefill/decode, vLLM и SGLang | 9 |
| Продакшен | AI gateways, OpenTelemetry для GenAI, онлайн-evals | 10 |
Для кого
Заголовок раздела «Для кого»| Роль | Что получит |
|---|---|
| Data engineer, analytics engineer | Понимание, как данные и пайплайны работают внутри AI-продуктов |
| Разработчик AI-фич | Карту решений: модель, prompt, RAG, finetuning, оценка |
| Аналитик | Методы оценки качества и работы с feedback |
| Руководитель | Язык для обсуждения стоимости, рисков и сроков AI-проекта |
Нужны базовые знания Python и общее представление о машинном обучении. Глубокая математика не нужна.
Как читать
Заголовок раздела «Как читать»- Новичок. Читайте по порядку. Главы 1, 2, 5 дают основу. Главу 9 оставьте на второй проход.
- Analytics engineer. Главы 3, 4, 8, 10: оценка, данные, feedback.
- Data engineer. Главы 6, 8, 9, 10: RAG-пайплайн, датасеты, serving, мониторинг.
- Руководитель. Главы 1, 4, 7, 10: планирование, оценка, build vs buy, архитектура.
Предлагаемый порядок:
- Главы 1–2: что строим и на чём.
- Главы 3–4: как измерять качество.
- Главы 5–7: как адаптировать модель.
- Глава 8: как готовить данные.
- Главы 9–10: как запускать и улучшать в продакшене.
Связь с другими конспектами
Заголовок раздела «Связь с другими конспектами»| Fundamentals of Data Engineering | AI Engineering | |
|---|---|---|
| Фокус | Жизненный цикл данных | Жизненный цикл AI-приложения |
| Вопрос | Как данные попадают к потребителю | Как из данных и модели собрать продукт |
Данные для RAG, finetuning и оценки приходят из тех самых пайплайнов. Начните с конспекта Fundamentals of Data Engineering, если нужна база.
Разбор по главам
Заголовок раздела «Разбор по главам»| Глава | Тема |
|---|---|
| 1. Введение в AI engineering | Foundation models, AI-стек, планирование приложения |
| 2. Как устроены foundation models | Данные, архитектура, post-training, sampling |
| 3. Методология оценки | Perplexity, exact evaluation, AI as a judge |
| 4. Оценка AI-систем | Критерии, выбор модели, пайплайн оценки |
| 5. Prompt engineering | Приёмы prompt, защита от атак |
| 6. RAG и агенты | Retrieval, chunking, tools, planning, memory |
| 7. Finetuning | Когда нужен, память, LoRA, QLoRA |
| 8. Dataset engineering | Качество данных, синтетика, обработка |
| 9. Оптимизация inference | Latency, KV cache, batching, quantization |
| 10. Архитектура и feedback | Guardrails, router, cache, мониторинг, обратная связь |
Каждая страница содержит главную мысль, схему, ключевые термины, выводы для практики и вопросы для самопроверки.