

Designing Data-Intensive Applications, глава 10: Пакетная обработка
Главная мысль: batch job читает ограниченный набор входных данных и создаёт новый результат. Вход не меняется. Поэтому задачу можно безопасно повторить, а сбои легко скрыть от кода.
Вступление Part III: системы и производные данные
Заголовок раздела «Вступление Part III: системы и производные данные»Часть III книги про интеграцию нескольких систем в одно приложение. Здесь важно различие:
| Тип | Что это |
|---|---|
| System of record | Источник истины. Новые данные попадают сюда первыми. Каждый факт хранится один раз |
| Derived data system | Результат обработки других данных: кэш, индекс, materialized view, denormalized копия. Её можно пересоздать из источника |
Тип зависит не от СУБД, а от того, как вы её используете. Batch-обработка в этой главе создаёт именно derived data.
Три типа систем
Заголовок раздела «Три типа систем»| Тип | Как работает | Главная метрика |
|---|---|---|
| Service (online) | Ждёт запрос и быстро отвечает | Response time, availability |
| Batch (offline) | Берёт большой вход, запускает job, пишет выход. Часто по расписанию | Throughput |
| Stream (near-real-time) | Обрабатывает события вскоре после появления | Latency (глава 11) |
Unix-философия
Заголовок раздела «Unix-философия»Анализ лога цепочкой awk | sort | uniq -c | sort | head показывает идеи, которые перешли в Hadoop.
- Каждая программа делает одно дело хорошо.
- Вывод одной программы становится входом другой, ещё неизвестной.
- Единый интерфейс: файл как последовательность байтов. Всё подключается ко всему.
- Логика отделена от wiring: программа читает stdin и пишет stdout. Куда идут данные, решает shell.
- Вход неизменяем. Можно запускать много раз и пробовать разные варианты.
- Результат любого шага можно посмотреть или сохранить в файл и продолжить с этого места.
Главный предел: Unix-инструменты работают на одной машине.
MapReduce и распределённая файловая система
Заголовок раздела «MapReduce и распределённая файловая система»MapReduce похож на Unix-процесс, распределённый на тысячи машин. Вместо файлов и pipes он использует HDFS.
HDFS строится по принципу shared-nothing. Каждая машина хранит свои блоки. NameNode знает, где лежит какой блок. Блоки реплицируются (или используют erasure coding). Object storage (S3 и др.) похож, но хранение и вычисления там обычно разделены.
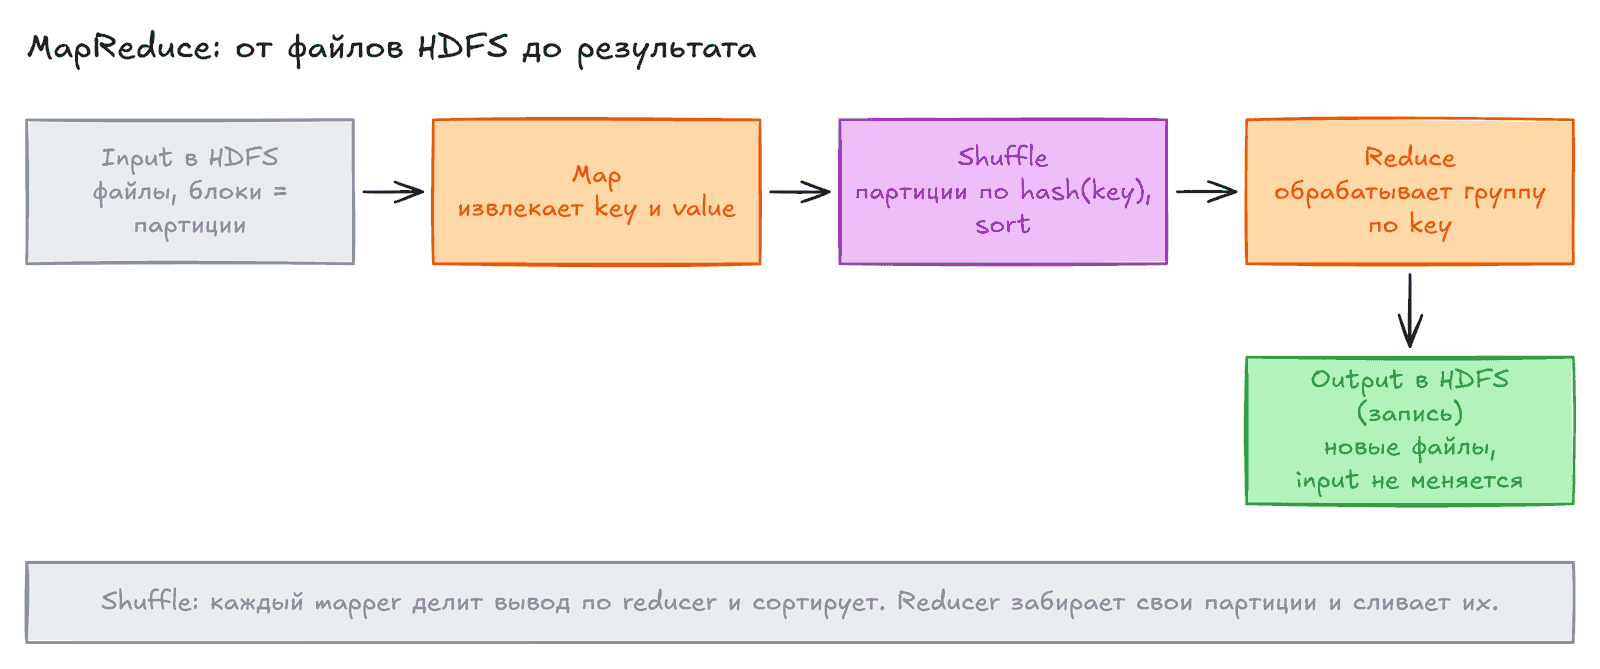
Как выполняется job:
- Входной файл делится на записи. Каждый блок файла обрабатывает свой mapper.
mapвызывается для каждой записи и выдаёт пары key-value. Ноль или больше пар на запись.- Framework делит вывод mapper по reducer через hash от ключа. Каждая партиция сортируется. Этот шаг называют shuffle.
- Reducer забирает свои партиции со всех mapper и сливает их, сохраняя порядок.
reduceвызывается один раз на ключ с итератором по значениям. Результат пишется в HDFS.
Важные детали:
- Сортировка встроена. Это самая важная часть модели.
- Код mapper запускают рядом с данными (data locality), чтобы не гонять файлы по сети.
- Число reducer задаёт автор job. Число mapper зависит от числа блоков входа.
- Выход job считается валидным только после успешного завершения. Частичный результат сбойной job отбрасывается.
Workflow из нескольких job
Заголовок раздела «Workflow из нескольких job»Одна job часто не хватает. Например, посчитать просмотры на URL можно одной job, а топ URL требует второй.
- Hadoop не умеет связывать job. Связь идёт через имя каталога в HDFS: выход первой job равен входу второй.
- Вторая job стартует только после успеха первой.
- Для зависимостей используют workflow-планировщики: Oozie, Azkaban, Luigi, Airflow.
- Workflow из 50–100 job обычны для рекомендательных систем.
- Pig, Hive, Cascading, Crunch строят такие цепочки автоматически.
Joins и группировка в batch
Заголовок раздела «Joins и группировка в batch»MapReduce не имеет индексов. Job читает весь вход (full scan). Для аналитики это нормально.
Не ходите из job в удалённую БД за каждой записью. Это медленно, перегружает БД и делает результат недетерминированным. Лучше скопировать таблицу в HDFS (ETL) и делать join локально.
Reduce-side joins
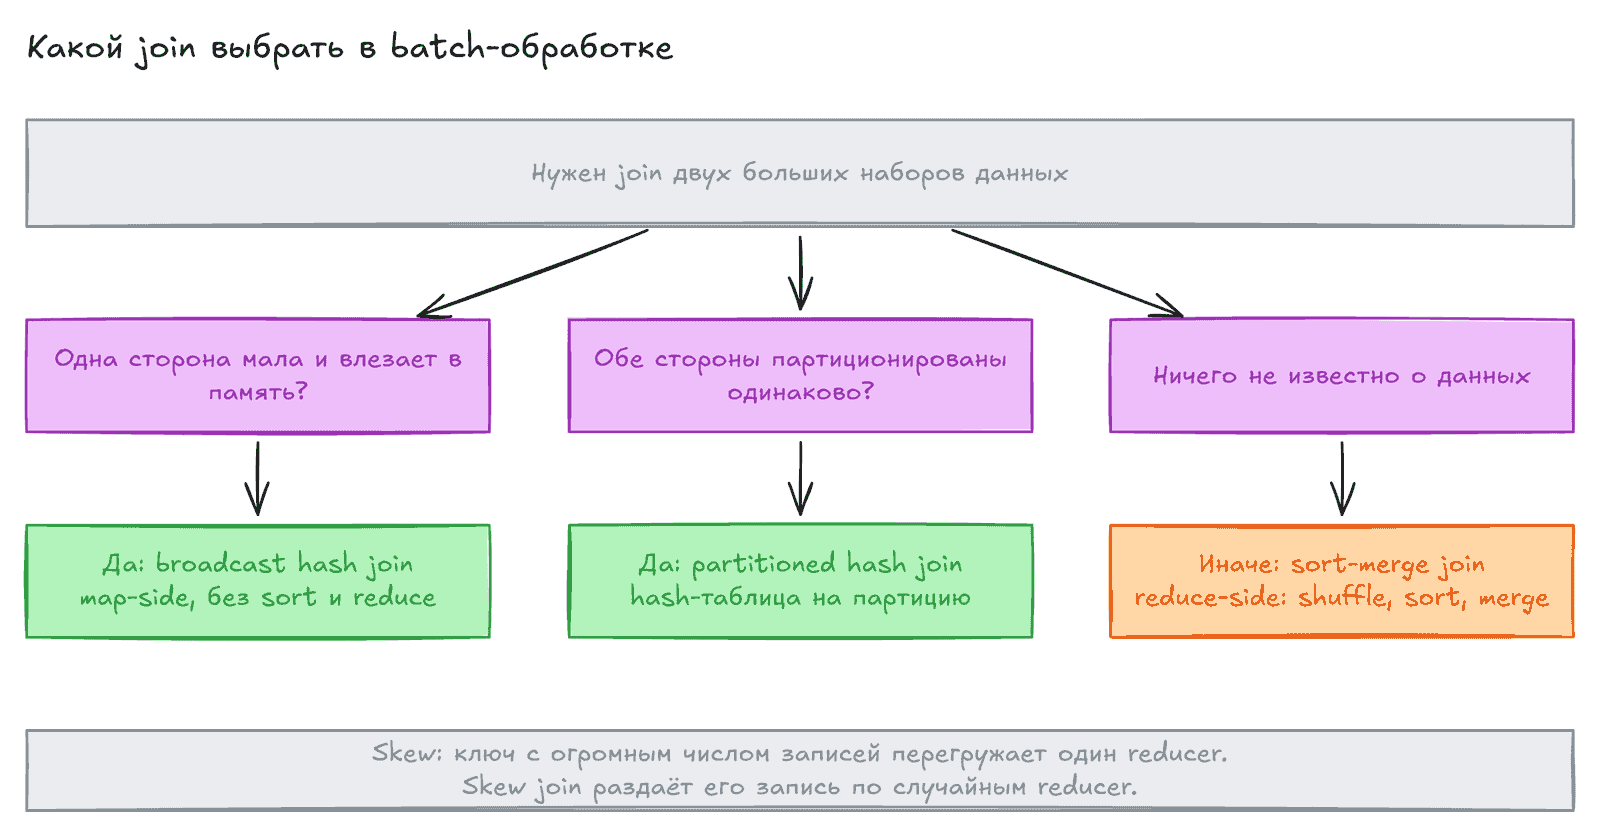
Заголовок раздела «Reduce-side joins»- Sort-merge join. Mapper для каждого входа извлекает join key. Shuffle собирает записи с одним ключом в одном
reduce. Secondary sort ставит запись из справочника первой. Reducer хранит одну запись в памяти. - GROUP BY делается так же: ключ группировки становится ключом mapper.
- Sessionization. Группировка событий по пользователю или сессии, например для A/B-тестов.
Идея: mapper «отправляет сообщения» reducer по ключу как по адресу. Сеть и сбои узлов спрятаны от кода.
Если на один ключ приходится очень много данных (linchpin object, например знаменитость в соцсети), один reducer становится медленным. Job ждёт самого медленного.
- Skew join (Pig, Hive) и sharded join (Crunch). Записи горячего ключа идут на случайные reducer. Вторую сторону join копируют на все reducer.
- Для GROUP BY: двухэтапная агрегация. Сначала частичная на случайных reducer, потом объединение.
Map-side joins
Заголовок раздела «Map-side joins»Это урезанная job без reducer и без sort. Быстрее, но нужны допущения о данных.
| Вариант | Условие | Идея |
|---|---|---|
| Broadcast hash join | Одна сторона мала и влезает в память | Каждый mapper грузит маленький вход в hash table и сканирует большой |
| Partitioned hash join (bucketed map join в Hive) | Оба входа партиционированы одинаково: тот же key, hash, число партиций | Hash table строится только для одной партиции |
| Map-side merge join | Входы партиционированы и отсортированы по ключу | Mapper сливает два отсортированных файла |
Для оптимизации важно знать физическую раскладку данных: число партиций, ключ, сортировку. Эти метаданные хранят HCatalog и Hive metastore.
Результат batch-обработки
Заголовок раздела «Результат batch-обработки»Batch не OLTP и не чистая аналитика. Результат часто не отчёт, а новая структура данных.
- Search index. Mapper делит документы, reducer строит индекс партиции. Файлы неизменяемы. При изменениях можно пересобрать всё или обновлять инкрементально.
- ML и рекомендации. Результат часто key-value база для веб-приложения.
- Как загружать результат. Не пишите в БД из mapper или reducer запись за записью. Это медленно, перегружает БД, а побочные эффекты видны при частичных и повторных попытках. Лучше собрать файлы базы в HDFS и загрузить их целиком (Voldemort, HBase bulk loading). Сервер атомарно переключается на новые файлы и может вернуться на старые.
Почему это удобно в сопровождении
Заголовок раздела «Почему это удобно в сопровождении»- Баг в коде: откатите код, перезапустите job, и результат снова верный (human fault tolerance). С БД, куда писали плохие данные, так не выйдет.
- Можно держать старый результат в соседнем каталоге и переключаться.
- Упавшую task безопасно перезапустить: вход неизменяем, вывод сбойной попытки отбрасывается.
- Одни и те же файлы читают разные job, включая проверки качества выхода.
- Логика отделена от wiring. Разные команды владеют разными job.
В Hadoop вместо текста часто используют Avro и Parquet: схема и эффективное кодирование.
MapReduce против MPP-баз
Заголовок раздела «MapReduce против MPP-баз»MPP (massively parallel processing) базы, такие как Teradata, появились раньше и умеют те же алгоритмы join. Различия:
| MPP-база | Hadoop (HDFS + MapReduce) | |
|---|---|---|
| Хранение | Нужна модель заранее, свой формат | Любые байты. Можно сначала сложить, потом разбираться (data lake, sushi principle) |
| Обработка | SQL, один движок | Любой код: ML, индексы, анализ изображений. SQL тоже (Hive) |
| Сбои | Обычно abort и перезапуск всего запроса | Повтор отдельной task |
| Память и диск | Данные в памяти | Активно пишет на диск |
Hadoop часто используют для ETL: сырые данные в HDFS, очистка и преобразование, загрузка в хранилище. Моделирование остаётся, но отделено от сбора. Разные модели обработки работают в одном кластере над одними файлами.
Почему MapReduce терпит частые сбои? Не из-за плохого железа. В дата-центрах Google batch-задачи имеют низкий приоритет, и их вытесняют (preemption). За час задача рискует примерно 5%. Это улучшает использование ресурсов. В YARN, Mesos и Kubernetes preemption применяют редко, и тогда эти решения менее оправданы.
Beyond MapReduce: dataflow engines
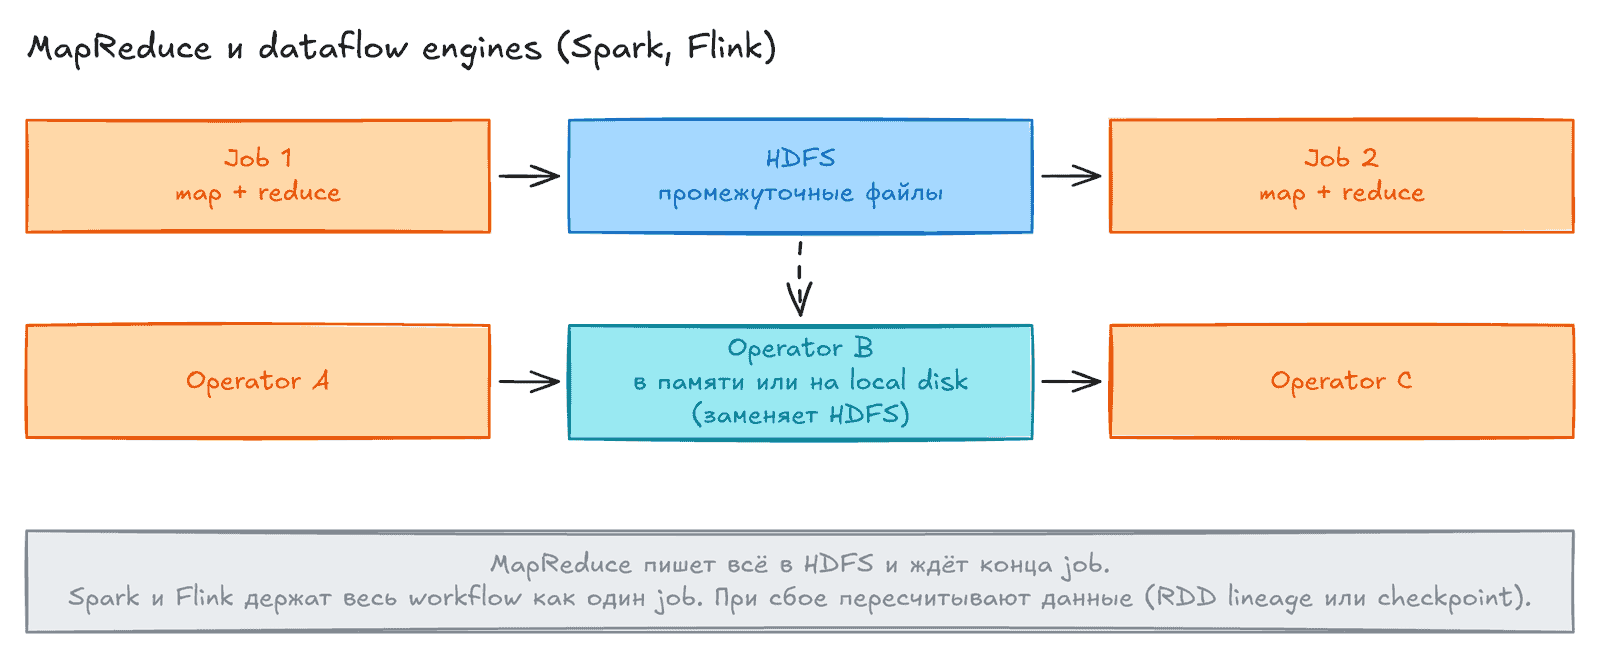
Заголовок раздела «Beyond MapReduce: dataflow engines»У MapReduce есть слабое место: materialization промежуточного состояния. Каждая job пишет результат в HDFS с репликами.
- Следующая job ждёт все task предыдущей, включая медленные (stragglers).
- Mapper часто лишний: читает то, что только что записал reducer.
- Промежуточные файлы реплицируются без нужды.
Dataflow engines (Spark, Tez, Flink) описывают весь workflow как один job. Функции называются operators. Они не обязаны чередоваться как map и reduce.
Варианты связи операторов:
- repartition и sort, как shuffle;
- partition без sort, для partitioned hash join;
- broadcast на все партиции.
Плюсы:
- Сортировка только там, где нужна.
- Нет лишних mapper.
- Планировщик видит зависимости и учитывает locality.
- Промежуточные данные в памяти или на local disk.
- Operator стартует, как только готов вход.
- JVM-процессы можно переиспользовать.
Код Pig, Hive и Cascading можно перевести с MapReduce на Tez сменой конфигурации.
Fault tolerance без HDFS
Заголовок раздела «Fault tolerance без HDFS»Промежуточное состояние потеряно, значит его надо пересчитать.
- Spark хранит lineage (какие партиции и operators дали данные) в абстракции RDD.
- Flink делает checkpoint состояния operators.
- Пересчёт требует детерминированных operators. Источники недетерминизма: порядок обхода hash table, случайные числа, системные часы, внешние источники. Для random используйте fixed seed.
- Если промежуточные данные малы или расчёт тяжёлый, дешевле сохранить их в HDFS.
Flink строится вокруг pipelined execution. Но sort всё равно собирает весь вход. Входы и итоговые выходы обычно остаются в HDFS.
Графы и итеративная обработка
Заголовок раздела «Графы и итеративная обработка»PageRank и подобные алгоритмы повторяют шаг, пока не наступит сходимость. В MapReduce это неэффективно: каждый раунд читает весь граф заново.
- Pregel (BSP): Giraph, GraphX в Spark, Gelly во Flink. Вершина хранит состояние в памяти и получает сообщения предыдущей итерации. Работа идёт только там, где есть сообщения.
- Отказоустойчивость: checkpoint состояния вершин после итерации.
- Граф обычно делят по hash от ID вершины. Это даёт много сетевого трафика. Если граф помещается на одной машине, один поток часто быстрее кластера.
- DAG в dataflow engines и граф как данные — разные вещи, хотя названия похожи.
Высокоуровневые API и declarative
Заголовок раздела «Высокоуровневые API и declarative»Spark и Flink дают API на relational-операциях: join, group, filter, aggregate. Плюсы:
- меньше кода, интерактивная работа в shell;
- cost-based optimizer сам выбирает алгоритм join и порядок joins (Hive, Spark, Flink);
- declarative фильтры позволяют читать только нужные колонки (column-oriented storage) и использовать vectorized execution.
Такие движки приближаются по скорости к MPP-базам, но сохраняют гибкость: произвольный код и любые форматы. Появляются готовые библиотеки: Mahout и MADlib для ML, k-nearest neighbors, genome analysis.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Batch processing | Обработка ограниченного набора данных. Job завершается |
| Bounded input | Вход с известным размером. В отличие от потока |
| HDFS | Распределённая файловая система Hadoop, shared-nothing |
| Map / Reduce | Функции: извлечь key-value и обработать группу по ключу |
| Shuffle | Разбиение вывода mapper по reducer, сортировка и копирование |
| Sort-merge join | Reduce-side join через сортировку по join key |
| Broadcast hash join | Малый вход целиком в память каждого mapper |
| Partitioned hash join | Hash join по одинаковым партициям обоих входов |
| Skew | Один ключ с огромным объёмом, одна reducer-партиция перегружена |
| Materialization | Запись промежуточного результата на диск или в HDFS |
| Dataflow engine | Движок, исполняющий workflow как один job из operators (Spark, Flink, Tez) |
| RDD | Абстракция Spark с отслеживанием происхождения данных |
| Deterministic operator | Те же входы дают тот же выход. Нужен для пересчёта |
| Pregel / BSP | Модель итеративной обработки графов сообщениями между вершинами |
| Human fault tolerance | Возможность исправить баг кода, перезапустив job на тех же данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Делайте jobs идемпотентными: вход не меняется, результат пишется целиком и заменяет прежний. Тогда перезапуск безопасен.
- Не пишите из задач в рабочую БД запись за записью. Готовьте файл или снимок и загружайте целиком с атомарным переключением.
- Выбирайте join по данным: маленькая таблица измерений подходит для broadcast, а для двух больших ищите общий ключ партиционирования. Следите за skew: смотрите на самую медленную task.
- Spark и Flink обычно быстрее MapReduce. Они пересчитывают потерянные данные, поэтому убирайте недетерминизм: время, random без seed, порядок hash table.
- Храните сырые данные неизменяемыми (data lake). Моделирование делайте отдельным шагом. Тогда ошибку в трансформации можно исправить пересчётом.
- Для зависимостей между jobs нужен workflow-планировщик (Airflow, Luigi). Метаданные о партиционировании и сортировке ведите в каталоге.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие принципы Unix перешли в MapReduce? Какое главное ограничение Unix-инструментов?
- Чем sort-merge join отличается от broadcast hash join? Когда нужен каждый?
- Почему не стоит писать результат batch job в базу запись за записью?
- Что такое materialization и как dataflow engines избегают её недостатков? Чем платят за это при сбое?
Предыдущая: Согласованность и консенсус. Следующая: Потоковая обработка.