

Designing Data-Intensive Applications, глава 5: Репликация
Главная мысль: Репликация хранит копии данных на нескольких узлах. Это просто, пока данные не меняются. Вся сложность в изменениях: порядок записей, отставание реплик и конфликты.
Часть II книги переходит от одной машины к нескольким. Причины две: масштаб и отказоустойчивость. Есть два механизма. Репликация хранит копии одних и тех же данных. Партиционирование делит данные на части (глава 6). Обычно их используют вместе. Книга рассматривает архитектуру shared-nothing: у каждого узла свои CPU, RAM и диски, узлы общаются по сети.
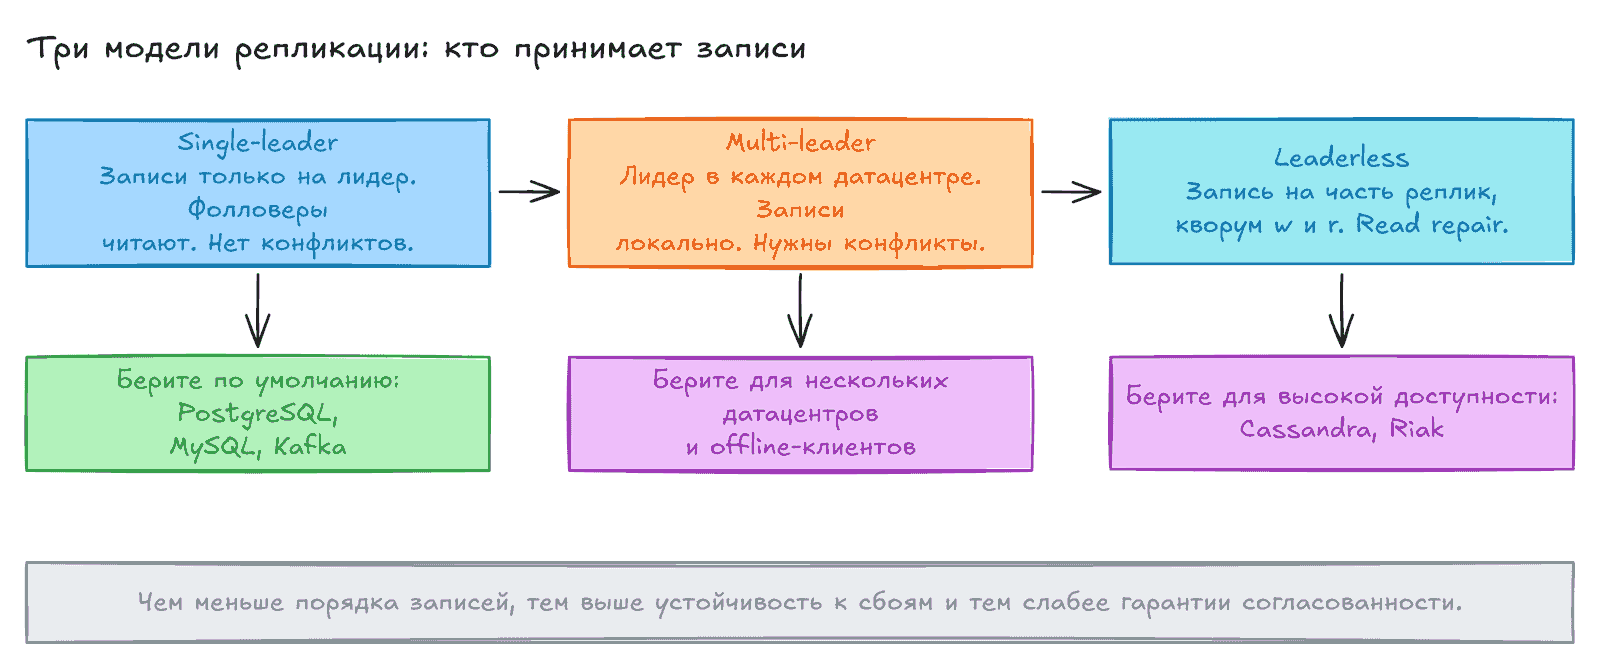
Зачем нужна репликация
Заголовок раздела «Зачем нужна репликация»- Держать данные ближе к пользователям (меньше latency).
- Работать при сбое части системы (доступность).
- Масштабировать чтение: читать можно с любой реплики.
Single-leader: лидер и фолловеры
Заголовок раздела «Single-leader: лидер и фолловеры»Одна реплика назначена лидером (leader, master, primary). Все записи идут на неё. Лидер отправляет поток изменений (replication log) фолловерам (followers, read replicas). Читать можно с любой реплики. Так работают PostgreSQL, MySQL, MongoDB, SQL Server AlwaysOn, а также Kafka.
Синхронная и асинхронная репликация
Заголовок раздела «Синхронная и асинхронная репликация»| Режим | Плюс | Минус |
|---|---|---|
| Синхронная | Фолловер точно имеет свежую копию | Если фолловер не отвечает, записи встают |
| Асинхронная | Лидер пишет, даже если фолловеры отстали | Если лидер потерян, неотправленные записи теряются |
| Semi-synchronous | Один фолловер синхронный, остальные асинхронные: данные есть минимум на двух узлах | Сложнее настройка |
Все фолловеры синхронными делать нельзя: один сбой остановит всю систему. Поэтому часто используют асинхронную репликацию.
Новый фолловер и сбои
Заголовок раздела «Новый фолловер и сбои»- Новый фолловер: берут consistent snapshot лидера, копируют его, затем фолловер догоняет изменения с позиции снимка (
log sequence numberв PostgreSQL, binlog coordinates в MySQL). - Сбой фолловера: он помнит последнюю обработанную транзакцию и догоняет лидера (catch-up recovery).
- Сбой лидера: нужен failover. Шаги: определить отказ (обычно по timeout), выбрать нового лидера, перенаправить клиентов.
Риски failover:
- Новый лидер мог не получить часть записей. Их обычно отбрасывают, это нарушает durability.
- Расхождение с внешними системами. В инциденте GitHub новый лидер MySQL повторно выдал первичные ключи, которые уже были в Redis. Часть данных увидели не те пользователи.
split brain: два узла считают себя лидером. Данные теряются или портятся.- Выбор timeout. Длинный дольше восстанавливает. Короткий вызывает лишние failover при пике нагрузки.
Поэтому часть команд делает failover вручную.
Форматы replication log
Заголовок раздела «Форматы replication log»| Метод | Как работает | Проблема |
|---|---|---|
| Statement-based | Лидер шлёт SQL-команды | NOW(), RAND(), триггеры, порядок выполнения дают разные результаты |
| WAL shipping | Шлют байты write-ahead log | Привязка к storage engine и версии БД. Обновление без простоя сложно |
| Logical (row-based) log | Записи на уровне строк | Независим от storage engine. Удобно читать снаружи |
| Trigger-based | Триггеры пишут изменения в таблицу, их читает приложение | Выше накладные расходы, больше ошибок. Гибко: частичная репликация, другая БД |
Logical log легко отдать во внешние системы: в data warehouse, индексы, кэши. Это change data capture (CDC), тема главы 11.
Replication lag и его аномалии
Заголовок раздела «Replication lag и его аномалии»При асинхронной репликации чтение с фолловера может вернуть старые данные. Это eventual consistency: если писать перестать, реплики сойдутся. Но срок не определён. Отставание бывает от долей секунды до минут.
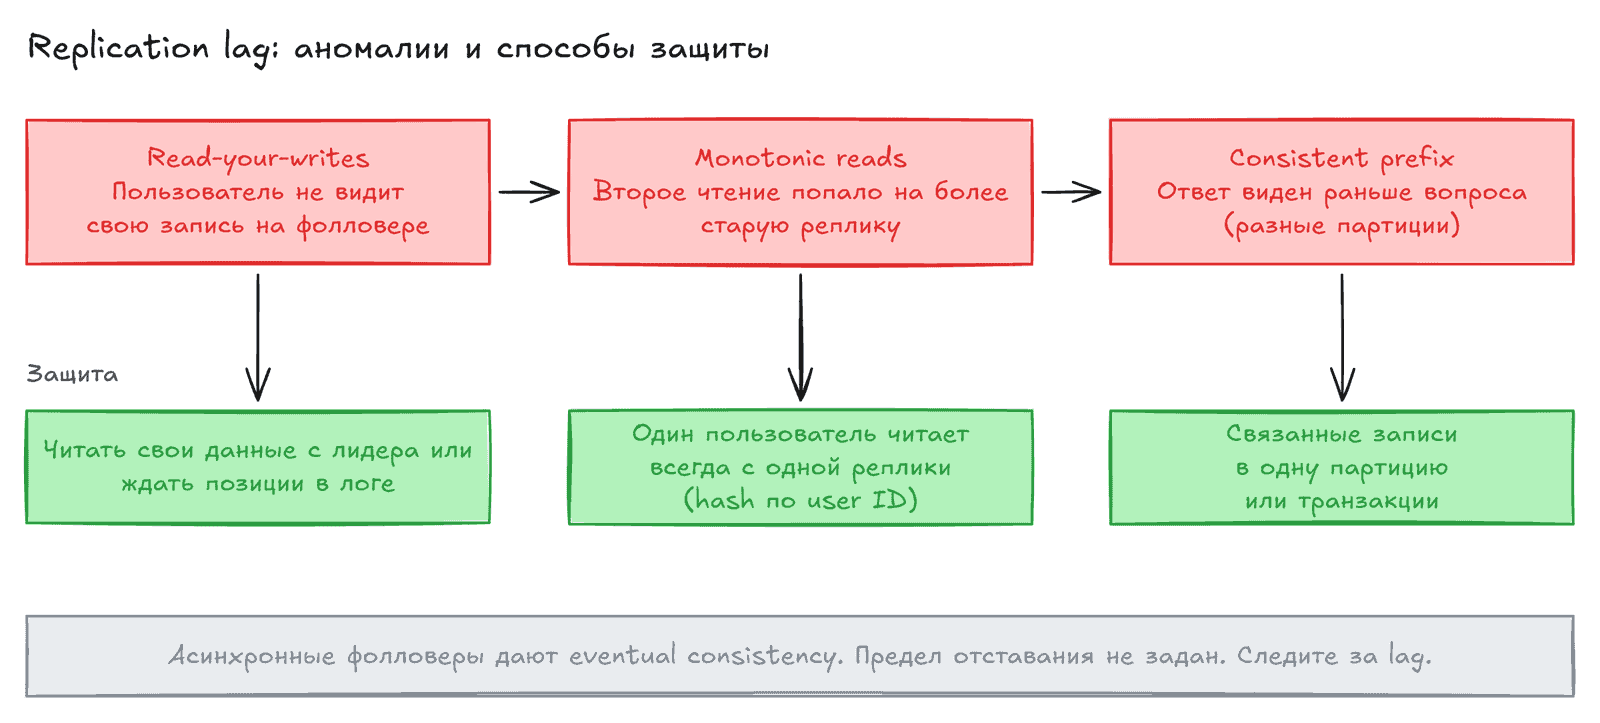
| Гарантия | Что нарушается без неё | Как достичь |
|---|---|---|
| Read-your-writes (read-after-write) | Пользователь не видит свою только что сделанную запись | Читать изменяемые данные с лидера. Читать с лидера после недавней записи. Запоминать timestamp или позицию в логе |
| Monotonic reads | Данные «возвращаются в прошлое» при чтении с разных реплик | Привязать пользователя к одной реплике (hash от user ID) |
| Consistent prefix reads | Следствие видно раньше причины | Писать связанные данные в одну партицию. Либо использовать транзакции |
Для нескольких устройств одного пользователя и нескольких датацентров всё сложнее: метаданные нужно хранить централизованно. Книга советует заранее продумать, что будет при lag в минуты и часы. Нельзя делать вид, что репликация синхронная. Транзакции нужны, чтобы эти гарантии давала БД, а не приложение.
Multi-leader replication
Заголовок раздела «Multi-leader replication»Несколько узлов принимают записи и пересылают их друг другу. В одном датацентре это редко оправдано.
| Сценарий | Почему multi-leader |
|---|---|
| Несколько датацентров | Запись локальна, задержка между датацентрами скрыта. Датацентр работает независимо при сбое сети |
| Клиенты offline (календарь, CouchDB) | Каждое устройство имеет локальную БД-лидер. Синхронизация идёт позже |
| Совместное редактирование | Мелкие изменения без блокировок. Иначе нужен lock, то есть single-leader |
Минус главный: конфликты записей. Два пользователя меняют заголовок страницы на B и C на разных лидерах. Конфликт замечают позже и асинхронно. Многие считают multi-leader «опасной территорией». Автоинкремент, триггеры и ограничения целостности работают с ним плохо.
Как справляться с конфликтами
Заголовок раздела «Как справляться с конфликтами»- Избегать: все записи одной сущности идут через одного лидера (например, домашний датацентр пользователя). Ломается при смене лидера.
- Сходиться (convergent): все реплики должны прийти к одному значению. Способы:
last write wins(LWW, по timestamp), приоритет реплики (обе теряют данные), слияние значений, сохранение обеих версий для приложения. - Свой код: обработчик при записи (Bucardo) или при чтении (CouchDB).
- Автоматические структуры: CRDT, mergeable persistent data structures, operational transformation.
Пример подвоха: в корзине Amazon сохранялись добавленные товары, но не удаления. Удалённые товары появлялись снова.
Топологии
Заголовок раздела «Топологии»Три формы: circular, star и all-to-all. В circular и star один упавший узел рвёт путь репликации. В all-to-all сообщения могут обгонять друг друга: update придёт раньше insert. Timestamp не помогает, часы не синхронны. Нужны version vectors. Во многих системах причинный порядок не обеспечен (PostgreSQL BDR, Tungsten Replicator).
Leaderless replication
Заголовок раздела «Leaderless replication»Нет лидера. Клиент (или координатор) шлёт запись на несколько реплик. Идея из Dynamo (Amazon). Так работают Riak, Cassandra, Voldemort. Failover не нужен.
- Read repair: клиент читает с нескольких реплик и записывает свежее значение на устаревшую.
- Anti-entropy: фоновый процесс сравнивает реплики и копирует недостающее, в любом порядке.
Кворумы
Заголовок раздела «Кворумы»Если n реплик, запись подтверждают w узлов, чтение идёт с r узлов. При w + r > n читаемые узлы пересекаются с записанными. Обычно n нечётное (3 или 5), w = r = (n+1)/2. Для редких записей и частых чтений: w = n, r = 1. Но тогда один сбой блокирует запись.
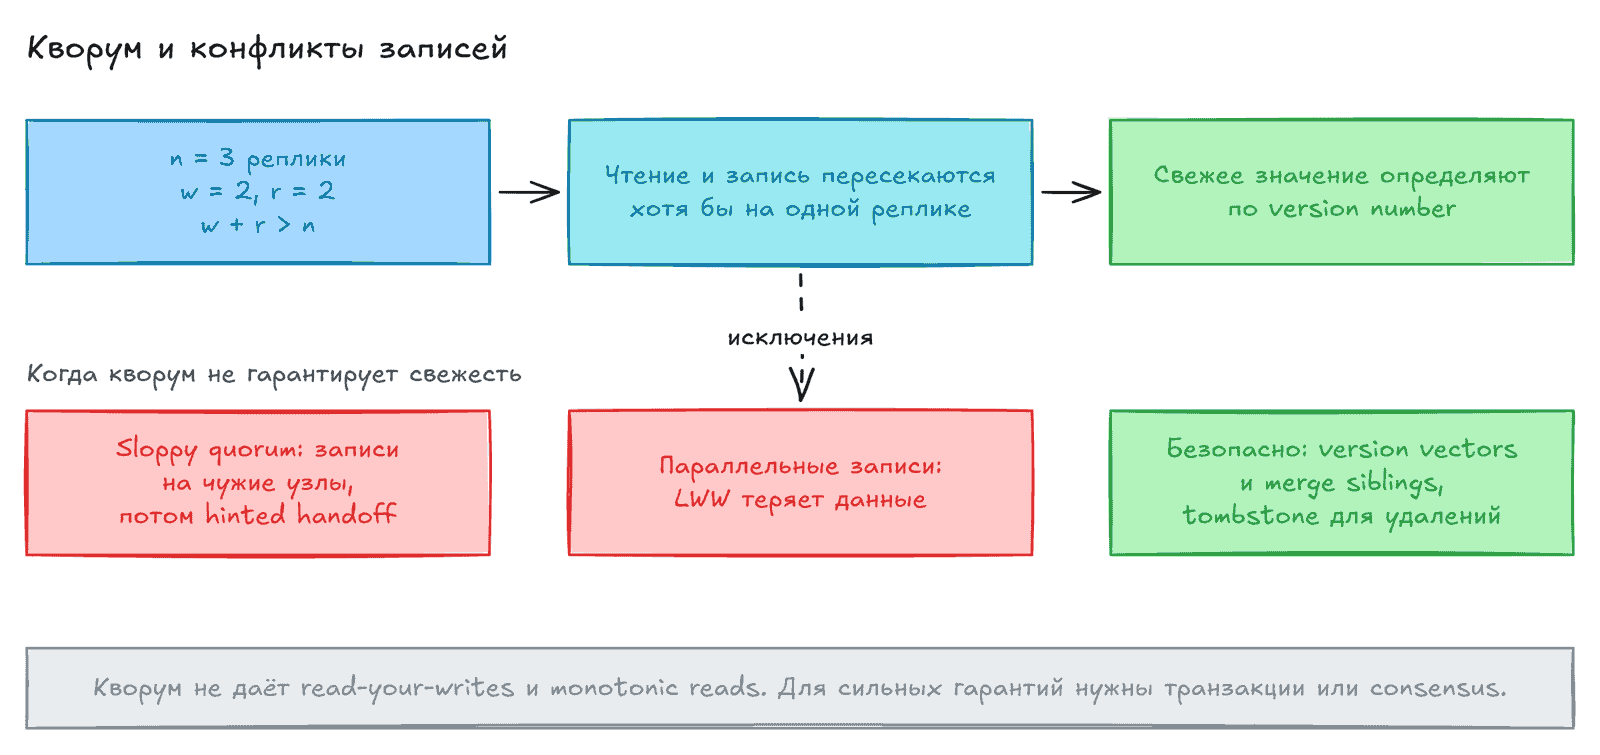
Кворум не абсолютная гарантия. Устаревшее значение возможно, если:
- используется sloppy quorum;
- записи параллельны, а победитель выбран по timestamp (LWW);
- запись идёт одновременно с чтением;
- запись прошла менее чем на
wузлах и не была откатана; - узел с новым значением восстановлен из старой копии.
Гарантий read-your-writes и monotonic reads кворум не даёт.
Sloppy quorum и hinted handoff. Если нужные узлы недоступны, запись принимают другие доступные узлы. Позже они передают её «домашним» узлам (hinted handoff). Это повышает доступность записи, но это уже не кворум в строгом смысле. По умолчанию sloppy quorum включён в Riak, выключен в Cassandra и Voldemort.
Мониторинг. В leader-based системах lag считают как разницу позиций в логе. В leaderless порядка нет, поэтому метрики staleness трудно получить. Без anti-entropy редко читаемые значения могут быть очень старыми.
Несколько датацентров. Cassandra считает n по всем датацентрам, но ждёт кворум в локальном. Riak держит n внутри одного датацентра, между ними репликация асинхронная.
Параллельные записи
Заголовок раздела «Параллельные записи»В leaderless-базах события приходят в разном порядке на разных узлах. Если просто перезаписывать, реплики разойдутся навсегда.
- LWW: побеждает больший timestamp. Остальные записи молча теряются. Годится для кэша или ключей, которые пишут один раз (UUID в Cassandra).
- Happens-before: операция A предшествует B, если B знает об A или зависит от неё. Если ни одна не знает о другой, они concurrent. Физическое время не важно.
- Алгоритм с версиями: сервер хранит номер версии ключа. Клиент перед записью читает ключ, затем записывает слитое значение с версией, которую прочитал. Сервер перезаписывает значения с этой версией и ниже, а более новые сохраняет как concurrent (siblings).
- Merge siblings: например, объединение корзин. Для удалений нужен
tombstone(маркер удаления), иначе удалённое вернётся. CRDT в Riak делают слияние автоматически. - Version vectors: версия на каждую реплику и ключ. Позволяют безопасно читать с одной реплики и писать в другую. Dotted version vector используется в Riak 2.0.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Replica | Узел с копией данных |
| Leader / follower | Узел, принимающий записи / узел, применяющий его лог |
| Replication log | Поток изменений от лидера к фолловерам |
| Failover | Замена упавшего лидера на фолловера |
| Split brain | Два узла считают себя лидером |
| Replication lag | Отставание фолловера от лидера |
| Eventual consistency | Реплики сойдутся, если записи прекратятся. Срок не определён |
| Read-your-writes | Пользователь видит свои записи |
| Monotonic reads | Чтения не идут назад во времени |
| Consistent prefix reads | Записи видны в причинном порядке |
| LWW | Last write wins: побеждает запись с большим timestamp |
Quorum (w + r > n) | Условие пересечения узлов записи и чтения |
| Sloppy quorum | Кворум с узлами вне «домашнего» набора |
| Hinted handoff | Возврат записей домашним узлам после сбоя |
| Read repair / anti-entropy | Исправление устаревших реплик при чтении / в фоне |
| Siblings | Конкурирующие версии одного ключа |
| Tombstone | Маркер удаления с версией |
| Version vector | Набор версий по всем репликам |
| CRDT | Структура данных с автоматическим слиянием |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- CDC строится на replication log. Читайте logical log (binlog, logical decoding), а не копируйте таблицы. Следите за позицией в логе.
- Реплики для аналитики отстают. Не стройте на них отчёты, которым нужна точность «прямо сейчас». Измеряйте lag и добавьте алерт.
- После failover проверьте данные. Потерянные асинхронные записи и повторно выданные ключи ломают пайплайны и внешние системы.
- Не ждите гарантий от eventual consistency. Если пользователь должен видеть свою запись, читайте с лидера или привяжите сессию к реплике.
- Остерегайтесь LWW. При параллельных записях данные теряются молча. Для важных данных нужен merge или неизменяемые записи с уникальным ключом.
- Multi-leader и leaderless: читайте документацию и тестируйте. Проверяйте реальные гарантии на своей версии.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем semi-synchronous репликация лучше полностью синхронной и полностью асинхронной?
- Какие три аномалии даёт replication lag и как защититься от каждой?
- Почему
w + r > nне гарантирует свежее чтение в Dynamo-style базах? - Как сервер понимает, что две записи конкурентны, и что делать с siblings?
Предыдущая: Кодирование и эволюция схем. Следующая: Партиционирование.