

Fundamentals of Data Engineering, глава 1: Что такое data engineering
Главная мысль: data engineering это создание и поддержка систем, которые превращают сырые данные в качественную информацию для аналитики и ML. Инженер отвечает за весь путь данных, а не за одну технологию.
Что такое data engineering
Заголовок раздела «Что такое data engineering»Определений много. Авторы выделяют общее: инженер получает данные, хранит их и готовит для аналитиков и data scientists.
Их определение:
- Data engineering это разработка, внедрение и поддержка систем и процессов, которые берут сырые данные и дают из них согласованную информацию.
- Это пересечение шести тем: security, data management, DataOps, data architecture, orchestration, software engineering.
- Data engineer управляет data engineering lifecycle: от получения данных из источников до выдачи для аналитики и ML.
Lifecycle состоит из пяти стадий: Generation, Storage, Ingestion, Transformation, Serving. Шесть тем выше названы undercurrents. Подробно они разобраны в главе 2.
Как развивалась профессия
Заголовок раздела «Как развивалась профессия»| Период | Что происходило |
|---|---|
| 1980-2000 | Data warehouse, реляционные БД, SQL, MPP. Kimball и Inmon описали методы моделирования. Роли: BI engineer, ETL developer |
| Начало 2000-х | Рост веб-компаний. Статьи Google про GFS и MapReduce. Hadoop (2006). AWS открывает облако |
| 2000-2010-е | Эра big data. Hadoop, Hive, Spark, Cassandra. Переход от batch к event streaming |
| 2020-е | Упрощение и managed сервисы. Инженер работает выше по уровню абстракции |
Big data стало обычным делом и перестало быть отдельным термином. Сложные кластеры заменили managed сервисы. Поэтому big data engineer стал просто data engineer.
Сегодня инженер всё чаще занят темами из undercurrents: безопасность, качество, governance, приватность (GDPR, CCPA), архитектура. Это называют data lifecycle engineer.
Data engineering и data science
Заголовок раздела «Data engineering и data science»Data engineering стоит upstream от data science. Инженеры дают данные, а data scientists превращают их в результат.
- Data Science Hierarchy of Needs (Monica Rogati): сначала сбор, хранение, очистка данных, потом аналитика и ML.
- Data scientists тратят много времени на подготовку данных. Хороший data engineer автоматизирует эту работу.
- Авторы считают data engineering равным по важности data science.
Навыки и задачи
Заголовок раздела «Навыки и задачи»Data engineer управляет балансом шести осей: cost, agility, scalability, simplicity, reuse, interoperability.
Что инженер обычно не делает: не строит ML-модели, не делает дашборды, не анализирует данные, не считает KPI, не пишет прикладное ПО. Но он должен понимать эти области.
Бизнес-навыки
Заголовок раздела «Бизнес-навыки»- Общаться с техническими и нетехническими людьми.
- Собирать и уточнять требования.
- Понимать культуру Agile, DevOps, DataOps. Это не только инструменты.
- Контролировать расходы: time to value, total cost of ownership (TCO), opportunity cost.
- Постоянно учиться и отличать полезное от моды.
Технические навыки
Заголовок раздела «Технические навыки»| Язык | Зачем нужен |
|---|---|
| SQL | Основной интерфейс к базам и data lake. Снова стал главным языком данных |
| Python | Связь между data engineering и data science. Airflow, pandas, PySpark |
| JVM (Java, Scala) | Spark, Hive, Druid. Быстрее Python, доступ к низкому уровню |
| bash | Скрипты, работа с файлами, вызов из оркестратора |
Нужны и вторичные языки: R, JavaScript, Go, Rust, C#. Это зависит от компании. Совет авторов: учите основы, которые не меняются, и следите за новым.
Зрелость данных
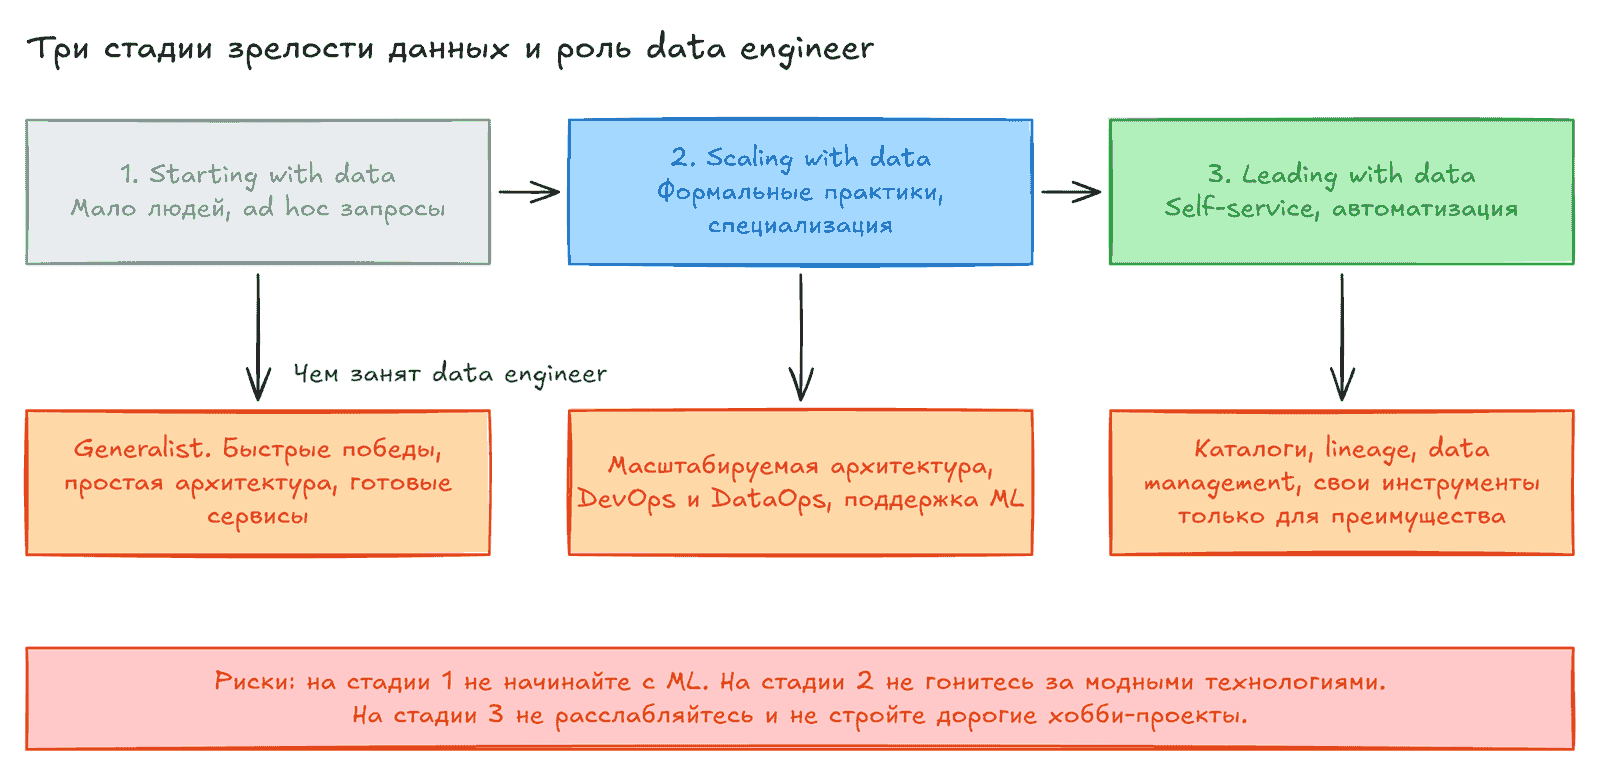
Заголовок раздела «Зрелость данных»Data maturity это уровень использования данных в компании. Он не зависит от возраста или выручки.
| Стадия | Что делает инженер | На что смотреть |
|---|---|---|
| 1. Starting with data | Generalist. Выбирает архитектуру, строит основу, делает отчёты | Не начинайте с ML. Быстрые победы создают technical debt. Не работайте в изоляции |
| 2. Scaling with data | Формальные практики, масштабируемая архитектура, DevOps и DataOps | Не берите модные технологии без пользы. Узкое место это команда, а не кластер |
| 3. Leading with data | Автоматизация, каталоги, lineage, custom tools для преимущества | Не расслабляйтесь. Не тратьте время на дорогие хобби-проекты |
Общее правило: избегайте undifferentiated heavy lifting (тяжёлой работы без отличия от других). Пишите свой код только там, где он даёт конкурентное преимущество.
Type A и Type B
Заголовок раздела «Type A и Type B»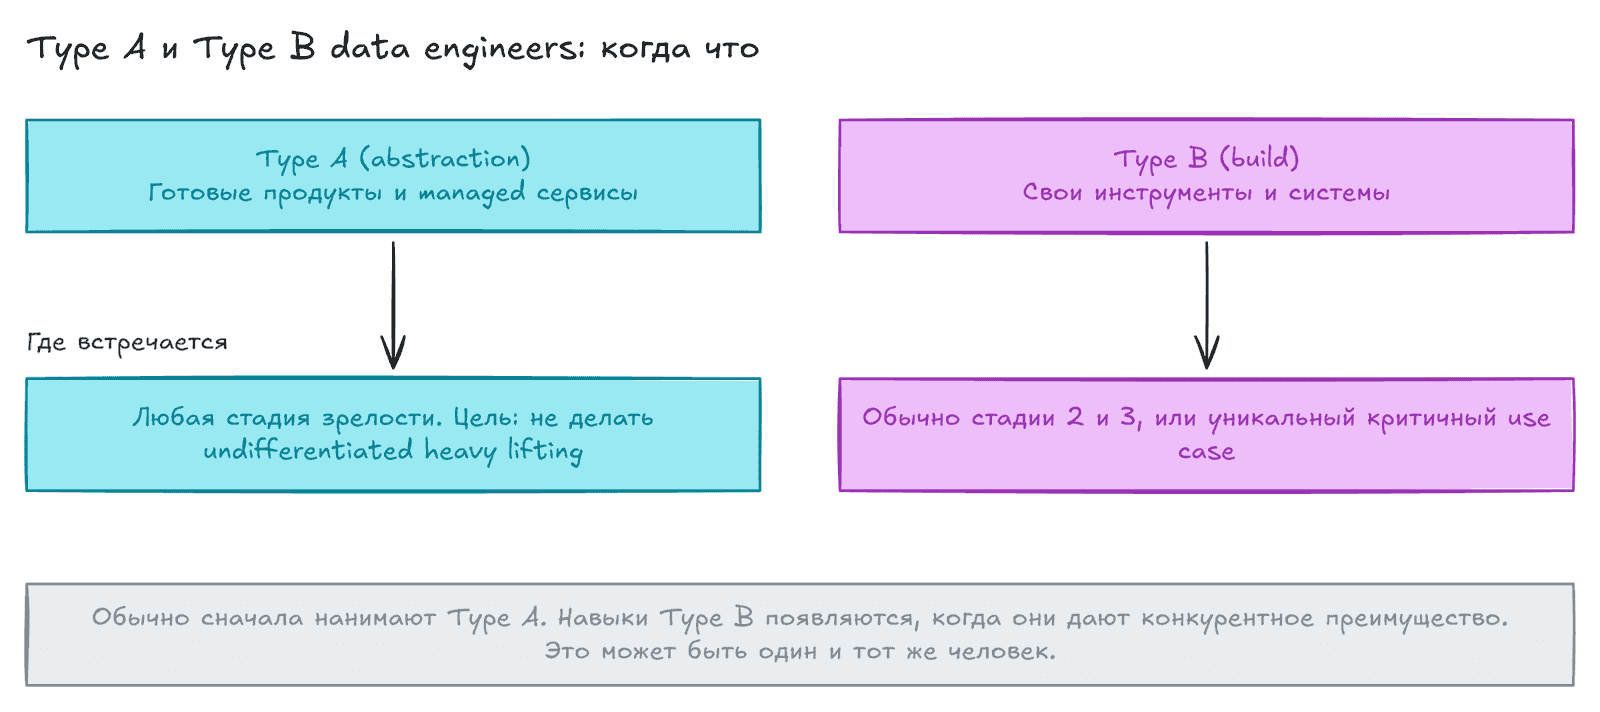
- Type A: использует готовые продукты и managed сервисы. Держит архитектуру простой.
- Type B: строит свои инструменты. Нужен, когда это даёт конкурентное преимущество.
Часто первым нанимают Type A, а навыки Type B появляются позже.
С кем работает data engineer
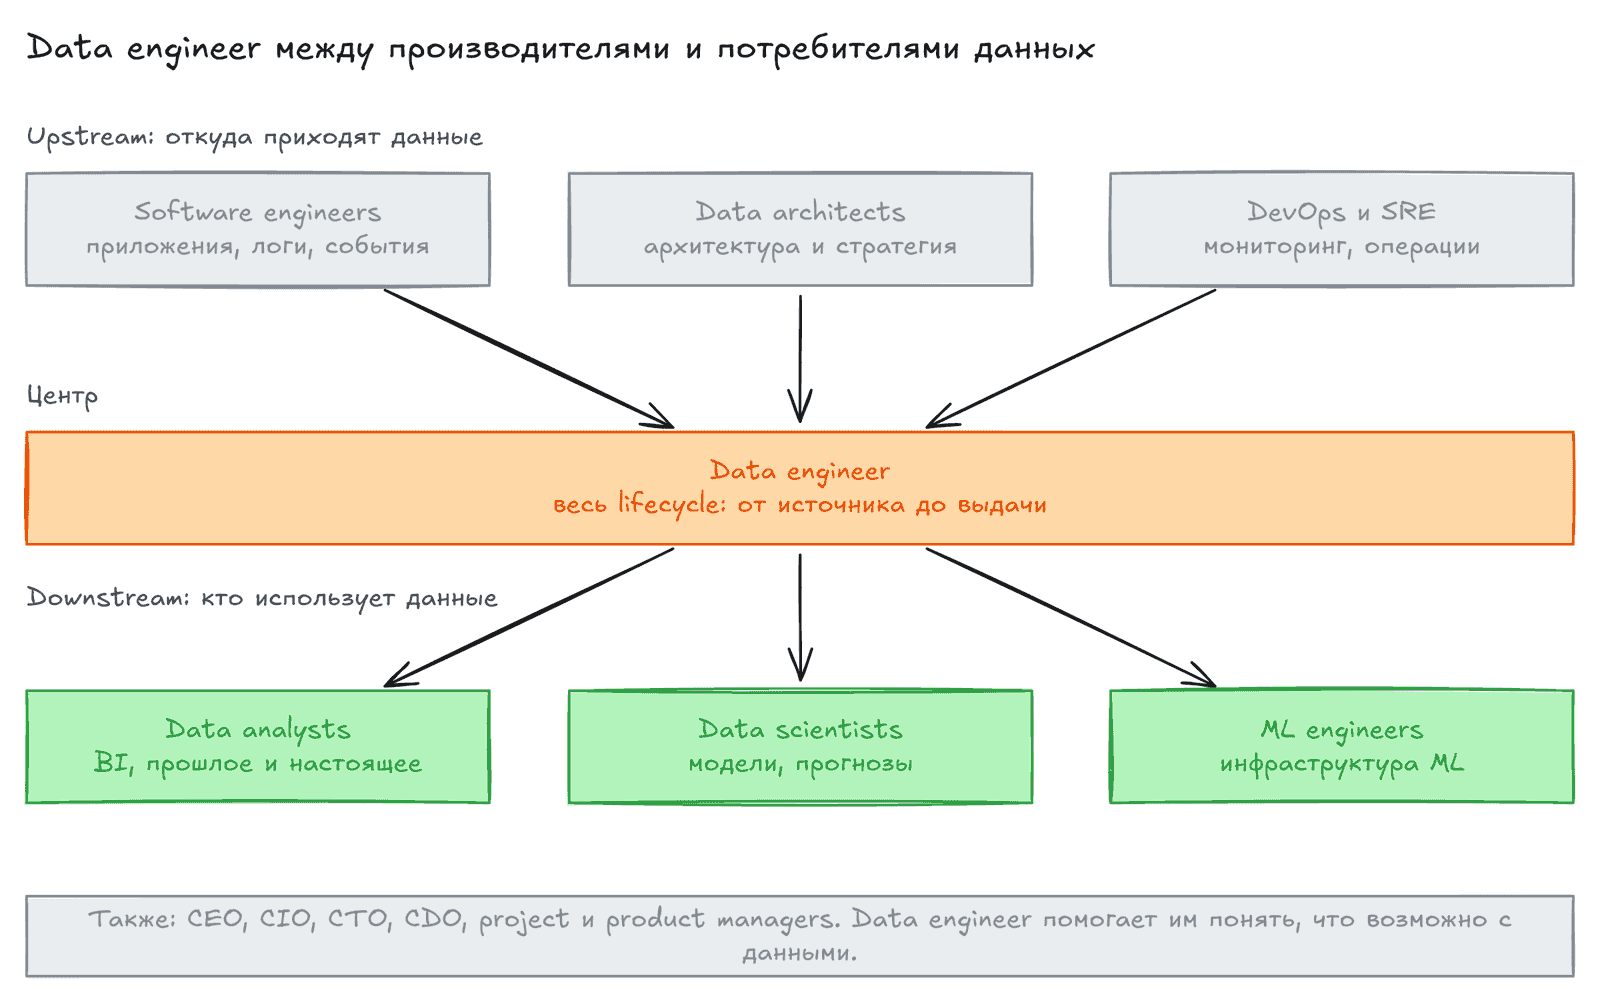
Заголовок раздела «С кем работает data engineer»Internal-facing и external-facing. Internal-facing инженер делает данные для BI, отчётов, ML. External-facing инженер работает с данными клиентских приложений. Там выше concurrency и сложнее безопасность, особенно при multitenancy (данные многих клиентов в одной таблице). Часто роли смешаны.
Upstream:
- Data architects: проектируют общую архитектуру и политики.
- Software engineers: создают приложения, логи и события. Нужно заранее договариваться о формате.
- DevOps и SRE: производят данные мониторинга.
Downstream:
- Data scientists: строят модели. Им нужна автоматизация и путь в production.
- Data analysts: смотрят в прошлое и настоящее через SQL и BI. Их знание данных помогает качеству.
- ML engineers: обучают модели и поддерживают инфраструктуру. Граница с data engineering размыта.
Руководство. Инженер взаимодействует с CEO, CIO, CTO, CDO, CAO. Он показывает, какие данные доступны и что возможно. Также он работает с project и product managers: сроки, приоритеты, data products.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Data engineering lifecycle | Пять стадий пути данных: от источника до выдачи |
| Undercurrents | Сквозные темы, которые поддерживают все стадии |
| Big data | Эпоха кластеров Hadoop. Сегодня термин почти не нужен |
| Modern data stack | Набор готовых open source и сторонних продуктов |
| Data maturity | Уровень использования данных в компании |
| Undifferentiated heavy lifting | Тяжёлая работа, которая не даёт преимущества |
| Type A / Type B | Инженер на готовых сервисах или строящий свои системы |
| Upstream / downstream | Источники данных и потребители данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Определите стадию зрелости своей компании. От неё зависят задачи и инструменты.
- Не начинайте с ML, пока нет основы: сбор, хранение, качество данных.
- Берите готовые сервисы. Свой код нужен только для конкурентного преимущества.
- Договаривайтесь с software engineers о формате данных до запуска проекта.
- Развивайте навыки общения и контроля затрат. Успех чаще зависит от них, чем от технологии.
- Хорошо знайте SQL и Python. Для open source на JVM пригодится Java или Scala.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Из каких шести тем состоит определение data engineering в книге?
- Почему термин big data почти исчез, и как это изменило роль инженера?
- Чем отличаются стадии 1, 2 и 3 зрелости данных? Какие ошибки типичны для каждой?
- Когда в команде нужен Type A, а когда Type B data engineer?
Следующая: Глава 2: Жизненный цикл.