

Fundamentals of Data Engineering, глава 2: Жизненный цикл
Главная мысль: работа data engineer это пять стадий жизненного цикла данных и шесть сквозных процессов (undercurrents). Технологии меняются, эта модель остаётся.
Что такое lifecycle
Заголовок раздела «Что такое lifecycle»Lifecycle показывает путь данных от источника до потребителя.
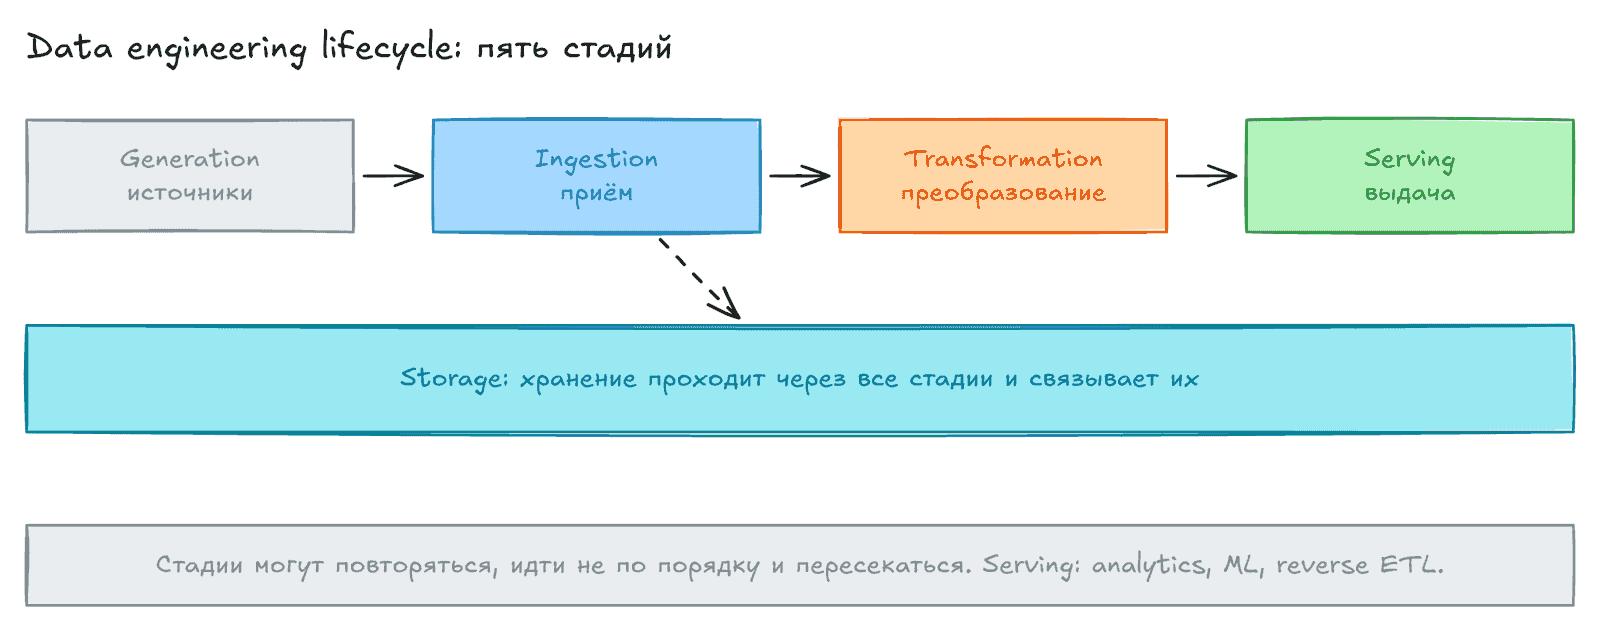
- Стадии: Generation, Storage, Ingestion, Transformation, Serving.
- Storage проходит через весь цикл. Данные хранятся на многих шагах.
- Стадии не всегда идут по порядку. Они могут повторяться и переплетаться.
- Data engineering lifecycle это часть полного data lifecycle. Он охватывает стадии, которыми управляет инженер.
Generation: источники данных
Заголовок раздела «Generation: источники данных»Source system это место, откуда данные приходят: база приложения, IoT-устройства, очередь сообщений. Инженер обычно не владеет источником. Поэтому нужен контакт с владельцами: они могут сменить схему или БД и сломать pipeline.
Что выяснить об источнике:
| Вопрос | Зачем |
|---|---|
| Как данные хранятся и как долго | Данные могут быстро удаляться |
| Скорость генерации | События в секунду, гигабайты в час |
| Качество и ошибки | Nulls, дубликаты, опоздавшие данные |
| Схема и её изменения | Как сообщают об изменениях |
| Snapshot или CDC | Как отслеживаются изменения состояния |
| Нагрузка на источник | Не замедлят ли запросы приложение |
Schema: бывает schemaless (схему задаёт приложение при записи) и fixed schema (схему задаёт БД). Schemaless не значит «без схемы». В обоих случаях схема меняется со временем, и это главная сложность.
Storage: хранение
Заголовок раздела «Storage: хранение»Выбор хранилища влияет на все стадии. Это одна из самых сложных стадий: облачные архитектуры используют несколько систем, а многие хранилища умеют ещё и считать.
Что проверить:
- Хватает ли скорости записи и чтения.
- Не станет ли хранилище узким местом.
- Используете ли вы его правильно. Частые случайные обновления в object storage это antipattern.
- Выдержит ли оно рост объёма.
- Собираются ли metadata, lineage, изменения схемы.
- Как соблюдаются регуляции и data sovereignty (где хранить данные).
Температура данных зависит от частоты доступа:
| Тип | Доступ | Где хранить |
|---|---|---|
| Hot | Много раз в день или секунду | Быстрое хранилище |
| Lukewarm | Раз в неделю или месяц | Среднее по цене |
| Cold | Редко, для compliance или аварий | Архив: дёшево хранить, дорого читать |
Универсального хранилища нет. У каждого свои trade-offs.
Ingestion: приём данных
Заголовок раздела «Ingestion: приём данных»Источники и ingestion чаще всего становятся узким местом цикла. Сбой здесь влияет на все следующие стадии.
Вопросы к ingestion: зачем нужны данные, можно ли использовать их повторно, надёжно ли они приходят, куда идут, как часто, в каком объёме и формате, годны ли для использования сразу.
Batch и streaming
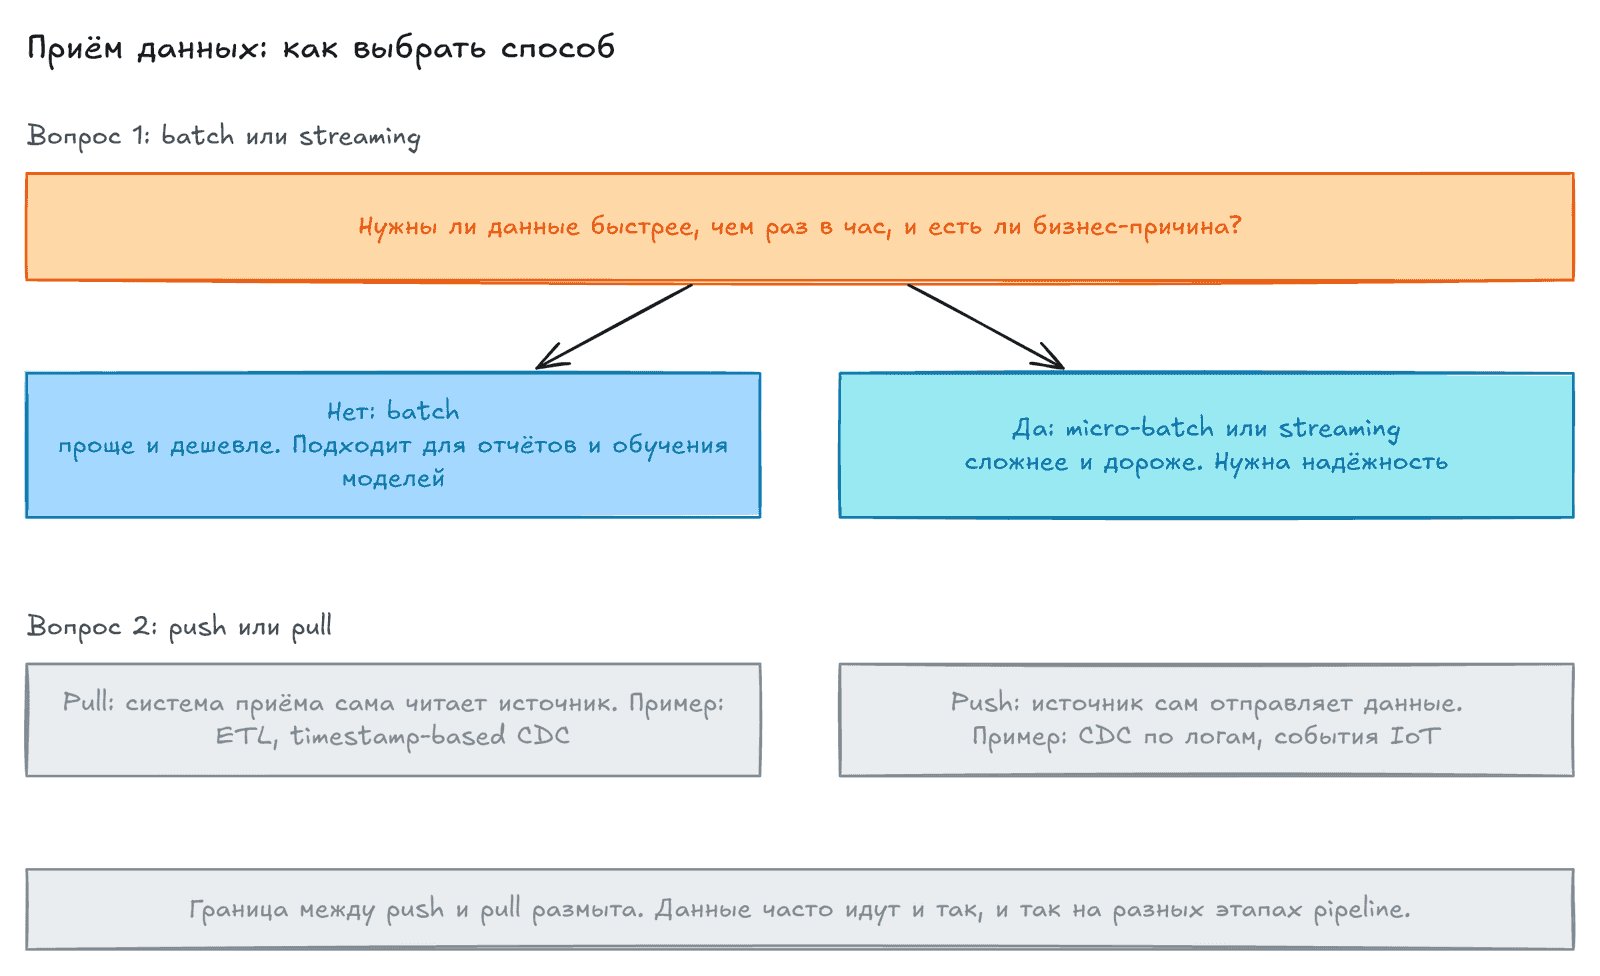
Заголовок раздела «Batch и streaming»- Почти все данные по природе являются потоком. Batch это удобный способ обработать поток большими частями.
- Batch идёт по расписанию или при достижении размера. Он задаёт нижнюю границу задержки.
- Streaming доставляет данные почти сразу (real-time задаётся по задаче).
- Micro-batch (например, каждую минуту) это компромисс.
Совет авторов: берите streaming только когда есть бизнес-причина. Он дороже и сложнее. Batch хорош для отчётов и обучения моделей.
Push и pull
Заголовок раздела «Push и pull»- Push: источник сам отправляет данные.
- Pull: система приёма читает источник.
- ETL использует pull. CDC по binary logs это push: БД пишет в логи, а система приёма читает логи без нагрузки на БД. Timestamp-based CDC это pull.
- Streaming часто идёт напрямую в endpoint через event-streaming платформу.
Transformation: преобразование
Заголовок раздела «Transformation: преобразование»Здесь данные начинают создавать ценность. Без transformation они лежат без пользы.
- Сразу после приёма: приведение типов, форматов, удаление плохих записей.
- Позже: изменение схемы, нормализация, агрегаты для отчётов, featurization для ML.
- Business logic часто задаётся в data modeling. Её нужно применять одинаково во всех преобразованиях.
- Преобразования бывают и в источнике, и в потоке (in flight), например enrichment.
Вопросы: какая стоимость и ROI, насколько преобразование простое и изолированное, какие бизнес-правила оно реализует.
Serving: выдача данных
Заголовок раздела «Serving: выдача данных»Данные имеют ценность, только когда их используют. Данные без потребителя это vanity project. Каждый проект должен иметь понятную цель.
| Тип | Суть | Особенность |
|---|---|---|
| Business intelligence | Описывает прошлое и настоящее через бизнес-логику | Self-service сложен: мешают качество и silos |
| Operational analytics | Данные в реальном времени для немедленных действий | Фокус на настоящем |
| Embedded analytics | Аналитика для клиентов SaaS | Высокая нагрузка. Клиент видит только свои данные |
| Machine learning | Обучение и работа моделей | Нужны качество, discoverability, ground truth без bias. Feature store |
| Reverse ETL | Результаты из хранилища возвращаются в SaaS и приложения | Примеры: Google Ads, CRM. Продукты Hightouch, Census |
Не начинайте с ML до основы. Сначала аналитика, потом ML. В embedded analytics утечка между клиентами это серьёзный сбой. Применяйте tenant-level security.
Undercurrents
Заголовок раздела «Undercurrents»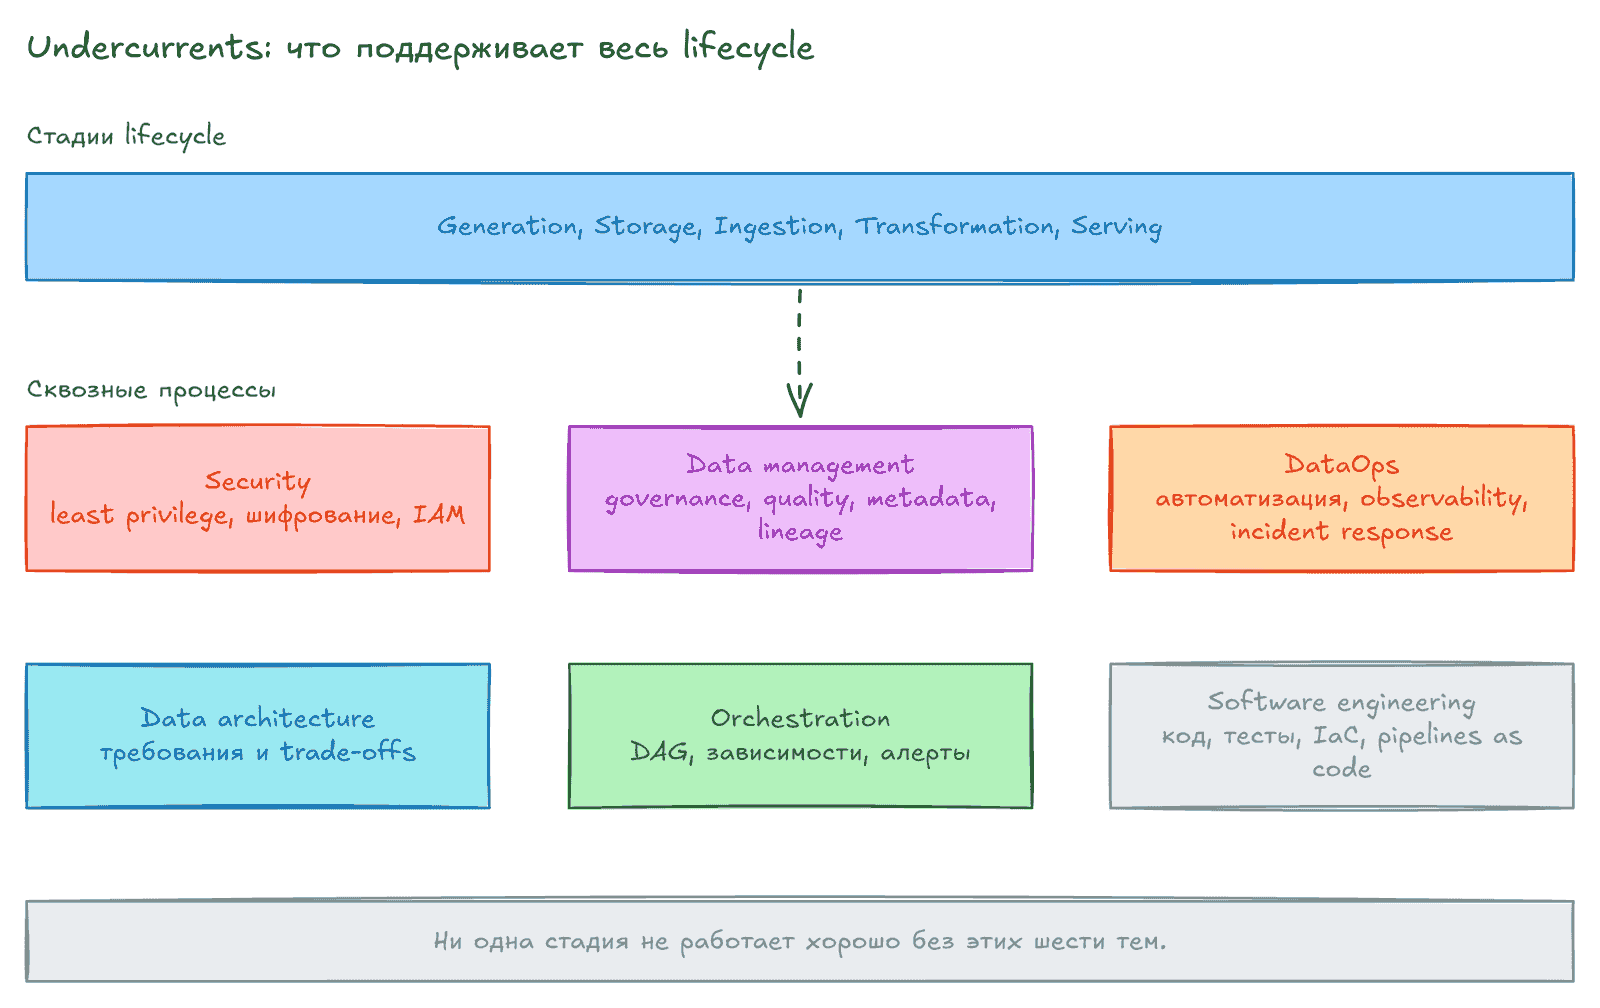
Security
Заголовок раздела «Security»- Принцип least privilege: давайте доступ только к нужным данным и только на нужное время. Выдача admin всем это антипаттерн.
- Самая слабая точка это люди. Нужна культура безопасности.
- Защита данных: encryption, tokenization, masking, access controls. Нужно знать IAM, сетевую безопасность, политики паролей.
Data management
Заголовок раздела «Data management»Это набор практик, которые раньше были только в больших компаниях. Сейчас они нужны всем.
| Область | Суть |
|---|---|
| Data governance | Качество, целостность, безопасность, удобство. Основа: discoverability, security, accountability |
| Metadata | Данные о данных. Типы: business, technical, operational, reference |
| Data accountability | Назначенный владелец отвечает за часть данных |
| Data quality | Три свойства: accuracy, completeness, timeliness |
| MDM | Согласованные определения сущностей (golden records) |
| Data modeling | Формат данных под задачу. Без него появляется data swamp |
| Data lineage | История данных и зависимостей. Помогает с отладкой и удалением по запросу |
| Integration и interoperability | Интеграция инструментов, часто через API |
| Data lifecycle management | Архивация и удаление. GDPR и CCPA требуют права «быть забытым» |
| Ethics и privacy | Маскирование PII, учёт bias, соблюдение регуляций |
DataOps
Заголовок раздела «DataOps»DataOps применяет Agile, DevOps и statistical process control к данным. Это в первую очередь культура: коммуникация, итерации, обучение на ошибках.
Три технические опоры:
- Automation: version control, CI/CD, configuration as code. Путь зрелости: cron, затем оркестратор (Airflow, Dagster), затем автоматический деплой DAG с тестами.
- Observability и monitoring: плохие данные могут месяцами быть в отчётах. Нужны мониторинг, logging, alerting, tracing. Метод DODD похож на TDD.
- Incident response: быстро найти причину и исправить. Находите проблемы раньше бизнеса. Общение должно быть открытым и без поиска виноватых.
Начинать советуют с observability и monitoring, затем automation и incident response.
Data architecture
Заголовок раздела «Data architecture»Архитектура отражает текущие и будущие системы под долгосрочные потребности. Инженер собирает требования и проектирует захват и выдачу данных с учётом стоимости и простоты. Он не обязательно архитектор, но должен реализовывать проект и давать обратную связь. Подробности в главе 3.
Orchestration
Заголовок раздела «Orchestration»Orchestration координирует задания по расписанию с учётом зависимостей (обычно в виде DAG).
- Планировщик вроде cron знает только время. Оркестратор знает зависимости.
- Он следит за заданиями, шлёт алерты, хранит историю, делает backfill.
- Инструменты: Airflow (лидер), Dagster, Prefect, Luigi, Argo, Metaflow.
- Orchestration это batch-понятие. Для потоков есть streaming DAG, их сложнее строить.
Software engineering
Заголовок раздела «Software engineering»- Core data processing code: Spark, SQL, Beam. SQL это код. Нужны тесты: unit, regression, integration, end-to-end, smoke.
- Open source фреймворки: сначала посмотрите готовые, учтите TCO и opportunity cost.
- Streaming: joins и windowing сложнее, чем в batch.
- Infrastructure as code (IaC): инфраструктура задаётся кодом, это даёт версии и повторяемость.
- Pipelines as code: задачи и зависимости описаны кодом, обычно на Python.
- General-purpose problem solving: когда нет готового коннектора (Fivetran, Airbyte), нужно писать свой код.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Source system | Система, откуда данные поступают в lifecycle |
| Schema | Структура данных: таблицы и поля |
| Hot / cold data | Часто и редко используемые данные |
| Batch / streaming | Приём порциями или непрерывно |
| Push / pull | Источник отправляет или система читает |
| CDC | Change data capture: отслеживание изменений в БД |
| Reverse ETL | Возврат обработанных данных в источники и SaaS |
| Least privilege | Минимально нужные права доступа |
| Metadata | Данные о данных: определения, схема, операции |
| Data lineage | Путь данных и зависимости |
| DataOps | Практики DevOps и Agile для данных |
| DAG | Ориентированный граф задач без циклов |
| IaC | Infrastructure as code |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для каждого источника выясните скорость, схему, ошибки и нагрузку. Договоритесь с владельцем об изменениях.
- Выбирайте batch по умолчанию. Streaming берите, когда есть бизнес-причина.
- Давайте права по принципу least privilege. Не выдавайте admin всем.
- Добавьте мониторинг качества данных (accuracy, completeness, timeliness) и алерты до того, как проблему заметит бизнес.
- Замените cron на оркестратор, когда появились зависимости. Деплойте DAG автоматически и с тестами.
- Планируйте удаление и архивацию данных, в том числе по запросам GDPR и CCPA.
- Описывайте инфраструктуру и pipelines кодом и храните в version control.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Назовите пять стадий lifecycle. Почему Storage проходит через все стадии?
- Чем batch ingestion отличается от streaming и когда выбирать каждый?
- Какие три свойства определяют качество данных и какие три опоры есть у DataOps?
- Чем оркестратор отличается от планировщика cron?
Предыдущая: Fundamentals of Data Engineering, глава 1: Что такое data engineering. Следующая: Fundamentals of Data Engineering, глава 3: Хорошая архитектура данных.