

AI Engineering, глава 1: Введение в AI-приложения на foundation models
Главная мысль: Большие модели стали готовым сервисом. Поэтому появилась новая дисциплина, AI engineering. Она строит приложения на чужих моделях. Здесь меньше обучения моделей и больше адаптации, оценки качества и работы с продуктом.
Откуда взялся AI engineering
Заголовок раздела «Откуда взялся AI engineering»Одно слово описывает AI после 2020 года: масштаб. Модели стали очень большими. Это дало два эффекта.
- Модели умеют больше задач. Появилось больше приложений.
- Обучить такую модель могут единицы компаний. Нужны данные, вычисления и редкие навыки.
Из второго эффекта вырос model as a service. Несколько компаний обучают модель. Остальные берут её через API. Спрос вырос, а порог входа упал. Поэтому AI engineering растёт очень быстро.
От языковой модели к foundation model
Заголовок раздела «От языковой модели к foundation model»| Шаг | Что изменилось |
|---|---|
language model | Хранит статистику языка. Предсказывает, какой token будет следующим |
LLM | Та же идея, но модель очень большая. Размер измеряют числом параметров |
foundation model | Модель работает не только с текстом, но и с картинками, видео, звуком. Это multimodal модель |
Важные факты о языковых моделях:
- Базовая единица модели:
token. Это символ, слово или часть слова. Для GPT-4 один token в среднем равен примерно 3/4 слова. - Основной тип сегодня:
autoregressiveмодель. Она предсказывает следующий token по предыдущим. Так она пишет текст по одному token. - Ответ модели это предсказание по вероятностям. Он может быть неверным.
- Многие задачи можно записать как «продолжи текст»: перевод, классификация, суммаризация.
Почему модели смогли вырасти: self-supervision. Обычное обучение (supervised) требует размеченных данных. Разметка дорогая и медленная. При self-supervision метки берутся из самого текста. Каждое слово в предложении служит ответом для предыдущих слов. Текста в мире очень много. Значит, данных для обучения тоже много.
Foundation model также меняет сам подход. Раньше модели были узкими. Одна модель определяла тональность, другая переводила. Теперь одна модель решает много задач. Её можно подстроить под вашу задачу. Это проще, чем строить модель с нуля. Пример из книги: десять примеров и выходные вместо миллиона примеров и полугода.
Три способа адаптации, которые книга разбирает дальше:
prompt engineering: даёте инструкции и примеры.RAG: подключаете базу знаний, из которой модель берёт факты.finetuning: дообучаете модель на своих данных.
AI engineering и ML engineering
Заголовок раздела «AI engineering и ML engineering»AI engineering это создание приложений на готовых foundation models. ML engineering шире. Оно включает и обучение своих моделей. Автор не выбрал названия на Ops (MLOps, LLMOps). Работа здесь больше про адаптацию модели, чем про эксплуатацию. Это также выбор большинства практиков, которых он опросил.
Три главных отличия от классического ML:
| Что | Классический ML | AI engineering |
|---|---|---|
| Модель | Вы обучаете свою | Вы берёте чужую и адаптируете |
| Размер и цена | Модели меньше | Модели больше, дороже и медленнее. Важна оптимизация inference |
| Результат | Ограниченный набор ответов (spam или не spam) | Открытый текст. Нет полного списка правильных ответов. Оценка качества намного сложнее |
Что осталось прежним:
- Продукт должен решать бизнес-задачу. Бизнес-метрики связаны с метриками модели.
- Нужны системные эксперименты. Раньше меняли hyperparameters. Теперь меняют модель, prompt, способ поиска контекста, параметры sampling.
- Нужна обратная связь от пользователей и данные из production.
- Модели должны работать быстрее и дешевле.
Ещё одно изменение: порядок работы. Раньше сначала собирали данные и обучали модель, а продукт делали в конце. Теперь можно сделать продукт первым. Данные и модель улучшают, когда идея доказала пользу. Поэтому в AI engineering идут и full-stack разработчики. Они быстро делают demo и собирают отзывы.
Где применяют foundation models
Заголовок раздела «Где применяют foundation models»Автор изучил 205 open-source приложений и опыт около 50 компаний. Он выделил восемь групп.
| Группа | Примеры |
|---|---|
| Coding | Автодополнение кода, документация, перевод кода между языками, текст в SQL |
| Image и video | Редактирование фото, реклама, дизайн |
| Writing | Письма, маркетинг, отчёты, SEO |
| Education | Репетитор, проверка работ, адаптация материала под ученика |
| Conversational bots | Поддержка клиентов, product copilot, AI-компаньоны |
| Information aggregation | Суммаризация, talk-to-your-docs, исследование рынка |
| Data organization | Поиск по фото и документам, извлечение полей из PDF, управление знаниями |
| Workflow automation | Ввод данных, обработка заявок, планирование поездок, agents |
Что стоит запомнить:
- Одно приложение часто попадает в несколько групп. Например, бот может и общаться, и суммировать.
- Coding это самый популярный сценарий. AI хорош в простых и средних задачах и слабее в очень сложных.
- Компании чаще начинают с внутренних приложений. Риск меньше: приватность, закон, дорогие ошибки. Узкие задачи вроде классификации проще оценивать.
- Для data engineer важны три группы: текст в SQL, извлечение данных из неструктурированных файлов и поиск по документам.
agentэто AI, который планирует шаги и использует внешние инструменты. Подробнее в главе 6.
Как планировать AI-приложение
Заголовок раздела «Как планировать AI-приложение»Сделать красивое demo легко. Сделать прибыльный продукт трудно. Пройдите шаги по порядку.
1. Зачем вам это приложение. Причины по убыванию риска:
- Конкуренты с AI могут вас вытеснить.
- Вы теряете возможность поднять прибыль и производительность.
- Вы не знаете, как AI подойдёт, но не хотите отстать.
2. Строить или покупать. Если AI это угроза бизнесу, лучше строить внутри. Если AI нужен для эффективности, часто выгоднее купить.
3. Роль AI и человека. Три вопроса про функцию:
- Она критична или это дополнение? Чем важнее AI, тем выше требования к точности.
- Она реактивная (отвечает на запрос) или проактивная (сама предлагает)? Проактивные функции должны быть качественнее: пользователь о них не просил.
- Она статичная или динамичная? Динамичная учитывает отзывы пользователя постоянно.
Роль человека описывает идея human-in-the-loop. Подход Crawl-Walk-Run увеличивает автоматизацию по шагам:
| Шаг | Что делает AI |
|---|---|
| Crawl | Только подсказывает, решает человек |
| Walk | Работает напрямую с сотрудниками компании |
| Run | Работает с внешними клиентами |
Пример: бот поддержки. Сначала он предлагает ответы операторам. Если операторы принимают почти все ответы на простые вопросы без правок, бота пускают к клиентам на этих вопросах.
4. Защита продукта. Порог входа низкий и для конкурентов. Преимущество бывает в технологии, данных и дистрибуции. Технология у всех похожа. Дистрибуция обычно у больших компаний. Остаются данные: кто первым собрал данные об использовании, тот улучшает продукт быстрее.
5. Ожидания. Задайте метрики до разработки:
- Бизнес-метрики: доля автоматизированных обращений, скорость ответа, сэкономленный труд.
- Порог полезности: качество ответов, задержка (
TTFT,TPOT, общая latency), цена одного запроса. - Удовлетворённость пользователей. Бот может отвечать на больше сообщений, но не радовать клиентов.
6. Этапы. Сначала оцените готовые модели. Чем сильнее модель из коробки, тем меньше работы. Цели могут измениться после оценки. Учтите last mile: путь от 0 до 60% простой, от 60 до 100% очень долгий. LinkedIn потратил месяц на 80% и ещё четыре месяца на 95%.
7. Поддержка. Область быстро меняется. Модели дешевеют и улучшаются. Что было лучшим выбором, через три месяца может стать худшим. Заменить API модели просто. Но у каждой модели свои особенности, поэтому prompts и данные придётся править. Нужны версии и оценка. Ещё есть риски закона и интеллектуальной собственности.
AI-стек: три слоя
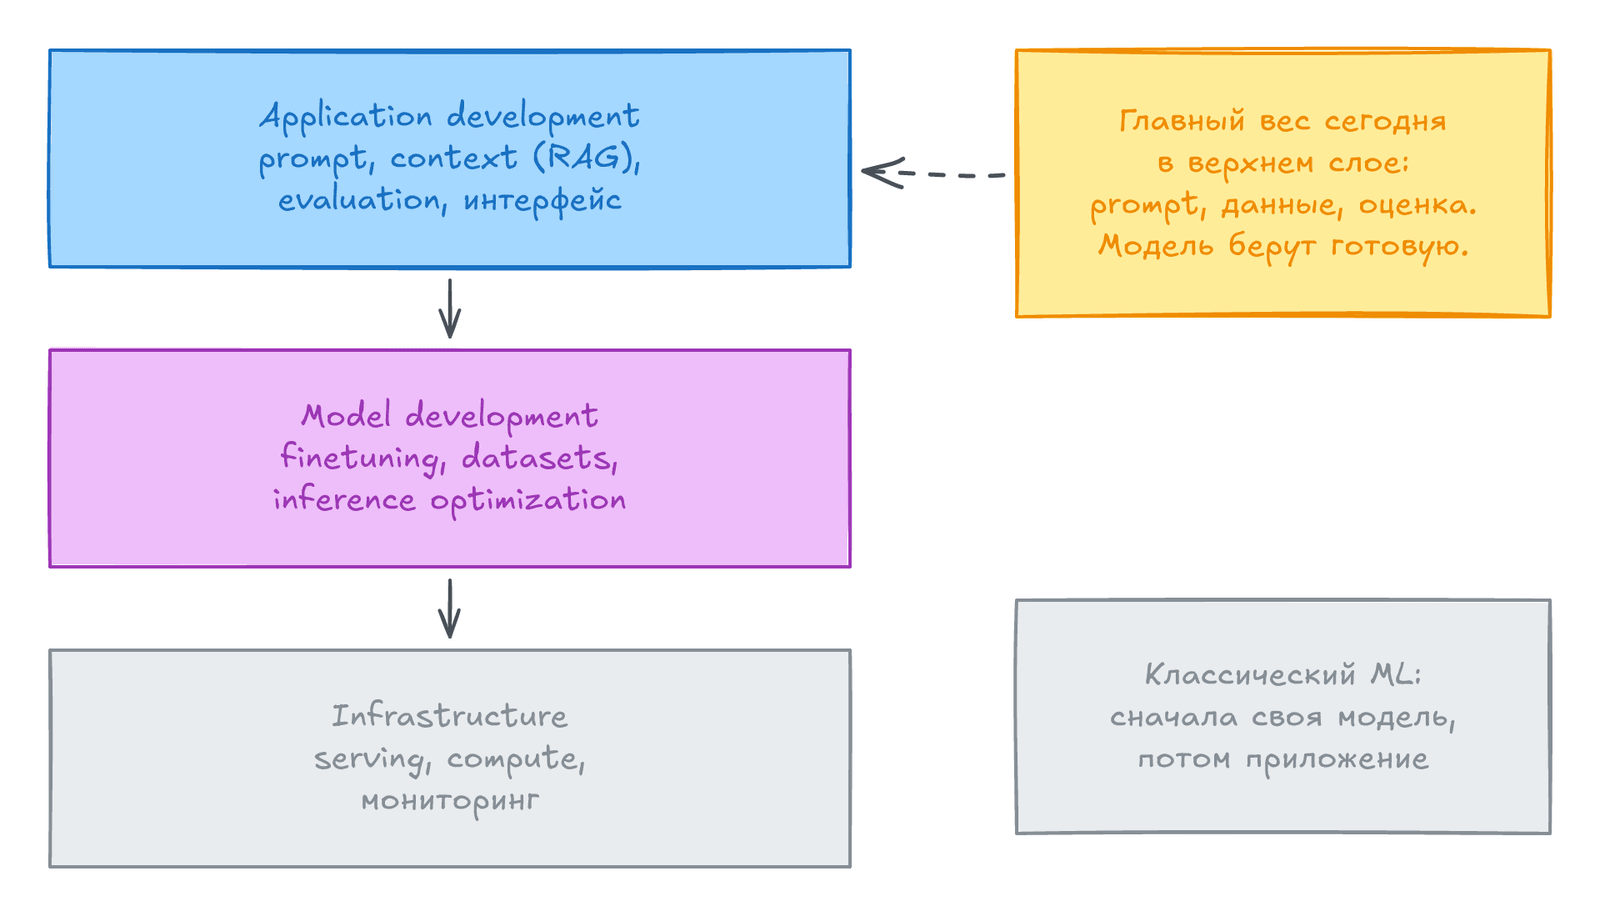
Заголовок раздела «AI-стек: три слоя»Любое AI-приложение состоит из трёх слоёв. Обычно начинают с верхнего и идут вниз по мере необходимости.
| Слой | Что входит |
|---|---|
| Application development | Prompt и контекст для модели, evaluation, интерфейс (AI interface) |
| Model development | Modeling и training, finetuning, dataset engineering, оптимизация inference, evaluation |
| Infrastructure | Serving модели, управление данными и вычислениями, мониторинг |
Что изменилось в каждом слое:
- Infrastructure. Почти не изменилась. Нужны те же ресурсы, развёртывание и мониторинг. Рост числа инструментов был здесь самым малым.
- Model development.
- Знание ML желательно, но уже не обязательно. Оно помогает искать причины ошибок.
Dataset engineeringменяется. Данные чаще неструктурированные. Задачи: дедупликация, токенизация, поиск контекста, контроль качества, удаление чувствительных и токсичных данных. Разметка открытых ответов сложнее разметки «спам или нет».- Оптимизация inference важнее. Модель выдаёт token по одному. Если один token занимает 10 мс, ответ из 100 token займёт секунду.
- Application development. Здесь больше всего изменений. Многие команды используют одну и ту же модель. Отличие продукта создаётся приложением.
Evaluationважнее, чем раньше. Открытые ответы нельзя сравнить с эталоном. Результат сильно зависит от техники. Пример из книги: Google и OpenAI в 2023 году сравнивали модели на MMLU с разным числом примеров в prompt. Выводы поменялись, когда условия выровняли.Prompt engineeringи построение контекста. Это адаптация без изменения весов модели.AI interface: веб, расширение браузера, бот в Slack, plug-in. Новые интерфейсы требуют новых способов собирать feedback.
Training, pre-training, finetuning, post-training
Заголовок раздела «Training, pre-training, finetuning, post-training»Адаптация делится на два вида: без изменения весов модели и с изменением весов.
| Термин | Что значит |
|---|---|
Prompt engineering | Инструкции и контекст. Веса не меняются. Не называйте это training |
Training | Любое обучение, которое меняет веса |
Pre-training | Обучение с нуля, веса случайные. Самый дорогой этап. Для InstructGPT на него ушло до 98% вычислений и данных |
Finetuning | Дообучение уже обученной модели. Нужно меньше данных и вычислений |
Post-training | То же дообучение, но его делает разработчик модели, например чтобы модель лучше слушалась инструкций |
Замечания:
- Не любое изменение весов это training.
Quantizationменяет веса, но обучением не считается. - Для продукта действует правило по данным: с нуля нужно больше всего, потом finetuning, потом prompt engineering.
- Finetuning сложнее, но может заметно улучшить качество, задержку и цену.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Coding стал главным use case. Coding agents (Claude Code, Codex, Cursor) пишут и меняют код в репозитории. Это самая массовая AI-задача в 2026 году.
- Агенты вышли в продакшен. В книге агенты ещё эксперимент. Сейчас это обычная часть продукта (глава 6).
- Роль AI engineer устоялась. Это отдельная вакансия. Data engineer часто делает её часть: данные для RAG, оценки, логи.
- Стек слоёв не изменился. Но верхний слой стал толще: context engineering, tools, оценка агентов.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Foundation model | Универсальная модель, обученная на огромных данных. Может быть текстовой или multimodal |
| LLM | Большая языковая модель. Слово «большая» относительное |
| Token | Единица текста для модели: символ, слово или часть слова |
| Autoregressive model | Модель, которая предсказывает следующий token по предыдущим |
| Self-supervision | Обучение, где метки берутся из самих данных |
| Model as a service | Модель доступна по API, без собственного хостинга |
| Prompt engineering | Адаптация модели через инструкции и контекст |
| RAG | Подключение внешней базы знаний к запросу |
| Finetuning | Дообучение модели с изменением весов |
| Pre-training | Обучение модели с нуля |
| Post-training | Обучение после pre-training, обычно у разработчика модели |
| Human-in-the-loop | Человек участвует в решениях AI |
| Last mile | Последние проценты качества, которые занимают больше всего времени |
| Dataset engineering | Подбор, создание и разметка данных для обучения и адаптации |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Данные важнее, чем кажется. Модели одинаковы у многих, а данные разные. Данные об использовании это будущее преимущество. Сохраняйте запросы, ответы и feedback в warehouse.
- Текст в SQL и поиск по каталогу. Это ближайшие сценарии для вас. Для них нужны хорошие описания таблиц и колонок. Документируйте модели в
dbt: это и контекст для AI. - Неструктурированные данные становятся таблицами. Извлечение полей из PDF и писем даёт новые источники для пайплайнов. Проверяйте качество извлечения так же, как качество любых данных.
- Оценка нужна с первого дня. Соберите набор тестовых вопросов с ожидаемыми ответами. Храните его как версионируемый датасет.
- Считайте цену. Платите за token. Считайте стоимость одного запроса и задержку. Следите за ними в мониторинге, как за любой метрикой пайплайна.
- Планируйте смену модели. Модели и цены меняются. Версионируйте prompts, данные и результаты оценки, чтобы сравнить новую модель со старой.
- Не путайте demo и продукт. Для demo нужен выходной. До production часто нужны месяцы: оценка, безопасность, мониторинг.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему self-supervision позволил моделям вырасти, а supervised обучение нет?
- Чем AI engineering отличается от ML engineering? Назовите три отличия.
- Что такое
Crawl-Walk-Runи как применить его к боту поддержки? - В чём разница между pre-training, finetuning и post-training? Что из этого не считается training?
Предыдущая: Обзор книги. Следующая: Понимание foundation models.