

The Data Warehouse Toolkit, глава 13: Образование
Главная мысль: университет — это много небольших процессов. У приёма студентов есть этапы, и для него нужен accumulating snapshot. У регистрации на курс и посещаемости нет чисел, и для них нужен factless fact table. Всё это работает на общих conformed dimensions.
Bus matrix университета
Заголовок раздела «Bus matrix университета»Университет похож на много компаний сразу: банк (финансовая помощь), магазин (книги), строитель (здания), фонд (выпускники). Процессы в книге делятся на группы.
| Группа | Примеры процессов |
|---|---|
| Жизненный цикл студента | Приём, финансовая помощь, регистрация на курсы, оценки, активности, пожертвования |
| Финансы | Бюджет, GL, закупки, зарплата |
| Сотрудники | Численность, найм, гранты, публикации |
| Администрирование | Использование помещений, энергия, заявки на ремонт |
Общие dimensions: дата и term, студент, сотрудник, курс, подразделение, помещение, счёт.
Accumulating snapshot: воронка приёма
Заголовок раздела «Accumulating snapshot: воронка приёма»Абитуриент проходит этапы. Одна строка в fact — один абитуриент. Строка обновляется при каждом новом этапе.
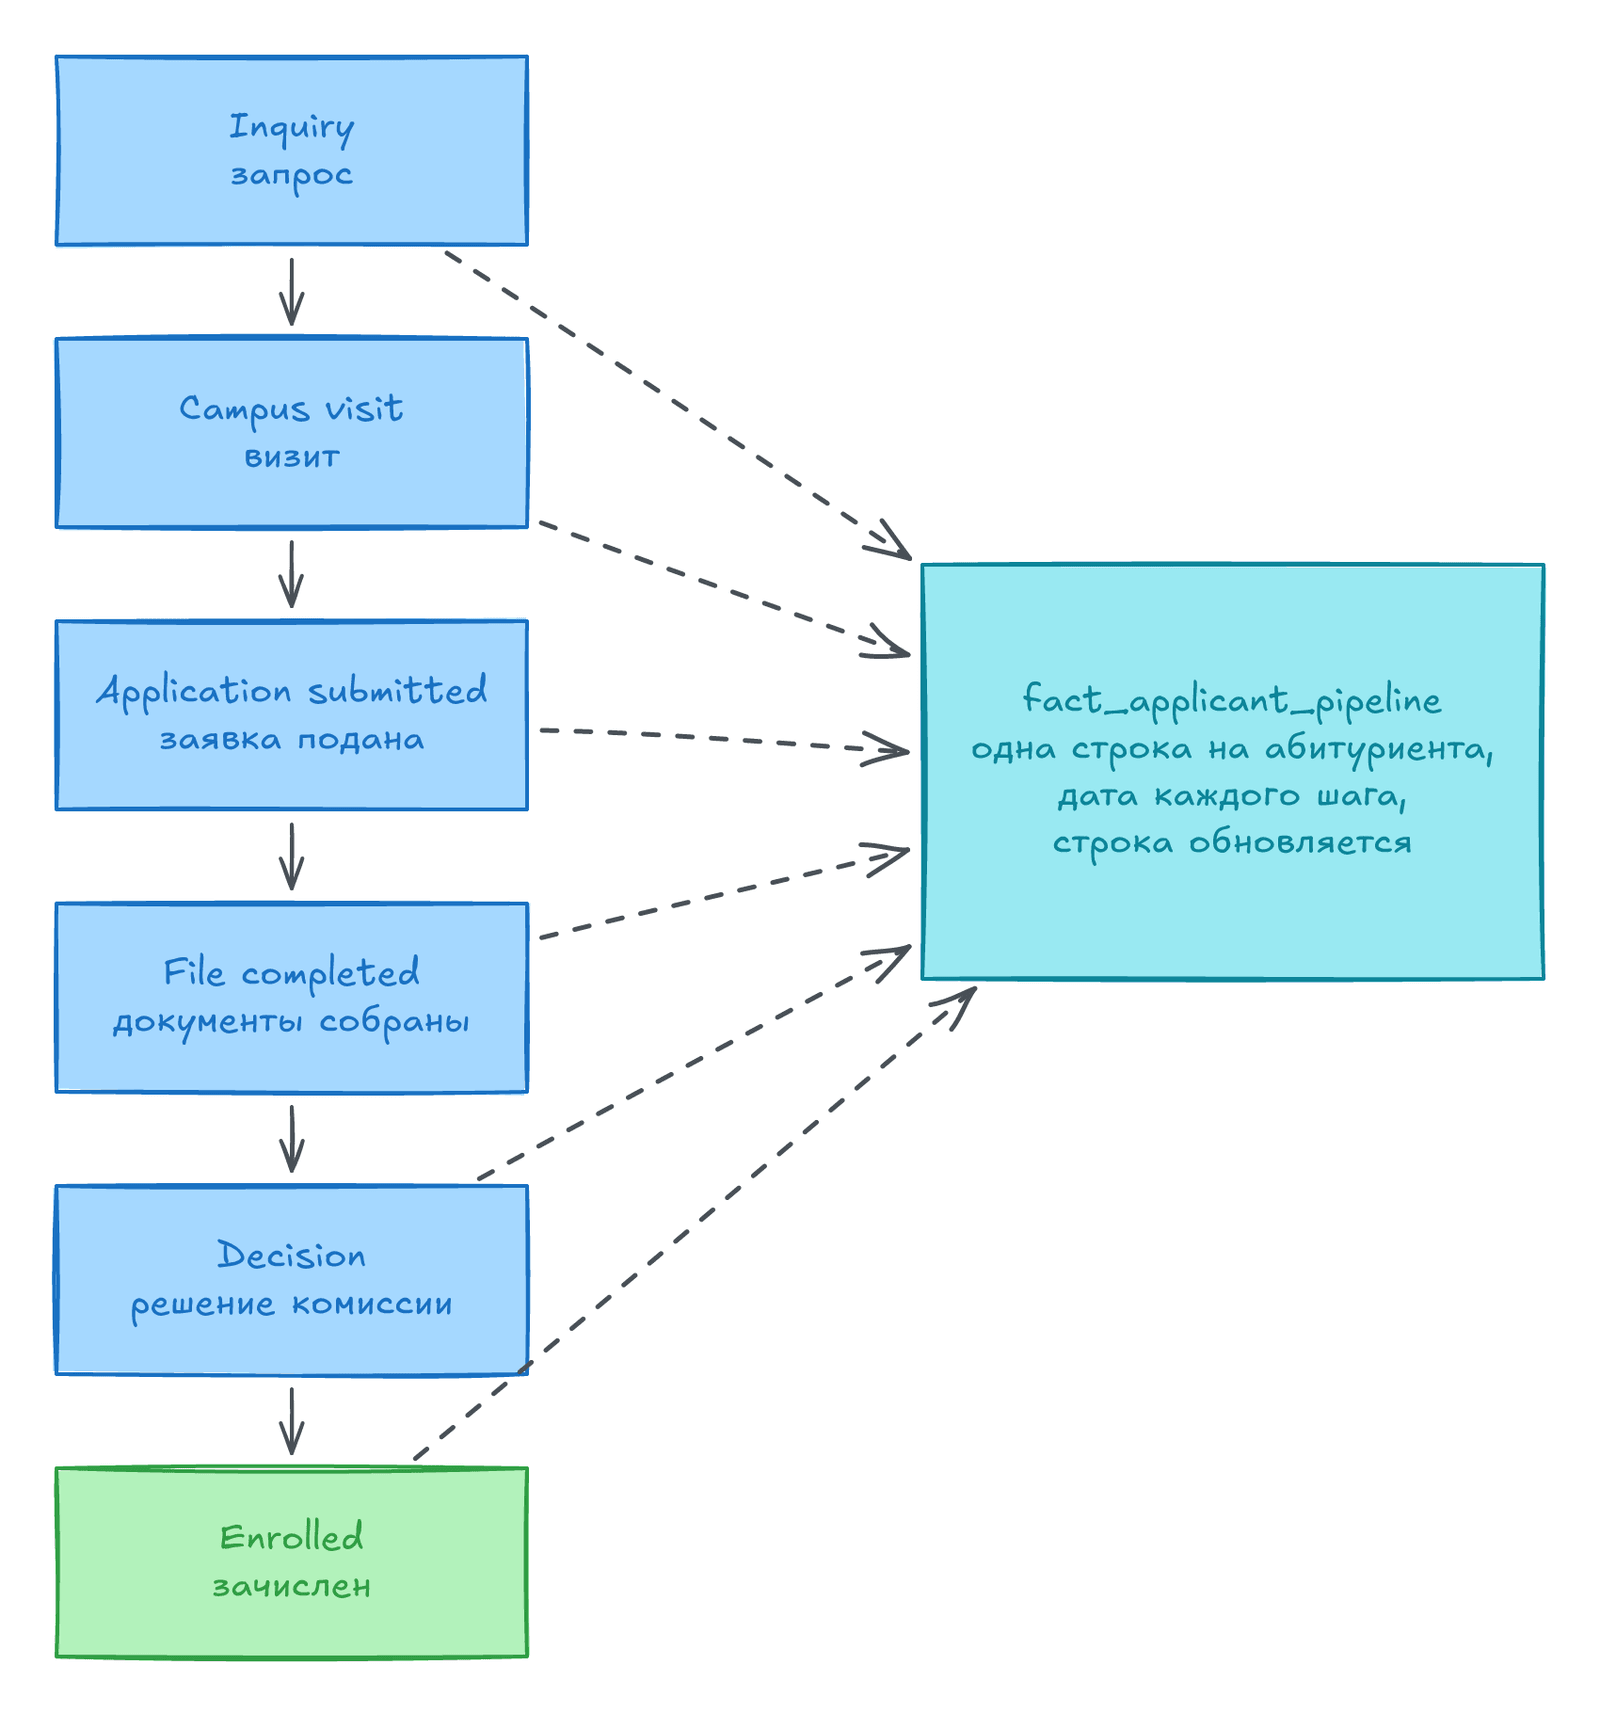
Свойства accumulating snapshot:
- Одна строка хранит всю историю одного процесса.
- Есть несколько дат: по одной на каждый этап.
- Есть счётчики и длительности между этапами.
- Строки меняются через
UPDATE. Меняются и foreign keys, и факты.
| Элемент | Как устроен |
|---|---|
| Grain | Один абитуриент |
| Даты | Запрос, визит, заявка, документы собраны, решение, зачисление или отказ |
| Dimensions | Абитуриент, статус заявки, role-playing даты |
| Facts | Счётчики этапов (inquiry count, admit count и так далее), вероятность зачисления |
- Для дат, которые ещё не наступили, нужна «Unknown» строка в
dim_date.NULLв foreign key нельзя. - Воронка видна сразу: сколько абитуриентов на каждом этапе. По разнице дат видно, где процесс застревает.
- Snapshot не помнит прошлое. Если нужны цифры на дату, например на конец раннего решения, добавьте periodic snapshot или transaction fact.
- Тот же приём работает для грантов: заявка, рассмотрение, одобрение, получение денег.
Factless fact table
Заголовок раздела «Factless fact table»Бывает событие, у которого нет чисел. Fact-таблица состоит только из ключей. Она всё равно полезна: считаем строки.
Тип 1. Событие
Заголовок раздела «Тип 1. Событие»| Событие | Grain |
|---|---|
| Приёмное мероприятие | Один абитуриент на одном мероприятии |
| Регистрация на курс | Один студент на одном курсе в одном term |
| Посещаемость | Один студент на одном занятии |
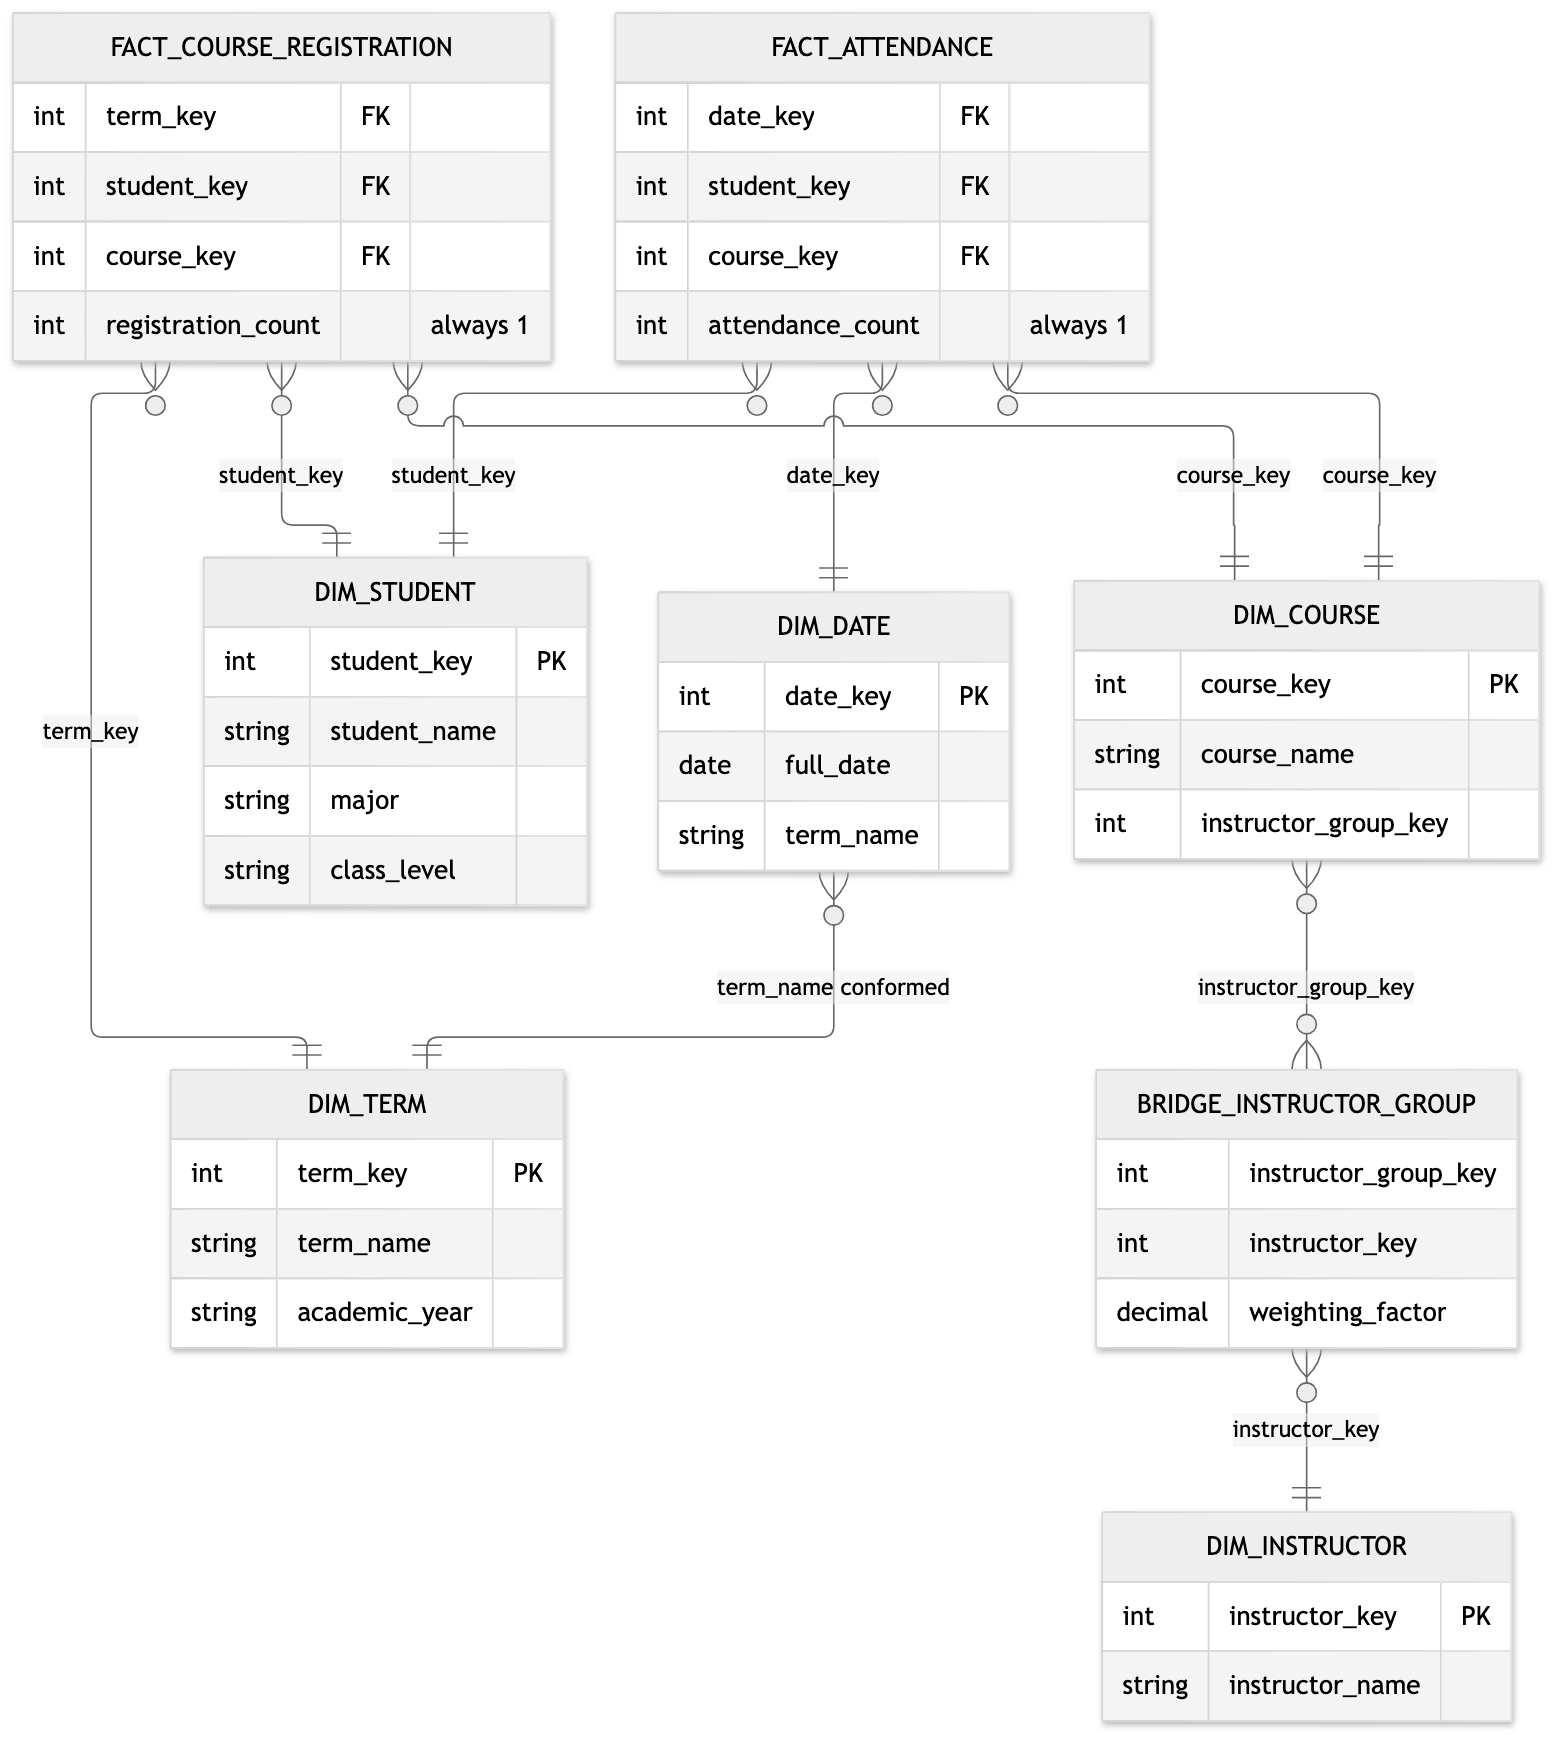
Для удобства добавляют registration_count = 1. Поле не несёт информации, но:
sum()читается проще, чемcount(ключ);- aggregate-таблице нужна настоящая колонка для суммы;
- OLAP-куб требует явный счётчик.
Если появляется настоящая мера (плата, оценка), то таблица уже не factless. Это нормально, если grain тот же.
Тип 2. Покрытие (coverage)
Заголовок раздела «Тип 2. Покрытие (coverage)»Событие записывает то, что было. Но иногда нужно знать то, чего не было. Пример: какие помещения не использовались в среду утром?
Решение: строка для каждого помещения на каждый час, независимо от занятости. В таблице есть dimension utilization_status (Available, Utilized). Другой вариант — вычитать события из полного списка возможностей.
То же с посещаемостью: «кто записан, но не пришёл». Два варианта:
- Вычесть фактические посещения из ожидаемых (запись × расписание). Так сделано в практике ниже.
- Книга допускает и явные строки для пропусков:
attendance_count= 1 или 0. Таблица уже не factless. Это работает, потому что у пропуска те же dimensions, а пропусков немного. - Для продаж так делать нельзя. Строка на каждый некупленный товар со скидкой раздует таблицу.
- OLAP-кубы хорошо показывают «чего не было» без хранения нулей.
Term dimension
Заголовок раздела «Term dimension»Регистрация имеет grain term, а не день. dim_term должна быть conformed с dim_date. В календаре каждая дата называет свой term (Fall 2025). Названия и значения общих атрибутов должны совпадать буква в букву.
Студент и изменения
Заголовок раздела «Студент и изменения»Студент — расширенный абитуриент. Появляются курс, статус обучения, проживание, major, уровень.
| Задача | Решение |
|---|---|
| Нужен профиль на момент регистрации | SCD type 2 |
| Профиль меняется часто (major, класс) | Mini-dimension (type 4) |
| Нужен и исторический, и текущий профиль | Type 7: два ключа в fact, durable key и surrogate key |
Несколько преподавателей у курса
Заголовок раздела «Несколько преподавателей у курса»Курс ведут два преподавателя. На grain регистрации это multivalued dimension. Варианты:
| Вариант | Плюс | Минус |
|---|---|---|
| Изменить grain: студент × курс × преподаватель | Просто | Регистрации считаются дважды |
Bridge table с instructor_group_key | Точно, поддерживает веса | Нужно помнить о перекосе при суммировании |
| Одна строка с именами через запятую | Удобно для подписи | Нет анализа по атрибутам |
| Главный преподаватель в fact | Просто | Теряется остальные |
Если нагрузка делится по правилу, в bridge добавляют weighting_factor. Тогда сумма по преподавателям равна общему итогу.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Accumulating snapshot | Одна строка на процесс. Обновляется по этапам |
| Factless fact table | Fact-таблица без мер. Только ключи |
| Coverage table | Factless-таблица со всеми возможными событиями. Показывает, чего не было |
| Bridge table | Связь many-to-many между fact и dimension |
| Weighting factor | Доля метрики, которая относится к строке bridge |
| Conformed dimension | Общая dimension с одинаковыми значениями для всех fact |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Accumulating snapshot в
dbt— это incremental-модель сmerge. Ключом служит id процесса. - Всегда ставьте дефолтный ключ даты «Unknown» (например,
0). Тогда inner join не теряет строки. - Для расчёта «чего не было» держите отдельную таблицу ожидаемых событий. Ищите разницу через
anti join. - Bridge опасен. Всегда решайте заранее: нужен ли вес, или отчёт показывает «влияние» (impact) с повторным счётом.
- Не усложняйте. Если в факте есть настоящая мера, добавьте её в ту же таблицу.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки ниже идут по порядку.
Шаг 1. Создаём схему
Заголовок раздела «Шаг 1. Создаём схему»-- dim_date с unknown-строкой и именем termCREATE TABLE dim_date ASSELECT 0 AS date_key, NULL::DATE AS full_date, 'Unknown' AS term_nameUNION ALLSELECT strftime(d, '%Y%m%d')::INT, d::DATE, CASE WHEN month(d) BETWEEN 9 AND 12 THEN 'Fall 2025' WHEN month(d) BETWEEN 1 AND 5 THEN 'Spring 2025' ELSE 'Summer 2025' ENDFROM generate_series(DATE '2025-01-01', DATE '2025-12-31', INTERVAL 1 DAY) t(d);
CREATE TABLE dim_term ASSELECT * FROM (VALUES (1, 'Fall 2025', '2025-2026'), (2, 'Spring 2025', '2024-2025'), (3, 'Summer 2025', '2024-2025')) t(term_key, term_name, academic_year);
CREATE TABLE dim_student ASSELECT * FROM (VALUES (1, 'Анна', 'Data Science', 'Sophomore'), (2, 'Борис', 'Economics', 'Junior'), (3, 'Вера', 'Data Science', 'Freshman'), (4, 'Глеб', 'Math', 'Sophomore'), (5, 'Дарья', 'Economics', 'Senior'), (6, 'Егор', 'Data Science', 'Junior')) t(student_key, student_name, major, class_level);
CREATE TABLE dim_instructor ASSELECT * FROM (VALUES (1, 'Проф. Иванов'), (2, 'Проф. Петрова')) t(instructor_key, instructor_name);
-- bridge: группа 3 это курс с двумя преподавателями, вес 0.5 у каждогоCREATE TABLE bridge_instructor_group ASSELECT * FROM (VALUES (1, 1, 1.0), (2, 2, 1.0), (3, 1, 0.5), (3, 2, 0.5)) t(instructor_group_key, instructor_key, weighting_factor);
CREATE TABLE dim_course ASSELECT * FROM (VALUES (1, 'SQL basics', 1), (2, 'Data modeling', 3), (3, 'Statistics', 2)) t(course_key, course_name, instructor_group_key);
-- factless: одна строка на студента, курс и termCREATE TABLE fact_course_registration ASSELECT term_key, student_key, course_key, 1 AS registration_countFROM (VALUES (1, 1, 1), (1, 1, 2), (1, 2, 1), (1, 2, 2), (1, 2, 3), (1, 3, 1), (1, 4, 2), (1, 4, 3), (1, 5, 3), (1, 6, 1), (1, 6, 2), (2, 1, 3), (2, 2, 1)) t(term_key, student_key, course_key);
-- расписание занятий осеньюCREATE TABLE class_schedule ASSELECT * FROM (VALUES (1, DATE '2025-09-01'), (1, DATE '2025-09-08'), (2, DATE '2025-09-02'), (2, DATE '2025-09-09'), (3, DATE '2025-09-03'), (3, DATE '2025-09-10')) t(course_key, class_date);
-- пропуски: студент, курс, датаCREATE TABLE stg_absence ASSELECT * FROM (VALUES (1, 1, DATE '2025-09-08'), (2, 2, DATE '2025-09-09'), (2, 3, DATE '2025-09-10'), (4, 3, DATE '2025-09-03'), (4, 3, DATE '2025-09-10'), (6, 1, DATE '2025-09-01')) t(student_key, course_key, class_date);
-- factless: один студент на одном занятии (если пришёл)CREATE TABLE fact_attendance ASSELECT d.date_key, r.student_key, r.course_key, 1 AS attendance_countFROM fact_course_registration rJOIN class_schedule cs ON cs.course_key = r.course_keyJOIN dim_date d ON d.full_date = cs.class_dateWHERE r.term_key = 1 AND NOT EXISTS ( SELECT 1 FROM stg_absence a WHERE a.student_key = r.student_key AND a.course_key = r.course_key AND a.class_date = cs.class_date );
-- accumulating snapshot: источник событийCREATE TABLE stg_applicant_event ASSELECT * FROM (VALUES (1, 'inquiry', DATE '2025-01-10'), (1, 'visit', DATE '2025-02-05'), (1, 'submitted', DATE '2025-02-20'), (1, 'completed', DATE '2025-03-01'), (1, 'decision_admit', DATE '2025-03-15'), (1, 'enrolled', DATE '2025-04-20'), (2, 'inquiry', DATE '2025-01-12'), (2, 'visit', DATE '2025-02-06'), (2, 'submitted', DATE '2025-02-25'), (2, 'completed', DATE '2025-03-05'), (2, 'decision_deny', DATE '2025-03-15'), (3, 'inquiry', DATE '2025-01-15'), (3, 'submitted', DATE '2025-02-28'), (3, 'completed', DATE '2025-03-10'), (3, 'decision_admit', DATE '2025-03-15'), (3, 'enrolled', DATE '2025-04-10'), (4, 'inquiry', DATE '2025-01-20'), (4, 'visit', DATE '2025-02-10'), (5, 'inquiry', DATE '2025-01-22'), (5, 'visit', DATE '2025-02-12'), (5, 'submitted', DATE '2025-03-01'), (5, 'completed', DATE '2025-03-12'), (5, 'decision_admit', DATE '2025-03-15'), (6, 'inquiry', DATE '2025-02-01'), (7, 'inquiry', DATE '2025-02-03'), (7, 'visit', DATE '2025-03-01'), (7, 'submitted', DATE '2025-03-08'), (7, 'completed', DATE '2025-03-14'), (8, 'inquiry', DATE '2025-02-10'), (8, 'submitted', DATE '2025-03-02'), (8, 'completed', DATE '2025-03-09'), (8, 'decision_admit', DATE '2025-03-15')) t(applicant_key, stage, event_date);
CREATE TABLE dim_application_status ASSELECT * FROM (VALUES (1, 'Inquiry'), (2, 'Submitted'), (3, 'File completed'), (4, 'Admitted'), (5, 'Denied'), (6, 'Enrolled')) t(application_status_key, application_status);
CREATE MACRO date_key_or_unknown(d) AS coalesce(strftime(d, '%Y%m%d')::INT, 0);
-- grain: один абитуриент. Нет события, значит ключ 0 (Unknown)CREATE TABLE fact_applicant_pipeline ASSELECT applicant_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage = 'inquiry')) AS inquiry_date_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage = 'visit')) AS visit_date_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage = 'submitted')) AS submitted_date_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage = 'completed')) AS completed_date_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage LIKE 'decision%')) AS decision_date_key, date_key_or_unknown(min(event_date) FILTER (WHERE stage = 'enrolled')) AS enrolled_date_key, CASE WHEN count(*) FILTER (WHERE stage = 'enrolled') > 0 THEN 6 WHEN count(*) FILTER (WHERE stage = 'decision_deny') > 0 THEN 5 WHEN count(*) FILTER (WHERE stage = 'decision_admit') > 0 THEN 4 WHEN count(*) FILTER (WHERE stage = 'completed') > 0 THEN 3 WHEN count(*) FILTER (WHERE stage = 'submitted') > 0 THEN 2 ELSE 1 END AS application_status_keyFROM stg_applicant_eventGROUP BY applicant_key;Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»-- 8 абитуриентов, ни одного NULL в ключах датSELECT count(*) AS applicants, count(*) FILTER (WHERE visit_date_key IS NULL OR decision_date_key IS NULL) AS null_keysFROM fact_applicant_pipeline;
-- регистраций осенью должно быть 11SELECT sum(registration_count) AS fall_registrationsFROM fact_course_registration WHERE term_key = 1;
-- conformed: каждая осенняя дата называет term так же, как dim_termSELECT count(*) AS fall_days FROM dim_date d JOIN dim_term t USING (term_name) WHERE t.term_key = 1;Задания
Заголовок раздела «Задания»1. Регистрации осенью по курсам. Покажите, что count(*) и sum(registration_count) дают одно число. Затем найдите студентов, записанных на два курса и больше.
Решение
SELECT c.course_name,       count(*)                    AS rows_count,       sum(r.registration_count)   AS registrationsFROM fact_course_registration rJOIN dim_course c USING (course_key)JOIN dim_term t USING (term_key)WHERE t.term_name = 'Fall 2025'GROUP BY c.course_nameORDER BY registrations DESC;
SELECT s.student_name, count(*) AS coursesFROM fact_course_registration rJOIN dim_student s USING (student_key)WHERE r.term_key = 1GROUP BY s.student_nameHAVING count(*) > 1ORDER BY courses DESC, s.student_name;
2. Регистрации по преподавателям через bridge. Посчитайте два числа: без весов (impact) и с весами. Итог с весами должен равняться 11.
Решение
SELECT i.instructor_name, count(*) AS registrations_impact, round(sum(r.registration_count * b.weighting_factor), 2) AS registrations_weightedFROM fact_course_registration rJOIN dim_course c USING (course_key)JOIN bridge_instructor_group b USING (instructor_group_key)JOIN dim_instructor i USING (instructor_key)WHERE r.term_key = 1GROUP BY i.instructor_nameORDER BY i.instructor_name;Без весов сумма равна 15, а регистраций 11. Курс Data modeling посчитан у двух преподавателей. С весами сумма равна 11.
3. Посещаемость. Для каждого курса найдите ожидаемые занятия (записанные студенты × расписание), фактические и долю посещения. Затем найдите студентов, которые пропустили все занятия курса.
Решение
WITH expected AS (    SELECT r.course_key, r.student_key, count(*) AS expected_sessions    FROM fact_course_registration r    JOIN class_schedule cs USING (course_key)    WHERE r.term_key = 1    GROUP BY ALL), actual AS (    SELECT course_key, student_key, sum(attendance_count) AS attended    FROM fact_attendance    GROUP BY ALL)SELECT c.course_name,       sum(e.expected_sessions)                     AS expected,       coalesce(sum(a.attended), 0)                 AS attended,       round(coalesce(sum(a.attended), 0) / sum(e.expected_sessions), 2) AS attendance_rateFROM expected eLEFT JOIN actual a USING (course_key, student_key)JOIN dim_course c USING (course_key)GROUP BY c.course_nameORDER BY attendance_rate;
-- студенты без единого посещения курса (anti join)SELECT s.student_name, c.course_nameFROM (SELECT DISTINCT student_key, course_key FROM fact_course_registration WHERE term_key = 1) rLEFT JOIN (SELECT DISTINCT student_key, course_key FROM fact_attendance) a USING (student_key, course_key)JOIN dim_student s USING (student_key)JOIN dim_course c USING (course_key)WHERE a.student_key IS NULL;
Глеб пропустил оба занятия по Statistics. Таких строк нет в fact_attendance, поэтому их видно только через список ожидаемых занятий.
4. Воронка приёма. Сколько абитуриентов дошло до каждого этапа? Какая средняя задержка в днях от запроса до заявки? Используйте два role-playing alias для dim_date.
Решение
SELECT count(*)                                               AS inquiries,       count(*) FILTER (WHERE visit_date_key <> 0)            AS visits,       count(*) FILTER (WHERE submitted_date_key <> 0)        AS submitted,       count(*) FILTER (WHERE completed_date_key <> 0)        AS completed,       count(*) FILTER (WHERE decision_date_key <> 0)         AS decided,       count(*) FILTER (WHERE enrolled_date_key <> 0)         AS enrolledFROM fact_applicant_pipeline;
SELECT round(avg(ds.full_date - di.full_date), 1) AS avg_days_inquiry_to_submittedFROM fact_applicant_pipeline fJOIN dim_date di ON di.date_key = f.inquiry_date_keyJOIN dim_date ds ON ds.date_key = f.submitted_date_keyWHERE f.submitted_date_key <> 0;
5. Обновление строки. Абитуриент 7 получил решение о приёме 20 марта 2025. Обновите его строку в accumulating snapshot. Потом покажите статусы всех абитуриентов.
Решение
INSERT INTO stg_applicant_event VALUES (7, 'decision_admit', DATE '2025-03-20');
UPDATE fact_applicant_pipelineSET decision_date_key = 20250320,    application_status_key = 4WHERE applicant_key = 7;
SELECT s.application_status, count(*) AS applicantsFROM fact_applicant_pipeline fJOIN dim_application_status s USING (application_status_key)GROUP BY s.application_statusORDER BY min(s.application_status_key);
Строка не добавилась, а изменилась. Так и работает accumulating snapshot.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие три признака отличают accumulating snapshot от transaction fact?
- Зачем в factless fact table нужен
registration_count = 1? - Как найти студентов, которые записаны на курс, но ни разу не пришли?
- Когда в bridge для преподавателей нужен weighting factor, а когда его лучше не добавлять?