

AI Engineering, глава 2: Как устроены foundation models
Главная мысль: Поведение модели зависит от четырёх вещей: данные, архитектура и размер, post-training и sampling. Вам не нужно обучать модель. Но эти четыре вещи объясняют, почему она ошибается, почему стоит денег и почему отвечает каждый раз по-разному.
Training data
Заголовок раздела «Training data»Модель знает только то, что было в данных. Нет вьетнамского в данных, нет хорошего перевода на вьетнамский.
- Главный источник данных:
Common Crawl. Это архив страниц из интернета. Качество у него разное: много мусора, кликбейта и фейков. - Разработчики берут то, что есть, а не то, что нужно. Поэтому модель хороша в задачах, которые часто встречаются в сети.
- Качество важнее объёма. Маленькая модель на 1,3B параметров, обученная на 7B токенов хорошего кода, обошла более крупные модели на нескольких coding-бенчмарках.
В Common Crawl английский занимает около 46%. Это в 8 раз больше, чем у русского (около 6%). Русский стоит на втором месте.
Что это даёт на практике:
- Мало данных на языке: качество ниже. Редкие языки (например, телугу) работают хуже.
- Перевод через английский теряет смысл. Например, вьетнамские местоимения, которые показывают отношения между людьми.
- Модель может вести себя по-другому на других языках, в том числе в вопросах безопасности.
Цена и скорость считаются по токенам. Для бирманского нужно примерно в 10 раз больше токенов, чем для английского, чтобы сказать то же самое. Значит, и счёт в 10 раз выше. Для русского тоже стоит проверить число токенов на своих текстах.
Доменные данные
Заголовок раздела «Доменные данные»Данных для узких областей в открытом интернете мало: белки, медицинские снимки, внутренние документы компании. Часто берут универсальную модель и дообучают на своих данных (глава 7).
Modeling: архитектура и размер
Заголовок раздела «Modeling: архитектура и размер»Transformer и attention
Заголовок раздела «Transformer и attention»Сейчас почти все языковые модели построены на transformer. До него был seq2seq на RNN. У него две проблемы:
- Декодер видел только одно «резюме» входа (последнее hidden state). Информация терялась.
- RNN читает токены по одному. На длинном тексте это медленно.
Transformer решает обе проблемы через attention. Модель при каждом новом токене сама решает, на какие прошлые токены смотреть и насколько сильно. Входные токены обрабатываются параллельно.
Как это работает, если упростить:
- У каждого токена есть три вектора:
query(что ищем),key(чем это помечено),value(что внутри). - Вес внимания = насколько
queryпохож наkey. Чем выше вес, тем больше берём изvalue. - Блок transformer = attention + MLP. Таких блоков десятки. Их число называют числом слоёв.
Чем длиннее контекст, тем больше key и value нужно хранить в памяти. Поэтому длинный контекст стоит дорого.
Инференс идёт в два шага:
| Шаг | Что происходит | Скорость |
|---|---|---|
| Prefill | Модель читает весь prompt параллельно | Быстро |
| Decode | Модель выдаёт по одному токену | Медленно, это узкое место |
Другие архитектуры
Заголовок раздела «Другие архитектуры»Transformer живёт с 2017 года, и его сильно оптимизировали. Заменить его трудно. Альтернативы: RWKV (RNN, который обучается параллельно), Mamba из семейства SSM (стоимость растёт линейно с длиной текста, а не квадратично), Jamba (гибрид transformer и Mamba). Если архитектура сменится, основные подходы из книги останутся.
Размер модели
Заголовок раздела «Размер модели»Размер описывают тремя числами: число parameters (оно в имени: Llama-13B), число training tokens и число FLOPs (стоимость обучения).
- Память для инференса: 7B параметров по 2 байта = минимум 14 GB GPU. На практике нужно больше.
Mixture of Experts(MoE): в каждый момент работает только часть параметров. УMixtral 8x7Bвсего 46,7B параметров, но активны 12,9B на токен. Цена и скорость как у модели на 12,9B.- Обучение GPT-3 175B на 256 GPU H100 при 70% загрузке стоило бы больше 4 млн долларов.
Scaling laws
Заголовок раздела «Scaling laws»Обычно у команды есть бюджет на вычисления. Вопрос: какой размер модели и данных дадут лучший результат за эти деньги?
- Правило
Chinchilla: для compute-optimal обучения нужно примерно 20 токенов на каждый параметр. Модели на 3B нужно около 60B токенов. - Размер модели и число токенов растут вместе. Модель в 2 раза больше, значит и данных в 2 раза больше.
- Правило не учитывает стоимость инференса. Поэтому часто делают модели меньше оптимума: их дешевле запускать.
- Последние проценты качества стоят очень дорого. Улучшить точность с 90 до 95% дороже, чем с 85 до 90%.
Узкие места роста
Заголовок раздела «Узкие места роста»- Данные. Обучающие данные растут быстрее, чем люди создают новый текст. Часть сайтов закрыла доступ для краулеров. Интернет заполняется текстом от ИИ, и обучение на нём может ухудшить модели. Закрытые собственные данные становятся ценным активом.
- Электричество. Дата-центры потребляют около 1-2% мирового электричества. Рост ограничен.
Post-training
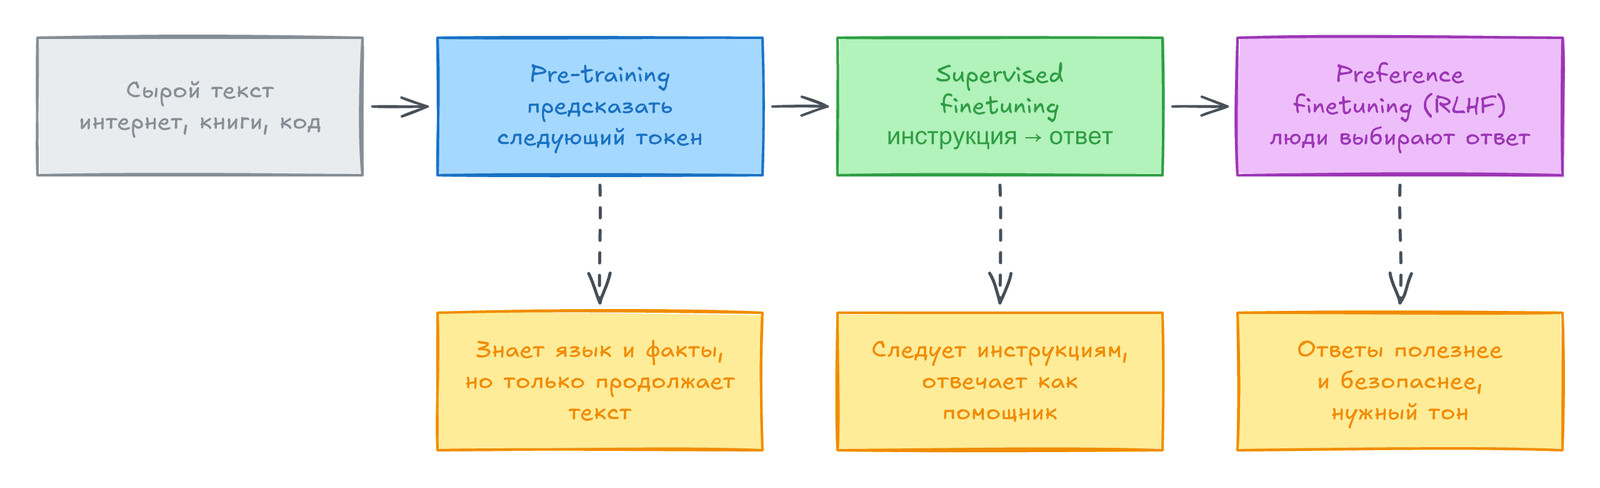
Заголовок раздела «Post-training»Pre-training учит предсказывать следующий токен на данных из интернета. Это даёт две проблемы:
- Модель продолжает текст, а не ведёт диалог. На «Как сварить рис?» она может продолжить вопрос другими вопросами.
- Модель может отвечать грубо, токсично или неверно.
Post-training решает обе проблемы. Он занимает малую часть вычислений (у InstructGPT около 2%). Он не добавляет знаний. Он раскрывает то, что модель уже умеет.
Supervised finetuning (SFT)
Заголовок раздела «Supervised finetuning (SFT)»- Данные: пары
(prompt, ответ). Это demonstration data. Модель копирует поведение из примеров. - Нужны сильные разметчики. У InstructGPT около 90% разметчиков имели высшее образование. Одна пара может занять до 30 минут.
- Это дорого: при 10 долларах за пару 13 000 пар стоят 130 000 долларов.
- Дешевле: волонтёры, фильтрация диалогов, синтетические данные (глава 8).
Preference finetuning
Заголовок раздела «Preference finetuning»SFT учит вести диалог. Но он не учит, какие ответы лучше. Здесь нужны человеческие предпочтения. А они у разных людей разные, поэтому задача очень трудная.
Самый известный метод: RLHF. Два шага:
- Обучить
reward model. Она ставит оценку паре(prompt, ответ). - Дообучить модель так, чтобы оценка reward model росла. Часто для этого берут алгоритм
PPO.
Как получить данные для reward model:
- Просить поставить балл каждому ответу плохо: оценки сильно плавают. Один человек даст 5, другой 7.
- Лучше сравнение: «какой из двух ответов лучше». Получается формат
(prompt, победитель, проигравший). Это comparison data. - Сравнение стоит дешевле, чем писать ответ: в книге пример 3,50 доллара против 25 долларов.
Альтернативы: DPO (проще, использовалась в Llama 3), RLAIF (оценивает ИИ). Некоторые команды вообще не делают RL: генерируют несколько ответов и берут лучший по reward model. Это best of N.
Sampling
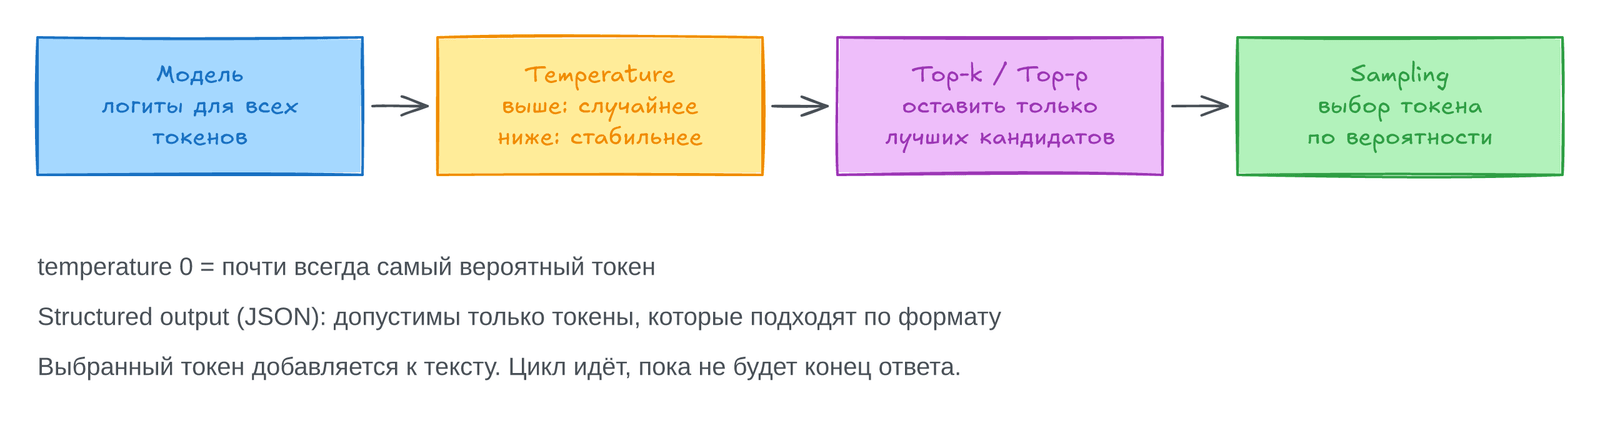
Заголовок раздела «Sampling»Модель строит ответ через sampling. Из-за него ответы вероятностные.
Как выбирается один токен
Заголовок раздела «Как выбирается один токен»Сеть выдаёт вектор logits: одно число на каждый токен словаря. softmax превращает logits в вероятности. Модель выбирает токен по этим вероятностям. Если всегда брать самый вероятный токен (greedy), текст получается скучным.
Temperature
Заголовок раздела «Temperature»Logits делятся на temperature T до softmax. Пример с тремя токенами и logits [2, 1, 0]:
| Temperature | Вероятности трёх токенов | Эффект |
|---|---|---|
| 2 | 51% / 31% / 19% | Распределение плоское, больше разнообразия |
| 1 | 67% / 25% / 9% | Исходное распределение |
| 0,5 | 87% / 12% / 2% | Почти всегда лидер, ответы стабильнее |
- Низкая temperature: ответы стабильные, но скучные. Высокая: разнообразные, но менее связные.
T = 0на практике означает выбор токена с наибольшим logit.- Для креативных задач часто берут около 0,7. Подбирайте на своих данных.
Top-k и top-p
Заголовок раздела «Top-k и top-p»| Метод | Что делает |
|---|---|
| Top-k | Оставляет k самых вероятных токенов (обычно 50-500). Считать softmax по ним дешевле |
| Top-p (nucleus) | Берёт самые вероятные токены, пока их сумма не достигнет p (обычно 0,9-0,95). Число кандидатов меняется по ситуации |
| Min-p | Отсекает токены с вероятностью ниже порога |
На вопрос «Да или нет?» хватит двух кандидатов. На открытый вопрос нужно много. Top-p подстраивается под это сам.
Logprobs и остановка
Заголовок раздела «Logprobs и остановка»Logprobsэто логарифмы вероятностей токенов. Они помогают отлаживать модель. Многие провайдеры отдают их не полностью.- Длинный ответ стоит денег. Его останавливают лимитом токенов или stop-токеном. Опасность: оборванный JSON не прочитает ни один парсер.
Test-time compute
Заголовок раздела «Test-time compute»Идея: на один запрос сгенерировать несколько ответов и выбрать лучший.
Best of N: N случайных ответов, выбор по критерию.- Критерии выбора: самый высокий средний logprob, оценка reward model или verifier, правило приложения.
- Пример правила: для text-to-SQL генерировать, пока запрос не станет валидным.
- Для точных ответов: брать самый частый из нескольких (
self-consistency). - Цена: N ответов стоят примерно в N раз больше.
- Verifier дал в опыте OpenAI на математике эффект, как увеличение модели примерно в 30 раз.
Structured outputs
Заголовок раздела «Structured outputs»Формат нужен, когда задача его требует (text-to-SQL, классификация) или когда ответ читает другая программа (JSON с нужными ключами, особенно для agents). Способы, от простых к сильным:
| Способ | Идея | Когда подходит |
|---|---|---|
| Prompting | Попросить формат в prompt | Когда модель и так хорошо слушается. Гарантий нет |
| Post-processing | Скрипт чинит частые ошибки (например, добавляет }) | Ошибки простые и повторяются. Парсер YAML у LinkedIn поднял долю верных ответов с 90% до 99,99% |
| Test-time compute | Генерировать, пока формат не станет верным | Есть бюджет на повторы |
| Constrained sampling | Из logits убираются токены, которые нарушают грамматику | Нужна гарантия. Нужна грамматика под формат, это сложно |
| Finetuning | Дообучить на примерах нужного формата | Самый общий и надёжный способ |
Режим JSON в API обычно гарантирует валидный JSON. Но не гарантирует нужные поля и значения. Если генерация оборвалась по лимиту токенов, JSON всё равно будет битым.
Вероятностная природа ИИ
Заголовок раздела «Вероятностная природа ИИ»Один вопрос два раза может дать два разных ответа. Модель вероятностная, а не детерминированная.
Inconsistency
Заголовок раздела «Inconsistency»Две формы: одинаковый prompt даёт разные ответы, или чуть изменённый prompt (например, регистр буквы) даёт сильно другой ответ.
- Для первой формы: кэшировать ответ, зафиксировать temperature, top-p, top-k и
seed. Полной гарантии нет: результат зависит ещё от железа. - Для второй формы помогают аккуратные prompt (глава 5) и память системы (глава 6).
Hallucinations
Заголовок раздела «Hallucinations»Hallucination: ответ без опоры на факты. В 2023 году юристов оштрафовали за выдуманные судебные дела, которые подсказал ChatGPT.
Есть две гипотезы причин. Они дополняют друг друга.
| Гипотеза | Суть |
|---|---|
| Самообман | Модель не отличает данные от входа от того, что сама выдала. Первая выдуманная фраза становится «фактом», и дальше ошибка нарастает (snowballing) |
| Разное знание модели и разметчика | При SFT разметчик пишет ответ, опираясь на то, что знает он. Модель этого не знает и учится выдумывать |
Что помогает: просить отвечать «не знаю», если модель не уверена. Просить короткие ответы. Добавлять проверенный контекст (главы 5 и 6).
RLHF не гарантирует меньше hallucinations. В исследовании InstructGPT их стало больше, хотя люди всё равно предпочли такую модель.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Reasoning models. OpenAI o1 (осень 2024), затем DeepSeek-R1 (январь 2025). Модель сначала «думает» длинной цепочкой токенов, потом отвечает. Сейчас режим thinking есть у всех крупных моделей.
- RL с проверяемой наградой (RLVR). Новый этап post-training. Награда приходит не от людей, а от проверки: тесты прошли, ответ в задаче по математике верный. Популярный алгоритм:
GRPO. - Test-time compute стал главным рычагом. Больше токенов на размышление = выше качество на сложных задачах. Цена и latency тоже растут.
- Mixture of Experts (MoE) стал нормой. DeepSeek-V3, Qwen3, Llama 4, gpt-oss. На каждый токен работает только часть параметров. Число параметров в имени больше не равно цене inference.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Transformer | Архитектура на attention, сейчас главная для LLM |
| MoE (Mixture of Experts) | Модель, где на токен работает только часть параметров |
| Scaling law (Chinchilla) | Правило подбора размера модели и данных под бюджет, около 20 токенов на параметр |
| Pre-training | Обучение предсказывать следующий токен на огромном корпусе |
| SFT | Supervised finetuning на парах (prompt, ответ) |
| Preference finetuning (RLHF, DPO) | Настройка под человеческие предпочтения |
| Temperature | Параметр: выше значит разнообразнее, ниже значит стабильнее |
| Test-time compute | Несколько ответов на запрос, выбор лучшего |
| Structured outputs | Ответы в заданном формате (JSON, SQL и др.) |
| Hallucination | Ответ без опоры на факты |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Считайте токены на своих данных. Цена и latency зависят от числа токенов. Для русского текста замерьте это до выбора модели.
- Данные в warehouse это актив. Закрытые, чистые и размеченные данные ценнее, чем выбор между похожими моделями. Готовьте их как таблицы с понятным grain и качеством.
- Данные для SFT и preference это таблицы. Пары
(prompt, ответ)и тройки(prompt, победитель, проигравший)нужно версионировать и проверять тестами, как любую модель вdbt. - Сохраняйте sampling-параметры. Пишите в лог модель, версию, temperature, top-p и seed вместе с запросом и ответом. Без этого ошибку не воспроизвести.
- Не ждите детерминизма. Тесты вроде «ответ равен X» ломаются. Нужна evaluation на наборе примеров (главы 3 и 4).
- Проверяйте формат на выходе. Если LLM пишет в таблицу или в SQL, добавьте валидацию и quarantine для плохих строк. Например, text-to-SQL: проверяйте запрос через
EXPLAINдо выполнения. - Считайте стоимость повторов. Best of N умножает счёт на N.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему английский текст стоит дешевле и работает лучше, чем текст на редких языках? Назовите две причины.
- Чем отличаются SFT и preference finetuning? Какие данные нужны для каждого?
- Что произойдёт с ответами, если поднять temperature с 0,5 до 2? А если уменьшить top-p?
- Какие способы получить structured output вы знаете? Когда нужен constrained sampling, а когда хватит prompt и post-processing?
Предыдущая: Введение в AI Engineering. Следующая: Методология evaluation.