

AI Engineering, глава 9: Оптимизация inference
Главная мысль: Хорошая модель бесполезна, если она медленная или дорогая. У LLM inference два шага с разными узкими местами: prefill упирается в вычисления, decode упирается в память. Оптимизация идёт на трёх уровнях: модель, attention и KV cache, сервис.
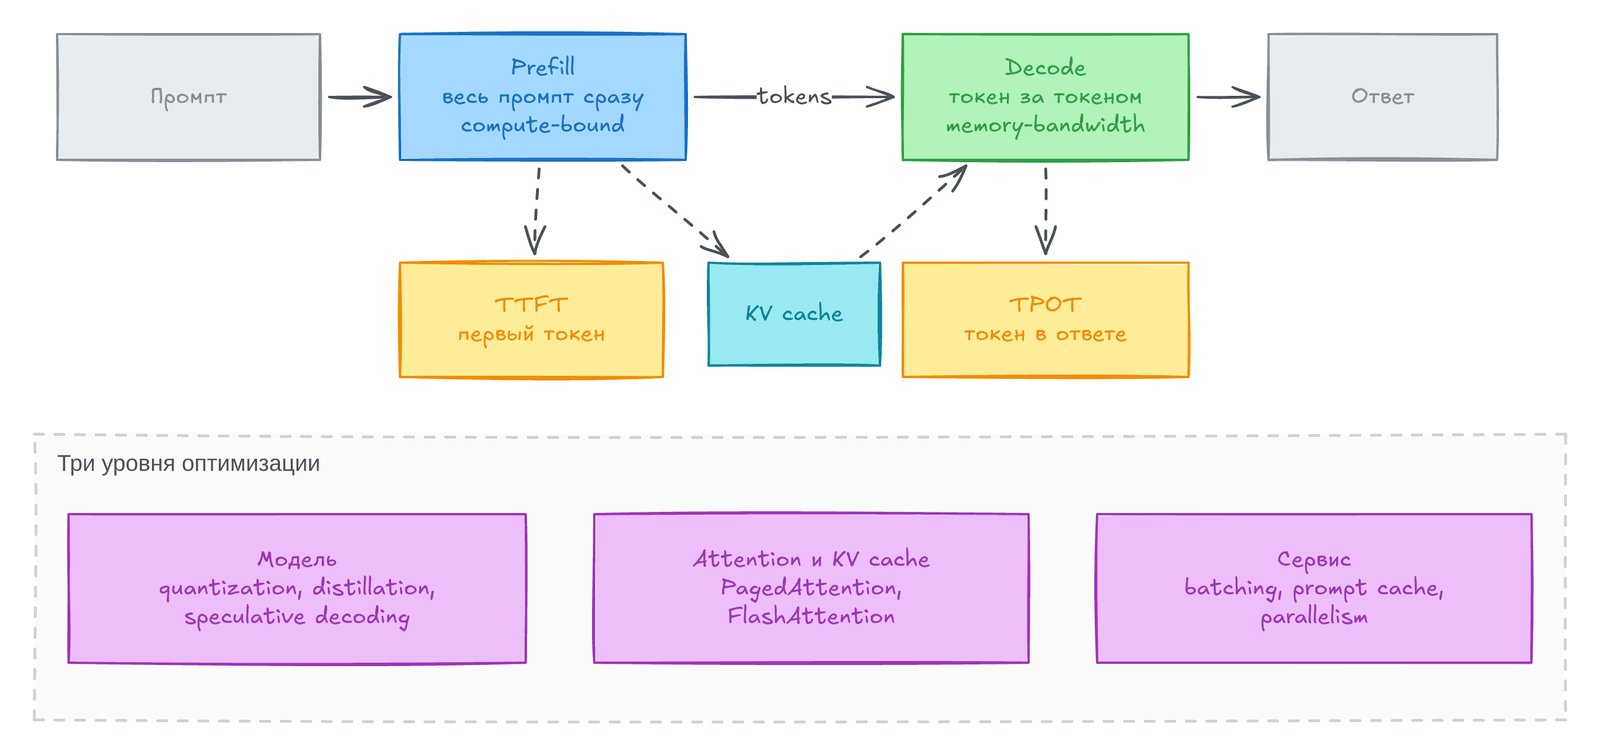
Если вы вызываете API OpenAI или Google, большую часть этих приёмов делает провайдер. Если вы сами хостите open-source модель, inference-сервис становится вашей задачей. Знать эти приёмы нужно в обоих случаях: так проще оценить провайдера или framework.
Как устроен inference
Заголовок раздела «Как устроен inference»Training создаёт модель. Inference считает ответ для входа. Inference-сервер хранит модель, получает запросы и выделяет под них ресурсы. Остальные части сервиса принимают запросы, маршрутизируют их и обрабатывают входные данные.
Оптимизация начинается с поиска узкого места. Их два вида:
| Тип | Что ограничивает скорость | Что помогает |
|---|---|---|
compute-bound | Число вычислений | Больше FLOP/s, несколько чипов |
memory-bandwidth-bound | Скорость передачи данных между памятью и процессором | Чипы с быстрой памятью, меньше байтов на параметр |
У LLM два шага:
- Prefill. Модель читает весь prompt параллельно. Скорость ограничена вычислениями. Шаг заполняет первый KV cache.
- Decode. Модель выдаёт по одному токену. На каждый токен нужно загрузить веса модели в вычислительные блоки. Скорость ограничена памятью.
Шаги разные, поэтому в production их часто разносят на разные машины. Длинный контекст сильнее нагружает prefill и память.
Online и batch API
Заголовок раздела «Online и batch API»| API | Цель | Когда брать |
|---|---|---|
| Online | Низкая latency | Чат-бот, подсказки в IDE |
| Batch | Низкая цена | Ночные отчёты, разметка тикетов, переиндексация базы знаний |
Batch API у крупных провайдеров обычно стоит примерно вполовину дешевле, но отвечает часами. Для data engineer это удобный вариант: ночной job по классификации тикетов или генерации описаний колонок не требует быстрого ответа.
Не путайте с классическим ML. Там batch inference значит “предсказания посчитаны заранее”. Для LLM prompt открытый, заранее все запросы не посчитать.
Streaming отдаёт токены по мере генерации. Пользователь ждёт первый токен меньше. Минус: вы не успеваете проверить ответ до показа.
Метрики inference
Заголовок раздела «Метрики inference»| Метрика | Что измеряет |
|---|---|
TTFT (time to first token) | Время до первого токена. Это время prefill. Растёт с длиной входа |
TPOT (time per output token) | Время на каждый следующий токен. Это время decode |
| Latency | TTFT + TPOT × число выходных токенов |
| Throughput | Сколько выходных токенов в секунду выдаёт весь сервис |
| Goodput | Сколько запросов в секунду уложились в SLO |
| Utilization | Какую часть мощности железа вы реально используете |
Важные детали:
- Две системы с одинаковой latency могут ощущаться по-разному. Одной нужен быстрый первый токен, другой быстрый поток.
- Для чтения глазами TPOT около 120 мс (6-8 токенов в секунду) обычно хватает.
- Если модель сначала думает или вызывает tools, пользователь видит первый токен позже, чем модель его произвела. Считайте TTFT с точки зрения пользователя.
- Latency это распределение. Среднее обманывает: один запрос на 3 секунды портит среднее у девяти по 100 мс. Смотрите перцентили
p50,p90,p95,p99.
Throughput, цена и goodput
Заголовок раздела «Throughput, цена и goodput»Throughput связан с ценой напрямую. Пример: железо стоит $2 в час и даёт 100 токенов в секунду. Это 360 000 токенов в час, то есть около $5,56 за 1 млн выходных токенов. Если ответ в среднем 200 токенов, 1000 ответов стоят около $1,11. Prefill считают так же и добавляют к decode.
Throughput и latency конфликтуют. Batching поднимает throughput, но может замедлить каждый запрос. Если смотреть только на throughput и цену, получится плохой UX. Поэтому есть goodput.
Пример: SLO это TTFT ≤ 200 мс и TPOT ≤ 100 мс. Сервис обрабатывает 100 запросов в минуту, но SLO выполняют 30. Goodput равен 30 запросов в минуту.
Utilization: MFU и MBU
Заголовок раздела «Utilization: MFU и MBU»nvidia-smiпоказывает долю времени, когда GPU чем-то занят. Это не доля используемой мощности. GPU может показывать 100 % и выполнять 1 % возможных операций.MFU(Model FLOPs Utilization) равен фактическому throughput, делённому на теоретический максимум при пиковых FLOP/s.MBU(Model Bandwidth Utilization) равен используемой пропускной способности памяти, делённой на пиковую.
Формула для LLM: параметры × байты на параметр × токены в секунду. Пример: модель 7B в FP16 (2 байта) при 100 токенах в секунду читает 700 ГБ/с. На чипе с памятью 2 ТБ/с это MBU 35 %. Если квантизовать веса до 8 бит, нужно вдвое меньше полосы.
Высокая utilization сама по себе не цель. Важно, чтобы задачи шли быстрее и дешевле.
AI-ускорители
Заголовок раздела «AI-ускорители»Ускоритель это чип для одного типа вычислений. Главный тип для AI это GPU. CPU имеет мало мощных ядер для сложных последовательных задач. GPU имеет тысячи простых ядер для параллельной работы. Основа ML это умножение матриц, и оно хорошо параллелится.
Есть и другие чипы: TPU, AWS Inferentia, Gaudi и другие. Часть из них заточена под inference: ниже точность, быстрее память.
Три памяти, с которыми работает GPU:
| Память | Скорость | Размер |
|---|---|---|
| CPU DRAM | Самая медленная (25-50 ГБ/с) | От десятков ГБ до ТБ |
| GPU HBM | Быстрая (от 256 ГБ/с до 1,5 ТБ/с и выше) | Десятки ГБ |
| On-chip SRAM | Самая быстрая (10 ТБ/с и выше) | Около 40 МБ и меньше |
Оптимизация GPU это в основном вопрос того, как использовать эту иерархию.
Как выбрать чип. Сначала определите узкое место. Для compute-bound нужны чипы с большими FLOP/s. Для memory-bound нужны чипы с широкой и большой памятью. Три вопроса: справится ли чип с нагрузкой, как быстро, сколько стоит. Первые два решают три числа: FLOP/s, размер памяти, пропускная способность памяти. В облаке цена почти у всех похожа и зависит от времени использования. Энергия тоже важна: H100 при полной нагрузке за год потребляет около 7000 кВт·ч.
Оптимизация модели
Заголовок раздела «Оптимизация модели»Эти приёмы меняют саму модель. Поведение может немного измениться. Три причины тяжёлого inference: размер модели, авторегрессивный decode, attention.
- Quantization. Меньше бит на параметр: память и нужная полоса падают. Самый популярный приём: простой, работает на многих моделях. Предел: меньше 1 бита не бывает.
- Distillation. Маленькая модель учится копировать большую.
- Pruning. Убираем узлы сети или обнуляем наименее полезные веса. В книге результаты обещающие, но на практике приём редкий: нужно знать архитектуру, выигрыш часто меньше, и не всё железо умеет использовать разреженные матрицы.
Обход авторегрессивного bottleneck
Заголовок раздела «Обход авторегрессивного bottleneck»Выходной токен у API стоит в 2-4 раза дороже входного. По замеру Anyscale один выходной токен влияет на latency как около 100 входных.
Speculative decoding. Быстрая слабая draft-модель предлагает K токенов. Основная target-модель проверяет их все сразу, параллельно. Берётся самое длинное начало, с которым она согласна, плюс один свой токен. Почему это работает:
- Проверка параллельна, генерация последовательна.
- Часть токенов легко угадать, и слабая модель с ними справляется.
- Decode ограничен памятью, поэтому свободные FLOP/s используются для проверки.
Качество ответа не меняется. Пример из книги: draft-модель 4B ускорила Chinchilla-70B больше чем вдвое. Приём встроен в vLLM, TensorRT-LLM, llama.cpp. Draft лучше работает на структурном тексте, например на коде. Он также должен иметь тот же tokenizer, что target.
Inference with reference. Вместо draft-модели токены копируются из входа. Полезно, когда ответ повторяет контекст: RAG, правка кода, диалоги. Книга показывает ускорение до 2 раз.
Parallel decoding. Модель выдаёт несколько будущих токенов сразу, не дожидаясь предыдущих, потом проверяет их. Примеры: lookahead decoding и Medusa (дополнительные “головы” предсказывают токены вперёд). Идея интересная, но реализовать сложно.
Оптимизация attention и KV cache
Заголовок раздела «Оптимизация attention и KV cache»При генерации токена модель нужны key и value векторы всех прошлых токенов. Чтобы не считать их заново, их хранят в KV cache. Только inference использует его: при обучении все токены известны сразу.
Размер cache растёт линейно с длиной последовательности и с размером batch. Число вычислений attention растёт квадратично. Формула: 2 × batch × длина × слои × размерность × байты.
Пример по книге: Llama 2 13B (40 слоёв, размерность 5120), batch 32, длина 2048, 2 байта. Cache занимает около 54 ГБ. Это один cache без оптимизаций. Если batch равен 1, останется около 1,7 ГБ. Длинный контекст и большой batch быстро съедают память.
Три группы приёмов:
| Группа | Приёмы | Что делают |
|---|---|---|
| Перепроектировать attention | Локальное окно, cross-layer attention, multi-query attention, grouped-query attention | Меньше пар key-value. Применяются только на этапе training или finetuning |
| Управлять KV cache | PagedAttention (vLLM), квантизация cache, сжатие cache | Cache режется на блоки, меньше фрагментации, память делится гибко |
| Быстрые kernels | FlashAttention | Сливает несколько операций в один проход |
Пример эффекта: Character.AI сообщает, что комбинация приёмов уменьшила KV cache более чем в 20 раз при диалогах в среднем по 180 сообщений.
Kernels и compilers
Заголовок раздела «Kernels и compilers»Kernel это код, оптимизированный под конкретный чип. Пишут на CUDA, Triton, ROCm. Базовые техники:
vectorization: обрабатывать много элементов за раз;parallelization: делить массив на независимые части;loop tiling: подгонять порядок обращений к памяти под кэш чипа;operator fusion: объединять операции в один проход, меньше обращений к памяти.
Для нового чипа kernels нужно писать заново. Поэтому FlashAttention имеет версии под A100 и H100. Compiler переводит код модели в операции для чипа и подставляет kernels. Примеры: torch.compile, XLA, TensorRT, Apache TVM.
В кейсе PyTorch для Llama-7B на A100 throughput росло шагами: torch.compile, потом INT8, потом INT4, потом speculative decoding. Влияние на качество ответов в кейсе не проверяли.
Оптимизация сервиса
Заголовок раздела «Оптимизация сервиса»Эти приёмы меняют не модель, а способ обслуживания. Качество ответов не должно измениться. Цель: распределить ресурсы между запросами так, чтобы упали latency и цена.
Batching
Заголовок раздела «Batching»Запросы обрабатываются группами. Аналогия: автобус вместо отдельных машин.
| Вид | Как работает | Минус |
|---|---|---|
| Static | Ждём полный batch фиксированного размера | Ранний запрос ждёт последний |
| Dynamic | Запускаем при полном batch или по таймауту (например, 100 мс) | Batch бывает неполным |
| Continuous (in-flight) | Готовый ответ уходит сразу, на его место встаёт новый запрос | Сложнее в реализации |
Для LLM лучше всего continuous. Иначе короткий ответ в 10 токенов ждёт длинный в 1000.
Разделение prefill и decode
Заголовок раздела «Разделение prefill и decode»Prefill и decode на одной GPU мешают друг другу: новый prefill отнимает вычисления у текущего decode и замедляет TPOT. Если развести их по разным GPU, throughput при тех же SLO заметно растёт. Цена: передача промежуточного состояния между машинами. Внутри узла с быстрой связью она невелика.
Соотношение prefill к decode зависит от нагрузки. Длинные входы и упор на TTFT: примерно от 2:1 до 4:1. Короткие входы и упор на TPOT: от 1:2 до 1:1.
Prompt caching
Заголовок раздела «Prompt caching»Многие prompts имеют общую часть: system prompt, длинный документ, история диалога. Cache хранит её обработку, и повторно её не считают. Его также называют context cache или prefix cache.
- Prompt в 1000 токенов и миллион вызовов в день: cache экономит около миллиарда обработанных токенов в сутки.
- Cache занимает память, как KV cache. Собственная реализация требует усилий.
- Провайдеры дают скидки. По данным книги на момент написания: у Gemini скидка 75 % на cached токены плюс плата за хранение. Anthropic обещает до 90 % экономии и до 75 % меньше latency.
- Пример: чат с книгой в 100 000 токенов: TTFT 11,5 с без cache и 2,4 с с cache, цена ниже на 90 %.
Parallelism
Заголовок раздела «Parallelism»| Вид | Что делает | Плюс | Минус |
|---|---|---|---|
| Replica | Несколько копий модели | Просто, больше одновременных запросов | Нужно больше чипов |
| Tensor | Делит операцию (например, матрицу) между устройствами | Модель помещается, latency падает | Затраты на связь |
| Pipeline | Делит модель на стадии по устройствам | Большие модели, больше throughput | Растёт latency, для inference с жёсткой latency не любят |
| Context и sequence | Делят длинный вход между устройствами | Длинный контекст | Редко применяют |
Подбор копий моделей под GPU разного размера это задача упаковки (bin packing). Она усложняется с числом моделей и чипов.
Что работает чаще всего: quantization, tensor parallelism, replica parallelism и оптимизация attention. Выбор зависит от нагрузки: KV cache важнее для длинного контекста, prompt caching для длинных повторяющихся prompts и многоходовых диалогов. Нужна низкая latency: добавляйте replicas.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- MoE изменил расчёт памяти и цены. Всю модель надо держать в памяти, но считается только часть экспертов на токен.
- FP8 стал стандартом, FP4 приходит. Чипы Blackwell (B200) поддерживают FP4. Quantization из главы теперь часть обычного serving.
- Disaggregated serving. Prefill и decode на разных GPU, как в главе, стал промышленной практикой (NVIDIA Dynamo, llm-d). Главные open-source движки: vLLM и SGLang.
- KV cache стал меньше. Новые схемы attention (например, MLA у DeepSeek) сжимают cache. Расчёт размера cache из главы годится для классической attention.
- Prompt caching есть у всех крупных API. Скидки и правила изменились с момента выхода книги. Проверяйте текущую документацию провайдера.
- Reasoning модели меняют метрики. TTFT может быть большим из-за thinking-токенов. Смотрите на время до полного ответа и цену на задачу.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
inference | Расчёт ответа обученной моделью |
prefill | Первый шаг: параллельная обработка входа. Compute-bound |
decode | Второй шаг: генерация по одному токену. Memory-bandwidth-bound |
TTFT | Время до первого токена |
TPOT | Время на один следующий токен |
throughput | Токены (или запросы) в секунду по всему сервису |
goodput | Запросы в секунду, которые уложились в SLO |
MFU / MBU | Доля использованных FLOP/s и пропускной способности памяти |
HBM | Быстрая память GPU |
quantization | Меньше бит на параметр |
speculative decoding | Draft-модель предлагает токены, target проверяет |
KV cache | Сохранённые key и value векторы прошлых токенов |
PagedAttention | Хранение KV cache блоками, меньше фрагментации |
FlashAttention | Kernel, который сливает операции attention |
continuous batching | Batch, в который новые запросы входят по мере выхода готовых |
prompt caching | Повторное использование обработки общей части prompt |
tensor parallelism | Деление одной операции между устройствами |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте API по задаче. Ночные job (разметка тикетов, описания колонок, переиндексация) отправляйте в batch API: примерно вдвое дешевле. Интерактивные функции держите на online API.
- Ставьте метрики с первого дня. Логируйте TTFT, TPOT, число входных и выходных токенов, перцентили
p95иp99. Одно среднее значение вводит в заблуждение. - Считайте цену на запрос. Ведите в warehouse таблицу вызовов: модель, токены на входе и выходе, cached токены, latency, цена. Из неё удобно строить модели в
dbtи дашборды по стоимости. - Выходные токены дороже входных. Короткие ответы и ограничение длины вывода экономят деньги. Смотрите на структуру ответа (например, JSON вместо длинного текста).
- Используйте prompt caching. Ставьте стабильную часть prompt (инструкции, схема таблиц, примеры) в начало, переменную часть в конец. Иначе общий префикс не сработает.
- Следите за провайдерами. Одна и та же модель у разных провайдеров может давать чуть разное качество из-за их оптимизаций. Прогоняйте свой evaluation-набор при смене провайдера или версии quantization.
- Не верьте GPU utilization. Высокий показатель в
nvidia-smiне значит, что вы платите не зря. Считайте цену и goodput. - Свой хостинг. Проверьте, закрывает ли ваш framework (vLLM и аналоги) continuous batching, PagedAttention, prefix caching и tensor parallelism. Без них вы платите за простой железа.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему prefill упирается в вычисления, а decode в память? Как это влияет на TTFT и TPOT?
- Сервис обрабатывает 200 запросов в минуту, но SLO выполняют 80. Чему равен goodput? Почему он полезнее throughput?
- Как speculative decoding ускоряет генерацию и почему качество ответа не меняется?
- Что такое KV cache и почему он ограничивает длину контекста и размер batch? Какие три группы приёмов его уменьшают?
Предыдущая: Dataset engineering. Следующая: Архитектура и обратная связь от пользователей.