

Designing Data-Intensive Applications, глава 7: Транзакции
Главная мысль: Транзакция группирует несколько операций в одну: либо все выполнены, либо ни одна. Но гарантии зависят от уровня изоляции. Большинство баз по умолчанию дают слабую изоляцию, и от неё бывают скрытые баги.
Что такое транзакция
Заголовок раздела «Что такое транзакция»- Транзакция объединяет чтения и записи в одну логическую единицу.
- Результат:
commit(успех) илиabort(откат). После abort можно безопасно повторить. - Приложению не нужно думать о частичных сбоях.
- Не всем приложениям нужны транзакции. Для простых операций над одной записью их можно не использовать.
- Мнение «транзакции убивают масштабируемость» и мнение «без них нет серьёзных данных» автор считает преувеличением.
| Буква | Что значит на самом деле |
|---|---|
| Atomicity | Если сбой случился посреди серии записей, все записи отменяются. Это не про параллелизм. Точнее: abortability |
| Consistency | Инварианты данных всегда верны. Это свойство приложения, не базы. База проверяет только constraints (unique, foreign key) |
| Isolation | Параллельные транзакции не мешают друг другу. Идеал: результат такой же, как при последовательном выполнении (serializability) |
| Durability | После commit данные не потеряются при сбое. Абсолютной durability нет: помогают диск, репликация и backup вместе |
- «ACID-compliant» сегодня почти маркетинговый термин. Реальные гарантии у разных баз разные.
- Слово BASE означает просто «не ACID».
Операции над одним и несколькими объектами
Заголовок раздела «Операции над одним и несколькими объектами»- Почти все движки дают atomicity и isolation для одного объекта (одной строки или документа): log для восстановления и lock на объект.
- Есть и атомарные операции:
incrementиcompare-and-set. Это не транзакции. Название «lightweight transactions» вводит в заблуждение. - Multi-object транзакции нужны, когда данные надо держать в синхроне:
- foreign keys в реляционной модели;
- денормализованные поля, например счётчик непрочитанных писем;
- secondary indexes: индекс и таблица обновляются вместе.
- В реляционных базах транзакция определяется соединением: всё между
BEGINиCOMMIT. - Многие NoSQL-базы имеют multi-put, но он не атомарный: часть ключей может записаться, часть нет.
Ошибки и повторы
Заголовок раздела «Ошибки и повторы»Retry после abort полезен, но не идеален:
| Проблема | Что делать |
|---|---|
| Commit прошёл, но подтверждение потерялось в сети. Повтор выполнит транзакцию дважды | Дедупликация на уровне приложения |
| Ошибка из-за перегрузки. Повторы ухудшают ситуацию | Лимит повторов, exponential backoff |
| Постоянная ошибка (нарушен constraint) | Не повторять. Повторять только transient errors: deadlock, failover |
| Побочные эффекты вне базы (письмо, платёж) | Двухфазный commit (2PC) или идемпотентность |
| Клиент упал во время retry | Данные теряются |
ORM вроде ActiveRecord и Django обычно не повторяют aborted транзакции. Ошибка просто доходит до пользователя.
Слабые уровни изоляции
Заголовок раздела «Слабые уровни изоляции»Ошибки параллелизма редко воспроизводятся в тестах. Они зависят от тайминга. Поэтому многие базы дают не serializable, а слабую изоляцию. Конкретные аномалии разобраны ниже.
Read committed
Заголовок раздела «Read committed»Две гарантии:
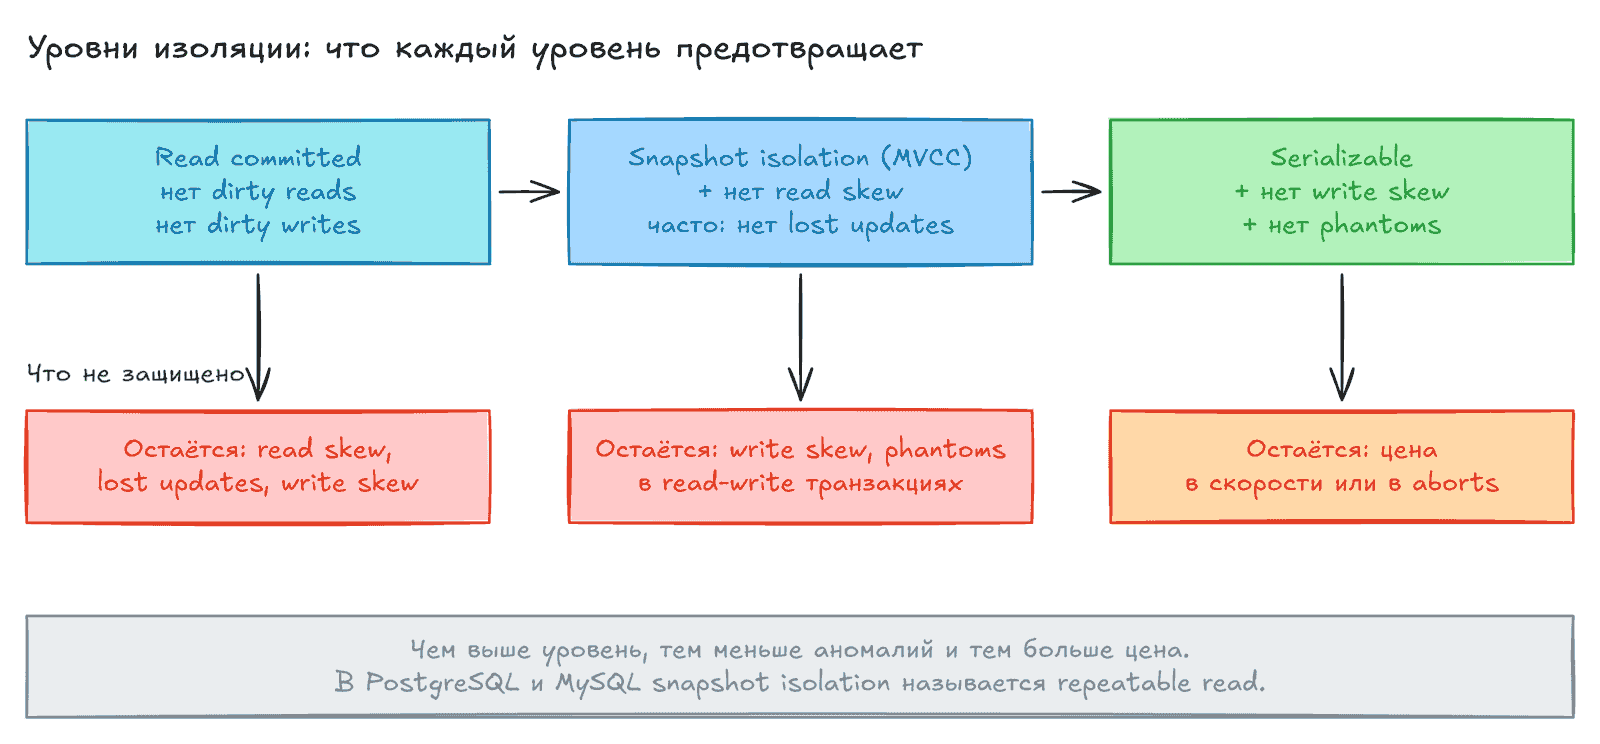
- No dirty reads. Читаются только закоммиченные данные.
- No dirty writes. Нельзя перезаписать незакоммиченные данные другой транзакции.
Как реализуется:
- Dirty writes предотвращают row-level locks. Lock держится до commit или abort.
- Dirty reads предотвращают хранением двух версий: старой закоммиченной и новой. Читатели видят старую. Read locks не используют: длинная запись заблокировала бы всех читателей.
Это уровень по умолчанию в PostgreSQL, Oracle, SQL Server. Он не защищает от read skew и lost updates.
Snapshot isolation и repeatable read
Заголовок раздела «Snapshot isolation и repeatable read»Read skew (non-repeatable read): транзакция видит разные части базы в разные моменты. Пример: перевод денег между счетами. Пользователь видит один счёт до перевода, второй после, и сумма меньше.
Для обычного UI это временная проблема. Для backup и аналитических запросов это опасно: несогласованность остаётся навсегда или даёт неверный результат.
Snapshot isolation решает это. Каждая транзакция читает consistent snapshot: данные, закоммиченные на момент старта.
Как это работает (MVCC, multiversion concurrency control):
- Каждая версия строки помечена
created byиdeleted by(ID транзакций). - Update = пометка старой версии удалённой + создание новой.
- Старые версии удаляет фоновый garbage collection.
- Правило: транзакция игнорирует записи тех, кто был в процессе на её старте, кто откатился или кто стартовал позже.
- Принцип: readers never block writers, writers never block readers.
- Индексы указывают на все версии. Альтернатива: append-only B-trees (CouchDB, Datomic, LMDB). Каждая запись создаёт новый корень, а корень = snapshot.
Путаница в названиях:
| Система | Как называет snapshot isolation |
|---|---|
| PostgreSQL, MySQL | repeatable read |
| Oracle | serializable (на самом деле это не serializable) |
| IBM DB2 | repeatable read означает serializability |
Стандарт SQL не знает snapshot isolation, поэтому термин «repeatable read» неоднозначен.
Lost updates
Заголовок раздела «Lost updates»Проблема: два клиента делают цикл read-modify-write. Одно изменение теряется. Примеры: счётчик, изменение JSON-документа, правка wiki-страницы.
Решения:
| Способ | Суть |
|---|---|
| Atomic write operations | UPDATE ... SET value = value + 1. Лучший вариант, если подходит |
| Explicit locking | SELECT ... FOR UPDATE. Легко забыть lock в одном месте |
| Автоматическое обнаружение | База сама abort-ит транзакцию. Есть в PostgreSQL repeatable read, Oracle serializable, SQL Server snapshot. В MySQL/InnoDB repeatable read нет |
| Compare-and-set | WHERE content = 'old'. Небезопасно, если WHERE читает старый snapshot |
В репликации с multi-leader или leaderless locks и compare-and-set не работают. Нужны conflict resolution и commutative операции (счётчики, множества, как в Riak). Стратегия last write wins (LWW) теряет обновления, а во многих базах она по умолчанию.
Write skew и phantoms
Заголовок раздела «Write skew и phantoms»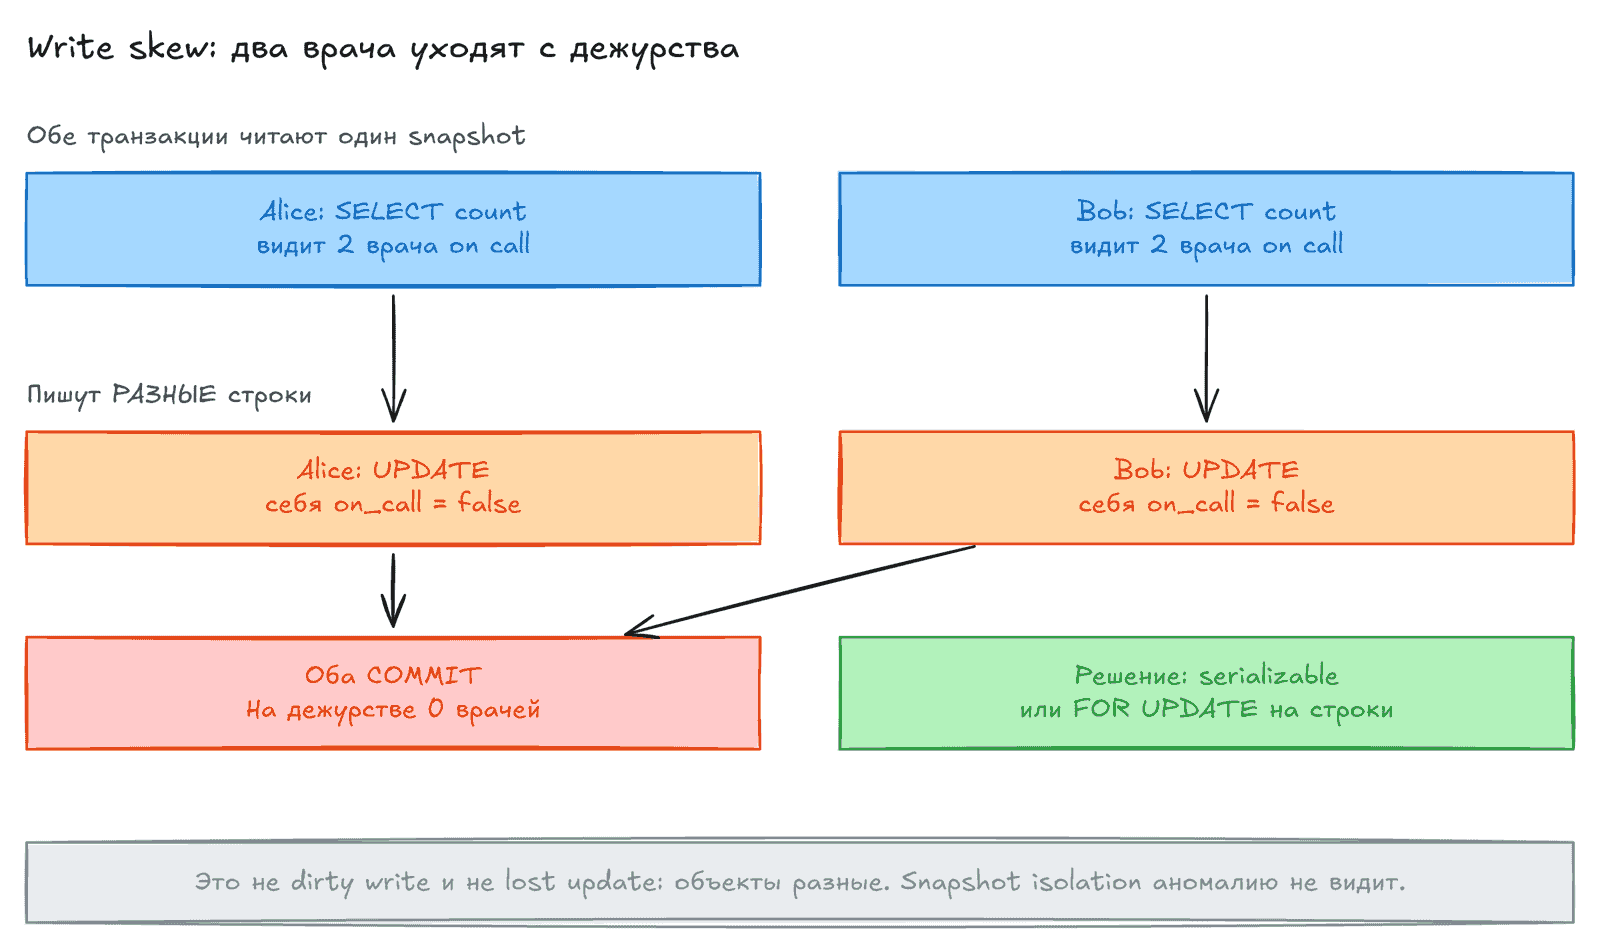
Write skew: две транзакции читают одни данные, принимают решение и пишут в разные объекты. Каждая в отдельности корректна. Вместе они нарушают инвариант.
Примеры:
- на дежурстве должен остаться хотя бы один врач;
- двойное бронирование переговорной;
- один и тот же username у двух пользователей;
- расход средств сверх баланса;
- две фигуры на одной клетке.
Что помогает:
- Atomic операции и автоматическое обнаружение lost updates не помогают.
- Constraints (unique) помогают для username. Для сложных инвариантов их обычно нет.
FOR UPDATEна прочитанные строки помогает, если строки существуют.- Надёжно решает только serializable isolation.
Phantom: запись в одной транзакции меняет результат поискового запроса в другой. Если запрос проверяет отсутствие строк (нет брони на это время), FOR UPDATE не к чему привязать lock.
Materializing conflicts: создать таблицу «комната x временной слот» заранее и блокировать её строки. Это крайняя мера: механизм конкурентности попадает в модель данных.
Serializability
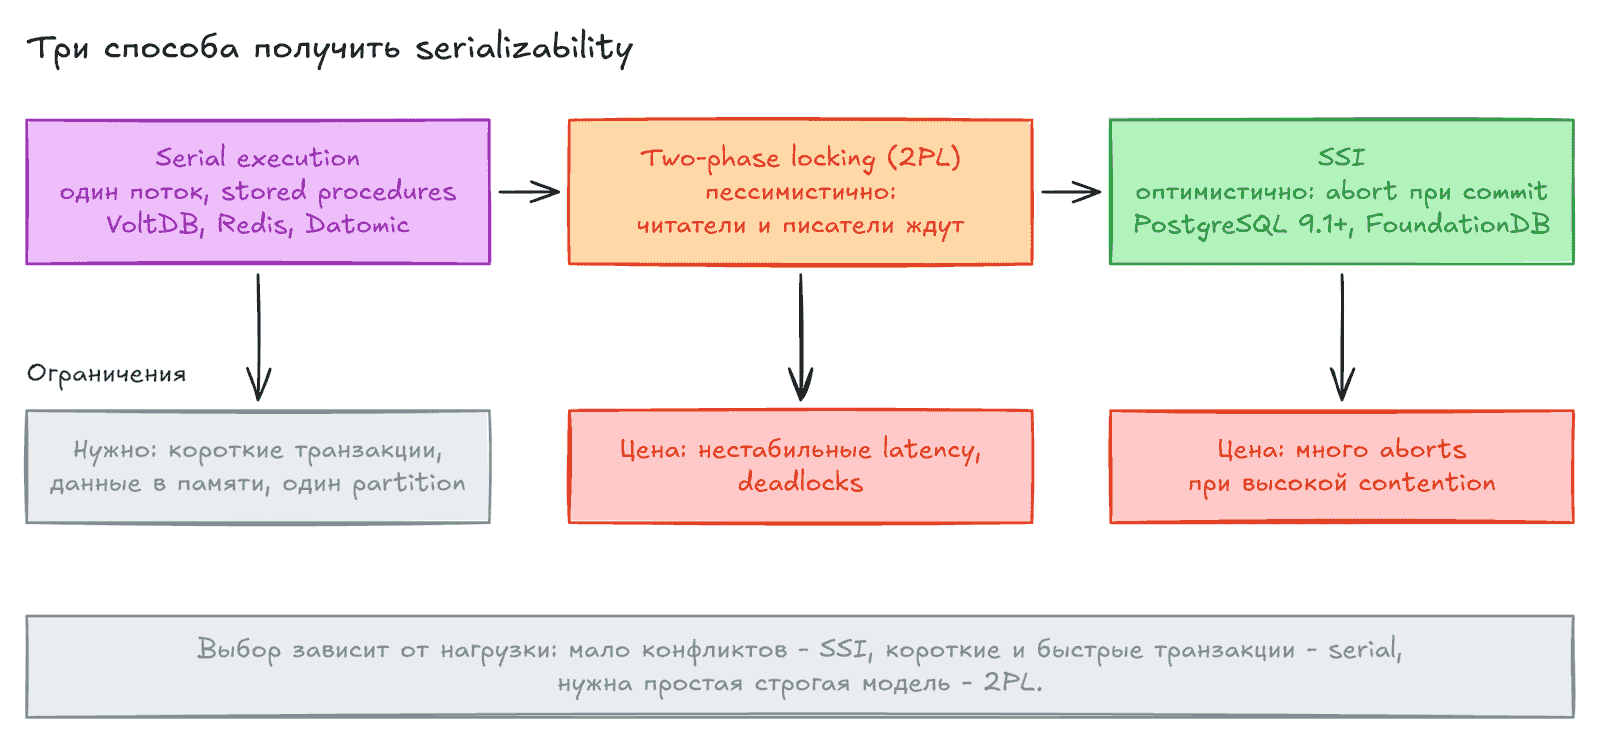
Заголовок раздела «Serializability»Serializable isolation: результат равен последовательному выполнению. Исследователи советуют её с 1970-х. Базы используют три техники.
Actual serial execution
Заголовок раздела «Actual serial execution»Транзакции выполняются по одной, в одном потоке. Это стало возможным с 2007 года:
- RAM дешёвая, активные данные помещаются в память;
- OLTP-транзакции короткие, а длинная аналитика идёт на snapshot вне цикла.
Применяется в VoltDB/H-Store, Redis, Datomic.
Условия:
- Транзакции передаются как stored procedure целиком, без интерактивных запросов (иначе время уйдёт на сетевые обмены).
- Процедуры должны быть детерминированными. VoltDB выполняет их на репликах.
- Для масштаба данные делят на partitions. Транзакция внутри одного partition быстрая. Cross-partition транзакции в сотни раз медленнее (в VoltDB порядка 1000 записей в секунду).
Ограничения: короткие транзакции, данные в памяти, низкая или partitioned нагрузка записи.
Two-phase locking (2PL)
Заголовок раздела «Two-phase locking (2PL)»Около 30 лет это был единственный распространённый способ. Не путать с 2PC (two-phase commit).
- Читатели блокируют писателей, писатели блокируют читателей.
- Shared lock для чтения, exclusive lock для записи.
- Фаза 1: locks берутся по ходу транзакции. Фаза 2: все отпускаются в конце.
- Используют MySQL (InnoDB) и SQL Server в serializable, DB2 в repeatable read.
- Deadlock: база находит и abort-ит одну транзакцию, приложение повторяет.
- Минус: низкая пропускная способность и нестабильные latency на высоких percentiles. Одна медленная транзакция тормозит остальные.
Для phantoms нужны блокировки по условию:
| Механизм | Суть | Минус |
|---|---|---|
| Predicate lock | Lock на все строки по условию, включая будущие | Медленная проверка |
| Index-range lock (next-key lock) | Упрощённая версия: lock на диапазон индекса | Блокирует чуть больше строк, но быстрее. Без индекса lock на всю таблицу |
Serializable snapshot isolation (SSI)
Заголовок раздела «Serializable snapshot isolation (SSI)»Оптимистичный подход поверх snapshot isolation (описан в 2008). Используют PostgreSQL с версии 9.1 и FoundationDB.
- Транзакции работают без блокировок.
- При commit база проверяет, не устарела ли premise (факт, на котором основано решение). Если да, транзакция abort-ится.
- Два случая, которые отслеживает база:
- транзакция прочитала старую версию (MVCC), а игнорируемая запись потом закоммитилась;
- другая транзакция записала данные, которые уже были прочитаны. Это tripwire на индексе: уведомление, а не блокировка.
- Плюсы: readers не блокируют writers, latency предсказуемее, не ограничена одним ядром.
- Минусы: при высокой contention много aborts. Read-write транзакции должны быть короткими.
Pessimistic vs optimistic
Заголовок раздела «Pessimistic vs optimistic»| Подход | Примеры | Когда лучше |
|---|---|---|
| Pessimistic | 2PL, serial execution | Высокая contention |
| Optimistic | SSI | Мало конфликтов, есть запас мощности |
Contention снижают commutative atomic операции (например, инкремент счётчика).
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Transaction | Группа операций, выполняемая как одна: commit или abort |
| ACID | Atomicity, Consistency, Isolation, Durability |
| Atomicity | Всё или ничего при сбое |
| Isolation | Параллельные транзакции не мешают друг другу |
| Durability | Закоммиченные данные не теряются |
| Dirty read | Чтение незакоммиченных данных другой транзакции |
| Dirty write | Перезапись незакоммиченных данных |
| Read skew | Транзакция видит базу в разные моменты времени |
| Snapshot isolation / MVCC | Чтение из consistent snapshot, хранение нескольких версий строки |
| Lost update | Одно из двух параллельных read-modify-write пропало |
| Write skew | Решение принято по устаревшему premise, записи в разные объекты |
| Phantom | Запись меняет результат чужого поискового запроса |
| Serializability | Результат такой же, как при последовательном выполнении |
| 2PL | Two-phase locking: пессимистичные shared и exclusive locks |
| SSI | Serializable snapshot isolation: оптимистичная проверка при commit |
| Stored procedure | Код транзакции, отправленный в базу целиком |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Узнайте, какой уровень изоляции реально у вашей базы по умолчанию.
repeatable readиserializableв разных системах значат разное. - Не пишите read-modify-write в коде приложения (особенно в ORM). Используйте atomic
UPDATEилиFOR UPDATE. - Проверки вида «если такой строки нет, создать» опасны. Используйте unique constraint или serializable.
- Делайте retry на transient ошибки (deadlock, serialization failure), с backoff и лимитом. Делайте операции идемпотентными: повтор не должен дублировать данные.
- Для backup, длинной аналитики и выгрузок в хранилище нужен consistent snapshot. Иначе данные получатся несогласованными.
- В пайплайнах без транзакций (многие NoSQL, потоки) сами следите за расхождением денормализованных данных и источника.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему буква C в ACID на самом деле свойство приложения, а не базы?
- Чем read skew отличается от lost update? Какой уровень изоляции защищает от первого?
- Почему
SELECT ... FOR UPDATEне спасает от phantoms при проверке «записи нет»? - Чем SSI отличается от 2PL и когда SSI работает хуже?
Предыдущая: Партиционирование. Следующая: Проблемы распределённых систем.