

AI Engineering, глава 8: Dataset Engineering
Главная мысль: Модель учится на данных, поэтому датасет решает многое. Хороший датасет нужно спроектировать: понять, чему учим модель, собрать данные, проверить и обработать. Это обычная работа data engineer, только с новыми проверками.
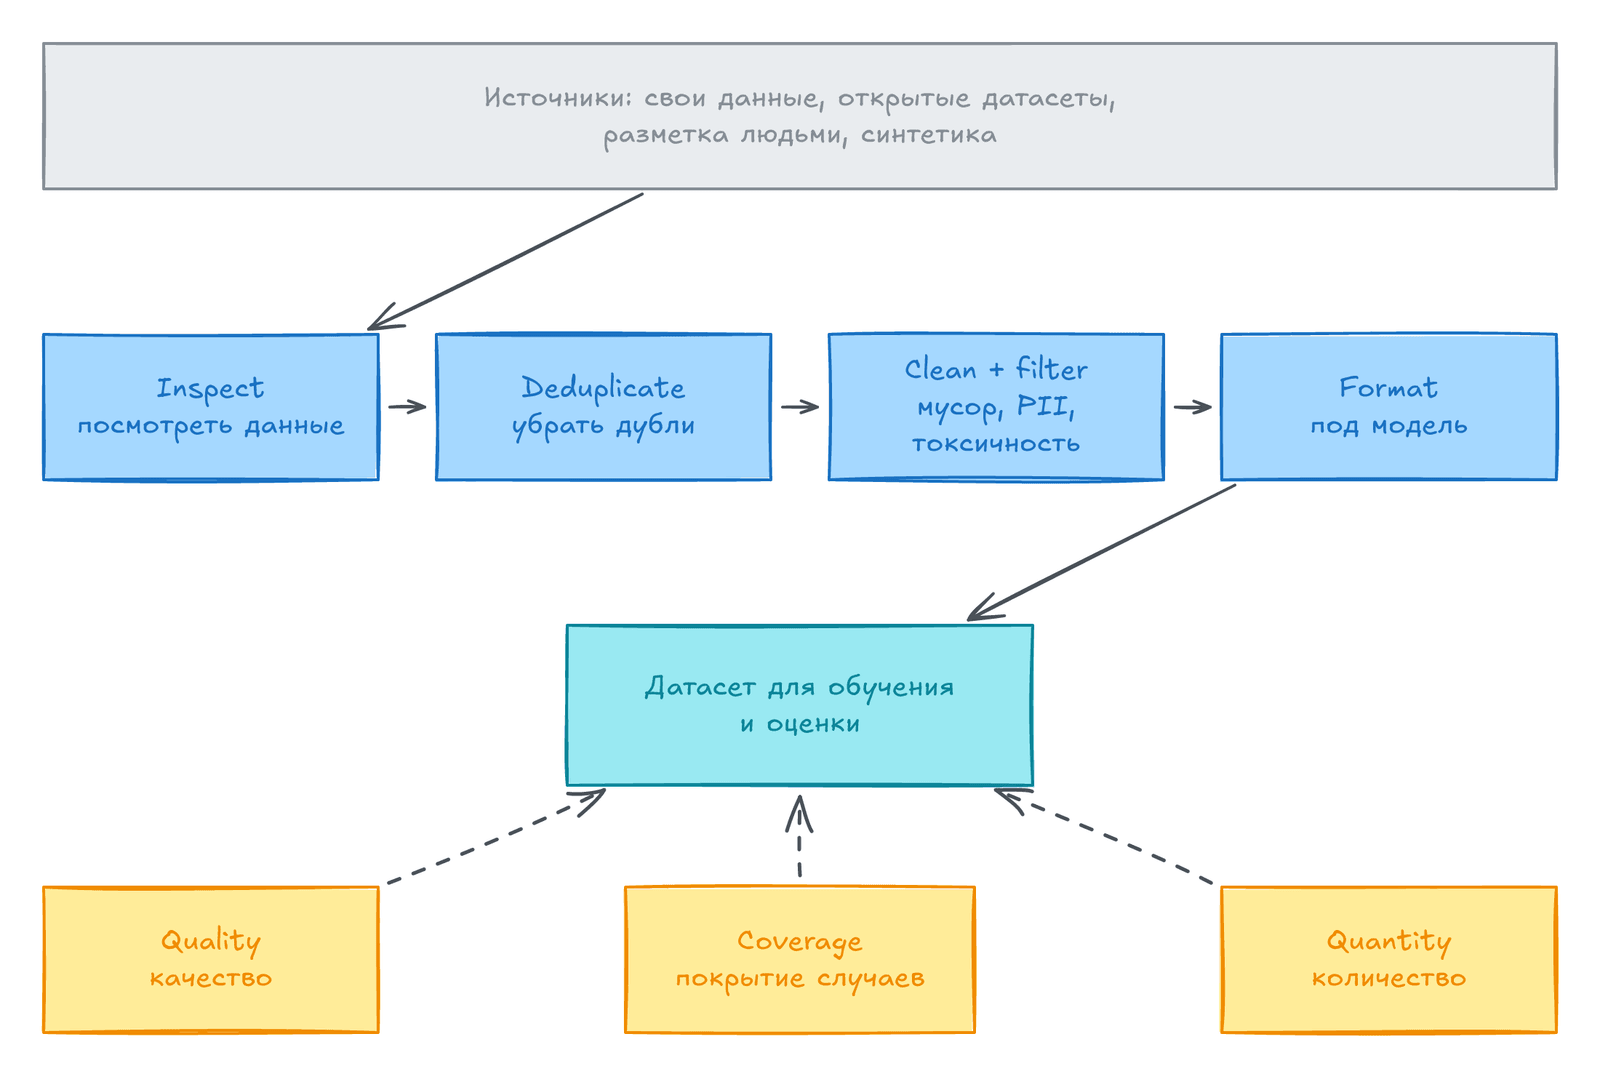
Глава в основном про post-training. Шаги не идут по прямой: нашли дыру в данных, значит нужно собрать ещё.
Взгляд с позиции данных
Заголовок раздела «Взгляд с позиции данных»- Model-centric AI: улучшаем модель: архитектура, размер, способ обучения.
- Data-centric AI: улучшаем данные. Лучше чистка и разметка при той же модели.
- Всё больше соревнований устроено так: модель зафиксирована, участники строят лучший датасет (DataComp).
- Компании редко обучают модели с нуля, поэтому данные стали главным способом выделиться. Работа с данными стала отдельной функцией: annotators, dataset creators, data quality engineers.
Какие данные нужны, зависит от задачи:
| Задача | Формат примера |
|---|---|
| Self-supervised finetuning | Последовательности текста |
| Instruction finetuning | (instruction, response) |
| Preference finetuning | (instruction, выигравший ответ, проигравший ответ) |
| Reward model | То же, или ((instruction, response), score) |
Данные должны показывать то поведение, которому вы учите модель. Сложное поведение собрать трудно:
- Chain-of-thought: нужны ответы по шагам. Писать их долго, поэтому таких датасетов мало.
- Tool use: человеку удобен сайт, модели удобнее API, поэтому разметка людьми не всегда оптимальна. Помогает симуляция.
- Multi-turn учит вести диалог, но данные сложнее, чем single-turn.
- Удаление данных: иногда нужно убрать плохие примеры. Бот лезет с непрошеными советами? Найдите такие примеры в обучении и уберите.
Data curation: три оси
Заголовок раздела «Data curation: три оси»Три оси: quality (чистота), coverage (разнообразие), quantity (объём).
Quality
Заголовок раздела «Quality»Малый чистый датасет часто лучше большого грязного. Команда Yi получила лучший результат на 10 тысячах тщательных инструкций, чем на сотнях тысяч шумных. В работе LIMA модель с 65B параметров дообучили на 1000 отобранных примерах. Люди оценили её ответы как равные GPT-4 или лучше в 43% случаев. Но такая модель была менее надёжной.
Шесть свойств качественных данных:
| Свойство | Что значит | Пример для SQL-ассистента |
|---|---|---|
| Relevant | Пример подходит задаче | Запросы к вашему warehouse, а не к старой СУБД |
| Aligned | Разметка соответствует требованиям задачи | Нужен короткий SQL: ответы без длинных пояснений |
| Consistent | Разные annotators дают похожие ответы | Две оценки “4 из 5” значат одно и то же |
| Correctly formatted | Нет мусора и ошибок формата | Убрать HTML, лишние пробелы, неверные типы колонок |
| Sufficiently unique | Мало дубликатов | Один и тот же вопрос не повторяется 100 раз |
| Compliant | Соблюдены законы и правила | Нет персональных данных клиентов |
Нужен annotation guideline: что такое хороший ответ, чем оценка 3 отличается от 4, может ли ответ быть верным, но бесполезным. LinkedIn называет эти правила одной из главных проблем пайплайна. Те же правила нужны для evaluation data (глава 4).
Coverage
Заголовок раздела «Coverage»Данные должны покрывать все типы запросов пользователей (diversity).
- Пользователи пишут с опечатками: добавьте такие примеры.
- Запросы короткие и длинные, на разных языках: нужны все виды.
Как выбрать смесь данных (data mix):
- Повторить реальное использование. Или через эксперименты: обучить несколько малых моделей на разных смесях и предсказать результат большой. Так делали в Meta для Llama 3.
- Смесь зависит от стадии: у Llama 3 кода и математики много в pre-training и SFT, и мало в preference finetuning.
В опыте авторов LIMA три набора по 2000 примеров (чистый без разнообразия, разнообразный без чистоты, и чистый и разнообразный) дали лучший результат у третьего. Но больше разнородных данных не всегда лучше: иногда результат падает.
Quantity
Заголовок раздела «Quantity»Сколько данных нужно, зависит от условий. Бывает один пример, бывают миллионы. Что влияет на объём:
| Фактор | Как влияет |
|---|---|
| Метод finetuning | Full finetuning нужно намного больше данных, чем LoRA (PEFT). Сотни или тысячи примеров: PEFT. Десятки тысяч и больше: можно full |
| Сложность задачи | Для классификации тональности нужно меньше, чем для вопросов по финансовым отчётам |
| Сила базовой модели | Чем сильнее модель, тем меньше примеров нужно. На 100 примеров сильная модель заметно лучше. На 550 тысячах разница почти исчезает |
Как действовать:
- Начните с малого датасета, например 50 примеров. Проверьте, растёт ли качество.
- Нет роста на малых данных: большой датасет редко поможет. Но сначала проверьте гиперпараметры, данные и prompt.
- Обучите модель на 25%, 50% и 100% данных. Постройте кривую. Крутой рост значит, что данные помогут. Плато значит, что нет.
- Ждите
diminishing returns: первые 1000 примеров дают больше, чем следующие. - Учтите бюджет: при 2 долларах за пример и бюджете 10 тысяч будет не больше 5000 примеров.
Можно снизить объём чистых данных: сначала дообучить модель на менее подходящих данных (близкая задача, документы, synthetic), потом на целевых. Это сложнее. Можно потратить больше compute и получить худшую модель.
Откуда брать данные
Заголовок раздела «Откуда брать данные»- Данные вашего приложения главные. Они точно подходят задаче и повторяют реальное распределение. Это основа
data flywheel: пользователи создают данные, данные улучшают продукт. - Готовые датасеты: Hugging Face, Kaggle, государственные порталы, cloud open data, датасеты из evaluation harness. Не доверяйте им слепо. Всегда проверяйте лицензию и происхождение. Лицензия может разрешать коммерцию, а часть данных внутри может её запрещать.
- Разметка вручную или с помощью AI. Нужны guideline и проверка.
Augmentation и synthesis
Заголовок раздела «Augmentation и synthesis»- Augmentation: новые данные из реальных. Пример: отразить картинку.
- Synthesis: данные, которые имитируют реальные, но сами не реальны.
- Synthetic data не заменяет человеческие данные полностью. Лучше всего работает смесь.
Зачем нужны synthetic data
Заголовок раздела «Зачем нужны synthetic data»| Цель | Пример |
|---|---|
| Больше quantity | Редкие события: аварии, редкая погода |
| Лучше coverage | Очень короткие и длинные тексты, adversarial примеры, редкий класс |
| Лучше quality | Tool use, сложные задачи по математике, preference-оценки модели стабильнее оценок разных людей |
| Privacy | Синтетические истории болезни или страховые случаи вместо реальных |
| Distillation | Обучить дешёвую модель повторять сильную (см. ниже) |
Классические способы
Заголовок раздела «Классические способы»- Rule-based: шаблоны и генератор значений (например,
Faker). Транзакция из полей: сумма, магазин, время, статус. Модели для fraud часто сначала учат на таких данных, пока нет реальных. AlphaGeometry обучили на 100 миллионах синтетических примеров. - Простые преобразования: поворот картинки, замена слова на синоним, замена гендерных слов для снижения bias.
- Perturbation: добавить шум. Модель становится устойчивее к атакам.
- Simulation: виртуальная среда вместо дорогого или опасного опыта (беспилотные авто, роботы, редкие финансовые сценарии). Она упрощает мир, поэтому есть проблема Sim2Real.
Synthesis с помощью AI
Заголовок раздела «Synthesis с помощью AI»- Симуляция API: модель имитирует ответы API, не вызывая его.
- Перефразирование: из запроса “Как сбросить пароль?” получаем много вариантов. MetaMath вырос с 15 тысяч примеров почти до 400 тысяч.
- Перевод. Данные из языков с большим объёмом в языки с малым. Качество можно проверить
back-translation: перевести обратно и сравнить с оригиналом. - Back-translation для кода. Из кода делаем объяснение, из объяснения снова код. Если код совпал по смыслу, объяснение берём в датасет.
Synthetic data чаще используют в post-training, чем в pre-training: AI лучше переупаковывает знания, чем создаёт новые.
Instruction data
Заголовок раздела «Instruction data»- Чтобы покрыть нужные темы, начните со списка тем, ключевых слов или шаблонов. Для каждого пункта генерируйте нужное число примеров. Сам список тоже может сделать AI.
- Alpaca: из 175 seed-примеров GPT-3 сгенерировал 52 000 пар. UltraChat: ChatGPT предложил темы и подтемы, затем инструкции и ответы.
- Reverse instruction: берём готовый длинный качественный текст и просим модель придумать инструкцию, которая его вызовет. Это снижает риск hallucination в ответе. Процесс можно повторять: слабая модель, новые данные, лучшая модель.
Llama 3 для кода построили пайплайн с проверками:
- AI пишет описания задач и решения на разных языках.
- Parser, linter и unit tests (их тоже пишет AI) проверяют код.
- Если проверка упала, модель получает ошибку и исправляет код.
- Код переводится на другие языки. Не прошедший тесты отбрасывается.
- AI пишет объяснения. Не прошедшие back-translation отбрасываются.
В итоге получили больше 2,7 миллиона примеров для SFT.
Как проверять synthetic data
Заголовок раздела «Как проверять synthetic data»- Functional correctness: запустить код и тесты. Поэтому код так часто синтезируют.
- AI judge: оценка 1-5, “хорошо или плохо” или проверка по требованиям.
- Фильтры: детектор hallucination, классификатор темы, anomaly detection, эвристики (пустые, короткие, повторы).
- Итоговый тест: растут ли метрики модели на реальной задаче.
- Position bias: NVIDIA спрашивала judge дважды, меняя порядок ответов. Пример принимали, только если победитель совпал.
Ограничения
Заголовок раздела «Ограничения»- Quality control: garbage in, garbage out. Нет проверки качества: не используйте данные.
- Поверхностная имитация. Ученик копирует стиль учителя, но не знания. Он может научиться выдавать ответы, похожие на решения, не умея решать. Так же может ошибаться и разметчик-человек.
- Model collapse. При рекурсивном обучении на данных модели редкие события исчезают. Если весь датасет synthetic, collapse неизбежен. Если смешать с реальными данными, его можно избежать. Точной доли никто не назвал. Есть и успехи: Nemotron-4 340B использовал 98% synthetic данных в instruction и preference этапах. Но это один цикл обучения.
- Потеря происхождения (lineage). Не видно, откуда пришли данные. Модель-генератор могла учиться на данных с нарушением авторских прав. Она могла видеть benchmark, и тогда оценка искажена.
Model distillation
Заголовок раздела «Model distillation»Distillation: маленькая модель (student) учится имитировать большую (teacher). Цель: дешевле и быстрее при похожем качестве.
- DistilBERT: на 40% меньше BERT, на 60% быстрее, 97% качества понимания.
- Alpaca: Llama-7B на данных text-davinci-003, всего 4% размера учителя.
- Лицензии многих моделей запрещают обучать другие модели на их ответах.
- Не любое обучение на synthetic data есть distillation. Student может превзойти teacher: Nemotron-4-340B-Instruct обошёл Mixtral, чьи данные использовал.
- Обучение на данных сильной модели помогает. Обучение на своих непроверенных данных может навредить.
Data processing
Заголовок раздела «Data processing»Порядок шагов выбирайте по стоимости: сначала тот, что дешевле или убирает больше данных. Практика:
- Сначала пробный запуск скриптов на малой части данных.
- Не меняйте данные на месте. Храните копию: баг в скрипте может испортить данные.
1. Inspect
Заголовок раздела «1. Inspect»- Постройте распределения: длина prompt и response, темы, языки. Режьте по источнику, времени, annotator. Ищите выбросы.
- Если разметок несколько, посчитайте расхождение между annotators.
- Смотрите данные вручную. 15 минут просмотра часто экономят часы. Попробуйте сами разметить несколько примеров и сравните.
- Ищите одинаковые запросы с разными ответами.
2. Deduplicate
Заголовок раздела «2. Deduplicate»Дубликаты искажают распределение, тратят compute и вызывают test contamination: пример в train, а копия в test. По данным Anthropic, если 0,1% данных повторить 100 раз, модель на 800M параметров ведёт себя как на 400M.
Сначала определите, что считать дубликатом: уровень (документ, абзац, предложение) и порог (точное совпадение или, например, 80%).
Методы:
| Метод | Как работает | Когда |
|---|---|---|
| Pairwise comparison | Сравниваем каждую пару: exact, n-gram, fuzzy или semantic | Малые данные. На больших дорого |
| Hashing | Раскладываем по buckets, сравниваем только внутри bucket: MinHash, Bloom filter | Большие данные |
| Dimensionality reduction | Сначала уменьшаем размерность, потом сравниваем | Embeddings, vector search |
3. Clean and filter
Заголовок раздела «3. Clean and filter»- Уберите лишнюю разметку: у Databricks удаление Markdown и HTML подняло accuracy на 20% и сократило длину ввода на 60%.
- Уберите то, что нельзя использовать: PII, чувствительные поля, защищённый авторским правом контент, токсичный текст.
- Уберите примеры низкого качества. Часто эвристику видно только при ручном просмотре. Пример: разметка во второй половине сессии хуже, вероятно из-за усталости.
- Данных больше бюджета? Сократите:
active learning,importance sampling,data pruning.
4. Format
Заголовок раздела «4. Format»- Модель ждёт свой tokenizer и
chat template(глава 5). Неверный шаблон даёт странные ошибки. - Prompt для finetuning короче: описание задачи и few-shot примеры не нужны, модель учится на примерах.
- На inference используйте тот же формат, что в обучении. Если учили на
burger -->, тоburger,Item: burger -->и лишний пробел в конце могут давать проблемы.
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Synthetic data стал основным источником для post-training. Большие лаборатории генерируют задачи и ответы моделями, а затем фильтруют проверками.
- Проверяемые данные ценнее всего. Для RLVR нужны задачи с автоматической проверкой: тесты для кода, точный ответ для математики, SQL с ожидаемым результатом. Дата-инженер может строить такие наборы из своих данных.
- Данные для оценки агентов. Нужны не пары «вопрос-ответ», а сценарии: стартовое состояние, задача, проверка итога.
- Пайплайн из главы (inspect, dedup, clean, format) не изменился.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Data-centric AI | Улучшаем качество модели через данные, а не архитектуру |
| Annotation guideline | Правила разметки: что такое хороший ответ |
| Synthetic data | Данные, созданные программой или моделью |
| Back-translation | Перевод туда и обратно для проверки |
| Model distillation | Обучение малой модели на выходах большой |
| Model collapse | Деградация при обучении на данных модели без real data |
| Data lineage | Происхождение и путь данных |
| Test contamination | Копии тестовых примеров попали в обучение |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Относитесь к датасету как к продукту. Версии, схема, владелец, документация. Это обычная data engineering работа.
- Храните сырые данные неизменными. Делайте слои: raw, cleaned, final. Так же, как в
dbt: исходные данные не трогаем, преобразования идут отдельными моделями. - Дедупликация и контроль утечек. Проверяйте пересечение train и eval по ключу или hash. Дубликаты портят метрики оценки.
- Добавьте data quality tests: пустые значения, длина, формат, язык, дубликаты, PII. Запускайте при каждой сборке.
- Следите за lineage. Для каждого примера храните источник, дату, версию guideline, annotator, модель-генератор и лицензию. Это нужно для аудита и compliance.
- Собирайте данные приложения заранее. Логи, ответы, feedback. Сразу продумайте схему, согласие и удаление PII.
- Считайте стоимость. Разметка, генерация, обработка, хранение. Считайте цену одного хорошего примера.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие шесть свойств у качественных данных? Приведите пример нарушения каждого.
- Как оценить, сколько данных нужно, не собирая огромный датасет?
- Почему обучение только на synthetic data опасно? Как снизить риск?
- В каком порядке выполнять inspect, deduplicate, clean и format? Что решает порядок?
Предыдущая: Finetuning. Следующая: Inference optimization.