

Fundamentals of Data Engineering, глава 8: Запросы, моделирование, трансформация
Главная мысль: на этом этапе сырые данные становятся полезными. Запрос читает данные. Модель задаёт структуру и бизнес-логику. Трансформация сохраняет результат для следующих шагов.
Запросы
Заголовок раздела «Запросы»Query читает данные (R в CRUD) или меняет их. В главе в основном речь об OLAP-системах и SQL. Термин database здесь значит движок запросов вместе с хранилищем: warehouse или Spark над S3.
| Группа SQL | Что делает | Примеры |
|---|---|---|
| DDL | Создаёт и удаляет объекты | CREATE, DROP |
| DML | Работает с данными | SELECT, INSERT, UPDATE, DELETE, MERGE |
| DCL | Управляет доступом | GRANT, REVOKE |
| TCL | Управляет транзакциями | COMMIT, ROLLBACK |
Жизнь запроса
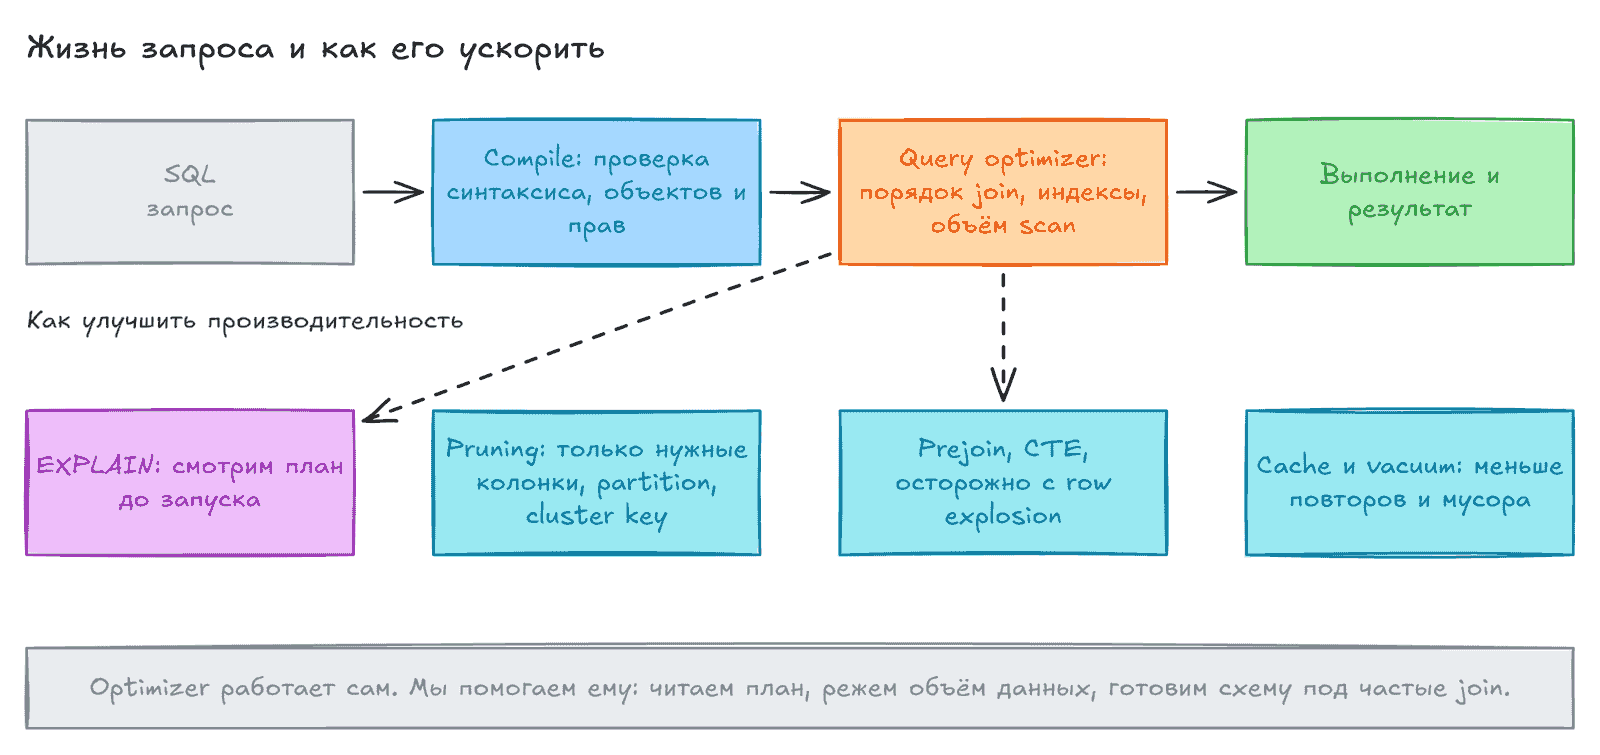
Заголовок раздела «Жизнь запроса»- База проверяет код: синтаксис, объекты, права.
- SQL превращается в bytecode.
- Query optimizer выбирает порядок шагов. Он учитывает join, индексы и объём scan.
- Запрос выполняется, результат возвращается.
Optimizer мы не настраиваем напрямую. Но нужно уметь читать explain plan.
Как ускорить запрос
Заголовок раздела «Как ускорить запрос»| Приём | Суть |
|---|---|
| Join и схема | Если одни и те же join повторяются, сделайте prejoin или широкую таблицу |
| Row explosion | Повторы в join-ключах дают произведение строк (5 × 10 = 50) и могут уронить запрос |
| CTE | Читаются лучше, чем вложенные subquery |
EXPLAIN | Смотрите план, а также диск, память, сеть, shuffle, конкуренцию запросов |
| Pruning | Не делайте SELECT *. В columnar берите нужные колонки, используйте partition и cluster key. В row-БД нужны индексы |
| Commits | Знайте модель транзакций вашей БД: ACID, dirty read, snapshot |
| Vacuum | Удаляйте старые версии записей: меньше bloat, точнее планы |
| Query cache | Повторный запрос может отработать за секунду вместо минуты |
Три примера commit-моделей:
- PostgreSQL: ACID, блокировки строк. Плохо подходит для больших analytics scan.
- BigQuery (похоже на Snowflake и Spark): читает последний snapshot, одна запись за раз, без блокировок на чтение.
- MongoDB: настраиваемая согласованность. В некоторых режимах при перегрузке молча теряет записи.
Правило: выбирайте БД и настройки под задачу. Плохих баз нет, есть неверное применение.
Запросы на streaming-данных
Заголовок раздела «Запросы на streaming-данных»Production-БД не стоит нагружать analytics scan. Поэтому появился шаблон fast follower: CDC копирует данные в OLAP-базу, запросы идут туда. Druid и BigQuery сочетают streaming buffer и columnar storage.
Ограничение: это те же SELECT по текущему состоянию. Мы не реагируем на события в потоке.
Kappa architecture хранит всё как события. Retention может быть месяцы или годы. Запрашивать можно прямо из streaming storage (KSQL) или через Spark и Flink.
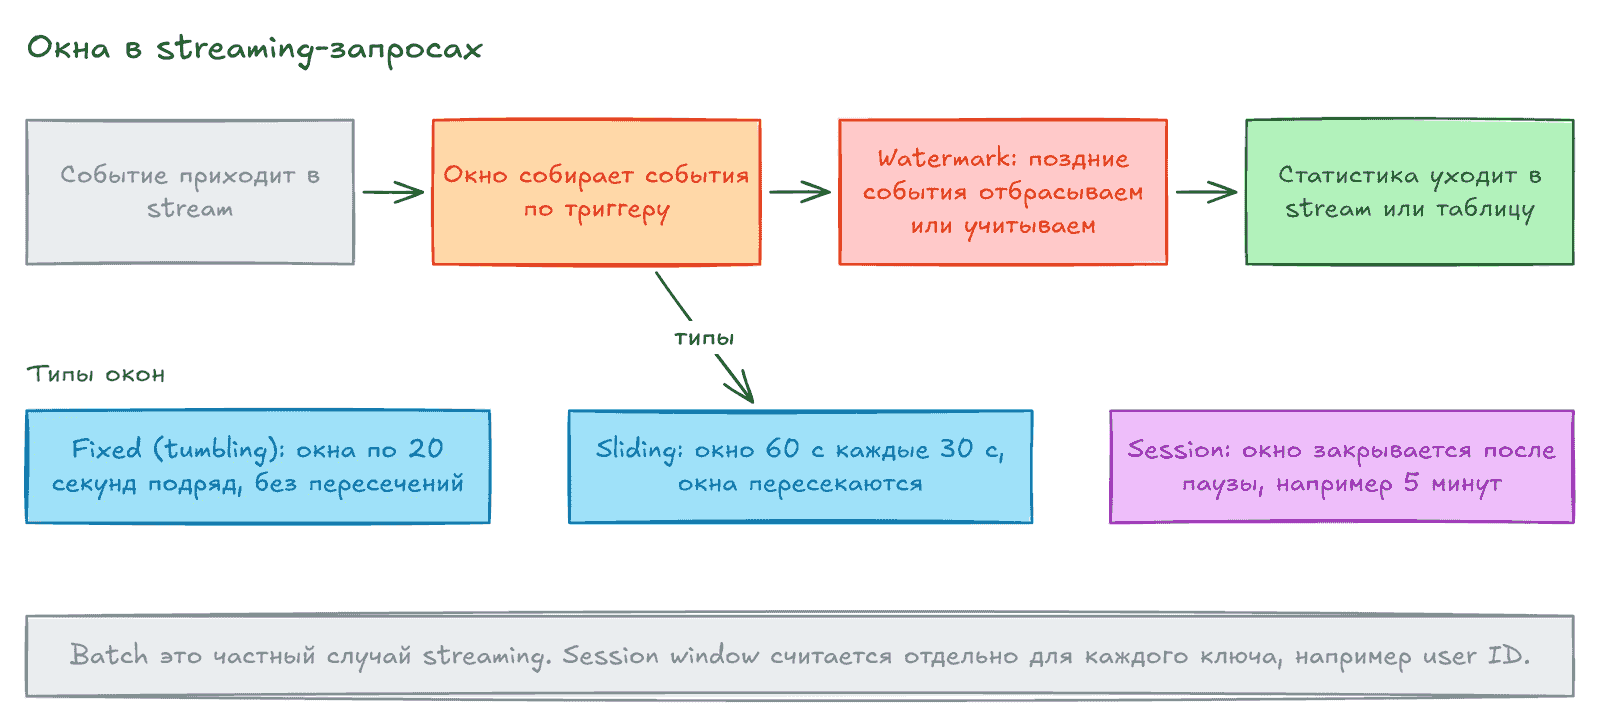
В streaming расчёт запускают сами данные, а не cron. Для этого нужны окна (windows):
| Окно | Как работает |
|---|---|
| Session | Группирует события одного ключа, закрывается после паузы (например 5 минут) |
| Fixed (tumbling) | Окна фиксированной длины идут подряд без пересечений |
| Sliding | Окна одной длины пересекаются (60 с каждые 30 с) |
| Watermark | Порог времени. Событие старше порога считается late-arriving |
Streaming можно объединять с другими данными тремя способами:
- Join двух таблиц, которые питает stream.
- Enrichment: добавляем к событиям данные из кэша, таблицы или файла.
- Stream-to-stream join: нужен buffer. События ждут пару в течение retention interval, потом вытесняются.
Моделирование данных
Заголовок раздела «Моделирование данных»Data model показывает, как данные связаны с реальным бизнесом. Без модели получаются data swamp и разные определения одного и того же. Например, кто такой customer: купил за 30 дней или за год?
Три уровня модели:
| Уровень | Что описывает |
|---|---|
| Conceptual | Бизнес-сущности и правила. Удобна ER-диаграмма |
| Logical | Типы полей, primary и foreign key |
| Physical | Конкретные базы, схемы, таблицы, настройки |
Модель делают вместе с бизнесом.
Grain (зерно) это уровень детализации строки. Храните данные на самом мелком grain. Агрегировать легко, восстановить детали нельзя.
Normalization
Заголовок раздела «Normalization»Цель: убрать дублирование и обеспечить referential integrity.
| Форма | Требование |
|---|---|
| Denormalized | Допускаются вложенные и повторяющиеся данные |
| 1NF | Нет повторов и вложенности в колонках, есть уникальный primary key |
| 2NF | 1NF и нет partial dependency на часть составного ключа |
| 3NF | 2NF и нет transitive dependency: неключевое поле не зависит от другого неключевого |
В OLAP денормализация часто нормальна. Степень нормализации зависит от задачи.
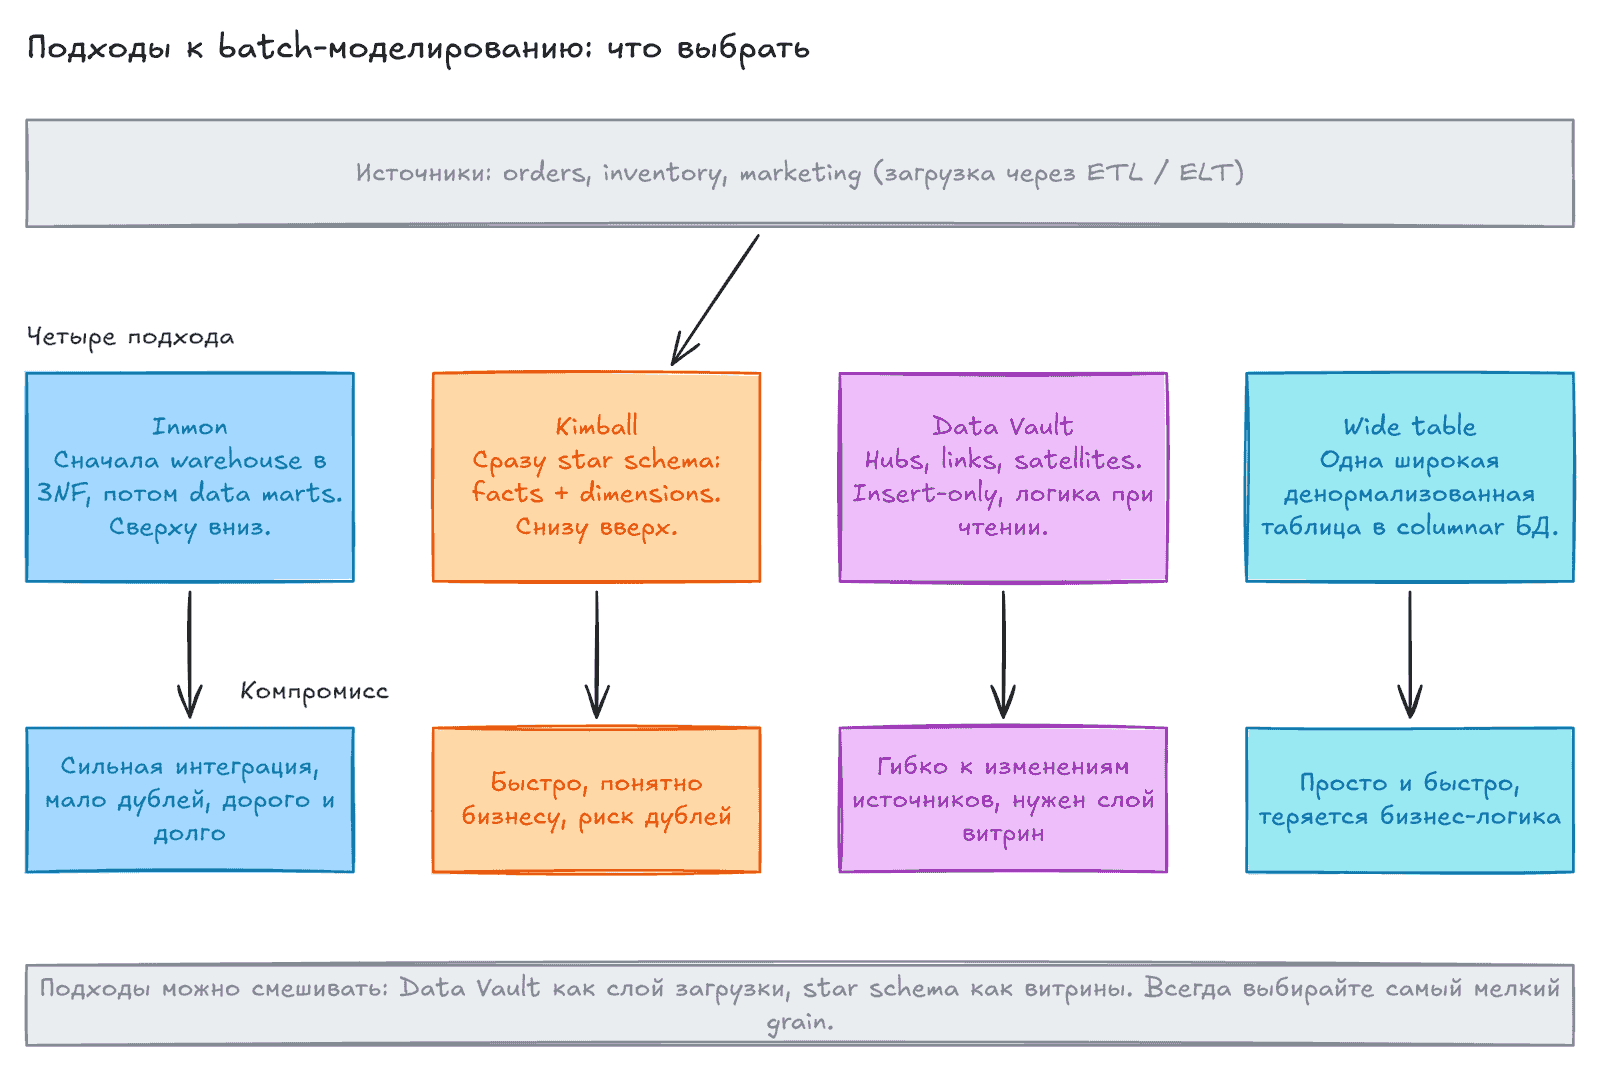
Подход 1989 года. Warehouse отделяет аналитику от источников. Он subject-oriented, integrated, nonvolatile и time-variant. Данные приходят через ETL в нормализованную 3NF-модель, это единый источник правды. Потом из него строят data marts для отделов, часто со star schema.
Kimball
Заголовок раздела «Kimball»Подход снизу вверх. Витрина и есть warehouse. Два вида таблиц:
| Таблица | Свойства |
|---|---|
| Fact | Числа и события. Узкая и длинная, append-only, на самом мелком grain. Ссылается только на dimensions |
| Dimension | Контекст: кто, что, где, когда. Широкая и короткая, денормализована |
Star schema это одна fact-таблица, окружённая dimensions. Меньше join, проще для бизнеса. Conformed dimension общий для нескольких star schema. Он позволяет объединять факты.
Slowly changing dimension (SCD) хранит изменения атрибутов:
| Тип | Что делает |
|---|---|
| Type 1 | Перезаписывает. История теряется. Это поведение по умолчанию |
| Type 2 | Новая строка при изменении, с датами действия. Самый частый на практике |
| Type 3 | Новая колонка для старого значения |
Kimball подходит только для batch. На streaming его перенести трудно.
Data Vault
Заголовок раздела «Data Vault»Метод Dan Linstedt. Структура отделена от атрибутов. Данные грузятся из источников insert-only. Нет понятий хороших или conformed данных: бизнес-логика применяется при чтении.
| Таблица | Что хранит |
|---|---|
| Hub | Уникальные business keys. Поля: hash key, load date, record source, business key |
| Link | Связи между hubs, many-to-many |
| Satellite | Атрибуты и контекст hub или link |
Новая связь в бизнесе это новый link. Часто Data Vault служит слоем загрузки, а сверху строят star schema. Есть также PIT и bridge таблицы.
Wide table
Заголовок раздела «Wide table»Одна очень широкая денормализованная таблица, обычно в columnar БД. Это работает по причинам:
- Хранение дешёвое.
- В columnar пустые значения почти ничего не стоят, читаются только нужные колонки.
- Добавить колонку это правка metadata.
- Нет join, scan быстрее.
Минусы: теряется бизнес-логика, обновление элементов массива дорого. Подходит, когда строгая модель не нужна или данных очень много.
Не моделировать
Заголовок раздела «Не моделировать»Можно запрашивать источники напрямую. Для старта это допустимо. Риски: результаты несогласованны, определения могут быть неверными, источник нагружается. Потом всё равно придётся строить модель.
Модель для streaming
Заголовок раздела «Модель для streaming»Единого подхода нет. Batch-методы плохо ложатся на поток: непонятно, как вести SCD Type 2 непрерывно. Схема события может поменяться без предупреждения. Эксперты советуют ждать изменений и держать гибкую схему. Некоторые называют Data Vault вариантом. Авторы ждут новых подходов с metrics и semantic layer.
Трансформации
Заголовок раздела «Трансформации»Query только читает. Transformation сохраняет результат, временно или постоянно. Трансформации сложнее: много источников, повторное использование промежуточных результатов. Они опираются на orchestration.
Batch-трансформации
Заголовок раздела «Batch-трансформации»Distributed joins: логический join делится на join на узлах кластера.
| Тип | Когда | Стоимость |
|---|---|---|
| Broadcast join | Одна таблица мала и помещается на узел. Её рассылают всем узлам | Дёшево |
| Shuffle hash join | Обе таблицы велики. Данные перераспределяют по хешу ключа | Дорого |
Фильтруйте заранее, чтобы получить broadcast join.
ETL и ELT. ETL появился из-за ограничений источников и приёмников. ELT загружает сырые данные и преобразует их в warehouse. ELT без плана в data lake ведёт к data swamp. Авторы советуют применять термины к отдельным pipeline, а не ко всей организации.
SQL или код. SQL декларативен, но подходит для сложных DAG через CTE, скрипты и orchestration. Три вопроса перед отказом от SQL:
- Насколько сложно это записать в SQL?
- Будет ли SQL читаемым?
- Нужна ли библиотека для повторного использования?
Советы для Spark: фильтруйте рано, используйте нативный API, осторожно с UDF (Python UDF медленные), смешивайте с SQL ради Catalyst optimizer. dbt помогает повторно использовать SQL.
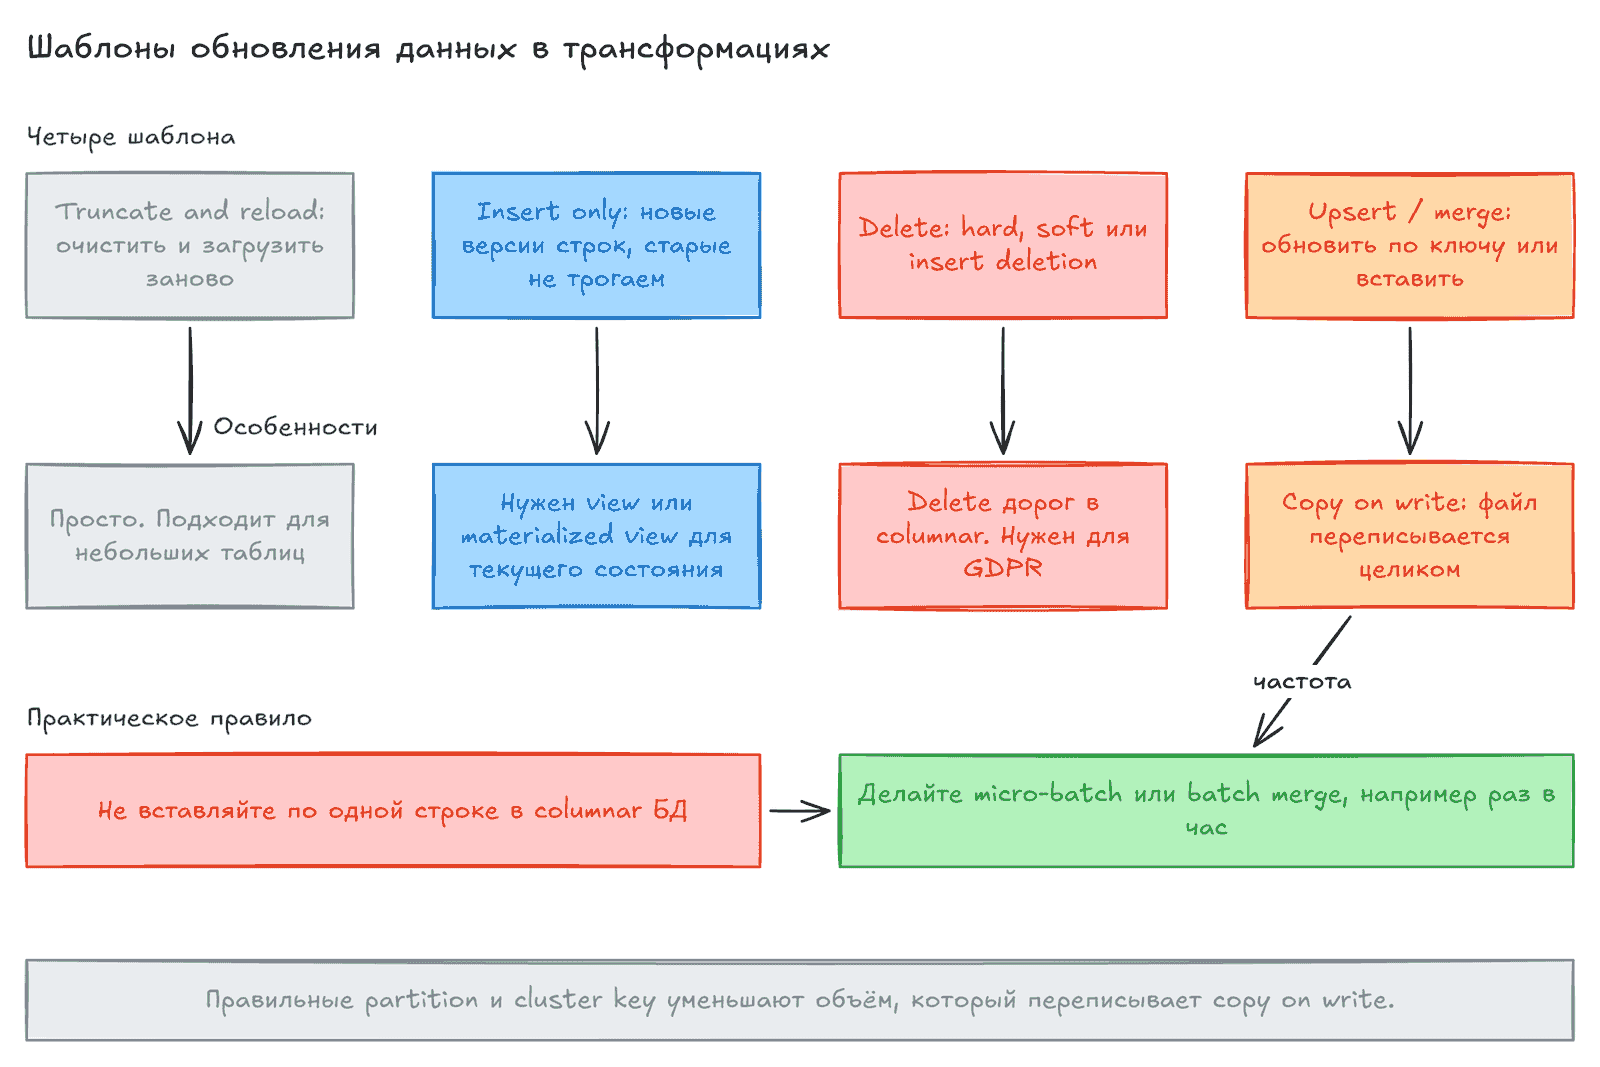
Update patterns:
| Шаблон | Суть |
|---|---|
| Truncate and reload | Очистить таблицу и загрузить заново |
| Insert only | Добавлять новые версии. Текущее состояние даёт query, view или materialized view |
| Delete | Hard delete, soft delete (флаг) или insert deletion (новая запись с флагом) |
| Upsert / merge | Обновить по ключу или вставить. Merge ещё и удаляет |
Важно:
- Columnar-системы не гарантируют уникальность ключа. Ключом управляет инженер.
- Файловые системы используют copy on write (COW): изменённый файл переписывается.
- Не вставляйте по одной строке в columnar. Грузите batch или micro-batch.
- Не делайте near real-time merge из CDC. Лучше merge раз в час.
- Merge больших наборов быстрый, но одной записи дорогой.
Schema updates. Колонки в columnar добавлять легко. Сложнее организация: авто-обновление схемы (как в Fivetran) может сломать downstream. Не используйте SELECT *. Для JSON храните сырой JSON и рядом плоские поля для частых данных.
Data wrangling превращает грязные данные в чистые. Его инструменты это IDE для плохих данных. Они показывают профиль, ошибки, пропуски. Тяжёлые задачи уходят в Spark.
Business logic и derived data. Метрики вроде прибыли сложны: фрод, отмены, attribution маркетинга. Логика в ETL-скриптах нарушает DRY. Альтернатива это metrics layer: логика в одном месте, запросы генерируются из метрик.
MapReduce
Заголовок раздела «MapReduce»MapReduce определил batch-обработку эпохи big data: map по блокам, shuffle по ключам, reduce агрегирует. Map масштабируется почти линейно. Минус: всё пишется на диск. После MapReduce (Spark, BigQuery) данные кэшируются в памяти, на диск идёт только spill. В облаке память можно арендовать на время задачи.
Views, materialized views, federation
Заголовок раздела «Views, materialized views, federation»| Объект | Суть |
|---|---|
| View | Сохранённый запрос. Нужен для безопасности, deduplicated представления, частых join |
| Materialized view | Результат считается заранее. Может ускорять и запросы, которые на него не ссылаются |
| Composable materialized views | Цепочки таблиц, которые обновляются по мере поступления данных (Databricks live tables) |
| Federated query | OLAP-БД читает внешний источник: object storage, MySQL, PostgreSQL |
| Data virtualization | Движок без своего хранилища (Trino, Presto). Важен query pushdown: фильтры идут в источник |
Virtualization не защищает production-БД: Trino читает её при каждом запросе. Лучше выгружать данные раз в день в S3. Это подходит и для data mesh.
Streaming-трансформации
Заголовок раздела «Streaming-трансформации»Streaming query показывает текущее состояние. Streaming transformation готовит данные для потребителя, например обогащает IoT-события метаданными устройства. Граница между query и transformation размыта.
- Streaming DAG: слияние и обогащение потоков в реальном времени. В Pulsar DAG это базовая абстракция.
- Micro-batch (Spark Streaming) обрабатывает пачки каждые 1 с или 2 минуты. True streaming (Flink, Beam) обрабатывает по одному событию, с большими накладными расходами.
- Выбор зависит от задачи. Метрики Black Friday раз в минуты подойдут micro-batch. Обнаружение DDoS раз в секунду требует true streaming.
- Не верьте benchmark вендоров. Тестируйте на своих данных.
Участники и undercurrents
Заголовок раздела «Участники и undercurrents»| Кто | Что важно |
|---|---|
| Upstream | Бизнес-определения и владельцы источников. Просите уведомлять об изменениях схемы. Не перегружайте источники |
| Downstream | Аналитики, data scientists, ML-инженеры, бизнес. Им нужны быстрые и надёжные данные |
| Undercurrent | Что делать |
|---|---|
| Security | Контроль доступа к колонкам и строкам, секреты не в коде, шифрование |
| Data management | Единые имена, каталог, data lineage, MDM, удаление по запросу, маскирование |
| DataOps | Тесты качества на входе и выходе, мониторинг очередей, памяти, concurrency, FinOps |
| Data architecture | Не используйте RDBMS или Elasticsearch как warehouse |
| Orchestration | Зависимости вместо cron |
| Software engineering | Чистый код, меньше UDF. dbt и CI/CD. Понимайте SQL, который генерирует low-code |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Query optimizer | Часть БД, выбирающая самый дешёвый план запроса |
| Explain plan | План выполнения запроса. Показывает шаги и стоимость |
| Row explosion | Рост числа строк из-за повторов в ключах join |
| Pruning | Чтение только нужных колонок и партиций |
| Vacuum | Удаление устаревших версий записей |
| Window | Окно событий в streaming (fixed, sliding, session) |
| Watermark | Порог, после которого событие считается поздним |
| Grain | Уровень детализации строки в таблице |
| Normalization | Снижение дублирования данных по normal forms |
| Fact / dimension | Событие с числами и контекст к нему в Kimball |
| SCD | Slowly changing dimension: способ хранить историю атрибутов |
| Data Vault | Модель из hubs, links и satellites |
| Broadcast / shuffle hash join | Два способа распределённого join |
| Upsert / merge | Обновить по ключу или вставить, при merge ещё удалить |
| Copy on write | Изменение файла через его полную перезапись |
| Materialized view | View с заранее посчитанным результатом |
| Data virtualization | Запросы к внешним источникам без своего хранилища |
| Metrics layer | Слой, где определены бизнес-метрики |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Читайте
EXPLAINдо оптимизации. Сначала уберите лишний scan и повторные join. - Храните факты на самом мелком grain. Агрегаты делайте в витринах.
- Выберите модель под задачу. Для отчётов подходит star schema, для гибкой загрузки Data Vault, для больших nested данных wide table.
- В columnar БД не делайте построчные insert и частые merge. Батчи и разумная частота спасают очередь.
- Определения метрик держите в одном месте: metrics layer или dbt. Не копируйте логику по ETL-скриптам.
- Ставьте тесты качества на входе и выходе трансформации. Следите за стоимостью запросов.
- Не нагружайте production-БД аналитикой. Используйте CDC и отдельную OLAP-базу.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Что делает query optimizer и как вам помогает explain plan?
- Чем fact table отличается от dimension table и зачем нужен SCD Type 2?
- Когда broadcast join лучше shuffle hash join?
- Почему merge из CDC в реальном времени плохо работает в columnar warehouse?
Предыдущая: Приём данных. Следующая: Выдача данных.