

The Data Warehouse Toolkit, глава 17: Kimball Lifecycle
Главная мысль: проект DW/BI — это не один большой билд, а повторяемый цикл. Сначала бизнес-требования. Потом три параллельных трека: технологии, данные и BI-приложения. Потом deployment и новый цикл.
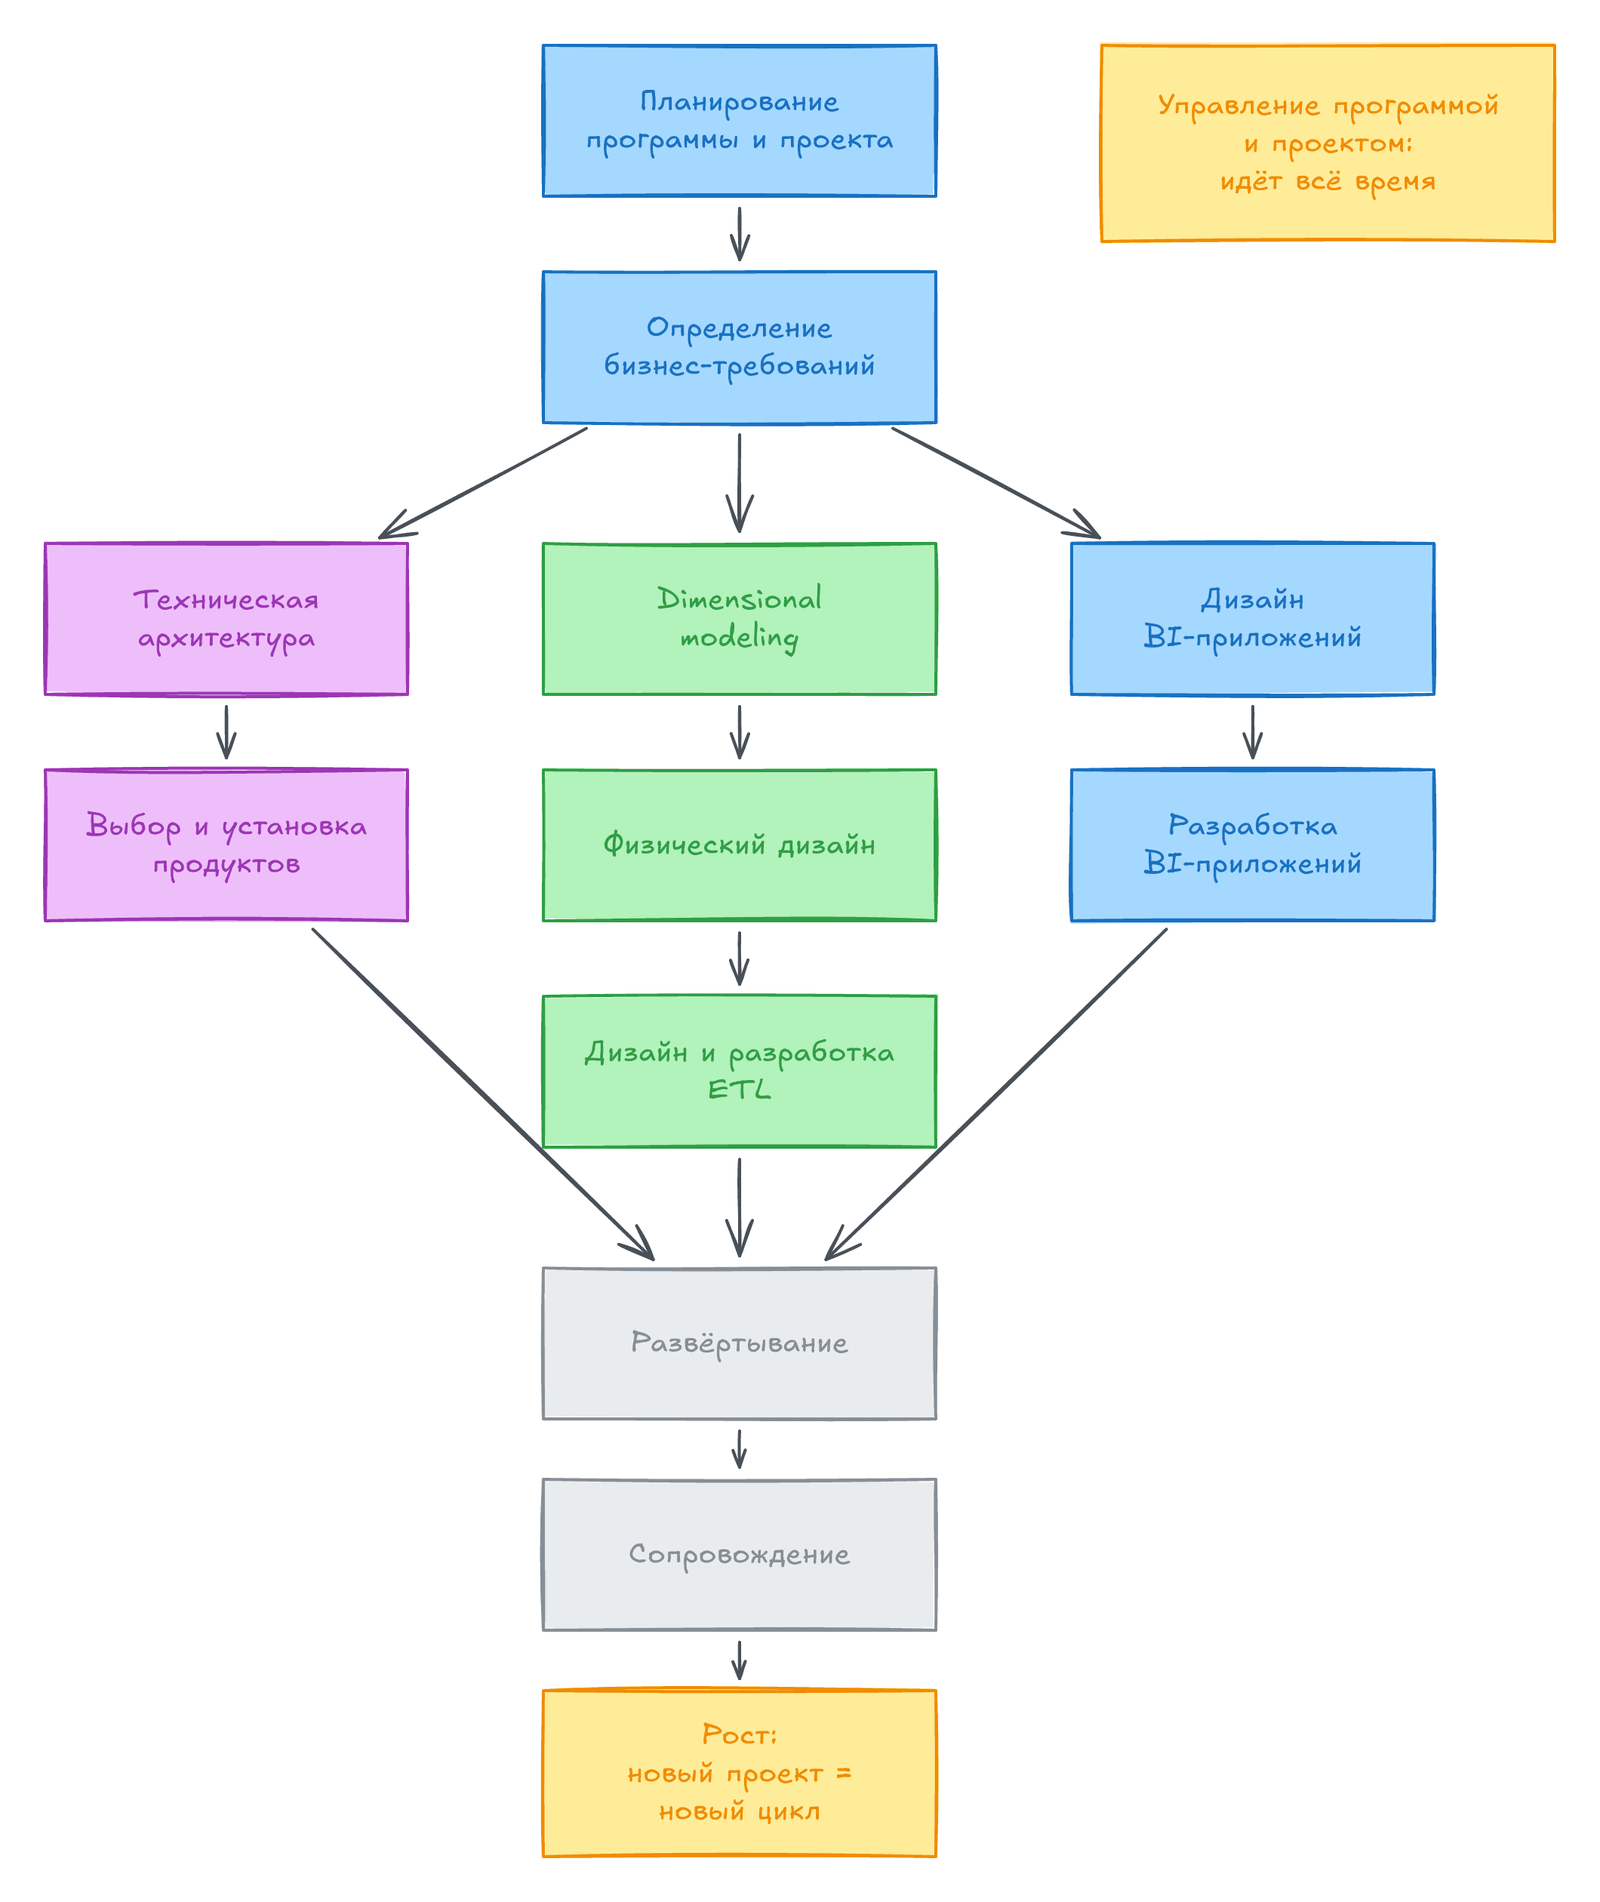
Три принципа Lifecycle
Заголовок раздела «Три принципа Lifecycle»- Фокус на потребностях бизнеса.
- Данные подаются в dimensional-структурах.
- Проект делится на небольшие итерации. Один проект — один бизнес-процесс.
Блоки на схеме одной ширины, но трудозатраты разные. Например, ETL занимает намного больше времени, чем физический дизайн.
Этапы Lifecycle
Заголовок раздела «Этапы Lifecycle»| Этап | Что делают | Результат |
|---|---|---|
| Планирование программы и проекта | Проверка готовности, scope, оценка выгод и затрат, команда, план | План проекта |
| Бизнес-требования | Интервью, консолидация, приоритеты | Документ требований, приоритеты |
| Техническая архитектура | Требования к платформе, модель архитектуры, фазы | План архитектуры |
| Выбор продуктов | Матрица оценки, short list, прототип, trial | Выбранные продукты |
| Dimensional modeling | Workshop с бизнесом (глава 18) | Модель и source-to-target mapping |
| Физический дизайн | Naming, индексы, агрегаты, партиции | Физическая модель |
| ETL (главы 19 и 20) | Разработка загрузки | Работающий ETL |
| BI-приложения | Шаблоны отчётов и анализов | Стартовый набор отчётов |
| Deployment | Обучение, поддержка, релиз | Работающая система |
| Maintenance и growth | Поддержка и новые проекты | Новый цикл |
Планирование
Заголовок раздела «Планирование»Три фактора готовности. В порядке важности:
- Сильный бизнес-спонсор. Лучше, если спонсор не CIO, а руководитель из бизнеса.
- Сильная бизнес-мотивация. Проект решает важную проблему.
- Реальные данные. Источники уже собирают нужные данные с нужным grain.
Если данных нет, быстро это не исправить. Это самый серьёзный риск.
Правила scope:
- Начинайте с одного бизнес-процесса.
- Избегайте «Law of Too»: слишком короткий срок, слишком много источников, слишком много пользователей, слишком разные задачи.
- Выгоду считает бизнес. Фразы «единая версия правды» недостаточно. Нужна оценка влияния на прибыль или выручку.
- Затраты на поддержку DW/BI не падают после запуска.
Scope creep: при новом запросе есть три варианта. Расширить scope (время, люди, бюджет), обменять на что-то из плана или оформить как будущее улучшение. Решайте вместе с бизнесом.
Роли в команде: sponsor, business driver, business lead, business analyst, data steward, project manager, technical architect, data modeler, DBA, metadata coordinator, ETL architect и developer, BI developer. Это роли, а не люди. Один человек может закрывать несколько ролей.
Бизнес-требования
Заголовок раздела «Бизнес-требования»Спрашивайте бизнес о работе, а не о таблицах. Не спрашивайте про grain и dimensions.
- Интервью лучше опросов. Опрос плоский и не даёт задать уточняющий вопрос.
- Часто используют гибрид: интервью для деталей, потом workshop для согласия.
- Для руководителей: видение и влияние информации на решения.
- Для аналитиков: какие метрики, как они их сегодня считают, какие отчёты.
- Для людей с данными: как они различают товары, как их группируют. Так находят атрибуты и иерархии.
- В конце спросите критерии успеха. Они должны быть измеримыми. «Быстро» — не критерий.
- Параллельно проводите data-centric интервью с экспертами источников. Так вы проверите, что данные есть.
Результат — документ с находками, сгруппированными по бизнес-процессам. Не просите «пять главных отчётов». Вопросы пользователей будут меняться.
Приоритизация
Заголовок раздела «Приоритизация»Каждый процесс ставят на сетку: влияние на бизнес и feasibility.
| Влияние | Feasibility | Решение |
|---|---|---|
| Высокое | Высокая | Начинать сейчас |
| Высокое | Низкая | Важно, но сначала нужно улучшить данные. Это работа других IT-команд |
| Низкое | Высокая | Не срочно |
| Низкое | Низкая | Избегать |
Решение принимают вместе с бизнесом, не в IT.
Технологический трек
Заголовок раздела «Технологический трек»Техническая архитектура — план для будущих технологий. Восемь шагов:
- Создать небольшую task force (2-3 человека): технический архитектор, ETL-архитектор, BI-архитектор.
- Собрать требования, связанные с архитектурой: latency, доступность, производительность.
- Записать их в таблицу «требование и последствия».
- Нарисовать модель архитектуры.
- Определить фазы внедрения.
- Описать подсистемы, которых нет в готовых продуктах.
- Написать план.
- Согласовать и опубликовать.
Выбор продуктов — после архитектуры, а не до неё. Типичная ошибка новичков: купить инструмент до того, как понятна задача.
- Составьте матрицу оценки с весами. Критерии должны быть конкретными.
- Не делайте RFP без необходимости. Это долго, и ответы похожи на рекламу.
- Сравните short list. Прототип нужен, только если нет явного лидера. Тогда берут не больше двух продуктов.
- Установите trial у одного вендора. Потом ведите переговоры.
Трек данных
Заголовок раздела «Трек данных»- Dimensional modeling. Модель строится в workshop с бизнесом (глава 18).
- Физический дизайн. Логическая и физическая модель похожи. Не превращайте star в 3NF. Нужны ещё staging-таблицы, таблицы аудита и безопасный доступ к подмножеству данных. Добавьте стандарты имён, план индексов, агрегаты и партиции.
- ETL. Самая трудоёмкая часть. Главы 19 и 20.
Трек BI-приложений
Заголовок раздела «Трек BI-приложений»- Приложения — это шаблоны отчётов и анализов, которыми пользуется большинство людей.
- Сначала определите стартовый набор. Он строится на требованиях.
- Разработка: стандарты, конфигурация, метаданные, тесты и проверка данных, документация.
Deployment, поддержка и рост
Заголовок раздела «Deployment, поддержка и рост»- Три трека сходятся в одно развёртывание. Само это не происходит, нужно планировать.
- Данные — самая непредсказуемая часть. Не выпускайте «недоготовленные» данные только ради даты.
- Перед релизом — end-to-end тесты: качество данных, операции, производительность, удобство.
- Обучение обязательно. Поддержка обычно в три уровня: сайт и self-service, power users в бизнесе, команда DW/BI.
- После запуска вкладывайтесь в четыре области: поддержка пользователей, обучение, техническая поддержка с SLA, поддержка программы (маркетинг успеха, регулярные ревью).
- Рост — признак успеха, а не провала. Приоритеты ставят вместе с бизнесом по той же сетке. Каждый новый проект возвращается к началу Lifecycle.
10 типичных ошибок
Заголовок раздела «10 типичных ошибок»Книга даёт список ошибок. Номер 1 — самая опасная.
| № | Ошибка |
|---|---|
| 10 | Увлечься технологиями и данными, а не целями бизнеса |
| 9 | Не найти влиятельного и доступного бизнес-спонсора |
| 8 | Делать огромный многолетний проект вместо итераций |
| 7 | Потратить бюджет на нормализованную структуру и не дойти до dimensional presentation area |
| 6 | Думать о скорости и удобстве ETL больше, чем о скорости и удобстве запросов |
| 5 | Сделать presentation area слишком сложной |
| 4 | Строить dimensional models отдельно, без conformed dimensions |
| 3 | Загружать в presentation area только агрегаты |
| 2 | Считать, что бизнес, требования, данные и технологии не меняются |
| 1 | Забыть, что успех DW/BI — это принятие системы бизнесом |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Kimball Lifecycle | Дорожная карта проекта DW/BI |
| Business sponsor | Руководитель из бизнеса, главный защитник проекта |
| Data steward | Эксперт, который согласует определения данных |
| Prioritization grid | Сетка impact и feasibility |
| Technical architecture | План технических сервисов и инфраструктуры |
| Bus matrix | Бизнес-процессы и общие dimensions |
| Scope creep | Постепенное расширение объёма проекта |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Перед стартом проверьте sponsor, motivation и данные. Если одного нет, остановитесь.
- Один проект — один процесс. Сначала самый ценный и самый реальный.
- Требования записывайте по процессам, а не по запросам пользователей.
- Не выбирайте стек до архитектурных требований. «Нужен latency ниже минуты» меняет всё.
- Современный стек (облачное хранилище,
dbt, оркестратор) не отменяет этапы. Они остаются, только инструменты другие. - Agile и Lifecycle совместимы: итерации и работа с бизнесом. Но bus architecture и governance нужны с первого дня.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Решения тоже запускайте по порядку.
Шаг 1. Создаём данные по требованиям
Заголовок раздела «Шаг 1. Создаём данные по требованиям»-- кандидаты на проекты: оценки от 1 до 5CREATE TABLE business_process ASSELECT * FROM (VALUES ('orders', 'Заказы', 5, 5, TRUE), ('shipments', 'Отгрузки', 4, 4, TRUE), ('inventory', 'Остатки на складе', 4, 2, TRUE), ('support', 'Звонки в поддержку',3, 4, TRUE), ('web', 'Клики на сайте', 4, 2, FALSE), ('procurement','Закупки', 2, 5, TRUE), ('returns', 'Возвраты', 5, 2, FALSE), ('budget', 'Бюджет', 2, 1, FALSE)) t(process_id, process_name, impact, feasibility, source_data_ready);
-- кому нужен процесс (opportunity/stakeholder matrix)CREATE TABLE process_stakeholder ASSELECT * FROM (VALUES ('orders','Продажи'), ('orders','Финансы'), ('orders','Маркетинг'), ('orders','Логистика'), ('shipments','Логистика'), ('shipments','Продажи'), ('inventory','Логистика'), ('inventory','Закупки'), ('inventory','Финансы'), ('support','Поддержка'), ('support','Маркетинг'), ('web','Маркетинг'), ('procurement','Закупки'), ('procurement','Финансы'), ('returns','Продажи'), ('returns','Финансы'), ('returns','Поддержка'), ('budget','Финансы')) t(process_id, department);
-- какие dimensions нужны процессам (bus matrix в виде пар)CREATE TABLE process_dimension ASSELECT * FROM (VALUES ('orders','date'), ('orders','customer'), ('orders','product'), ('orders','promotion'), ('shipments','date'), ('shipments','customer'), ('shipments','product'), ('shipments','warehouse'), ('inventory','date'), ('inventory','product'), ('inventory','warehouse'), ('support','date'), ('support','customer'), ('support','agent'), ('procurement','date'), ('procurement','product'), ('procurement','vendor'), ('returns','date'), ('returns','customer'), ('returns','product'), ('returns','reason')) t(process_id, dimension_name);
-- готовность организации к старту проектаCREATE TABLE readiness ASSELECT * FROM (VALUES ('orders', TRUE, TRUE, TRUE), ('shipments', TRUE, FALSE, TRUE), ('returns', FALSE, TRUE, FALSE)) t(process_id, has_sponsor, has_motivation, data_feasible);Шаг 2. Проверка данных
Заголовок раздела «Шаг 2. Проверка данных»-- у каждого процесса есть оценки в диапазоне 1..5 (должно вернуть 0 строк)SELECT * FROM business_processWHERE impact NOT BETWEEN 1 AND 5 OR feasibility NOT BETWEEN 1 AND 5;
SELECT count(*) AS processes, count(DISTINCT process_id) AS unique_processesFROM business_process;Задания
Заголовок раздела «Задания»1. Разместите каждый процесс на prioritization grid. Высокое = оценка 4 и выше. Выведите квадрант словами.
Решение
SELECT process_name, impact, feasibility, CASE WHEN impact >= 4 AND feasibility >= 4 THEN 'Начинать сейчас' WHEN impact >= 4 AND feasibility < 4 THEN 'Важно, но нужно улучшить данные' WHEN impact < 4 AND feasibility >= 4 THEN 'Не срочно' ELSE 'Избегать' END AS quadrantFROM business_processORDER BY impact DESC, feasibility DESC;2. Выберите порядок проектов. Считайте priority_score = impact * feasibility. Процессы без готовых данных не берём в ближайшие итерации. При равенстве выше тот, у кого больше impact.
Решение
SELECT row_number() OVER (ORDER BY impact * feasibility DESC, impact DESC) AS iteration, process_name, impact * feasibility AS priority_scoreFROM business_processWHERE source_data_readyORDER BY iteration;Первым идёт orders: score 25. Это нужная и реальная итерация. Формула — упрощение для практики. В книге место процесса на сетке определяют вместе с бизнесом на встрече по приоритетам.
3. Проверка готовности. Проект готов, если есть sponsor, motivation и данные. Для не готовых покажите, чего не хватает.
Решение
SELECT process_id, (has_sponsor AND has_motivation AND data_feasible) AS ready, concat_ws(', ', CASE WHEN NOT has_sponsor THEN 'нет sponsor' END, CASE WHEN NOT has_motivation THEN 'нет мотивации' END, CASE WHEN NOT data_feasible THEN 'нет данных' END) AS missingFROM readinessORDER BY ready DESC;concat_ws пропускает NULL. Поэтому у готового проекта колонка missing пустая.
4. Opportunity/stakeholder matrix. Для каждого процесса покажите число отделов и их список. Найдите процессы, которые нужны трём отделам и больше.
Решение
SELECT process_id, count(*) AS departments, string_agg(department, ', ' ORDER BY department) AS whoFROM process_stakeholderGROUP BY process_idHAVING count(*) >= 3ORDER BY departments DESC, process_id;5. Проверьте bus architecture. Для каждого dimension посчитайте, сколько процессов его используют. Dimensions с двумя и больше процессами нужно согласовать (conform) раньше всех. Для первой итерации (orders) покажите, какие её dimensions будут повторно использованы другими проектами.
Решение
-- общие dimensionsSELECT dimension_name,       count(*) AS processes,       string_agg(process_id, ', ' ORDER BY process_id) AS used_byFROM process_dimensionGROUP BY dimension_nameHAVING count(*) >= 2ORDER BY processes DESC;
-- dimensions первой итерации и их повторное использованиеSELECT o.dimension_name, count(*) FILTER (WHERE d.process_id <> 'orders') AS reused_by_other_processesFROM process_dimension oJOIN process_dimension d USING (dimension_name)WHERE o.process_id = 'orders'GROUP BY o.dimension_nameORDER BY reused_by_other_processes DESC;date, customer и product нужны почти всем. Их стоит проектировать как conformed dimensions в первой же итерации. promotion пока нужен только orders.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие три фактора определяют готовность к DW/BI проекту? Какой из них самый критичный?
- Почему выбор продуктов идёт после технической архитектуры?
- Почему опросы плохо подходят для сбора требований?
- Что делать с проектом, у которого высокое влияние, но низкая feasibility?