

The Data Warehouse Toolkit, глава 21: Big Data
Главная мысль: big data не отменяет dimensional modeling. Это новые типы данных и новые платформы. Но принципы те же: бизнес-цель, dimensions и facts, conformed dimensions, durable keys. Сырые данные превращают в факты и подключают к dimensions.
Что такое big data
Заголовок раздела «Что такое big data»- Важен не размер. Важны разные форматы: структурированные, полуструктурированные, неструктурированные и сырые данные.
- Многие из них нельзя обработать обычным SQL: изображения, тексты, логи, пары «имя и значение».
- Это смена подхода: что собирать, где хранить и как получать из этого деньги.
Примеры задач из книги: ранжирование поиска, учёт рекламы, геолокация, соцсети и CRM, генетика, датчики и умные счётчики, антифрод, анализ оттока.
Книга перечисляет 19 требований к системе для big data. Обычная RDBMS и SQL их не покрывают. Вот главные:
- масштаб до петабайт и тысяч процессоров;
- хранение данных в исходном формате, анализ без конвертации;
- загрузка со скоростью гигабайты в секунду, до объявления структуры;
- пользовательские функции (UDF) на разных языках, библиотеки UDF;
- сложные типы данных: изображения, иерархии, пары «имя и значение»;
- streaming-запросы на входящих данных;
- join dimension на миллиард строк с fact на триллион строк;
- работа без единой точки отказа, продолжение работы при падении узла.
Две архитектуры
Заголовок раздела «Две архитектуры»| Extended RDBMS | MapReduce / Hadoop | |
|---|---|---|
| Идея | Реляционная база расширяет типы данных и UDF | Фреймворк для выполнения функций над данными на множестве машин |
| Лицензия | В основном проприетарная | Open source |
| Данные | Нужна структура | Структура не обязательна |
| Стоимость | Дорого | Дешевле |
| Сильная сторона | Быстрый поиск по индексам | Полное сканирование больших объёмов |
| Реляционная семантика (SQL) | Полная поддержка | Косвенная (например, Hive) |
| Транзакции | Полная поддержка | Почти нет |
| Сложные структуры | Косвенная поддержка | Прямая поддержка |
| Итерации, сложная логика | Косвенная поддержка | Прямая поддержка |
- Extended RDBMS. Новые типы данных нельзя просто хранить как blob. Их нужно обрабатывать внутри базы через UDF. Полезный приём: два прохода. Первый проход извлекает факты из сырых данных. Второй загружает их обратно как обычные строки и колонки.
- MapReduce. По сути это среда для выполнения UDF, где функция может быть очень сложной. Главная реализация — Apache Hadoop с файловой системой HDFS.
Книга считает, что обе архитектуры будут существовать вместе.
Стандартные практики остаются
Заголовок раздела «Стандартные практики остаются»Проверенные за 30 лет практики применимы и здесь:
- выбирайте источники по бизнес-задаче;
- заботьтесь о простоте и скорости интерфейса;
- мыслите dimensions и facts;
- объединяйте источники через conformed dimensions;
- отслеживайте изменения через SCD;
- используйте durable surrogate keys.
Практики управления
Заголовок раздела «Практики управления»| Практика | Смысл |
|---|---|
| Стройте среду вокруг аналитики | Каждый шаг пути данных должен поддерживать сложные функции, а не только отчёты |
| Не стройте legacy сейчас | Рынок быстро меняется. Закладывайте, что вы перепишете и перенесёте приложения за два года. Hadoop — гибкая среда для ETL: он добавляет структуру, чтобы данные можно было загрузить в RDBMS. Metadata-driven инструменты без кода защищают от смены технологий |
| Идите от sandbox | Data scientists экспериментируют в любых языках. Потом IT переписывает удачное на поддерживаемый стек |
| Начните с простого | Например, Hadoop как дешёвый backup и archive. Так можно сохранить данные старых приложений, которые скоро выключат |
Практики архитектуры
Заголовок раздела «Практики архитектуры»Data highway
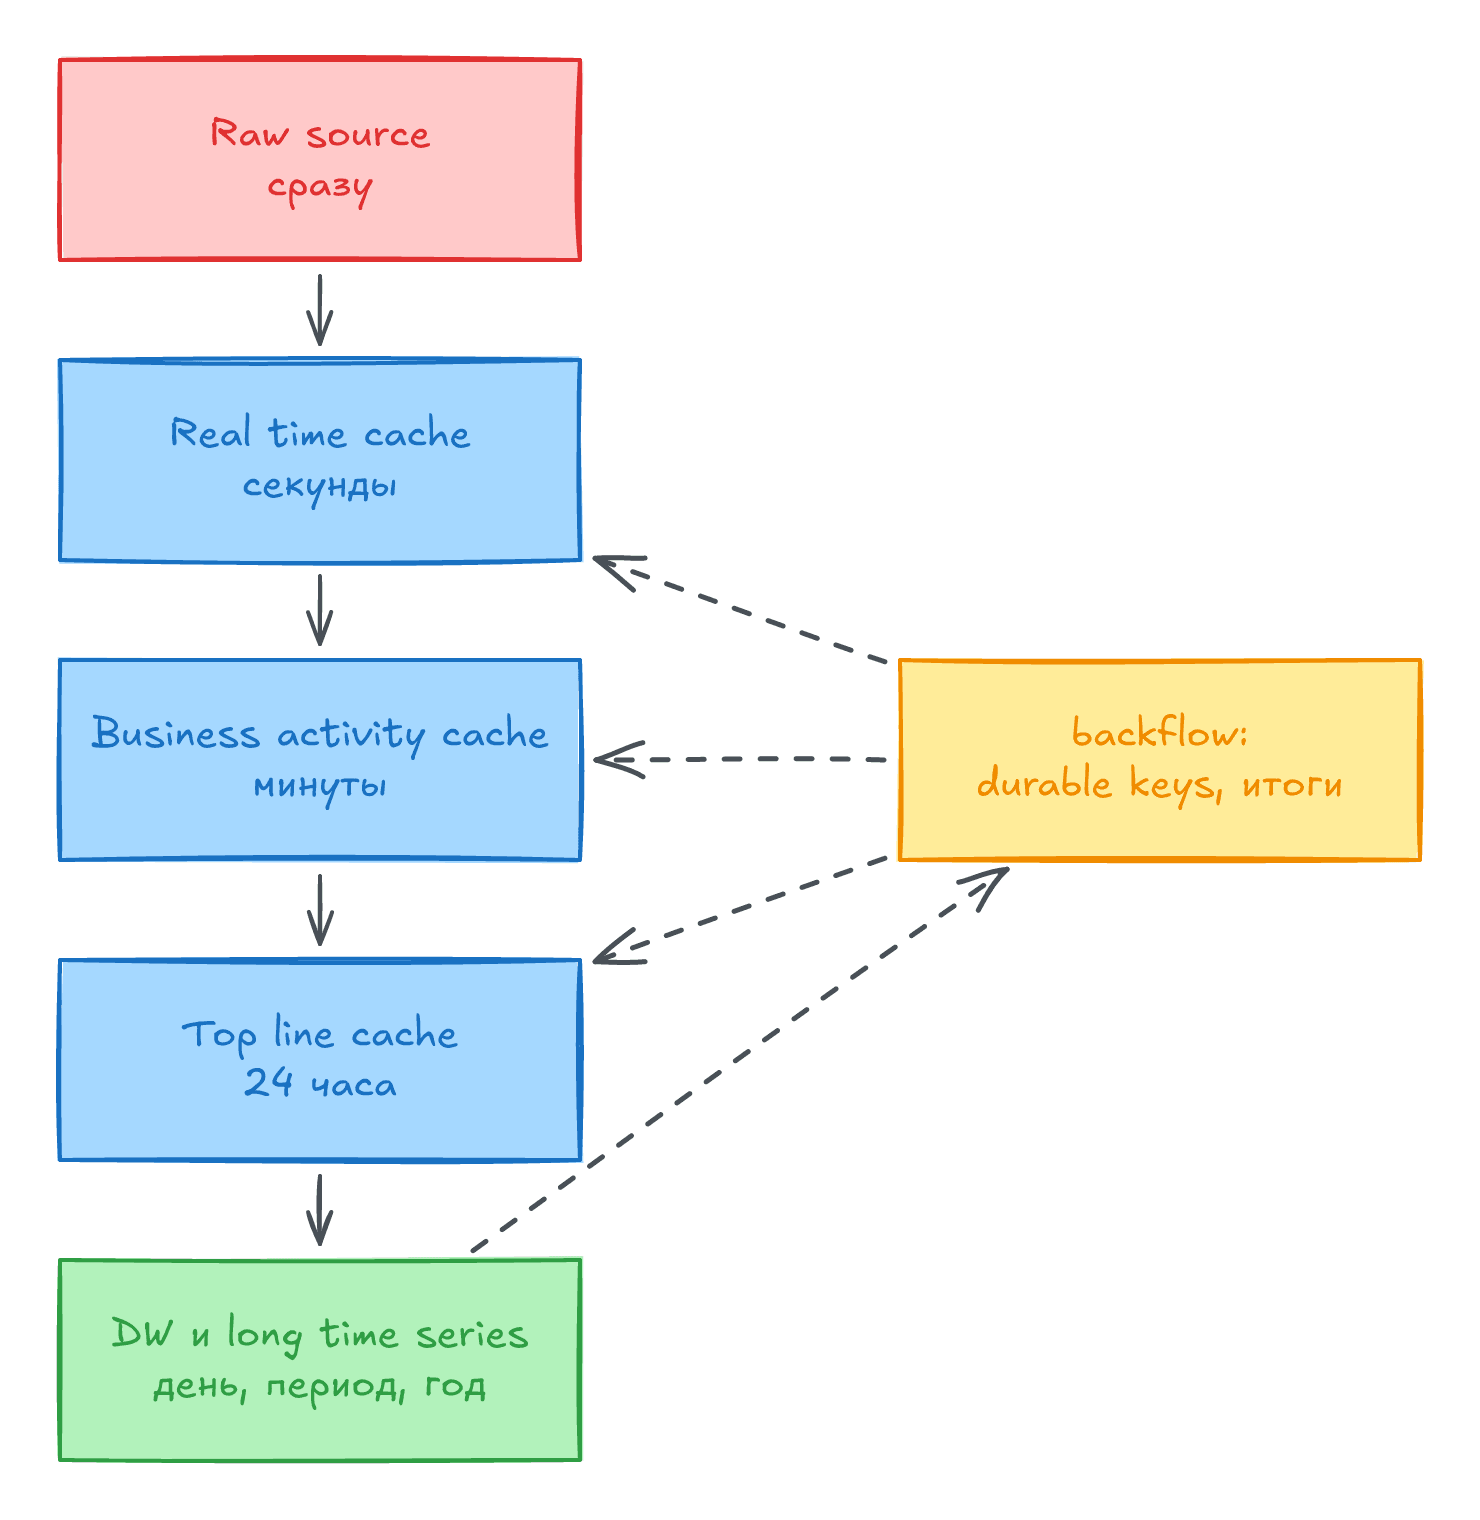
Заголовок раздела «Data highway»Это цепочка кешей с растущей задержкой и растущим качеством.
| Кеш | Задержка | Примеры |
|---|---|---|
| Raw source | Сразу | Антифрод по карте, обнаружение атак |
| Real time | Секунды | Выбор рекламы, персональные акции |
| Business activity | Минуты | Dashboards с низкой задержкой, отслеживание тикетов |
| Top line | 24 часа | Дневная сводка для руководства. Похож на ODS |
| DW и long time series | День, период, год | Отчёты, ad hoc, история |
Внедряют только нужные кеши. Каждый кеш — отдельное физическое хранилище. Путей может быть несколько: данные идут в real time cache и одновременно в top line cache (как ODS), а из него в DW. Данные идут и назад (backflow, см. ниже). Многие данные на этом пути остаются в нереляционных форматах.
Другие практики
Заголовок раздела «Другие практики»- Fact extractor. Анализ неструктурированных данных создаёт числа. Например, из твитов получают share of voice, долю позитива, время решения проблемы. Эти числа идут в следующий кеш.
- Comprehensive ecosystems. Объединяйте в одной среде таблицы RDBMS, документы, e-mail и внутреннюю соцсеть. Пример из книги: банк с миллионами счетов и документов сохраняет переписку партнёров и клиентов в Hadoop и dimensionalize её.
- Качество растёт вдоль highway. Это компромисс latency и качества. Мгновенные данные неизбежно грязнее. Проверка одного поля быстрая. Проверка связей между полями и источниками медленнее. Дневной кеш строится на более полных данных: в нём уже нет незавершённых и отменённых транзакций.
- Добавляйте ценность как можно раньше. Фильтрация, чистка, conforming. Но есть мнение, что чистку нужно делать при анализе, чтобы не потерять интересные выбросы.
- Backflow. Из хранилища возвращайте в ранние кеши dimensions (customer, product, date) и производные итоги. Для этого во всех кешах нужны одни durable keys. Поэтому задача номер один каждого ETL-шага: заменить ключи источника на durable keys.
- Streaming. Анализ потока, пока данные идут. Запросы с движущимися окнами.
- Избегайте boundary crash. Планируйте масштаб заранее.
- Прототип в публичном облаке, потом private cloud. Публичное облако быстро выделяет ресурсы. Это подходит, если чувствительность данных позволяет. Потом переносите в private cloud.
- Ищите ускорение в 10-100 раз. Узкие решения бывают намного быстрее универсальных. Примеры: «big join», визуализация больших наборов, semantic zooming без предагрегаций.
- Следите за ресурсами. Отделяйте аналитику big data от обычного хранилища, чтобы не нарушить SLA.
- Используйте in-database analytics. После загрузки в таблицы SQL вместе с аналитическими расширениями очень мощен. Пример: UDF в PostgreSQL.
Практики моделирования
Заголовок раздела «Практики моделирования»- Мыслите dimensions и facts. Даже в твите «Вау, круто!» можно найти клиента, место, продукт, сессию, событие-причину. Это dimensionalization. Её нужно автоматизировать и делать как можно раньше.
- Объединяйте источники через conformed dimensions. В каждую версию dimension «клиент» добавляют общий enterprise-атрибут, например демографическую категорию. Потом отдельные запросы к разным источникам сливают по этому атрибуту. Атрибут можно добавлять постепенно, не ломая старые отчёты.
- Закрепляйте dimensions durable surrogate keys. Natural key источника несовместим между системами и им управляет кто-то другой. Durable key принадлежит хранилищу, и никакое бизнес-правило его не меняет.
- Интегрируйте структурированные и неструктурированные данные. Пример из книги: медицинское исследование. Группу пациентов из DW объединяют со снимками, заметками врачей и отзывами о лечении.
- Отслеживайте изменения через SCD.
- Объявляйте структуру при анализе (сейчас это называют schema-on-read). Структура может быть неизвестна при загрузке. Разные аналитики видят одни данные по-разному. Минус: такие данные трудно индексировать. Перенос в колонки RDBMS — это обычный полезный шаг ETL.
- Загружайте как пары «имя и значение». Источник может прислать неожиданное поле, например «редкая марка = $10,000». Пара «имя и значение» загрузится без ошибки.
- Прототипируйте через data virtualization. Например, SQL view поверх сырых данных. Когда схема проверена и нужна скорость, материализуйте её в таблицы.
Практики governance
Заголовок раздела «Практики governance»- Нет отдельного «big data governance». Governance — общий подход ко всем данным компании: приватность, безопасность, compliance, качество, метаданные, MDM, бизнес-глоссарий.
- Dimensionalize данные до governance. Данные приходят с неожиданным содержимым. Разберите их, сопоставьте, сделайте identity resolution как можно раньше. Не используйте данные до этого шага.
- Приватность — главное. Если в данных есть люди или организации, маскируйте персональные поля и агрегируйте так, чтобы нельзя было узнать человека. Hadoop плохо умеет обновлять данные. Поэтому маскируйте при записи (persistent masking) или при чтении (dynamic masking).
- Не откладывайте governance ради big data. Даже для прототипа ведите чек-лист вопросов на будущее.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Big data | Данные разных форматов, часто не для обычного SQL |
| MapReduce / Hadoop | Фреймворк для распределённых функций над данными |
| UDF | Функция пользователя внутри обработки данных |
| Data highway | Цепочка кешей с растущей задержкой и качеством |
| Fact extractor | Преобразование сырых данных в числовые факты |
| Backflow | Возврат ключей и итогов из DW в ранние кеши |
| Schema-on-read | Структуру определяют в момент чтения (общий термин, в книге: «объявляйте структуру при анализе») |
| Schema-on-write | Структура задана при записи (общий термин) |
| Data virtualization | Логическая структура (view) поверх физических данных |
| Durable key | Постоянный ключ сущности для всех систем |
Что это значит на практике
Заголовок раздела «Что это значит на практике»Это заметки автора конспекта, а не текст книги.
- Сегодня Hadoop заменили lakehouse и облачные платформы (Parquet, Iceberg, Spark, облачные хранилища). Идеи главы остаются верными.
- Сырой слой держите в исходном виде (JSON, Parquet). Это ваш архив.
- Для отчётов делайте типизированную модель: dimensions и facts. Не просите BI читать JSON каждый раз.
- Часть полей, которые часто используют, выносите из JSON в колонки.
- Строки, которые не прошли приведение типов, не выбрасывайте. Записывайте их в отдельную таблицу отклонений.
- Не забывайте про приватность: исключите или замаскируйте персональные поля до публикации.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Расширение json встроено в DuckDB. Блоки идут по порядку. Решения тоже запускайте по порядку.
Шаг 1. Создаём сырые JSON-данные
Заголовок раздела «Шаг 1. Создаём сырые JSON-данные»-- сырые события. Структура у них разная: у кого-то есть coupon, у кого-то attrsCREATE TABLE raw_events (event_id INT, payload JSON);INSERT INTO raw_events VALUES (1, '{"ts":"2025-03-01T10:15:00","type":"purchase","user":{"id":"u1","country":"RU"},"items":[{"sku":"A1","qty":2,"price":10.5},{"sku":"B2","qty":1,"price":99}],"attrs":{"device":"ios","campaign":"spring"}}'), (2, '{"ts":"2025-03-01T11:00:00","type":"view","user":{"id":"u2"},"items":[],"attrs":{"device":"web"}}'), (3, '{"ts":"2025-03-02T09:30:00","type":"purchase","user":{"id":"u1","country":"RU"},"items":[{"sku":"A1","qty":1,"price":10.5}],"coupon":"SPRING10"}'), (4, '{"ts":"bad-date","type":"purchase","user":{"id":"u3","country":"KZ"},"items":[{"sku":"C3","qty":"two","price":5}]}'), (5, '{"ts":"2025-03-02T14:00:00","type":"purchase","user":{"id":"u2","country":"DE"},"items":[{"sku":"C3","qty":3,"price":5}],"attrs":{"device":"android"}}'), (6, '{"ts":"2025-03-03T08:00:00","type":"view","user":{"id":"u3","country":"KZ"},"items":[]}');
-- отзывы клиентов (текст)CREATE TABLE raw_feedback (feedback_id INT, payload JSON);INSERT INTO raw_feedback VALUES (1, '{"user":"u1","ts":"2025-03-02","text":"Отлично, быстро доставили"}'), (2, '{"user":"u2","ts":"2025-03-02","text":"Долго ждал, плохая упаковка","stars":2}'), (3, '{"user":"u1","ts":"2025-03-03","text":"Супер, возьму ещё"}'), (4, '{"user":"u3","ts":"2025-03-03","text":"Нормально"}');Задания
Заголовок раздела «Задания»1. Schema-on-read. Не создавая схему, найдите, какие поля встречаются в событиях и как часто. Потом достаньте user.id, user.country и coupon из JSON.
Решение
-- профиль структуры: какие поля есть и в скольких событияхSELECT k AS field, count(*) AS eventsFROM (SELECT unnest(json_keys(payload)) AS k FROM raw_events)GROUP BY kORDER BY events DESC, field;
-- достаём значения. Если поля нет, получаем NULLSELECT event_id,       payload->>'$.user.id'      AS user_id,       payload->>'$.user.country' AS country,       payload->>'$.coupon'       AS couponFROM raw_eventsORDER BY event_id;
Поля items, ts, type, user есть во всех шести событиях. attrs есть в трёх, coupon в одном. Отсутствие поля не ломает запрос: вернётся NULL.
2. Flatten. Разверните массив items из покупок в строки: одна строка на товар. Потом разверните attrs в пары «имя и значение».
Решение
-- одна строка на товар в покупкеSELECT e.event_id,       i->>'$.sku'                                  AS sku,       i->>'$.qty'                                  AS qty_raw,       try_cast(i->>'$.price' AS DECIMAL(10,2))     AS priceFROM raw_events e, unnest(from_json(e.payload->'$.items', '["JSON"]')) AS t(i)WHERE e.payload->>'$.type' = 'purchase'ORDER BY e.event_id, sku;
-- пары имя и значениеSELECT e.event_id, j.key AS attr_name, trim(j.value::VARCHAR, '"') AS attr_valueFROM raw_events e, json_each(e.payload->'$.attrs') AS jORDER BY e.event_id, attr_name;
Первый запрос вернёт 5 строк (товары из событий 1, 3, 4 и 5). Второй вернёт 4 пары. События 3, 4 и 6 не имеют attrs, и в результат не попадут.
3. Schema-on-write. Создайте типизированную таблицу stg_event_item с try_cast для времени и количества. Строки, где приведение не удалось, сохраните в rejected_event_item. Оставшиеся поместите в clean_event_item.
Решение
CREATE TABLE stg_event_item ASSELECT e.event_id,       try_cast(e.payload->>'$.ts' AS TIMESTAMP)  AS event_ts,       e.payload->>'$.user.id'                    AS user_id,       e.payload->>'$.user.country'               AS country,       i->>'$.sku'                                AS sku,       try_cast(i->>'$.qty' AS INT)               AS qty,       try_cast(i->>'$.price' AS DECIMAL(10,2))   AS price,       e.payload::VARCHAR                         AS raw_jsonFROM raw_events e, unnest(from_json(e.payload->'$.items', '["JSON"]')) AS t(i)WHERE e.payload->>'$.type' = 'purchase';
CREATE TABLE rejected_event_item ASSELECT * FROM stg_event_itemWHERE event_ts IS NULL OR qty IS NULL OR price IS NULL;
CREATE TABLE clean_event_item ASSELECT * FROM stg_event_itemWHERE event_ts IS NOT NULL AND qty IS NOT NULL AND price IS NOT NULL;
SELECT 'clean' AS bucket, count(*) AS rows_cnt FROM clean_event_itemUNION ALLSELECT 'rejected', count(*) FROM rejected_event_item;
Чистых строк 4, отклонена 1 (событие 4: плохая дата и qty = "two"). В raw_json лежит исходный документ. Так можно разобрать причину и перезагрузить.
4. Fact extractor. Из текстов отзывов получите числовые факты. Определите тональность по ключевым словам и посчитайте по дням число положительных, отрицательных и нейтральных отзывов, а также долю положительных.
Решение
CREATE TABLE fact_feedback ASSELECT feedback_id,       payload->>'$.user'                       AS user_id,       CAST(payload->>'$.ts' AS DATE)           AS feedback_date,       CASE           WHEN lower(payload->>'$.text') LIKE '%отлично%' OR lower(payload->>'$.text') LIKE '%супер%'  THEN 'positive'           WHEN lower(payload->>'$.text') LIKE '%плох%'    OR lower(payload->>'$.text') LIKE '%долго%'  THEN 'negative'           ELSE 'neutral'       END AS sentimentFROM raw_feedback;
SELECT feedback_date,       count(*) FILTER (WHERE sentiment = 'positive') AS positive,       count(*) FILTER (WHERE sentiment = 'negative') AS negative,       count(*) FILTER (WHERE sentiment = 'neutral')  AS neutral,       round(count(*) FILTER (WHERE sentiment = 'positive') / count(*), 2) AS positive_shareFROM fact_feedbackGROUP BY feedback_dateORDER BY feedback_date;
2 марта: 1 положительный, 1 отрицательный. 3 марта: 1 положительный, 1 нейтральный. Тексты превратились в числа, которые можно суммировать. Это и есть fact extractor. Правила на ключевых словах — простой пример. В реальной системе тут стоит модель.
5. Загрузка в dimensional model. Постройте dim_user с unknown member и surrogate key. Создайте dim_product из sku. Загрузите fact_purchase_item с grain «один товар в одном событии покупки». Затем посчитайте выручку по странам.
Решение
-- dim_user: user_key = surrogate key хранилища, user_id = natural key источника.-- страна берётся из самого свежего событияCREATE TABLE dim_user ASSELECT 0 AS user_key, 'unknown' AS user_id, 'Unknown' AS countryUNION ALLSELECT row_number() OVER (ORDER BY user_id), user_id, coalesce(country, 'Unknown')FROM (    SELECT payload->>'$.user.id' AS user_id,           arg_max(payload->>'$.user.country', try_cast(payload->>'$.ts' AS TIMESTAMP)) AS country    FROM raw_events    GROUP BY 1);
CREATE TABLE dim_product ASSELECT row_number() OVER (ORDER BY sku) AS product_key, skuFROM (SELECT DISTINCT sku FROM clean_event_item);
-- grain: один товар в одном событии покупкиCREATE TABLE fact_purchase_item ASSELECT c.event_id,       row_number() OVER (PARTITION BY c.event_id ORDER BY c.sku) AS line_no,       strftime(c.event_ts, '%Y%m%d')::INT      AS date_key,       coalesce(u.user_key, 0)                  AS user_key,       p.product_key,       c.qty,       c.qty * c.price                          AS amountFROM clean_event_item cLEFT JOIN dim_user u    ON u.user_id = c.user_idJOIN dim_product p      ON p.sku = c.sku;
SELECT u.country, sum(f.amount) AS revenue, count(*) AS itemsFROM fact_purchase_item fJOIN dim_user u USING (user_key)GROUP BY u.countryORDER BY revenue DESC;
Выручка RU: 2 * 10.5 + 99 + 10.5 = 130.50, три позиции. DE: 15.00, одна позиция. KZ в результате нет, потому что событие 4 отклонено. Его нужно разобрать в rejected_event_item.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему big data не отменяет dimensional modeling?
- Чем отличаются Extended RDBMS и MapReduce/Hadoop? Для каких задач подходит каждый?
- Что такое data highway и зачем нужен backflow?
- В чём разница между schema-on-read и schema-on-write? Когда нужна вторая?
- Что такое fact extractor? Приведите пример.