

The Data Warehouse Toolkit, глава 6: Управление заказами
Главная мысль: заказ состоит из заголовка и строк. Fact table строим на grain строки заказа. Суммы заголовка (доставка, скидка) раскладываем по строкам. Путь заказа от размещения до выставления счёта описывает accumulating snapshot с lags.
Order management и bus matrix
Заголовок раздела «Order management и bus matrix»Заказ запускает много процессов. Каждый процесс — своя строка в bus matrix.
| Процесс | Date | Customer | Product | Sales rep | Deal | Order profile |
|---|---|---|---|---|---|---|
| Quote (предложение) | X | X | X | X | X | |
| Order | X | X | X | X | X | X |
| Shipment | X | X | X | X | ||
| Invoice | X | X | X | X | X | X |
| Return | X | X | X | X |
- Это цепочка ценности. Процессы идут один за другим и используют одни и те же dimensions.
- Одна dimension в разных процессах — conformed dimension (см. главу 4).
Order transactions
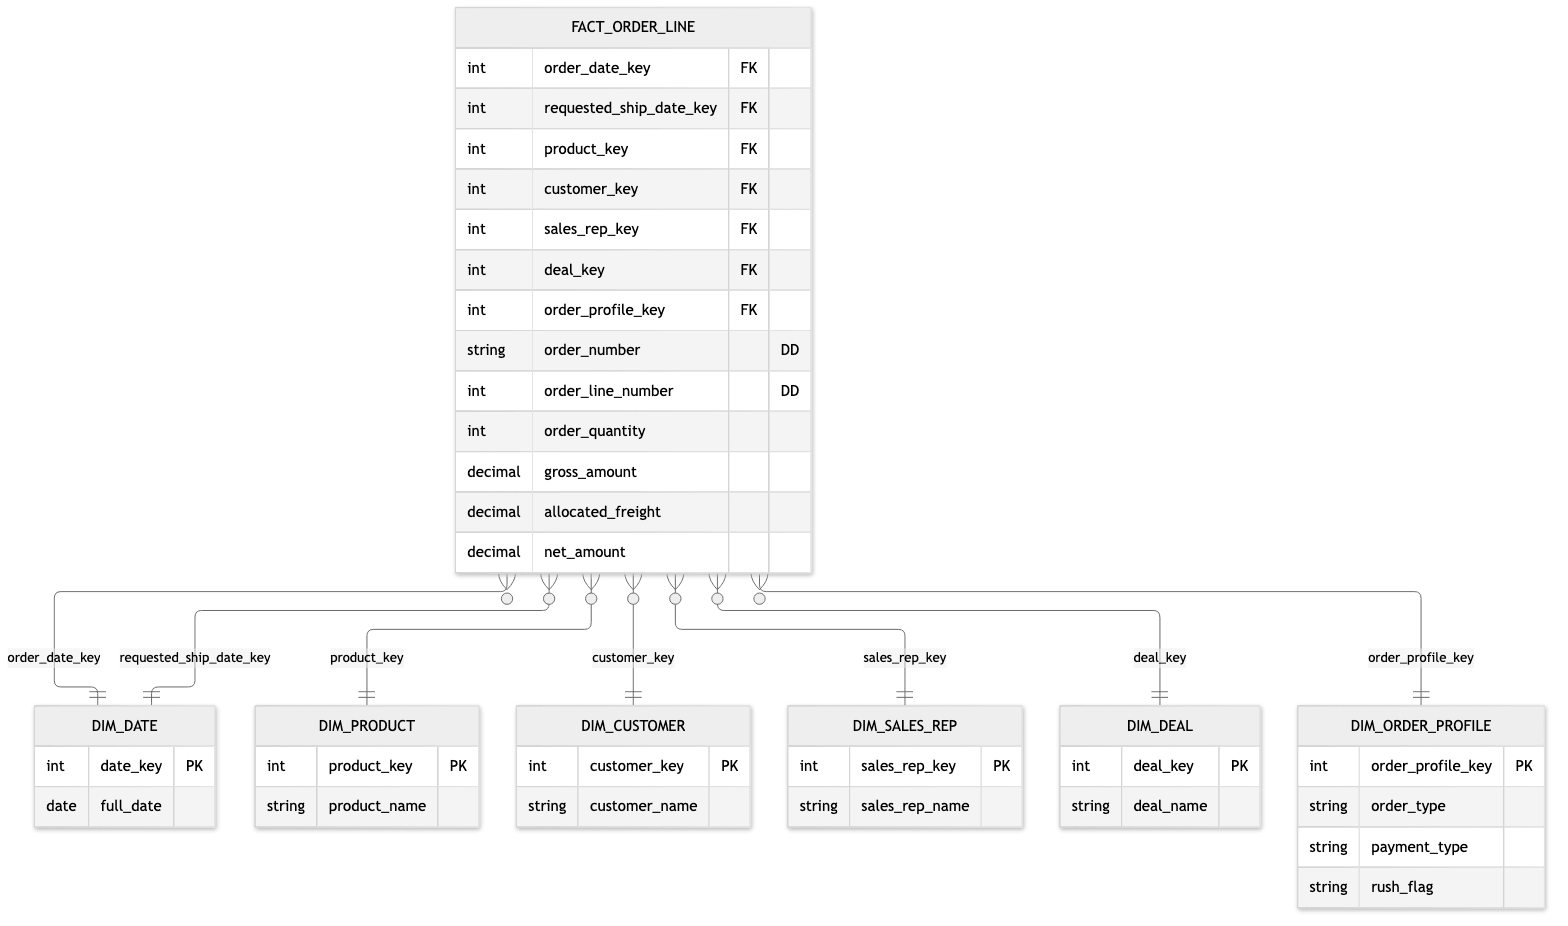
Заголовок раздела «Order transactions»Grain: одна строка заказа (order line item). Это самый детальный уровень.
| Элемент | Что включаем |
|---|---|
| Dimensions | Дата заказа, запрошенная дата отгрузки, клиент, товар, менеджер, сделка (deal), order profile |
| Degenerate dimensions | order_number, order_line_number |
| Facts | Количество, gross amount, скидка, net amount |
| Недопустимо | Факты заголовка заказа, не разложенные по строкам |
Role-playing dimension
Заголовок раздела «Role-playing dimension»В заказе много дат: дата заказа, запрошенная дата отгрузки, фактическая отгрузка, доставка, оплата. Это одна physical dim_date в разных ролях.
- В запросе — alias для каждой роли:
order_date,ship_date. - Удобнее сделать view на каждую роль с переименованными колонками. Тогда в BI нет путаницы.
- Foreign key в fact называем по роли:
order_date_key,requested_ship_date_key.
Customer dimension
Заголовок раздела «Customer dimension»- Это широкая таблица: название, адрес, сегмент, иерархия, ответственный менеджер.
- Атрибуты меняются: используйте SCD (глава 5).
- Для клиентов с несколькими адресами и ролями нужны отдельные dimensions или bridge table.
Junk dimension: order profile
Заголовок раздела «Junk dimension: order profile»У заказа много маленьких признаков: тип заказа, способ оплаты, срочность, канал. Отдельная dimension на каждый признак была бы лишней. Складываем комбинации в одну junk dimension. В fact остаётся один ключ.
Deal dimension
Заголовок раздела «Deal dimension»Скидки и условия сделки описывают в отдельной dimension. Один заказ может иметь сложные условия. В fact хранят ключ, а условия — в dimension.
Header/line: главная ловушка
Заголовок раздела «Header/line: главная ловушка»Заказ имеет заголовок (header) и строки (line). У заголовка свои числа: доставка, налог, общая скидка. У строки свои: количество, цена.
Если положить сумму заголовка в каждую строку, получится ошибка. Сумма доставки в 10 рублей при трёх строках превратится в 30.
| Решение | Что делаем | Когда |
|---|---|---|
| Allocation | Раскладываем сумму заголовка по строкам пропорционально gross amount | Основной путь. Fact остаётся additive |
| Отдельный fact на grain заголовка | Заголовочные суммы живут отдельно | Когда разложить нельзя |
| Degenerate dimension | Номер заказа в fact | Всегда, чтобы собрать строки в заказ |
Книга называет два плохих варианта header/line:
- Заголовок как огромная dimension (
dim_order_header). Она растёт так же быстро, как fact. - Заголовок как отдельный fact, а строки ссылаются на него по
order_number. Строки не наследуют dimensions заголовка (клиент, дата). Чтобы отфильтровать строки по клиенту, нужна join двух fact.
Правильно: строка наследует все dimensions заголовка.
Правила allocation:
- Сумма по строкам должна точно равна сумме в заголовке. Следите за округлением: остаток отдайте одной строке.
- Правило распределения (пропорционально сумме, количеству, весу) согласуйте с бизнесом.
- Книга называет такие факты
allocated facts. Тот же приём используют в P&L (прибыль и убытки).
Другие техники главы
Заголовок раздела «Другие техники главы»| Тема | Суть |
|---|---|
| Multiple currencies | В fact две суммы: местная валюта и единая отчётная. Курс фиксируем на момент события. Альтернатива — отдельная таблица курсов |
| Multiple units of measure | Храним количества в одной базовой единице и коэффициенты конверсии прямо в fact. View показывает количества в любой единице. Коэффициенты в dimension книга не советует: пользователи ошибаются, а коэффициенты меняются во времени |
| Audit dimension | Метаданные ETL: batch, версия правил, флаг качества. Ключ в fact |
| Invoice transactions | Счёт — отдельный процесс. Grain: строка счёта. Содержит дату отгрузки и дату счёта |
| Service level | Качество отгрузки можно хранить как факт (флаг «вовремя» 0/1, lag в днях), как атрибут («на 2 дня позже») или и то, и другое |
| Profit and loss facts | В fact счёта кладём выручку и затраты по порядку P&L: от gross revenue до net profit. Часть затрат приходит через allocation |
| Credit memos и returns | Возвраты — отдельный fact или отрицательные суммы. Нужна причина возврата |
| Late arriving facts | Факт пришёл поздно. Ищем версию dimension на дату события |
Не делайте так:
- Не смешивайте разные grain в одной таблице (заголовок и строки).
- Не нормализуйте facts в пару «тип метрики + значение» (
fact normalization). Строк станет в разы больше, а считать отношения между фактами станет трудно. - Не храните «чистое» отношение, например процент скидки. Храните суммы и считайте отношение в запросе.
- Не оставляйте
NULLв foreign key даты. Используйте строку «ещё не наступило».
Accumulating snapshot заказа
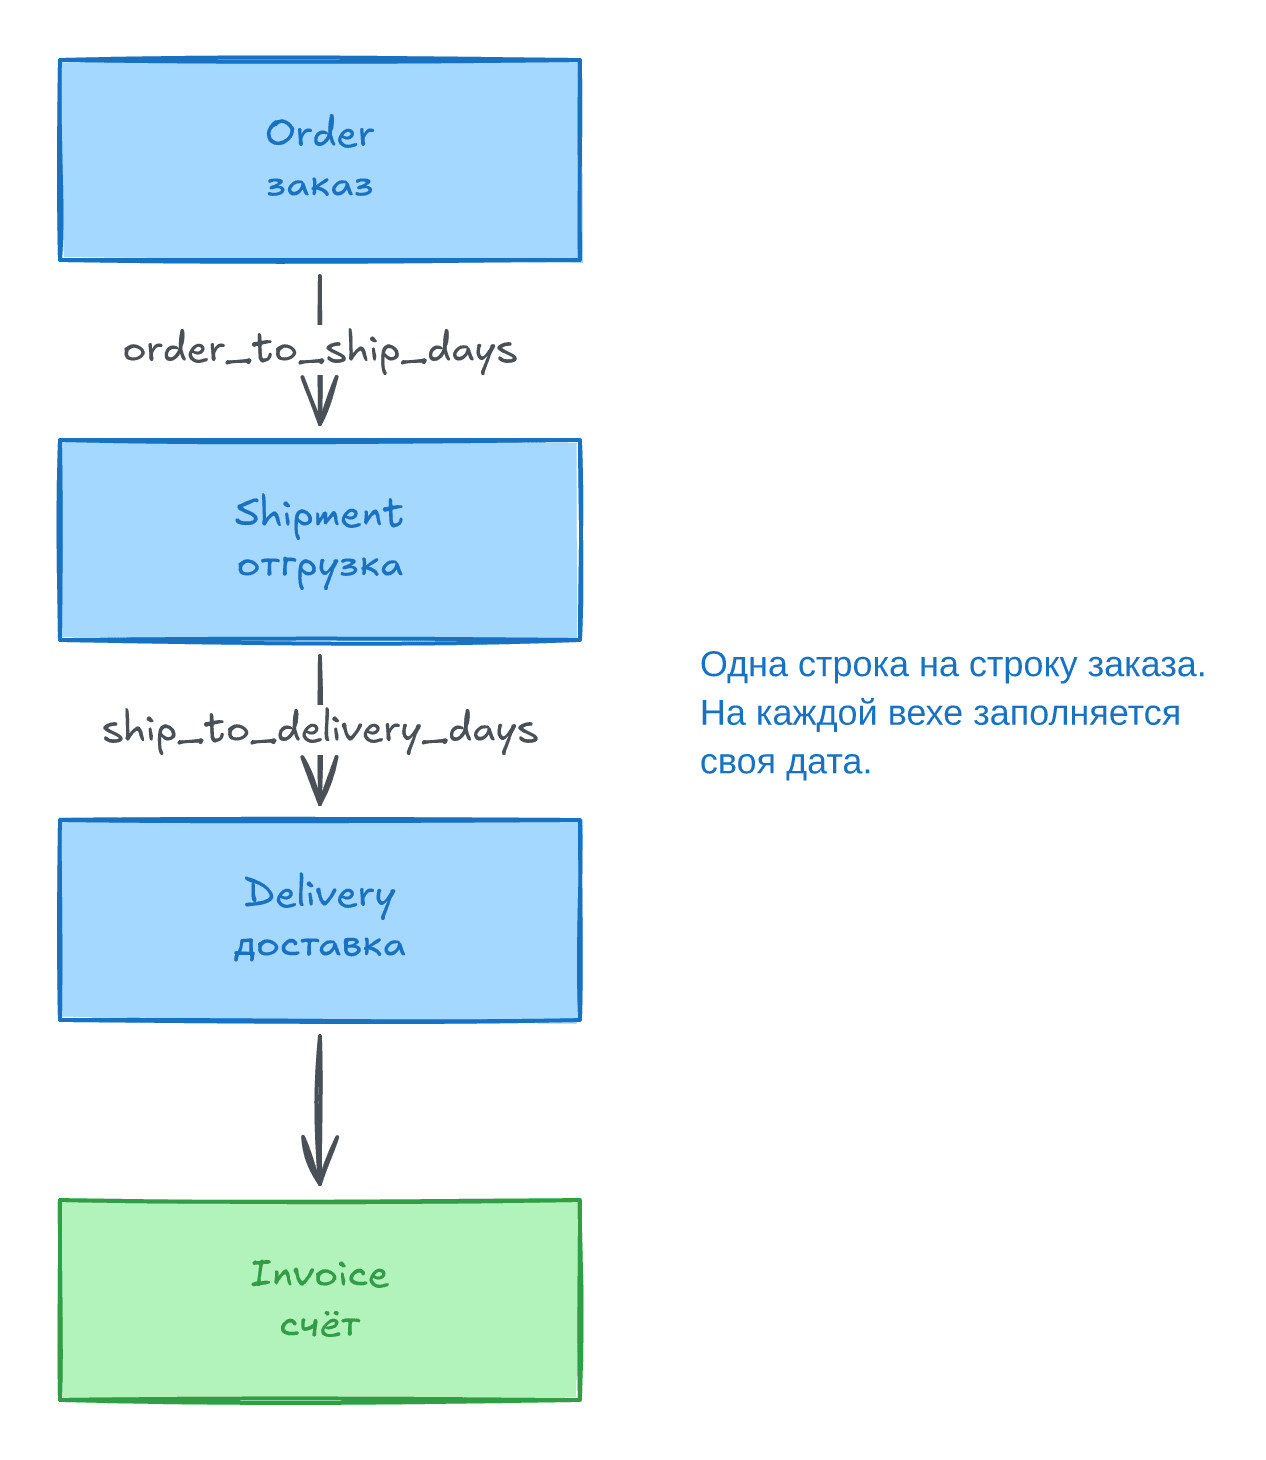
Заголовок раздела «Accumulating snapshot заказа»Заказ проходит конвейер. Для него строим accumulating snapshot.
| Элемент | Как устроен |
|---|---|
| Grain | Одна строка заказа на весь путь |
| Date keys | order_date_key, ship_date_key, delivery_date_key, invoice_date_key и так далее |
| Lags | order_to_ship_days, ship_to_delivery_days |
| Счётчики | Флаги вех. Например, 1, когда веха пройдена |
| Обновление | Строку вставляем при заказе и обновляем при каждой вехе |
| Неснятая веха | Ключ ссылается на строку dimension «ещё не наступило». Lag равен NULL |
Что он даёт:
- Видно, где заказы «застревают».
- Легко считать средние сроки и просрочки.
- Поддерживает не только последние события, а весь путь заказа.
Если путь заказа плохо определён, accumulating snapshot не подходит. Тогда достаточно transactions.
Factless fact tables
Заголовок раздела «Factless fact tables»Factless fact table не имеет числовых фактов. Строка означает «событие произошло» или «такая комбинация возможна».
| Вид | Пример |
|---|---|
| Событие | Клиент получил рекламное письмо |
| Coverage | Какой торговый представитель закреплён за клиентом. Две даты: начало и конец закрепления. Пример книги |
Вопрос «чего не было» решаем в два шага: берём coverage table и вычитаем таблицу реальных событий. Остаток — это то, что не произошло. Например, закрепления представителей, по которым не было ни одного заказа. В практике ниже та же идея на примере товаров по сделке.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Header/line | Заголовок документа и его строки |
| Allocation | Распределение суммы заголовка по строкам |
| Role-playing dimension | Одна dimension в нескольких ролях |
| Junk dimension | Мелкие флаги в одной таблице |
| Accumulating snapshot | Одна строка на процесс, обновляется по вехам |
| Lag | Число дней между вехами |
| Factless fact table | Fact table без числовых фактов |
| Coverage table | Все возможные комбинации событий |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте grain строки заказа, а не заголовка.
- Номер заказа держите как degenerate dimension. По нему собирают «корзину».
- Сумму allocation проверяйте тестом
dbt: сумма по строкам равна сумме в заголовке. - В
dbtaccumulating snapshot — этоincrementalсmergeпоorder_numberиorder_line_number. - Для каждой роли даты делайте view:
dim_order_date,dim_ship_date. - Чтобы найти «чего не было», держите coverage table и делайте
anti join.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку в одной сессии.
Шаг 1. Создаём dimensions и staging заказов
Заголовок раздела «Шаг 1. Создаём dimensions и staging заказов»Модель упрощена: без sales rep, deal и order profile. Техники от этого не меняются.
CREATE MACRO key_to_date(k) AS strptime(k::VARCHAR, '%Y%m%d')::DATE;
-- ключ 0 = «ещё не наступило»CREATE TABLE dim_date ASSELECT strftime(d, '%Y%m%d')::INT AS date_key, d::DATE AS full_date, dayname(d) AS day_nameFROM generate_series(DATE '2024-03-01', DATE '2024-03-31', INTERVAL 1 DAY) t(d)UNION ALLSELECT 0, NULL, 'Не наступило';
CREATE TABLE dim_customer ASSELECT * FROM (VALUES (1, 'Альфа'), (2, 'Бета'), (3, 'Гамма')) t(customer_key, customer_name);
CREATE TABLE dim_product ASSELECT * FROM (VALUES (1, 'Товар A'), (2, 'Товар B'), (3, 'Товар C')) t(product_key, product_name);
-- заголовки заказов: freight относится ко всему заказуCREATE TABLE stg_order_header ASSELECT * FROM (VALUES    ('O1', DATE '2024-03-01', DATE '2024-03-04', 1, 10.00),    ('O2', DATE '2024-03-05', DATE '2024-03-08', 2, 12.00),    ('O3', DATE '2024-03-10', DATE '2024-03-12', 1,  5.00),    ('O4', DATE '2024-03-20', DATE '2024-03-25', 3,  8.00)) t(order_number, order_date, requested_ship_date, customer_key, freight_amount);
-- строки заказовCREATE TABLE stg_order_line ASSELECT * FROM (VALUES    ('O1', 1, 1, 2, 50.0),    ('O1', 2, 2, 1, 100.0),    ('O1', 3, 3, 4, 25.0),    ('O2', 1, 1, 5, 50.0),    ('O2', 2, 2, 1, 100.0),    ('O3', 1, 3, 10, 25.0),    ('O4', 1, 2, 2, 100.0),    ('O4', 2, 1, 1, 50.0)) t(order_number, order_line_number, product_key, order_quantity, unit_price);
-- события конвейера, пришедшие из склада и биллингаCREATE TABLE stg_order_event ASSELECT * FROM (VALUES    ('O1', 1, 'shipped',   DATE '2024-03-03'),    ('O1', 1, 'delivered', DATE '2024-03-05'),    ('O1', 1, 'invoiced',  DATE '2024-03-03'),    ('O1', 2, 'shipped',   DATE '2024-03-04'),    ('O1', 2, 'delivered', DATE '2024-03-06'),    ('O1', 2, 'invoiced',  DATE '2024-03-04'),    ('O1', 3, 'shipped',   DATE '2024-03-04'),    ('O1', 3, 'delivered', DATE '2024-03-07'),    ('O1', 3, 'invoiced',  DATE '2024-03-04'),    ('O2', 1, 'shipped',   DATE '2024-03-09'),    ('O2', 1, 'delivered', DATE '2024-03-11'),    ('O2', 1, 'invoiced',  DATE '2024-03-09'),    ('O2', 2, 'shipped',   DATE '2024-03-08'),    ('O2', 2, 'delivered', DATE '2024-03-10'),    ('O2', 2, 'invoiced',  DATE '2024-03-08'),    ('O3', 1, 'shipped',   DATE '2024-03-12')) t(order_number, order_line_number, event_type, event_date);
Задания
Заголовок раздела «Задания»1. Header/line и allocation. Постройте fact_order_line на grain строки. Разложите freight_amount по строкам пропорционально gross amount. Сумма по заказу должна совпасть с заголовком. Сначала покажите ошибку: что будет, если просто присоединить freight к каждой строке.
Решение
-- ошибка: freight повторяется на каждой строкеSELECT sum(h.freight_amount) AS wrong_freight,       (SELECT sum(freight_amount) FROM stg_order_header) AS right_freightFROM stg_order_line lJOIN stg_order_header h USING (order_number);
-- правильно: allocation пропорционально gross, остаток от округления в первую строкуCREATE TABLE fact_order_line ASWITH lines AS (    SELECT l.order_number, l.order_line_number, l.product_key, l.order_quantity,           l.order_quantity * l.unit_price AS gross_amount,           h.customer_key, h.freight_amount,           strftime(h.order_date, '%Y%m%d')::INT AS order_date_key,           strftime(h.requested_ship_date, '%Y%m%d')::INT AS requested_ship_date_key,           round(h.freight_amount * (l.order_quantity * l.unit_price)                 / sum(l.order_quantity * l.unit_price) OVER (PARTITION BY l.order_number), 2) AS alloc_raw    FROM stg_order_line l    JOIN stg_order_header h USING (order_number))SELECT order_number, order_line_number, order_date_key, requested_ship_date_key,       customer_key, product_key, order_quantity, gross_amount,       (alloc_raw + CASE WHEN order_line_number = 1            THEN freight_amount - sum(alloc_raw) OVER (PARTITION BY order_number)            ELSE 0 END)::DECIMAL(10,2) AS allocated_freightFROM lines;
-- проверка: разница равна 0 для каждого заказаSELECT f.order_number, sum(f.allocated_freight) AS allocated, max(h.freight_amount) AS header_freight,       sum(f.allocated_freight) - max(h.freight_amount) AS diffFROM fact_order_line fJOIN stg_order_header h USING (order_number)GROUP BY f.order_numberORDER BY f.order_number;
У заказа O1 три строки по 100. Без правки получится 3.33 × 3 = 9.99. Остаток 0.01 уходит в первую строку.
2. Accumulating snapshot. Создайте таблицу fact_order_fulfillment на grain строки заказа. Вставьте строки со всеми вехами = 0. Потом обновите вехи из stg_order_event и посчитайте lags.
Решение
CREATE TABLE fact_order_fulfillment ASSELECT order_number, order_line_number, customer_key, product_key,       order_date_key, requested_ship_date_key,       0 AS ship_date_key, 0 AS delivery_date_key, 0 AS invoice_date_key,       NULL::INT AS order_to_ship_days,       NULL::INT AS ship_to_delivery_daysFROM fact_order_line;
UPDATE fact_order_fulfillment fSET ship_date_key     = coalesce(e.ship_key,     f.ship_date_key),    delivery_date_key = coalesce(e.delivery_key, f.delivery_date_key),    invoice_date_key  = coalesce(e.invoice_key,  f.invoice_date_key)FROM (    SELECT order_number, order_line_number,           max(CASE WHEN event_type = 'shipped'   THEN strftime(event_date, '%Y%m%d')::INT END) AS ship_key,           max(CASE WHEN event_type = 'delivered' THEN strftime(event_date, '%Y%m%d')::INT END) AS delivery_key,           max(CASE WHEN event_type = 'invoiced'  THEN strftime(event_date, '%Y%m%d')::INT END) AS invoice_key    FROM stg_order_event    GROUP BY order_number, order_line_number) eWHERE f.order_number = e.order_number AND f.order_line_number = e.order_line_number;
UPDATE fact_order_fulfillmentSET order_to_ship_days = CASE WHEN ship_date_key <> 0        THEN date_diff('day', key_to_date(order_date_key), key_to_date(ship_date_key)) END,    ship_to_delivery_days = CASE WHEN delivery_date_key <> 0        THEN date_diff('day', key_to_date(ship_date_key), key_to_date(delivery_date_key)) END;
SELECT order_number, order_line_number, ship_date_key, delivery_date_key,       order_to_ship_days, ship_to_delivery_daysFROM fact_order_fulfillmentORDER BY order_number, order_line_number;
3. Анализ lags. Покажите средний срок «заказ → отгрузка» и «отгрузка → доставка» по клиентам. Затем найдите строки, которые ещё не отгружены, и их возраст в днях на 31 марта.
Решение
SELECT c.customer_name,       round(avg(f.order_to_ship_days), 2)    AS avg_order_to_ship,       round(avg(f.ship_to_delivery_days), 2) AS avg_ship_to_deliveryFROM fact_order_fulfillment fJOIN dim_customer c USING (customer_key)GROUP BY c.customer_nameORDER BY c.customer_name;
-- открытые строки: ещё не отгруженыSELECT order_number, order_line_number,       date_diff('day', key_to_date(order_date_key), DATE '2024-03-31') AS age_daysFROM fact_order_fulfillmentWHERE ship_date_key = 0ORDER BY age_days DESC;
Строки без доставки дают NULL в lag. avg их пропускает, поэтому средние не портятся.
4. Role-playing dimension. Сделайте два view над dim_date: для запрошенной даты отгрузки и для фактической даты отгрузки. Найдите строки, отгруженные позже запрошенной даты. Покажите, во сколько дней просрочка.
Решение
CREATE VIEW dim_requested_date ASSELECT date_key AS requested_ship_date_key, full_date AS requested_ship_date FROM dim_date;
CREATE VIEW dim_ship_date ASSELECT date_key AS ship_date_key, full_date AS ship_date, day_name AS ship_day FROM dim_date;
SELECT f.order_number, f.order_line_number,       r.requested_ship_date, s.ship_date,       s.ship_date - r.requested_ship_date AS days_lateFROM fact_order_fulfillment fJOIN dim_requested_date r USING (requested_ship_date_key)JOIN dim_ship_date s USING (ship_date_key)WHERE s.ship_date > r.requested_ship_dateORDER BY days_late DESC;
Одна dim_date играет три роли: заказ, запрошенная и фактическая отгрузка. В fact каждая роль — свой foreign key.
5. Factless coverage. Создайте таблицу fact_deal_coverage: какие товары доступны каждому клиенту по сделке. Найдите товары по сделке, которые клиент ни разу не заказал.
Решение
CREATE TABLE fact_deal_coverage ASSELECT * FROM (VALUES    (1, 1), (1, 2),    (2, 1), (2, 3),    (3, 2), (3, 3)) t(customer_key, product_key);
-- coverage минус то, что произошлоSELECT c.customer_name, p.product_nameFROM fact_deal_coverage covLEFT JOIN (SELECT DISTINCT customer_key, product_key FROM fact_order_line) act       USING (customer_key, product_key)JOIN dim_customer c USING (customer_key)JOIN dim_product p USING (product_key)WHERE act.customer_key IS NULLORDER BY c.customer_name, p.product_name;
Результат: Бета не заказывала Товар C, Гамма не заказывала Товар C. В fact_order_line этих строк нет, поэтому одним запросом по ней ответа не получить. Нужна coverage table.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему сумму заголовка нельзя просто повторить в каждой строке?
- Как выбрать правило allocation и как проверить, что сумма сошлась?
- Чем accumulating snapshot отличается от transaction fact table? Когда он подходит?
- Как найти события, которых не было, если в fact table есть только события, которые были?