

AI Engineering, глава 7: Finetuning
Главная мысль: Finetuning меняет веса модели. Он нужен для формы ответа: стиль, формат, поведение. Для фактов лучше RAG. Главная техническая проблема finetuning — память. Поэтому все современные приёмы (PEFT, LoRA, QLoRA) экономят память.
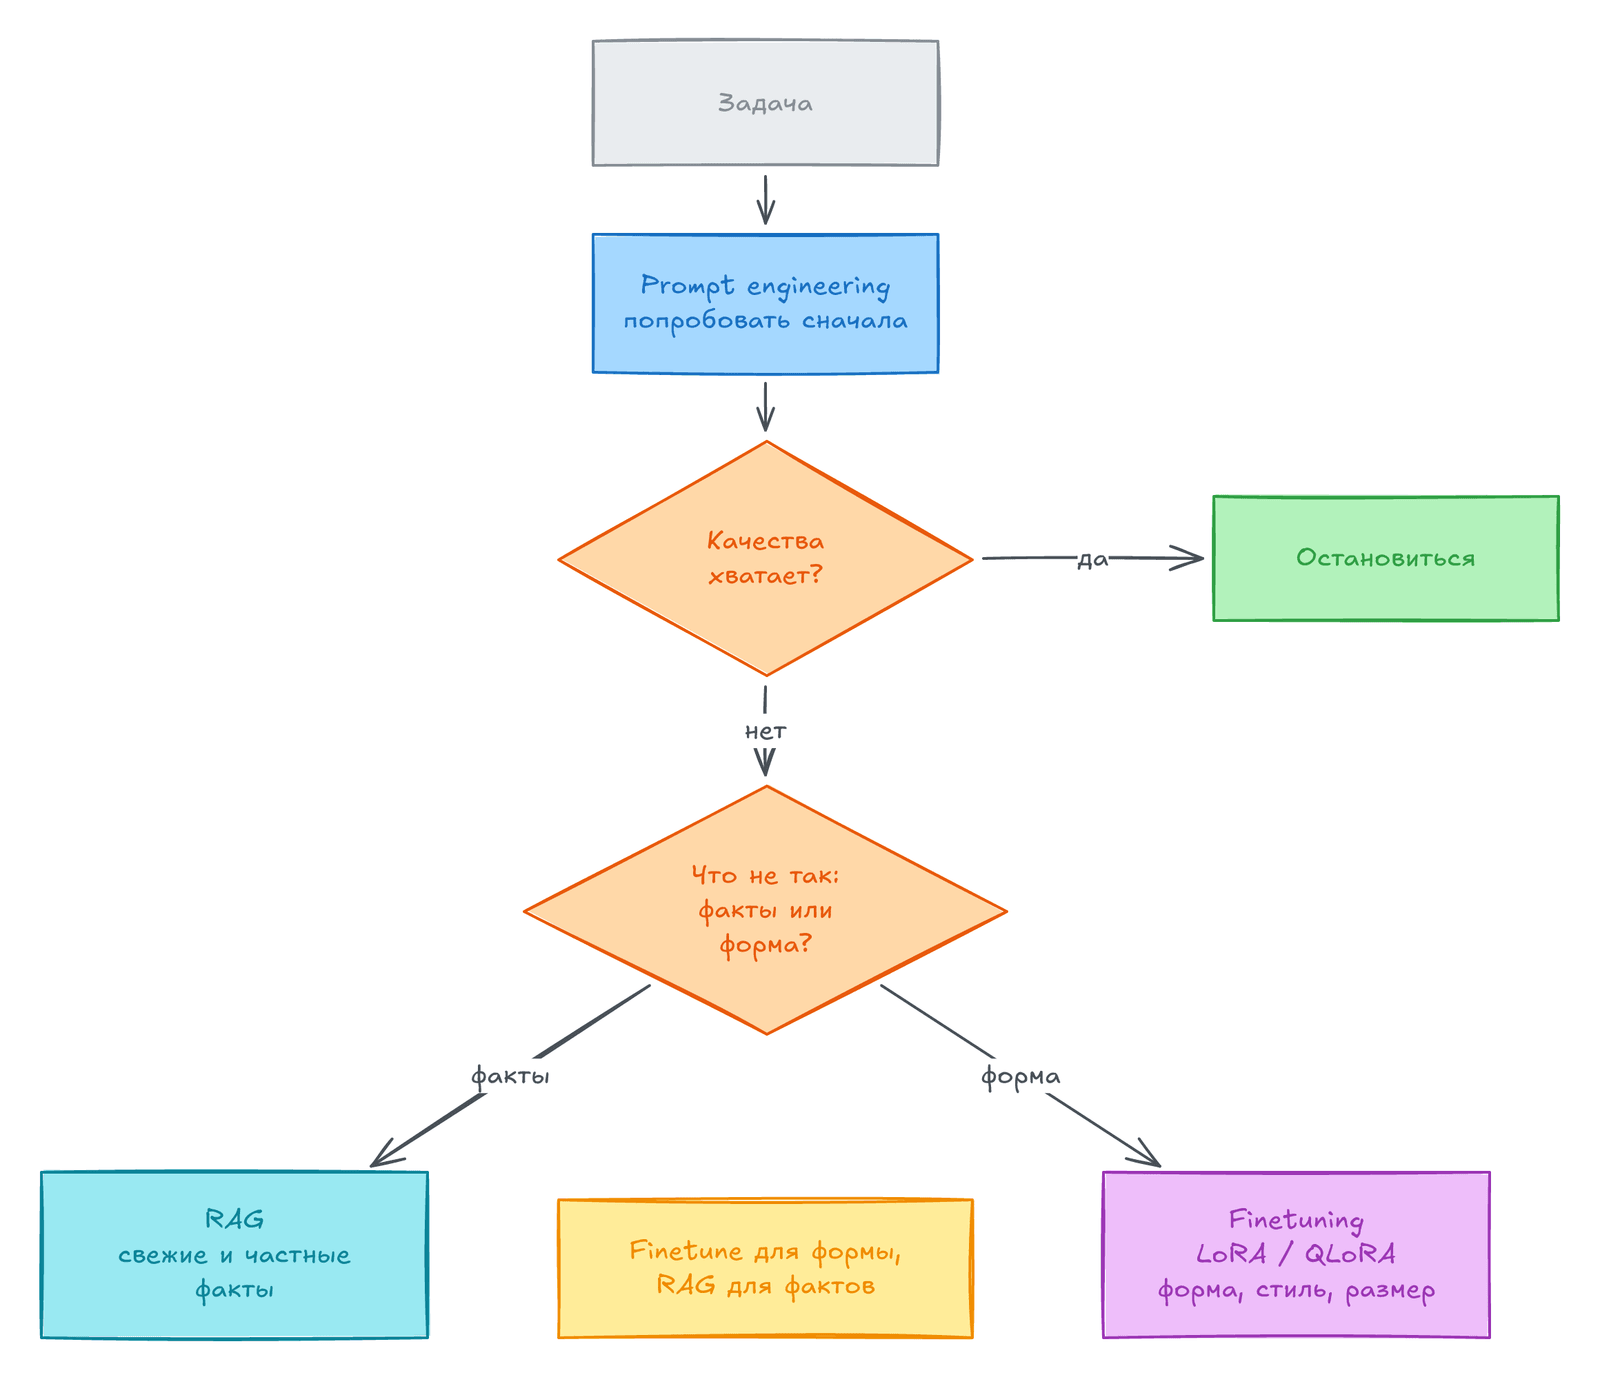
Что такое finetuning
Заголовок раздела «Что такое finetuning»Finetuning продолжает обучение готовой модели на ваших данных. Это часть transfer learning: знания из одной задачи помогают в другой.
- Pre-training учит модель языку на огромном тексте. Данных много, разметка не нужна.
- Finetuning берёт готовую модель и учит её вашей задаче. Для этого хватает сотен или тысяч примеров.
- Идея из InstructGPT: finetuning не вкладывает новые способности. Он открывает те, что в модели уже есть.
Виды finetuning:
| Вид | Данные | Для чего |
|---|---|---|
| Continued pre-training (self-supervised) | Сырой текст из вашей области | Привыкнуть к домену или языку |
| Supervised finetuning (SFT) | Пары (инструкция, ответ) | Следовать инструкциям, нужный формат |
| Preference finetuning | Тройки (инструкция, хороший ответ, плохой ответ) | Ответы, которые нравятся людям |
| Long-context finetuning | Длинные тексты | Расширить контекст. Меняет архитектуру, сложно |
Обычно вы дообучаете модель, которую уже довели до instruct-версии. Чем ближе модель к вашей задаче, тем меньше работы.
Когда делать finetuning
Заголовок раздела «Когда делать finetuning»Finetuning дорог. Нужны данные, GPU и люди, которые умеют обучать модели. Поэтому сначала пробуют prompt.
Причины за
Заголовок раздела «Причины за»- Нужна лучшая форма: строгий
JSONилиYAML, свой стиль, редкий формат. - Нужен редкий домен. Пример: модель знает стандартный SQL, но ошибается в диалекте вашего хранилища или в ваших типовых запросах.
- Нужно уменьшить
bias: дообучить на аккуратно собранных данных. - Нужна маленькая и дешёвая модель. Её дообучают на ответах большой модели. Это
distillation. - Нужно убрать длинные примеры из каждого prompt. Меньше токенов, меньше latency. Количество примеров уже не ограничено контекстом.
Факт из книги: Grammarly дообучила Flan-T5, который в 60 раз меньше специализированной GPT-3. Он оказался лучше на задачах редактирования текста. Данных было всего 82 тысячи пар.
Причины против
Заголовок раздела «Причины против»- Finetuning под одну задачу может ухудшить другие. Пример: бот для заказов стал лучше менять заказы, но хуже советует товары.
- Нужны данные. Разметка дорога. Синтетика и open-source данные дают разный результат.
- Нужны навыки: выбрать базовую модель, learning rate, следить за overfitting, оценивать качество.
- Нужен деплой и поддержка. Новые базовые модели выходят быстро. Они могут обогнать вашу дообученную модель.
- Часто prompt просто плохой: размытые инструкции, примеры не из реальных данных, нет метрик. После правки prompt finetuning не нужен.
Пример из книги: BloombergGPT (50B параметров) стоил около 1,3 млн GPU-часов A100. Это порядка 1,3-2,6 млн долларов только на вычисления. Почти сразу универсальный GPT-4 показал на финансовых тестах результат лучше. Вывод: универсальные модели быстро догоняют узкие.
Finetuning или RAG
Заголовок раздела «Finetuning или RAG»Сначала поймите тип ошибки.
| Тип ошибки | Пример | Что помогает |
|---|---|---|
| Информационная | Модель не знает ваших данных или знает устаревшее | RAG |
| Поведенческая | Ответ верный, но не по теме, не того формата, не того стиля | Finetuning |
Короткое правило: finetuning для формы, RAG для фактов.
- Если есть оба типа ошибок, начните с RAG. Он проще: не нужны обучающие данные и свой хостинг модели.
- Для RAG сначала берите простой поиск по словам (
BM25), а не векторную базу. - В исследовании Ovadia et al. RAG на базовой модели обошёл finetuning на вопросах о новых событиях. RAG на дообученной модели помог лишь в 43% случаев по сравнению с RAG на базовой.
- RAG и finetuning можно совмещать. Но выгода не гарантирована.
Порядок работы из книги:
- Настройте prompt и оценку качества. Версионируйте prompt.
- Добавьте примеры в prompt (от 1 до 50).
- Если не хватает информации, подключите RAG. Начните с простого поиска.
- Если ошибки информационные, усложните RAG (поиск по embeddings). Если поведенческие, делайте finetuning.
- Совмещайте RAG и finetuning.
Оценка нужна на каждом шаге, не только в начале.
Память: главный bottleneck
Заголовок раздела «Память: главный bottleneck»Finetuning требует намного больше памяти, чем inference. Причина в обучении.
Backpropagation и trainable parameters
Заголовок раздела «Backpropagation и trainable parameters»Каждый шаг обучения имеет два прохода:
- Forward pass: модель считает ответ.
- Backward pass: модель считает ошибку (
loss), затемgradientдля каждого параметра, затем оптимизатор меняет веса.
Inference использует только forward pass. Обучение использует оба.
Trainable parameter — параметр, который обновляется. Остальные заморожены (frozen). Для каждого trainable параметра нужно хранить gradient и состояние оптимизатора. У Adam это два значения. Всего три лишних значения на параметр.
Простая арифметика памяти
Заголовок раздела «Простая арифметика памяти»N — число параметров, M — байт на параметр.
| Что считаем | Формула | Пример |
|---|---|---|
| Inference | N × M × 1.2 (20% на activations и KV-cache) | 13B, 2 байта: 26 ГБ × 1,2 = 31,2 ГБ |
| Только веса | N × M | 70B, 2 байта: 140 ГБ |
| Обучение | веса + activations + gradients + optimizer states | — |
| Gradients и Adam для всех параметров | N × 3 × M | 13B: 78 ГБ |
| То же для 1B trainable | 1B × 3 × 2 | 6 ГБ |
Полный finetuning модели на 7B в 16 bit: 14 ГБ веса и 42 ГБ gradients и Adam. Итого 56 ГБ, и это без activations. Обычная GPU имеет 12-24 ГБ. Activations могут занять больше памяти, чем веса. Их можно не хранить, а пересчитывать (gradient checkpointing). Память падает, время растёт.
Числовые форматы
Заголовок раздела «Числовые форматы»| Формат | Размер | Заметка |
|---|---|---|
| FP32 | 4 байта | Стандартная точность |
| FP16 | 2 байта | Точнее, но диапазон меньше |
| BF16 | 2 байта | Больше диапазон, меньше точность |
| INT8, INT4 | 1 и 0,5 байта | Целые числа, для inference |
Формат делит биты на диапазон (range) и точность (precision). Загружайте модель в том формате, в котором её обучили. Пример: Llama 2 вышла в BF16. Многие загрузили её в FP16 и получили качество хуже заявленного.
Quantization
Заголовок раздела «Quantization»Меньше бит на значение: меньше память, часто выше скорость. Строго говоря, quantization — это перевод в целые числа. На практике так называют любое снижение точности.
- Чаще всего квантуют веса. Они стабильнее влияют на качество, чем activations.
PTQ(post-training quantization) делают после обучения. Это самый частый вариант. Он доступен в PyTorch и Hugging Face в несколько строк.QAT(quantization-aware training) учит модель работать при низкой точности. Время обучения не падает.- Для inference используют 16, 8 и даже 4 бита. Обучать в низкой точности труднее, поэтому используют
mixed precision: часть значений в высокой точности, часть в низкой. - Минус: ошибки округления накапливаются. Значение вне диапазона формата становится бесконечностью.
Техники finetuning
Заголовок раздела «Техники finetuning»PEFT: меньше trainable параметров
Заголовок раздела «PEFT: меньше trainable параметров»Full finetuning обновляет все параметры. Для больших моделей это почти недоступно. Partial finetuning (заморозить большинство слоёв) экономит память, но неэффективен: для хорошего качества нужно много параметров. В примере книги для BERT large обновляли около 25% параметров.
PEFT (parameter-efficient finetuning) добавляет в модель небольшие обучаемые части. Основная идея Houlsby et al.: вставить адаптеры в каждый блок и учить только их. Они получили качество в пределах 0,4% от полного finetuning при 3% trainable параметров. Минус адаптеров: они добавляют слои, и inference замедляется.
Два семейства PEFT:
| Семейство | Идея |
|---|---|
| Adapter-based (аддитивные) | Добавить модули к весам. Пример: LoRA |
| Soft prompt-based | Добавить обучаемые токены-векторы к входу. Люди их не читают. Примеры: prefix-tuning, prompt tuning |
PEFT экономит и данные: часто хватает нескольких тысяч примеров. По активности вопросов в репозитории huggingface/peft LoRA сильно впереди.
LoRA (low-rank adaptation) заменяет обновление большой матрицы весов W на две маленькие матрицы A и B. Их произведение имеет тот же размер, что W.
- Во время обучения меняются только
AиB. МатрицаWзаморожена. - Размер задаёт rank
r. Обычно хватаетrот 4 до 64. Большийrне всегда лучше. - После обучения
A × Bприбавляют кW. Новых слоёв нет, значит нет лишней latency. - Для GPT-3 LoRA дала качество не хуже полного finetuning при около 4,7 млн trainable параметров. Это 0,0027% от модели.
- Чаще LoRA применяют к матрицам attention (
Wq,Wk,Wv,Wo). Если бюджет мал, лучше братьWqиWv. LoRA и на feed-forward слоях тоже полезна. - Есть гиперпараметр
α. Он регулирует вкладA × B. Подбирают опытом вместе сr.
Почему это работает: у больших моделей низкая intrinsic dimension. Хорошо обученной модели нужно очень мало параметров, чтобы сменить поведение.
Минусы: качество обычно чуть ниже полного finetuning. Нужен фреймворк, который поддерживает вашу модель (PEFT, Axolotl, unsloth, LitGPT).
Multi-LoRA serving. Адаптеры можно не вливать в модель, а хранить отдельно. Тогда одну базовую модель делят много адаптеров. Пример из книги: 100 клиентов, матрица 4096 × 4096, r = 8. Отдельные полные модели: 16,8M × 100 = 1,68B параметров. Одна W и 100 адаптеров: около 23,3M. Минус: небольшая задержка. Плюс: быстрое переключение между клиентами.
QLoRA хранит веса базовой модели в 4 bit (формат NF4). Перед вычислением веса переводят в BF16. Есть также paged optimizers: данные уходят между CPU и GPU, когда не хватает памяти. Так модель на 65B дообучают на одной GPU 48 ГБ.
Минус: quantization и dequantization стоят времени. Обучение идёт медленнее.
Model merging и multi-task finetuning
Заголовок раздела «Model merging и multi-task finetuning»Merging объединяет несколько моделей в одну. Часто это модели, дообученные под разные задачи. Без дообучения merging не требует GPU.
Зачем:
- Multi-task: вместо одной модели на все задачи, учат отдельно и склеивают. Одновременный finetuning требует больше данных. Последовательный даёт
catastrophic forgetting: модель забывает старую задачу. - Меньше памяти для on-device.
- Federated learning: копии модели учатся на устройствах отдельно, потом сливаются.
Три подхода:
| Подход | Что делает | Заметка |
|---|---|---|
| Summing | Складывает веса: средневзвешенное, SLERP | Лучше для моделей с одной базой. Можно чистить лишние параметры (TIES, DARE) |
| Layer stacking | Берёт слои из разных моделей. “Frankenmerging” | Обычно нужен ещё finetuning. Применяют для MoE и для upscaling (пример: SOLAR 10.7B из модели на 7B) |
| Concatenation | Склеивает параметры, rank растёт до r1 + r2 | Не экономит память. Не рекомендуют |
Task vector — разница между дообученной и базовой моделью. Их можно складывать и вычитать. Вычитание убирает нежелательное поведение.
Merging — не то же самое, что ensembling. Ensemble запускает несколько моделей и объединяет ответы. Это дороже на inference.
Тактика finetuning
Заголовок раздела «Тактика finetuning»- Базовая модель. Сначала возьмите самую сильную, какую можете себе позволить. Дешёвые проверяйте потом.
- Путь progression: проверьте код на дешёвой модели, данные на средней, потом лучшая, потом сравните цену и качество.
- Путь distillation: лучшая модель плюс малый датасет, затем генерация данных, затем обучение дешёвой модели.
- Метод. Начните с LoRA, позже пробуйте full finetuning. На сотнях примеров full finetuning не лучше LoRA.
- Способ. Проще всего finetuning API провайдера. Но вы ограничены его моделями и настройками. Альтернатива: фреймворки (LLaMA-Factory, unsloth, PEFT, Axolotl, LitGPT). Для нескольких машин нужен DeepSpeed или PyTorch Distributed.
Ключевые гиперпараметры:
| Параметр | Что делает | Совет |
|---|---|---|
| Learning rate | Размер шага обучения | Обычно от 1e-7 до 1e-3. Если loss прыгает, шаг велик. Если падает очень медленно, мал |
| Batch size | Примеры за один шаг | Меньше 8 даёт нестабильность. Мало памяти: gradient accumulation |
| Epochs | Проходы по данным | Миллионы примеров: 1-2. Тысячи: 4-10. Train loss падает, а validation loss растёт: overfitting |
| Prompt loss weight | Вклад prompt в loss | Обычно 10%. Модель учится в основном на ответах |
Что изменилось к 2026 году
Заголовок раздела «Что изменилось к 2026 году»Книга написана в 2024 году. Вот что важно знать сейчас. Это наше дополнение, его нет в книге.
- Finetuning нужен ещё реже. Модели стали сильнее, контекст длиннее. Порядок «prompt → RAG → finetuning» остаётся верным.
- Reinforcement fine-tuning (RFT). Провайдеры дают дообучать модель через RL с grader: вы задаёте функцию проверки, а не готовые ответы. Это развитие RLVR из главы 2.
- Distillation из reasoning моделей. Малые модели учат на цепочках рассуждений больших (так сделаны малые версии DeepSeek-R1).
- LoRA и QLoRA остаются главными техниками. Советы главы про память и PEFT актуальны.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Finetuning | Дообучение модели: меняются веса |
| Transfer learning | Перенос знаний из одной задачи в другую |
| SFT | Supervised finetuning на парах (инструкция, ответ) |
| Preference finetuning | Дообучение на сравнениях ответов |
| Distillation | Малая модель учится на ответах большой |
| Quantization | Хранение значений в меньшем числе бит |
| PTQ / QAT | Quantization после обучения / во время обучения |
| PEFT | Finetuning с малым числом trainable параметров |
| LoRA | Адаптер из двух маленьких матриц A и B |
| QLoRA | LoRA на модели с весами в 4 bit |
| Model merging | Объединение нескольких моделей в одну |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с оценки, не с обучения. Нужен eval-набор и метрики до finetuning. Без них вы не поймёте, стало ли лучше. Храните набор в хранилище с версиями.
- Данные для finetuning — ваша работа. Пары (запрос, ответ) собирают из логов, тикетов, SQL-запросов. Их нужно чистить, дедуплицировать и версионировать. Это обычный data pipeline. Подробнее в главе 8.
- Не отправляйте приватные данные наружу без проверки. Finetuning API провайдера получает ваши данные. Проверьте политику, маскируйте PII.
- Для знаний делайте RAG. Документация, каталог данных, описания dbt-моделей — это факты. Их место в индексе, который обновляется в пайплайне, а не в весах.
- Для формата делайте finetuning. Пример: модель должна выдавать SQL в диалекте вашего хранилища или JSON по строгой схеме. Это поведенческая задача. Сначала проверьте structured output и хороший prompt.
- Считайте стоимость целиком. GPU-часы, разметка, хостинг, мониторинг, повторное обучение при выходе новой базовой модели. Прикиньте память по формулам выше до заказа железа.
- Версионируйте артефакты и проверяйте регрессии. Датасет, базовая модель, адаптер, гиперпараметры, метрики. После finetuning прогоните общий eval: модель могла ухудшиться на соседних задачах.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие ошибки модели лечит finetuning, а какие RAG? Приведите по одному примеру из задач с данными.
- Из чего складывается память при обучении модели? Почему она сильно больше, чем при inference?
- Как LoRA экономит память и почему она не добавляет latency? Что даёт QLoRA сверх этого?
- Зачем делать model merging и чем он отличается от ensembling?
Предыдущая: RAG и агенты. Следующая: Dataset engineering.