

Fundamentals of Data Engineering, глава 3: Хорошая архитектура данных
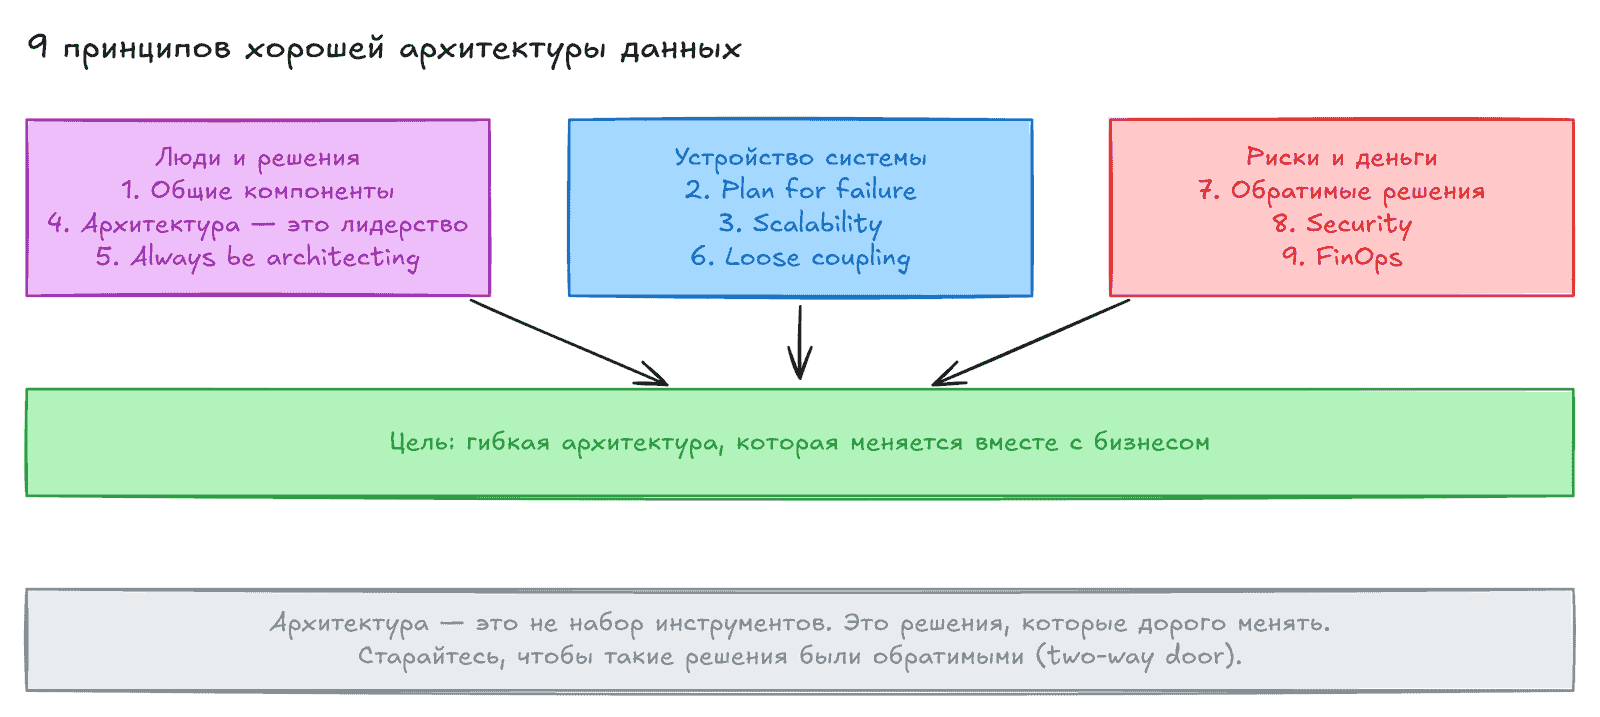
Главная мысль: хорошая архитектура данных помогает меняться. Она строится на гибких и обратимых решениях и на честной оценке компромиссов. Идеальной архитектуры нет. Есть наименее плохая для вашей задачи.
Что такое data architecture
Заголовок раздела «Что такое data architecture»- Enterprise architecture — проектирование систем, которые поддерживают изменения в компании.
- Data architecture — часть enterprise architecture. Это проектирование систем под меняющиеся потребности в данных.
- Авторы связывают оба определения с тремя идеями: гибкие и обратимые решения, управление изменениями, оценка компромиссов.
- Решение типа one-way door почти нельзя отменить. Решение типа two-way door можно вернуть назад. Чем больше решений вида two-way, тем быстрее команда учится.
- Большие изменения лучше делить на малые шаги. Каждый шаг тоже должен быть обратимым.
- Технические решения нужны для бизнеса, а не сами по себе.
Есть два вида архитектуры:
| Вид | О чём |
|---|---|
| Operational | Что нужно сделать: бизнес-процессы, качество данных, требования к задержке |
| Technical | Как это сделать: приём, хранение, трансформация, выдача |
Что значит «хорошая» архитектура
Заголовок раздела «Что значит «хорошая» архитектура»- Она обслуживает требования бизнеса из общего набора повторно используемых блоков.
- Она гибкая и легко поддерживается.
- Плохая архитектура: сильно связанная (tightly coupled), жёсткая, слишком централизованная или собранная из неподходящих инструментов.
- Основа для любой зрелости данных — undercurrents жизненного цикла: безопасность, data management, DataOps, архитектура, orchestration, software engineering. Подробнее в главе 2.
Девять принципов
Заголовок раздела «Девять принципов»| # | Принцип | Суть |
|---|---|---|
| 1 | Choose common components wisely | Общие компоненты (object storage, git, orchestration, мониторинг) связывают команды. Не навязывайте один инструмент всем |
| 2 | Plan for failure | Всё ломается. Заранее определите availability, reliability, RTO и RPO |
| 3 | Architect for scalability | Система растёт и уменьшается (elasticity). Лучше всего, если может scale to zero. Не усложняйте без нужды |
| 4 | Architecture is leadership | Архитектор обучает и ведёт команду. Он не командует и не становится узким местом |
| 5 | Always be architecting | Целевая архитектура меняется. Нужен план последовательности изменений |
| 6 | Build loosely coupled systems | Команды общаются через API и схемы сообщений, а не через чужие базы |
| 7 | Make reversible decisions | Выбирайте лучшее на сегодня и будьте готовы заменить |
| 8 | Prioritize security | Zero-trust вместо жёсткого периметра. Shared responsibility model. Каждый data engineer отвечает за безопасность |
| 9 | Embrace FinOps | Расходы в облаке динамические. Их нужно мониторить и ограничивать |
Пояснения к принципам:
- RTO (recovery time objective) — максимальное допустимое время простоя.
- RPO (recovery point objective) — максимальная допустимая потеря данных.
- Shared responsibility: облако отвечает за безопасность самого облака. Вы отвечаете за безопасность своих данных и настроек. Публичные S3 bucket — частая причина утечек.
- FinOps: в облаке платят по использованию. Нужны оповещения о всплесках расходов и лимиты. Одна из угроз — cost attack, например массовая загрузка данных из публичного bucket.
Основные концепции архитектуры
Заголовок раздела «Основные концепции архитектуры»Domain и service. Domain — область реального мира, например sales. Service — набор функций для задачи, например обработка заказов. Один domain содержит несколько services. Определяйте domain, разговаривая с пользователями.
Распределённые системы. Четыре свойства связаны между собой:
| Свойство | Значение |
|---|---|
| Scalability | Можно увеличить мощность |
| Elasticity | Система сама растёт и уменьшается |
| Availability | Доля времени, когда сервис работает |
| Reliability | Вероятность, что система работает по стандарту |
Один сервер можно усилить (vertical scaling), но предел есть. Несколько серверов (horizontal scaling) дают рост и отказоустойчивость. Обычно есть leader node и worker nodes.
Tight и loose coupling.
| Уровень | Описание |
|---|---|
| Single tier | База и приложение на одном сервере. Подходит для прототипа. Не для production. Нельзя запускать аналитику на продуктовой базе |
| Multitier | Слои разделены: данные, логика, представление. Чаще всего three-tier |
| Monolith | Всё вместе. Простота, но сложно менять и заменять части. Риск big ball of mud |
| Microservices | Мелкие независимые сервисы. Сбой одного не ломает другие |
Совет авторов: монолит не всегда плохой. Можно начать с него, но будьте готовы разбить. Используйте loose coupling как идеал, с учётом ограничений ваших технологий.
Multitenancy. Нужно решить, делят ли системы разные команды и клиенты. Два риска: noisy neighbor (один арендатор замедляет других) и утечка данных между арендаторами. Изоляцию через views нужно проверять.
Event-driven architecture. Событие — это изменение состояния. Процесс: event production, routing, consumption. Производитель, роутер и потребитель не зависят друг от друга. Хорошо подходит для loosely coupled сервисов.
Brownfield и greenfield.
| Тип | Что делать |
|---|---|
| Brownfield | Есть старая система. Сначала поймите, почему она такая. Избегайте big-bang переписывания. Используйте strangler pattern: новые части постепенно заменяют старые |
| Greenfield | Чистый лист. Не поддавайтесь shiny object syndrome и resume-driven development. Требования важнее модных инструментов |
Типы и примеры архитектуры данных
Заголовок раздела «Типы и примеры архитектуры данных»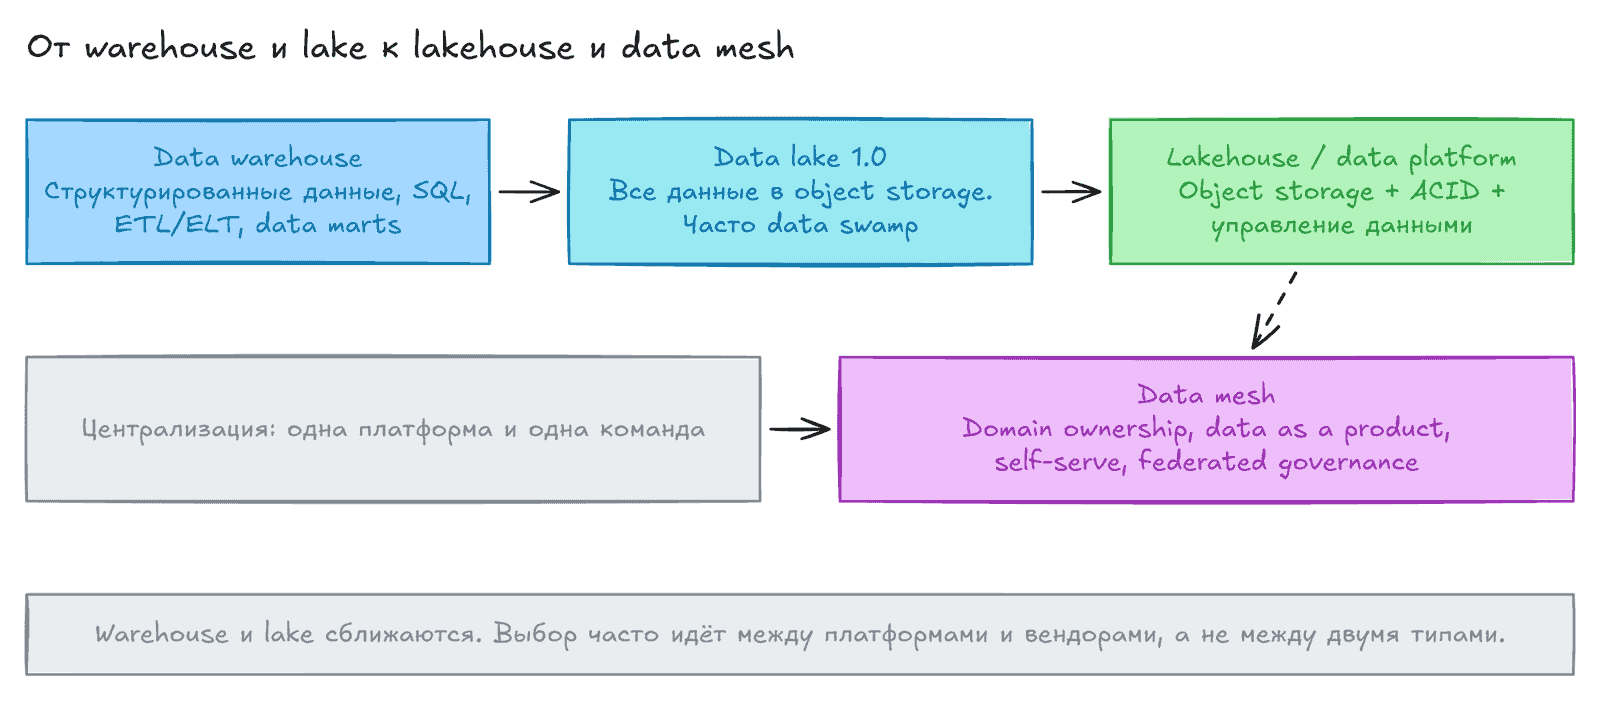
Data warehouse
Заголовок раздела «Data warehouse»Центральное хранилище для отчётов и аналитики. Данные структурированы. Определение Inmon: subject-oriented, integrated, nonvolatile, time-variant.
- Отделяет OLAP от продуктовых OLTP баз.
- Классически данные грузят через ETL. Вариант ELT: сырые данные идут в staging внутри хранилища, а трансформации выполняются там же.
- Технически это MPP-системы (massively parallel processing), чаще колоночные.
- Cloud data warehouse (Redshift, BigQuery, Snowflake) разделил compute и storage. Это дало гибкость и pay-as-you-go.
- Data mart — подмножество хранилища для отдела или процесса. Удобен аналитикам и ускоряет сложные запросы.
Data lake
Заголовок раздела «Data lake»Идея: сложить все данные в одно место без жёсткой схемы.
- Data lake 1.0 начался с HDFS, потом перешёл в object storage.
- Проблемы: data swamp, нет каталога и схем, трудно удалять и обновлять (например, по GDPR), MapReduce сложен, расходы выросли.
- Крупные tech-компании получили пользу. Остальным озёра часто принесли разочарование.
Lakehouse и data platform
Заголовок раздела «Lakehouse и data platform»- Lakehouse (термин Databricks): данные в object storage, но с ACID-транзакциями и управлением как в хранилище.
- Cloud data warehouse и data lake становятся похожими. Будущий выбор — converged data platform: вендор, экосистема, открытость.
Modern data stack
Заголовок раздела «Modern data stack»Облачные, модульные компоненты по принципу plug-and-play: pipelines, хранилище, transformation, governance, мониторинг, BI. Цели: self-service, простота, понятные цены, активное сообщество.
Lambda, Kappa и unified batch/streaming
Заголовок раздела «Lambda, Kappa и unified batch/streaming»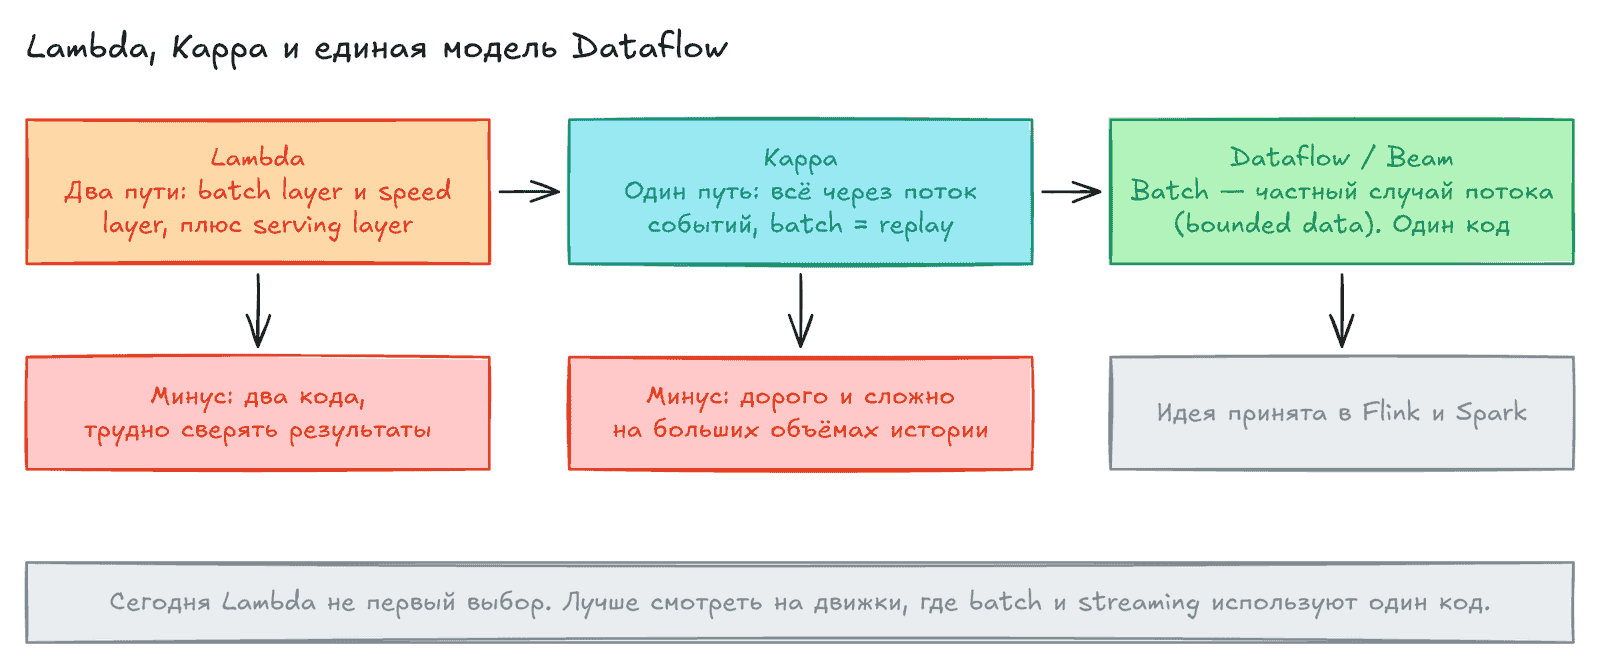
| Архитектура | Идея | Проблема |
|---|---|---|
| Lambda | Источник идёт в batch layer и speed layer. Serving layer объединяет результаты | Два разных кода, трудно сверять данные |
| Kappa | Единая платформа потоков для приёма, хранения и выдачи. Batch — это replay | Сложно и дорого на больших историях. Мало применяется |
| Dataflow / Beam | Все данные — события. Batch — ограниченный (bounded) поток | Идея принята в Flink и Spark. Современный подход |
Авторы не рекомендуют Lambda первым выбором.
Architecture for IoT
Заголовок раздела «Architecture for IoT»- Компоненты: devices, IoT gateway, ingestion, storage, serving.
- Нужно учитывать: поздние данные, разные схемы, повреждения, обрывы связи.
- Для near real-time подходят message queue и time-series database. Для научных данных хватит batch и object storage.
- Часть IoT-данных возвращается на устройства. Это похоже на reverse ETL.
Data mesh
Заголовок раздела «Data mesh»Ответ на разросшиеся централизованные платформы. Основан на domain-driven design. Четыре компонента:
- domain-oriented ownership;
- data as a product;
- self-serve data infrastructure;
- federated computational governance.
Другие примеры
Заголовок раздела «Другие примеры»Data fabric, data hub, metadata-first, live data stack. Следите за новыми подходами, но не привязывайтесь эмоционально к одному.
Кто проектирует архитектуру
Заголовок раздела «Кто проектирует архитектуру»- Архитектор должен быть близок к технологиям. «Ivory tower» архитектура уходит.
- В малых компаниях data engineer часто совмещает роль архитектора.
- Выбирая архитектуру, работайте вместе с бизнесом и оценивайте компромиссы.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Two-way door | Решение, которое легко отменить |
| Loose coupling | Слабая связь: части меняются независимо |
| RTO / RPO | Допустимое время простоя / допустимая потеря данных |
| Elasticity | Автоматическое увеличение и уменьшение ресурсов |
| Zero trust | Никому не доверять по умолчанию, даже внутри сети |
| Strangler pattern | Постепенная замена старой системы по частям |
| MPP | Параллельная обработка запросов на многих узлах |
| Data lakehouse | Озеро данных с ACID и управлением как у хранилища |
| Lambda / Kappa | Архитектуры для объединения batch и streaming |
| Data mesh | Децентрализованное владение данными по доменам |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Записывайте решения и помечайте, какие из них one-way. Для таких решений нужна особая осторожность.
- Для каждой системы задайте RTO, RPO и целевую availability. Не копируйте чужие значения.
- Не запускайте аналитические запросы на продуктовой базе. Выносите данные в отдельное хранилище.
- Начинайте с простого монолита, если нужна скорость. Но заранее продумайте, как его разделить.
- Перед любым публичным доступом проверьте права на bucket. Настройте оповещения о расходах.
- Для старых систем используйте strangler pattern, а не большой переезд за один раз.
- Не выбирайте Lambda, Kappa или data mesh из-за моды. Сначала сформулируйте бизнес-требования.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем one-way door отличается от two-way door? Почему книга советует выбирать вторые?
- Какие проблемы были у data lake 1.0 и как lakehouse их решает?
- Почему Lambda architecture критикуют и какую идею предлагает Dataflow?
- Когда стоит применять strangler pattern, а когда подойдёт greenfield?
Предыдущая: Жизненный цикл. Следующая: Выбор технологий.