

Fundamentals of Data Engineering, глава 6: Хранение
Главная мысль: Хранение лежит в основе всех стадий lifecycle. Выбор хранилища зависит от того, как данные будут читать и обновлять, и от цены. Нужно знать три уровня: физические компоненты, системы хранения и абстракции над ними.
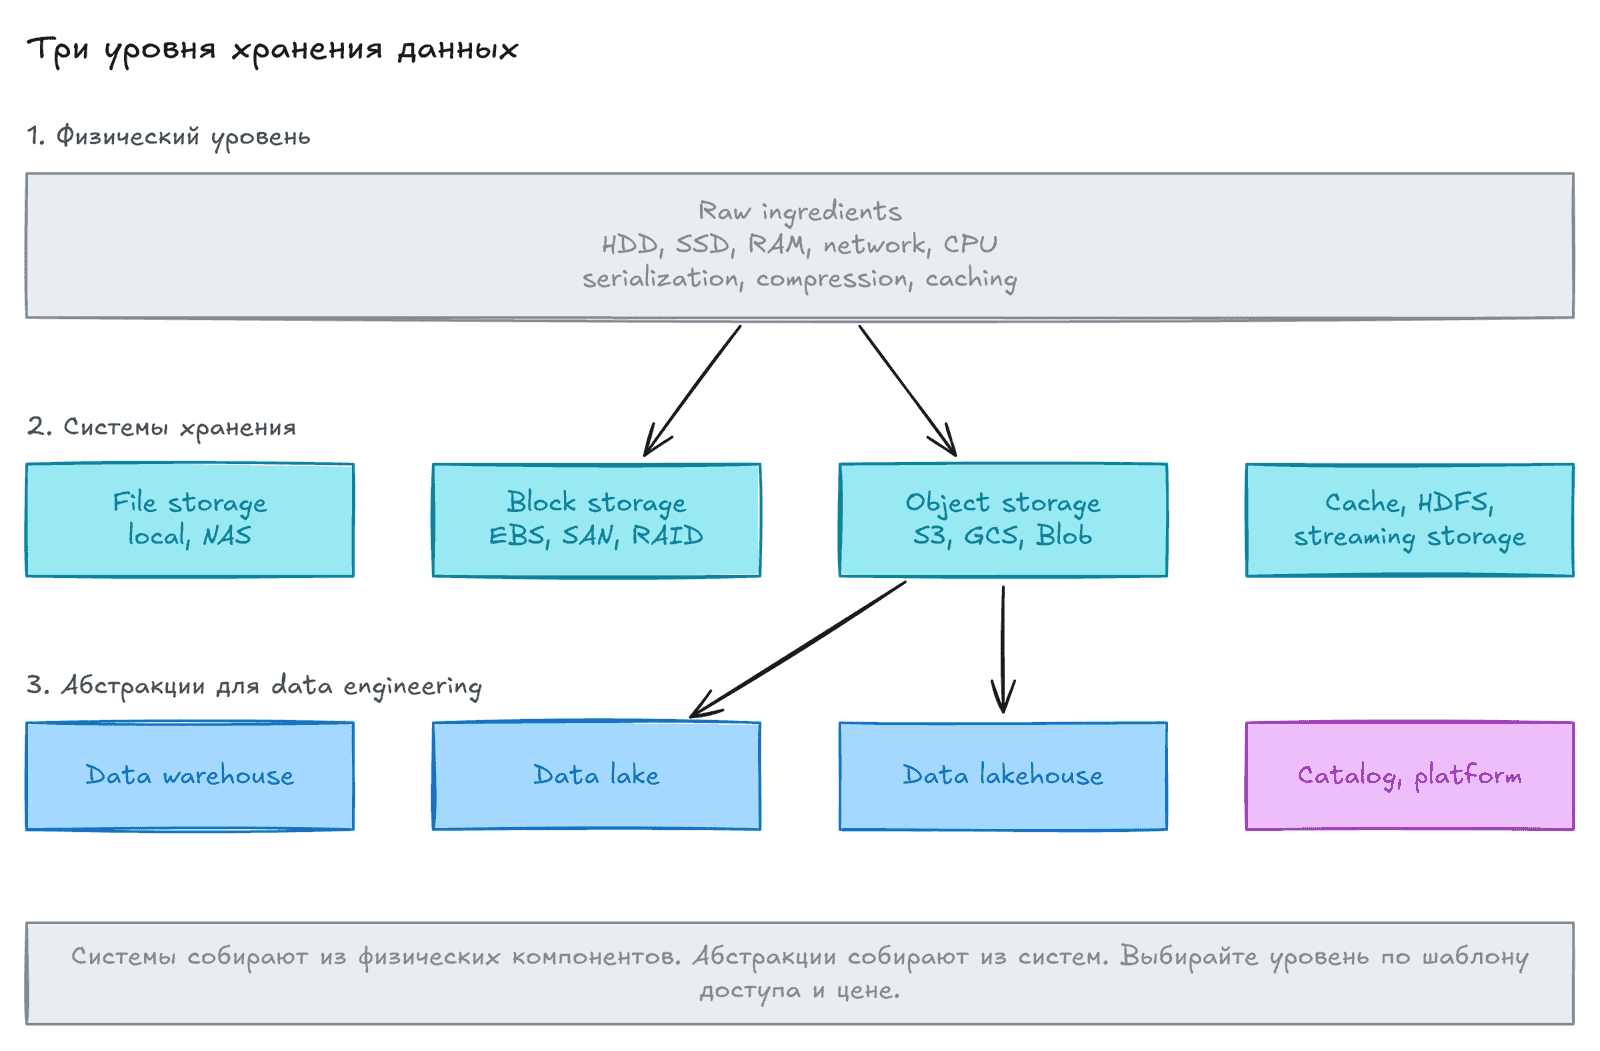
Raw ingredients: из чего состоит хранение
Заголовок раздела «Raw ingredients: из чего состоит хранение»| Компонент | Свойства |
|---|---|
| HDD (магнитный диск) | Дешёвый, около 3 центов за GB. Скорость 200-300 MB/s, задержка выше 4 мс, 50-500 IOPS. Скорость растёт медленнее ёмкости |
| SSD | Поиск быстрее 0,1 мс, десятки тысяч IOPS. Около 20-30 центов за GB, примерно в 10 раз дороже HDD. Стандарт для OLTP |
| RAM | Задержка порядка 100 нс, до 100 GB/s. Около 10 долларов за GB. Данные теряются без питания |
| Network и CPU | Распределённое хранилище параллельно читает много дисков. Скорость часто ограничена сетью, а не диском |
Ещё три ингредиента:
- Serialization — упаковка данных в формат для диска или сети. Row-based базы хранят строки для быстрых lookups. Columnar базы хранят колонки для сжатия и быстрого scan. Подробнее в приложении A.
- Compression — меньше места, выше эффективная скорость scan и сети. При сжатии 10:1 диск с 200 MB/s читает как 2 GB/s. Цена: время CPU на сжатие и распаковку.
- Caching — быстрый слой для частых данных. Чем быстрее кэш, тем он дороже и меньше.
Иерархия по скорости: CPU cache, RAM, SSD, HDD, object storage, archival. Archival можно считать reverse cache: доступ хуже, цена ниже. Его используют для backup и compliance.
Availability zone — изолированная зона облака со своим питанием. Хранение в нескольких зонах повышает availability и durability.
Системы хранения
Заголовок раздела «Системы хранения»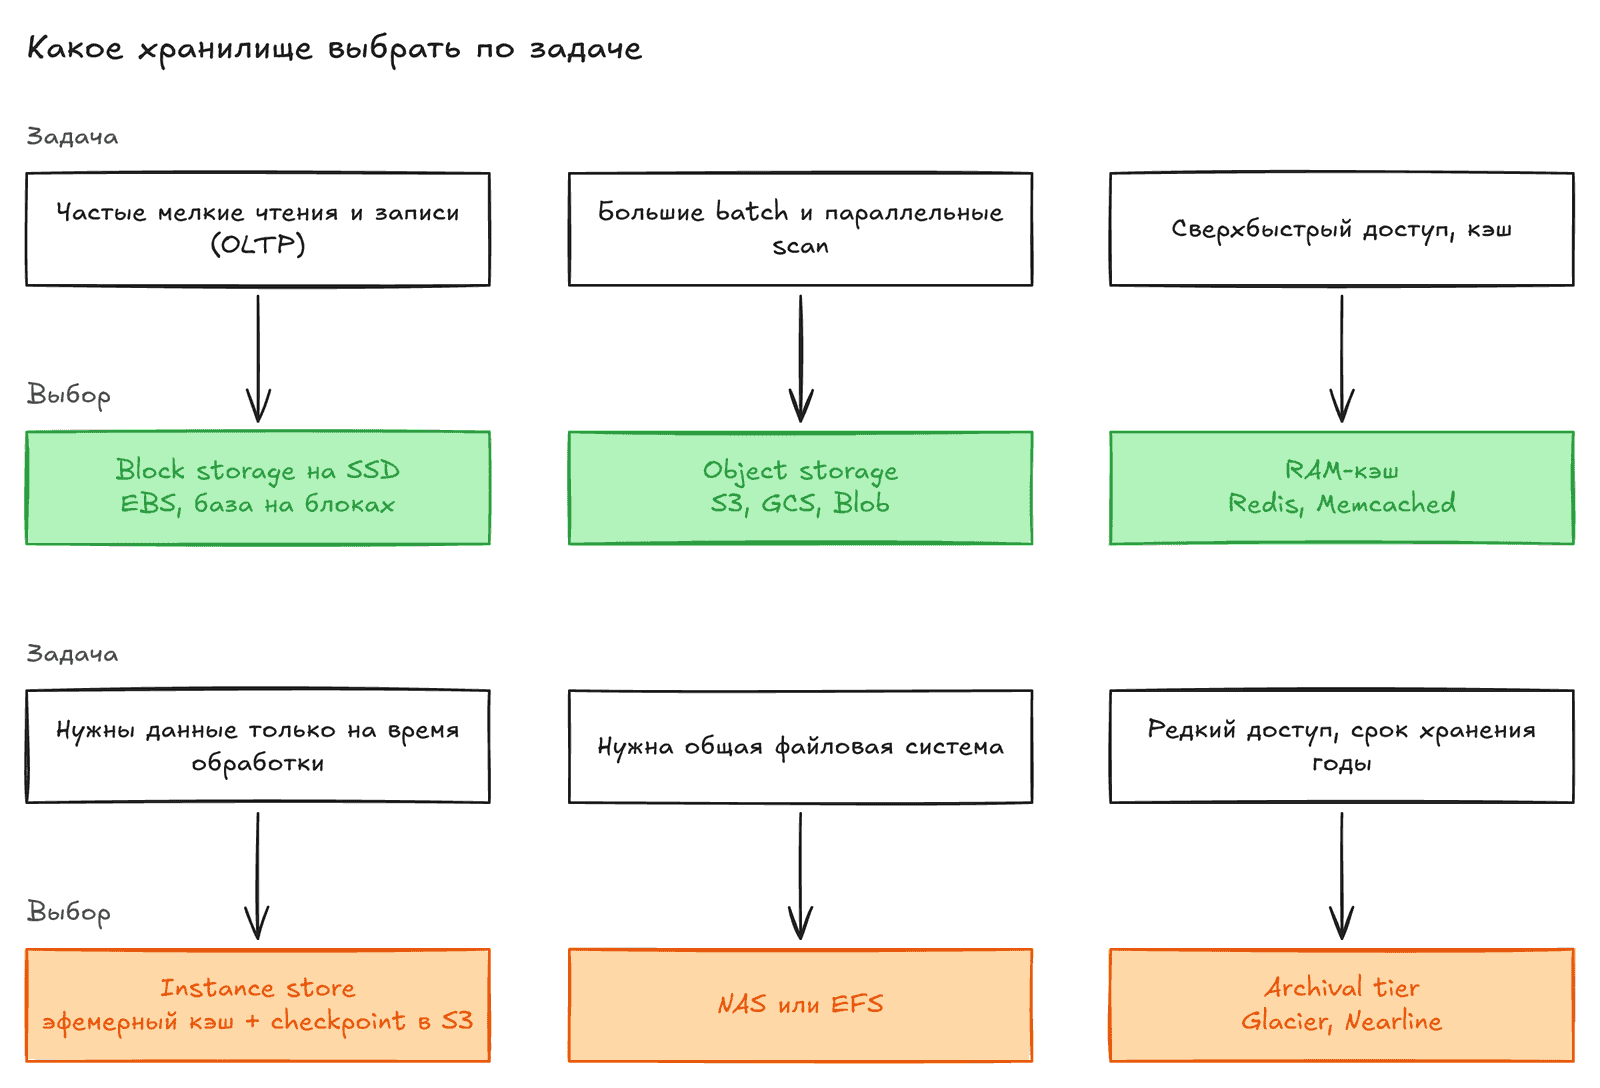
Одна машина и distributed storage
Заголовок раздела «Одна машина и distributed storage»Distributed storage координирует много серверов. Это даёт масштаб и redundancy. На нём построены object storage, Spark и cloud data warehouses.
Eventual и strong consistency
Заголовок раздела «Eventual и strong consistency»- BASE (basically available, soft-state, eventual consistency) — противоположность ACID.
- Eventual consistency: чтение в какой-то момент вернёт актуальные данные. Это цена горизонтального масштаба.
- Strong consistency: запись сначала согласуется между узлами. Чтение всегда верное, но задержка выше.
- Уровень consistency задаётся базой, её настройками и иногда отдельным запросом. Пример: DynamoDB даёт eventually и strongly consistent reads.
File storage
Заголовок раздела «File storage»Файл имеет конечную длину, допускает append и random access. Файлы лежат в дереве каталогов.
| Вариант | Суть |
|---|---|
| Local disk | Файловая система ОС (NTFS, ext4) |
| NAS (network-attached storage) | Файловая система по сети. Узнайте модель consistency при нескольких клиентах |
| Cloud filesystem | Управляемый NAS, например Amazon EFS |
В pipeline избегайте состояния на диске. Для промежуточных данных используйте object storage. Ручную работу с файлами оставьте для разовой загрузки и экспериментов.
Block storage
Заголовок раздела «Block storage»Block — наименьшая адресуемая единица диска (сейчас обычно 4096 байт). OLTP-базы работают с блоками напрямую. Также это диск для загрузки ОС в облачных VM.
- RAID — объединение дисков для durability и скорости.
- SAN (storage area network) — виртуальные блочные устройства по сети.
- Amazon EBS — облачный блочный диск. Данные реплицируются минимум на два хоста. Живёт отдельно от VM. Есть мгновенные snapshots. Не переживает отказ целой зоны.
- Instance store — диск на хосте VM. Быстрый и дешёвый. Нет репликации и snapshots. Данные пропадают при остановке VM. Подходит для временного кэша, например в эфемерном кластере EMR. Продумайте худший сценарий и делайте checkpoint в S3.
Object storage
Заголовок раздела «Object storage»Основа data lake и cloud data warehouse: Amazon S3, Azure Blob Storage, Google Cloud Storage.
- Это key-value хранилище неизменяемых объектов. Нет append и random writes. Чтобы изменить объект, его перезаписывают целиком.
- Объекты лежат в bucket и адресуются по key. Каталогов нет. Путь с
/— это просто префикс ключа. Операции по префиксу на миллионах объектов бывают медленными. - Отлично для больших batch чтений и записей и параллельных scan. Плохо для множества мелких обновлений в секунду. Для этого берут OLTP или block storage.
- Данные хранятся в нескольких зонах. Ёмкость практически не ограничена, предел — бюджет.
- Объектное хранилище позволяет отделить compute от storage и использовать эфемерные кластеры.
Consistency и versioning. Раньше S3 был eventually consistent. Строгость можно добавить внешней базой с метаданными версий. Versioning хранит старые версии под ключом. Пара key + version всегда указывает на один неизменяемый объект. Минус: старые версии стоят как полные копии. Используйте lifecycle policies для удаления и переноса.
Storage classes. Дешевле хранение даёт более дорогой доступ:
| Класс (пример S3) | Особенность |
|---|---|
| Standard | Базовый |
| Infrequent Access | Дешевле хранение, дороже чтение |
| One Zone-IA | Одна зона. Данные теряются, если зона уничтожена |
| Glacier Deep Archive | Около 1 доллара за TB в месяц. Восстановление около 12 часов |
Помните: в архив зайти просто, а достать данные дорого, если нужно чаще, чем ожидалось.
Инструменты вроде s3fs и S3 File Gateway монтируют bucket как диск. Подходят для редко меняемых файлов, не для частых транзакционных записей.
Cache и memory-based
Заголовок раздела «Cache и memory-based»- Memcached — key-value кэш с простыми типами.
- Redis — более сложные типы и persistence (snapshots, journaling). Пишет на диск примерно раз в две секунды, поэтому возможна небольшая потеря.
RAM-системы нужны для кэша. Долговременные данные храните на устойчивом носителе.
Hadoop Distributed File System делит файлы на блоки и хранит по три копии. NameNode знает, где лежат блоки. В отличие от object storage, HDFS совмещает compute и storage на тех же узлах. Hadoop уже не новая технология, но HDFS жив в legacy и внутри EMR и Spark. Небольшой компании кластер Hadoop обычно невыгоден.
Streaming storage
Заголовок раздела «Streaming storage»Kafka, Kinesis, Pulsar и Pub/Sub могут хранить данные очень долго (Kafka переносит старое в object storage). Replay возвращает исторический диапазон. Это основной способ чтения из streaming storage. Он нужен для batch запросов и для повторной обработки.
Indexes, partitioning, clustering
Заголовок раздела «Indexes, partitioning, clustering»- Index даёт быстрый поиск отдельных записей. Без него нужен full scan.
- Аналитика ушла от индексов к columnar storage. Он читает только нужные колонки и хорошо сжимает. Плох для частых lookup строк.
- Раньше советовали денормализацию из-за медленных joins. Сейчас joins в columnar быстрее, и это уже не обязательно.
- Partitioning делит таблицу по полю, чаще по дате. Clustering сортирует данные внутри partitions.
- Snowflake micro-partitions: группы строк 50-500 MB. Метаданные хранят диапазоны значений. Это позволяет пропускать ненужные partitions (pruning). Метаданные работают как индекс.
Абстракции хранения
Заголовок раздела «Абстракции хранения»Что выбирать, зависит от цели, шаблона обновлений (bulk, streaming, upsert), цены и разделения compute и storage.
| Абстракция | Суть |
|---|---|
| Data warehouse | Стандартная OLAP-архитектура. Эволюция: OLTP, row MPP, columnar MPP, cloud DWH. Не хранит настоящие unstructured данные |
| Data lake | Сырые данные в дешёвом хранилище. Сейчас на object storage вместо Hadoop |
| Data lakehouse | Lake в object storage плюс слой метаданных: таблицы, схемы, update, delete, history и rollback. Примеры: Delta Lake, Hudi, Iceberg. Данные в открытом формате, поэтому выше interoperability |
| Data platform | Экосистема инструментов вокруг ядра хранения. Риск vendor lock-in |
| Stream-to-batch | Поток идёт и в real-time обработку, и в batch хранилище. Пример: Kinesis Firehose пишет объекты в S3 |
Границы между DWH и lake стираются. BigQuery и Snowflake по устройству похожи на lakehouse.
Большие идеи
Заголовок раздела «Большие идеи»Data catalog
Заголовок раздела «Data catalog»Централизованное хранилище метаданных организации. Включает lineage, описания и портал поиска. Метаданные обычно собирает автоматический scanning. На практике data engineer подключает системы к catalog и поддерживает его.
- Schema on write: схема задана и проверяется при записи. Так работает классический DWH. Данные проще использовать.
- Schema on read: схема определяется при чтении. Гибко, но потребителю труднее. Лучше использовать форматы со схемой, например Parquet. CSV для этого не рекомендован.
Separation of compute and storage
Заголовок раздела «Separation of compute and storage»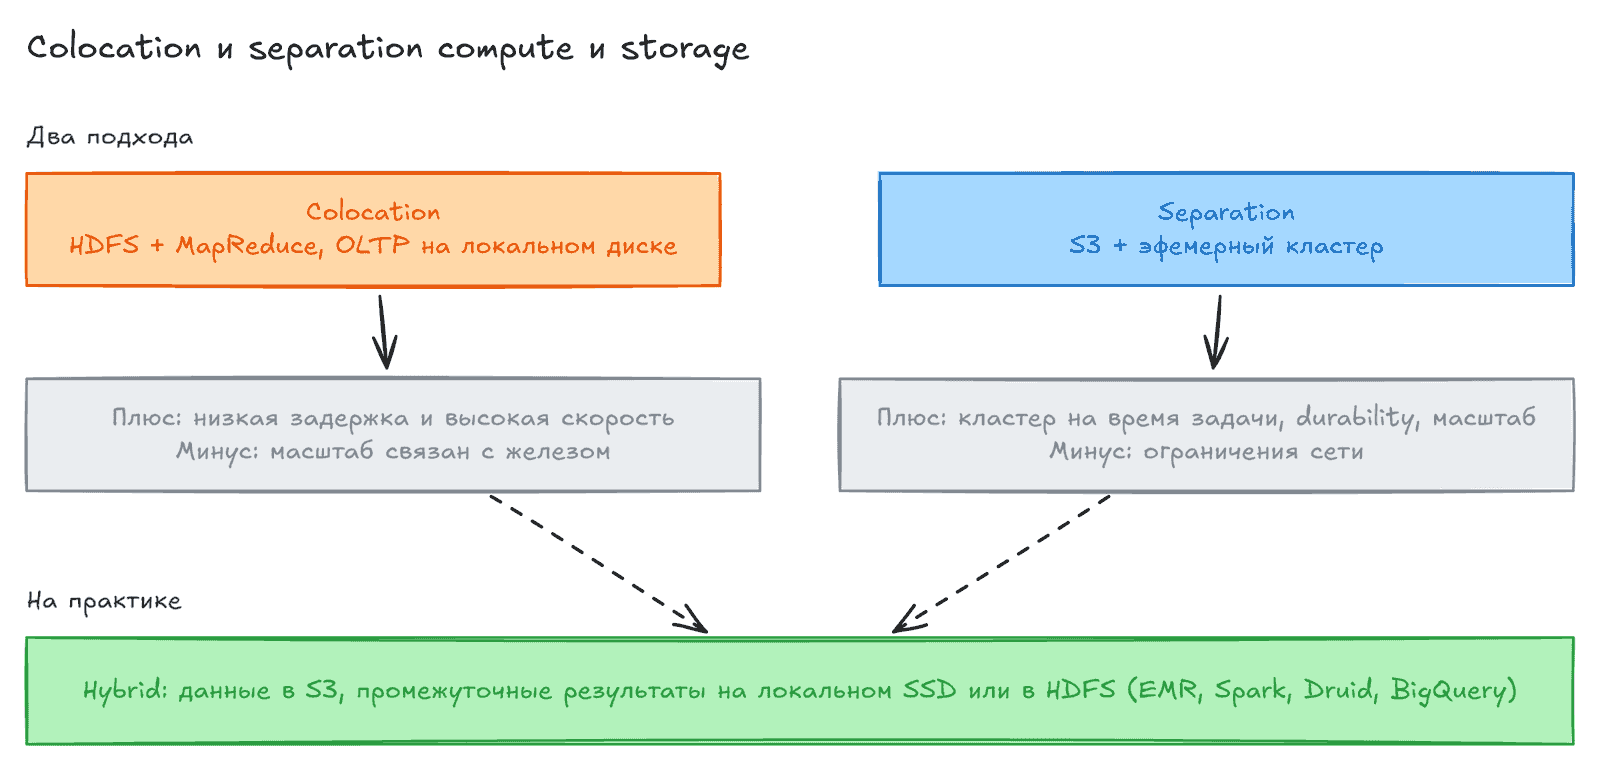
- Colocation даёт скорость: данные рядом с обработкой (HDFS и MapReduce).
- Separation даёт эфемерность, масштаб и durability. Кластер поднимают на время задачи.
- На практике используют hybrid: multitier caching и hybrid object storage.
- Примеры: EMR читает S3 и держит промежуточные данные в HDFS на SSD. Spark держит данные в памяти. Druid хранит одну копию на SSD, а durability даёт object store. BigQuery и S3 Select приближают вычисления к данным.
Zero-copy cloning
Заголовок раздела «Zero-copy cloning»Новая виртуальная копия таблицы без копирования файлов. Создаются новые указатели на те же файлы. Риск: удаление исходных файлов в data lake может сломать клон. Deep copy копирует все файлы. Это дороже, но надёжнее.
Data storage lifecycle и retention
Заголовок раздела «Data storage lifecycle и retention»| Температура | Доступ | Хранилище | Цена |
|---|---|---|---|
| Hot | Часто | SSD, память | Хранение дорогое, чтение дешёвое |
| Warm | Примерно раз в месяц | Infrequent Access, Nearline | Средняя |
| Cold | Редко | Архив, tape | Хранение дешёвое, чтение дорогое |
Автоматизируйте lifecycle policies. Пример: через 180 дней без обращений переносить данные в архив. Учитывайте стоимость и время извлечения. Горячие данные в памяти могут переливаться на диск (spillover).
Retention отвечает на вопрос, что и как долго хранить. Учитывайте:
- Value: можно ли восстановить данные из источника.
- Time: новые данные ценнее. Для кэша задайте TTL (time to live).
- Compliance: HIPAA и PCI требуют хранить. Другие правила требуют удалять вовремя.
- Cost: переносите в cold или удаляйте данные, которые не нужны.
Накопление всех данных ведёт к data swamp и проблемам с регуляторами.
Single-tenant и multitenant
Заголовок раздела «Single-tenant и multitenant»- Single-tenant: у каждого клиента своя база. Полная изоляция. Схемы могут расходиться, и общий вид по клиентам собирать труднее.
- Multitenant: клиенты делят базу, схемы или таблицы.
Партнёры и undercurrents
Заголовок раздела «Партнёры и undercurrents»С вами работают DevOps, security и cloud architects. Заранее разделите зоны ответственности: кто может развернуть инфраструктуру в аккаунте AWS. В зрелых компаниях data engineer отвечает только за часть хранилища.
| Область | Что важно |
|---|---|
| Security | Принцип least privilege. Контроль доступа на уровне колонок, строк и ячеек. Хорошая защита позволяет шире делиться данными |
| Data management | Catalog, lineage, data dictionary. Versioning для восстановления и воспроизводимости ML. Privacy: GDPR, удаление по запросу, masking |
| DataOps | Мониторинг систем, стоимости (FinOps) и доступа. Наблюдение за самими данными: статистика, anomaly detection |
| Architecture | Надёжность и durability по требованиям. Предпочитайте fully managed. Не оптимизируйте преждевременно |
| Orchestration | Хранилище — труба, orchestration — насос |
| Software engineering | Инфраструктура как код. Эфемерный compute. Код должен хорошо работать с хранилищем |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| IOPS | Число операций ввода-вывода в секунду |
| Serialization | Упаковка данных в формат для хранения и передачи |
| Eventual consistency | Данные согласуются через некоторое время |
| Block storage | Сырые блоки диска, основа для OLTP |
| Object storage | Хранилище неизменяемых объектов по ключу |
| Bucket | Верхний контейнер объектов |
| Storage class / tier | Класс хранения с разной ценой хранения и доступа |
| Replay | Повторное чтение исторических событий потока |
| Partitioning / clustering | Разбиение и сортировка таблицы для сокращения scan |
| Data lakehouse | Lake в object storage с таблицами и транзакционными функциями |
| Schema on write / on read | Схема проверяется при записи или определяется при чтении |
| Zero-copy cloning | Копия через указатели без копирования данных |
| Retention / TTL | Срок хранения данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте хранилище по шаблону доступа: lookup по строкам (SSD, OLTP) или большие scan (object storage, columnar).
- Не делайте частые мелкие обновления в object storage. Для этого есть lakehouse-форматы.
- Настройте lifecycle policies и retention. Проверьте цену и время извлечения из архива.
- Включайте versioning осознанно и следите за ростом стоимости.
- Не удаляйте файлы под клонами и таблицами в data lake без проверки.
- Предпочитайте форматы со схемой (Parquet), не CSV.
- Готовьтесь к запросам на удаление данных (GDPR). Подключите catalog и lineage.
- Используйте эфемерный compute и инфраструктуру как код.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему object storage плохо подходит для частых мелких обновлений, но хорошо для data lake?
- Чем отличаются eventual и strong consistency и когда нужна каждая?
- Как lakehouse связывает lake и warehouse?
- Какие четыре фактора определяют срок хранения данных?
Предыдущая: Источники данных. Следующая: Приём данных.