

The Data Warehouse Toolkit, глава 19: ETL subsystems
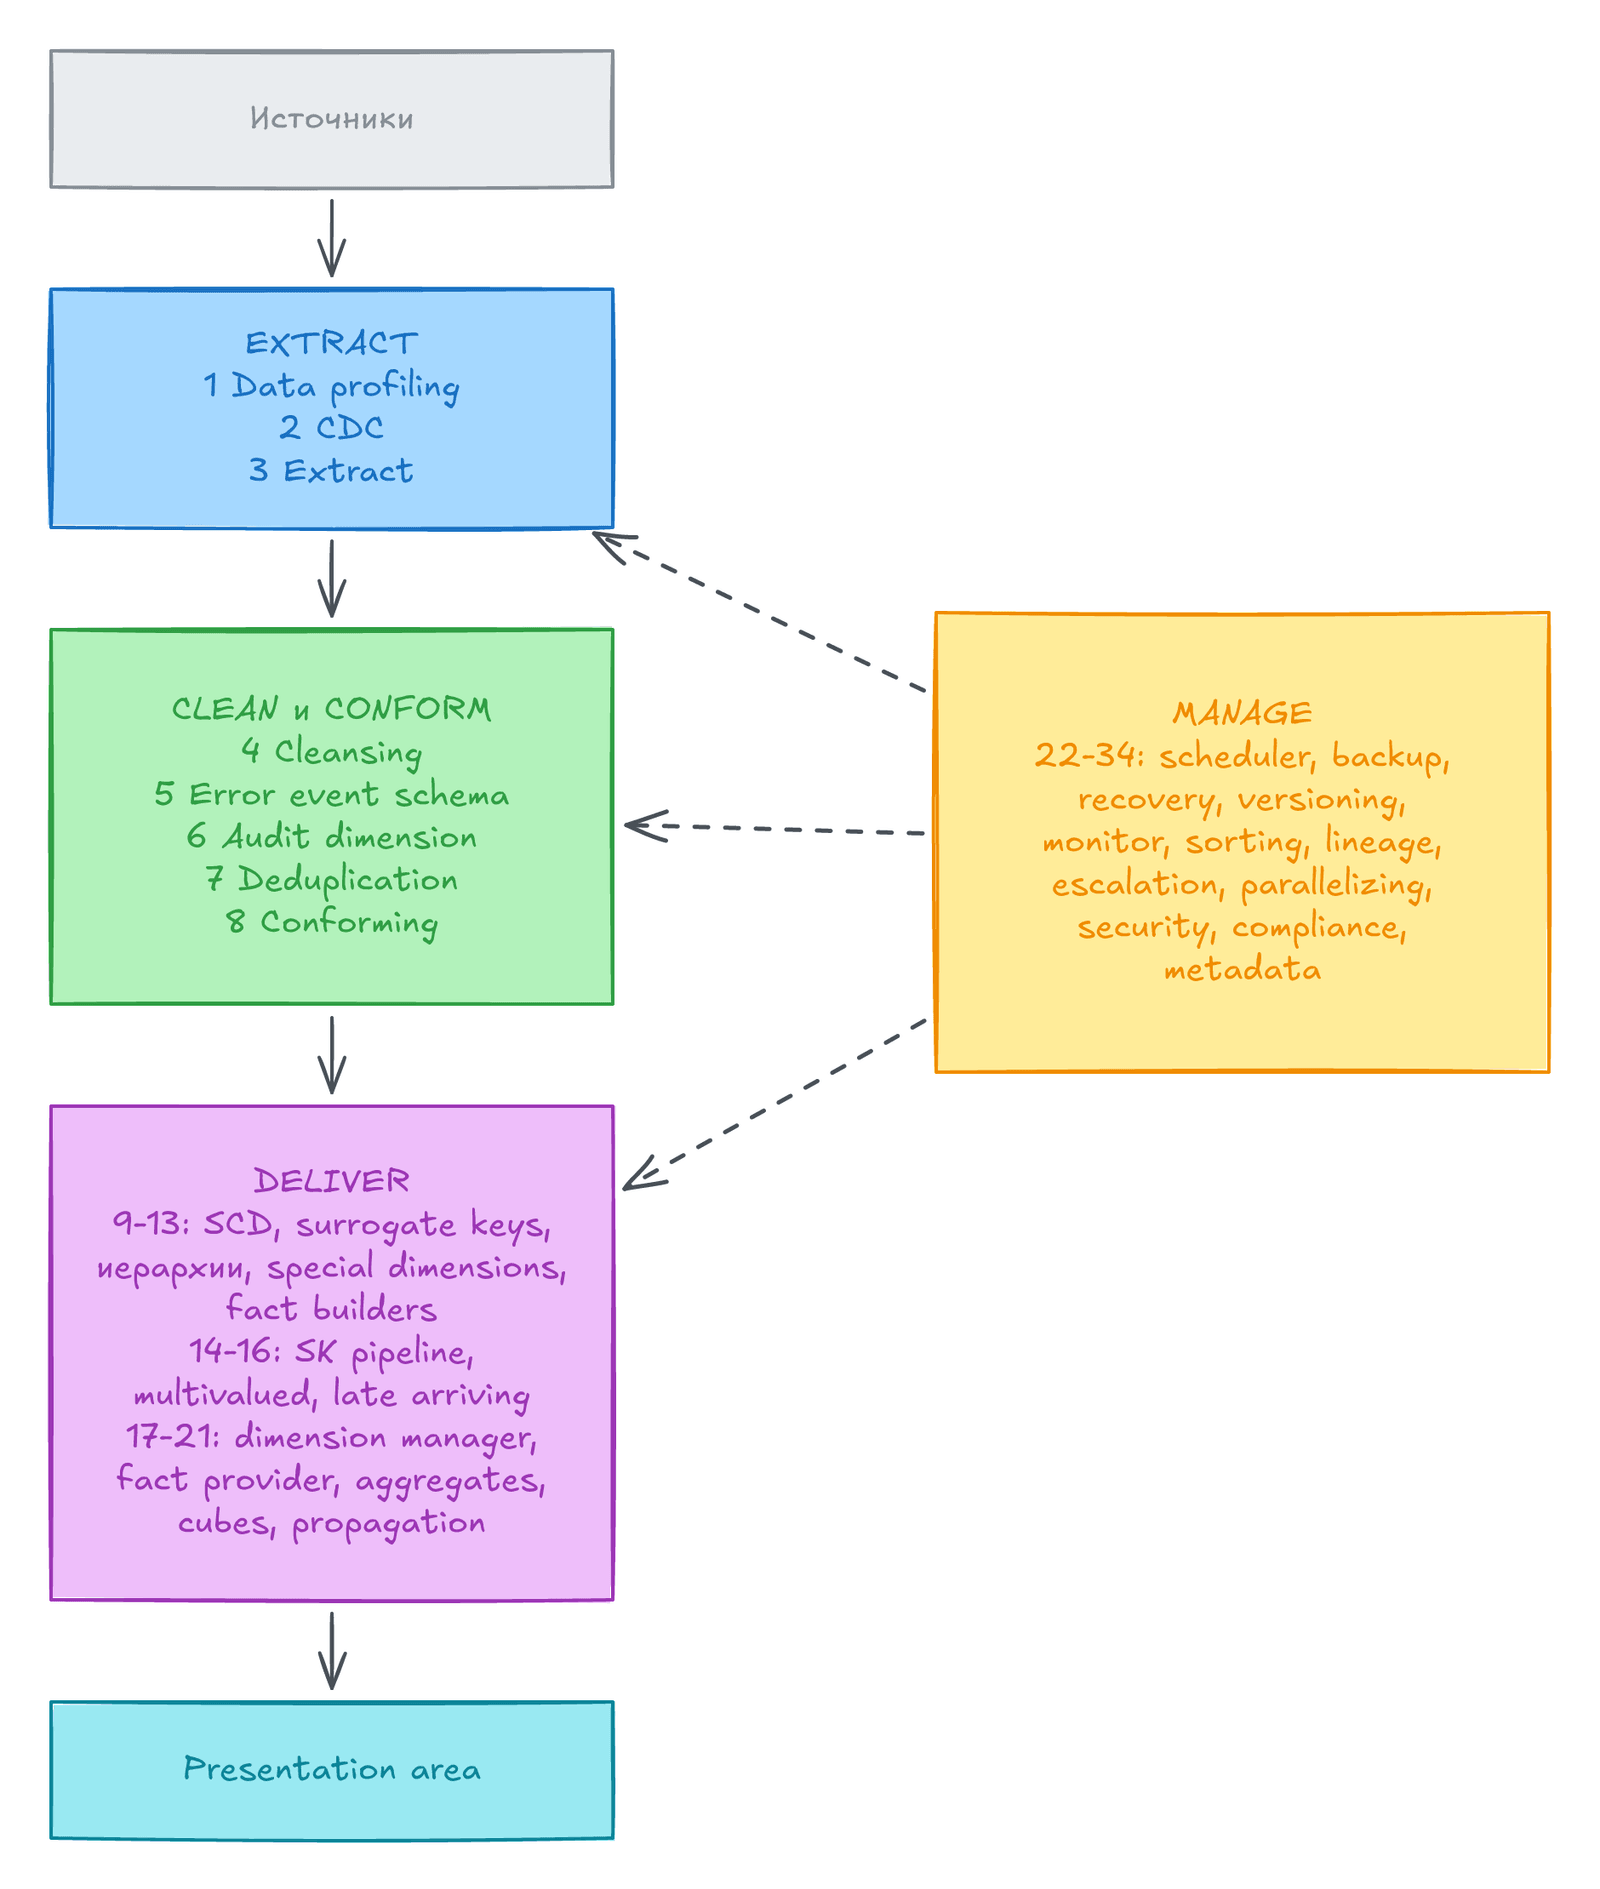
Главная мысль: ETL — это набор из 34 подсистем в четырёх группах. Extract (3), clean и conform (5), deliver (13) и manage (13). Не нужно строить все. Но нужно понимать, какую задачу решает каждая.
Сначала соберите требования
Заголовок раздела «Сначала соберите требования»Перед дизайном ETL дайте короткий ответ по десяти областям. Любая из них может остановить проект.
| Область | Вопрос |
|---|---|
| Business needs | Какие KPI и drill-down нужны? |
| Compliance | Какие данные нужно защищать и доказывать (chain of custody)? |
| Data quality | Какие поля заведомо грязные? Что мониторим? |
| Security | Кто видит данные? Как защищены backup? |
| Data integration | Какие conformed dimensions и facts нужны? |
| Data latency | День, час, секунды? |
| Archiving и lineage | Что храним и сколько? Откуда пришла каждая цифра? |
| BI delivery interfaces | Как BI получает данные? |
| Skills | Что умеет команда? |
| Legacy licenses | Какие продукты уже куплены? |
Главное про latency: переход от batch к streaming — это смена парадигмы. Почти каждый шаг нужно переписать.
Staging: пишите данные на диск после каждого крупного шага (extract, clean, deliver). Архивируйте всё, пока не решили обратное. Читать архив проще, чем пересчитывать.
Группа 1. Extract (подсистемы 1-3)
Заголовок раздела «Группа 1. Extract (подсистемы 1-3)»| № | Подсистема | Что делает |
|---|---|---|
| 1 | Data profiling | Описывает содержимое, структуру и связи источника. Сначала быстрая оценка «брать или нет». Потом глубокий анализ |
| 2 | Change data capture system (CDC) | Находит только изменённые данные, включая delete. Лучше делать как можно раньше |
| 3 | Extract system | Забирает данные из источника: файл или поток |
Как работает CDC
Заголовок раздела «Как работает CDC»| Способ | Плюс | Минус |
|---|---|---|
| Audit columns | Просто | Нельзя доверять, если данные правят скриптами. Не видит delete |
Timed extract (WHERE date = вчера) | Просто | Ненадёжный. Дубли при перезапуске. Пропуск дня теряет данные |
| Full diff compare | Находит всё | Дорого. Помогает hash или CRC |
| Log scraping | Видит всё, в том числе delete | Самый сложный способ |
| Message queue | Мало нагрузки | Нет replay. Разрыв связи теряет данные |
Extract в файл удобнее потока: легко перезапустить, можно сжать и зашифровать, можно сверить число строк. Сжимайте до шифрования.
Группа 2. Clean и conform (подсистемы 4-8)
Заголовок раздела «Группа 2. Clean и conform (подсистемы 4-8)»| № | Подсистема | Что делает |
|---|---|---|
| 4 | Data cleansing system | Проверяет данные quality screens. Исправляет или помечает |
| 5 | Error event schema | Таблицы, где хранятся все события качества |
| 6 | Audit dimension assembler | Собирает метаданные о качестве каждой строки |
| 7 | Deduplication system | Находит дубли и собирает одну строку из лучших колонок (survivorship) |
| 8 | Conforming system | Приводит данные из разных источников к общим dimensions и facts |
Quality screens
Заголовок раздела «Quality screens»Три типа проверок:
- Column screens: одно поле. Not null, допустимые значения, формат.
- Structure screens: связи между полями. Foreign key, иерархии.
- Business rule screens: сложные правила. Например, дата выдачи раньше даты закрытия.
Каждое срабатывание пишется в error event schema. Это маленькая star schema. Fact «error event» имеет grain «одна ошибка от одного screen». Dimensions: дата, batch, screen. Есть второй fact с grain ниже: одно поле в одной записи (таблица, запись, поле, условие ошибки). Решения при срабатывании: пропустить, исправить, отбросить, остановить загрузку. Чаще всего правильно записать событие и продолжить.
Audit dimension
Заголовок раздела «Audit dimension»Это dimension с метаданными загрузки: batch, время, версия правил, оценка качества. Каждая строка fact ссылается на audit key. Пользователь может спросить: «Насколько можно верить этой цифре?»
Culture качества
Заголовок раздела «Culture качества»Грязные данные — симптом сломанного бизнес-процесса. Технический фикс (маска ввода) часто приводит к выдуманным значениям. Нужна поддержка сверху и процесс, а не только ETL.
Группа 3. Deliver (подсистемы 9-21)
Заголовок раздела «Группа 3. Deliver (подсистемы 9-21)»| № | Подсистема | Что делает |
|---|---|---|
| 9 | Slowly changing dimension manager | Применяет SCD типов 1-7 |
| 10 | Surrogate key generator | Выдаёт ключи dimensions |
| 11 | Hierarchy manager | Поддерживает иерархии: fixed depth, ragged, bridge |
| 12 | Special dimensions manager | Date/time, junk, mini-dimensions, shrunken, small static, user maintained |
| 13 | Fact table builders | Загружает transaction, periodic и accumulating snapshot |
| 14 | Surrogate key pipeline | Заменяет natural keys в facts на surrogate keys |
| 15 | Multivalued dimension bridge table builder | Строит bridge tables |
| 16 | Late arriving data handler | Факты и dimensions, которые пришли с опозданием |
| 17 | Dimension manager system | Создаёт и публикует conformed dimensions |
| 18 | Fact provider system | Принимает conformed dimensions и использует их в facts |
| 19 | Aggregate builder | Строит агрегаты |
| 20 | OLAP cube builder | Загружает кубы |
| 21 | Data propagation manager | Отдаёт данные в другие системы |
Slowly changing dimensions в ETL
Заголовок раздела «Slowly changing dimensions в ETL»- Type 1: перезаписать значение. История теряется. Если dimension хранит версии, обновляют все версии.
- Type 2: закрыть текущую строку и добавить новую с новым surrogate key.
- Type 3: добавить колонку «предыдущее значение». Меняет структуру. Автоматизируют редко.
- Дату окончания текущей строки лучше задавать как дальнюю дату (
9999-12-31), а неNULL. Так проще сравнивать. - Для больших dimensions ищите изменения по CRC или hash от строки. Потом смотрите, какие колонки изменились: type 1 или type 2.
- Type 2 housekeeping columns: change date, row effective и row end date/time, reason for change, current flag.
- Даты версий берите из системной даты загрузки (as-of date), а не из
last_modifiedисточника. Скрипты в источнике могут менять данные без обновления этого поля. - Type 1 и type 3 меняют историю. Агрегаты по этой колонке нужно пересчитать. Type 2 агрегаты не ломает.
- Не используйте «UPDATE else INSERT» на больших объёмах. Отделяйте UPDATE от INSERT.
- Types 4-7 тоже задача SCD manager: mini-dimension (4), mini-dimension и type 1 outrigger (5), type 1 атрибуты в type 2 dimension (6), dual type 1 и type 2 через durable key в fact (7).
Surrogate key pipeline
Заголовок раздела «Surrogate key pipeline»- Это последний шаг перед загрузкой fact. В facts natural keys заменяют на surrogate keys. Natural key в fact не оставляют.
- Сначала обновите все dimensions. Только потом грузите facts. Так dimension всегда источник правильных ключей.
- Для обычной загрузки берут текущую версию. Для перезагрузки истории и поздних фактов ищут версию, которая была действительна на дату события.
- Каждый natural key должен найти ключ или получить значение по умолчанию. Ошибки ссылочной целостности отправляют назад на разбор. Дубли (key collisions) — это ошибка качества: остановить, отложить или исправить по правилу и записать в error event.
Late arriving data
Заголовок раздела «Late arriving data»- Late arriving fact: событие пришло позже. Нужно найти версию dimension на дату события. Иногда нужно поправить semi-additive балансы в следующих строках.
- Late arriving dimension (early arriving fact): факт пришёл раньше описания. В batch-режиме часто можно просто подождать. Если ждать нельзя:
- Natural key есть, но клиента ещё нет в dimension. Создайте inferred member: новую строку со своим surrogate key и временными значениями. Когда придут настоящие данные, перезапишите строку как type 1. Ключ в fact менять не нужно. Ссылка на общую строку Unknown хуже: потом придётся переписывать ключи в fact.
- Опоздало type 2 изменение. Вставьте новую версию, поправьте даты версий и перепишите ключ в fact-строках после даты изменения.
Группа 4. Manage (подсистемы 22-34)
Заголовок раздела «Группа 4. Manage (подсистемы 22-34)»| № | Подсистема | Что делает |
|---|---|---|
| 22 | Job scheduler | Расписание и зависимости задач |
| 23 | Backup system | Резервные копии и архив |
| 24 | Recovery and restart system | Возобновить работу после сбоя |
| 25 | Version control system | Хранит версии ETL-кода |
| 26 | Version migration system | Переносит изменения dev, test, prod |
| 27 | Workflow monitor | Следит за ходом задач |
| 28 | Sorting system | Сортировка и группировка |
| 29 | Lineage and dependency analyzer | Откуда пришла цифра. Что зависит от поля |
| 30 | Problem escalation system | Эскалация сбоев |
| 31 | Parallelizing/pipelining system | Параллельная и конвейерная обработка |
| 32 | Security system | Доступ к ETL и данным |
| 33 | Compliance manager | Доказательства chain of custody |
| 34 | Metadata repository manager | Хранит технические, бизнес- и процессные метаданные |
Ключевая идея: ETL должен работать без людей (lights-out). Задачи перезапускаются без ручной чистки. Для каждой ошибки есть план.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| CDC | Захват только изменённых данных |
| Quality screen | Проверка качества данных |
| Error event schema | Таблицы для событий качества |
| Audit dimension | Dimension с метаданными загрузки |
| Surrogate key pipeline | Подмена natural keys на surrogate keys в fact |
| Inferred member | Заглушка в dimension для раннего факта |
| Survivorship | Правило, какая строка из дублей останется |
| Lineage | Происхождение данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с data profiling. Он определяет, сколько чистки нужно.
- Не используйте timed extract как единственный CDC. Берите high-water mark по данным, а не по часам.
- Quality screens — это тесты в
dbt(not_null,accepted_values,relationships). Результаты тестов храните в таблице. - Всегда держите строку Unknown в каждой dimension. Тогда fact не получает
NULLв ключе. - Сохраняйте сырой слой (raw или staging). Это ваш архив и точка перезапуска.
- Современные оркестраторы закрывают группу manage: расписание, повторы, мониторинг, lineage.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Решения тоже запускайте по порядку: каждое использует результат предыдущего.
Шаг 1. Создаём сырые данные
Заголовок раздела «Шаг 1. Создаём сырые данные»-- выгрузка клиентов из источника. Есть дубли, лишние пробелы, плохие значенияCREATE TABLE src_customer ASSELECT * FROM (VALUES (101, ' Иван Петров ', 'IVAN@MAIL.RU', 'Москва', TIMESTAMP '2024-03-01 10:00:00'), (101, 'Иван Петров', 'ivan@mail.ru', 'Москва', TIMESTAMP '2024-03-01 18:00:00'), (102, 'Анна Смирнова', 'anna@mail.ru', 'Казань', TIMESTAMP '2024-03-01 11:00:00'), (103, 'Олег Иванов', NULL, 'Самара', TIMESTAMP '2024-03-01 12:00:00'), (104, 'Мария Орлова', 'maria(at)mail.ru', 'Москва', TIMESTAMP '2024-03-01 13:00:00'), (105, 'Сергей Волков', 'sergey@mail.ru', NULL, TIMESTAMP '2024-03-01 14:00:00')) t(customer_id, name, email, city, updated_at);
-- выгрузка продажCREATE TABLE src_sales ASSELECT * FROM (VALUES (5001, 1, 101, DATE '2024-03-15', 100.0), (5002, 1, 101, DATE '2024-04-10', 150.0), (5003, 1, 102, DATE '2024-04-11', 80.0), (5004, 1, 107, DATE '2024-04-12', 60.0), -- клиента 107 ещё нет в dimension (5005, 1, NULL, DATE '2024-04-12', 30.0) -- клиент не указан) t(order_id, line_no, customer_id, order_date, amount);Задания
Заголовок раздела «Задания»1. Data profiling и deduplication. Сначала посмотрите на сырые данные: число строк, число разных customer_id, число NULL, диапазон времени. Потом создайте stg_customer: очистите пробелы, приведите email к нижнему регистру, оставьте одну последнюю строку на клиента.
Решение
-- profilingSELECT count(*)                                  AS rows_total,       count(DISTINCT customer_id)               AS distinct_ids,       count(*) FILTER (WHERE email IS NULL)     AS null_email,       count(*) FILTER (WHERE city IS NULL)      AS null_city,       min(updated_at) AS min_ts, max(updated_at) AS max_tsFROM src_customer;
-- dedup: победитель — самая свежая строкаCREATE TABLE stg_customer ASSELECT customer_id, trim(name) AS name, lower(email) AS email, city, updated_atFROM src_customerQUALIFY row_number() OVER (PARTITION BY customer_id ORDER BY updated_at DESC) = 1;
SELECT * FROM stg_customer ORDER BY customer_id;
Было 6 строк и 5 разных клиентов. После dedup в stg_customer 5 строк. Здесь самое простое правило: побеждает строка с самым поздним updated_at. В книге survivorship сложнее: для каждой колонки задают приоритет источников и собирают одну строку из лучших значений.
2. Quality screens и error event. Создайте таблицу error_event. Запишите в неё: пустой email (warning), email без нормального формата (warning), пустой город (error).
Решение
CREATE TABLE error_event (    event_key INT, batch_id INT, screen_name VARCHAR, table_name VARCHAR,    record_id VARCHAR, severity VARCHAR, event_ts TIMESTAMP);
INSERT INTO error_eventSELECT coalesce((SELECT max(event_key) FROM error_event), 0) + row_number() OVER (ORDER BY screen, customer_id),       1, screen, 'stg_customer', customer_id::VARCHAR, severity, TIMESTAMP '2024-03-02 02:00:00'FROM (    SELECT customer_id, 'email_not_null' AS screen, 'warning' AS severity    FROM stg_customer WHERE email IS NULL    UNION ALL    SELECT customer_id, 'email_format', 'warning'    FROM stg_customer    WHERE email IS NOT NULL AND NOT regexp_matches(email, '^[^@ ]+@[^@ ]+\.[a-z]+$')    UNION ALL    SELECT customer_id, 'city_not_null', 'error'    FROM stg_customer WHERE city IS NULL) e;
SELECT * FROM error_event ORDER BY event_key;
Три события: клиенты 103, 104 и 105. Клиент 105 имеет severity error, его мы не загрузим.
3. Surrogate keys, unknown member и audit dimension. Создайте dim_audit и запишите одну строку для batch 1. Создайте dim_customer с версиями (row_start, row_end, is_current). Добавьте строку Unknown с ключом 0. Загрузите клиентов без error и дайте им ключи.
Решение
CREATE TABLE dim_audit (    audit_key INT, batch_id INT, load_ts TIMESTAMP,    rows_read INT, rows_loaded INT, rows_rejected INT, quality_status VARCHAR);
INSERT INTO dim_auditSELECT 1, 1, TIMESTAMP '2024-03-02 02:00:00',       (SELECT count(*) FROM src_customer),       (SELECT count(*) FROM stg_customer WHERE city IS NOT NULL),       (SELECT count(DISTINCT record_id) FROM error_event WHERE severity = 'error'),       CASE WHEN EXISTS (SELECT 1 FROM error_event WHERE severity = 'error')            THEN 'with errors' ELSE 'clean' END;
CREATE TABLE dim_customer (    customer_key INT, customer_id INT, name VARCHAR, email VARCHAR, city VARCHAR,    row_start DATE, row_end DATE, is_current BOOLEAN, is_inferred BOOLEAN, audit_key INT);
-- unknown memberINSERT INTO dim_customer VALUES    (0, NULL, 'Unknown', NULL, 'Unknown', DATE '1900-01-01', DATE '9999-12-31', TRUE, FALSE, 0);
-- ключ = max + порядковый номерINSERT INTO dim_customerSELECT (SELECT max(customer_key) FROM dim_customer) + row_number() OVER (ORDER BY customer_id),       customer_id, name, email, city, DATE '2024-03-01', DATE '9999-12-31', TRUE, FALSE, 1FROM stg_customerWHERE city IS NOT NULL;
SELECT * FROM dim_audit;SELECT * FROM dim_customer ORDER BY customer_key;
В dim_audit: прочитано 6, загружено 4, отклонено 1. В dim_customer пять строк: Unknown и клиенты 101-104.
4. SCD в ETL. Пришёл второй batch. У клиента 101 изменился город (type 2). У клиентов 101 и 103 изменился email (type 1). Появился новый клиент 106. Примените изменения.
Решение
CREATE TABLE stg_customer_2 ASSELECT * FROM (VALUES    (101, 'Иван Петров',   'ivan.new@mail.ru', 'Санкт-Петербург', TIMESTAMP '2024-04-01 09:00:00'),    (102, 'Анна Смирнова', 'anna@mail.ru',      'Казань',          TIMESTAMP '2024-04-01 09:00:00'),    (103, 'Олег Иванов',   'oleg@mail.ru',      'Самара',          TIMESTAMP '2024-04-01 09:00:00'),    (106, 'Павел Седов',   'pavel@mail.ru',     'Омск',            TIMESTAMP '2024-04-01 09:00:00')) t(customer_id, name, email, city, updated_at);
-- audit-строка для batch 2INSERT INTO dim_audit VALUES (2, 2, TIMESTAMP '2024-04-02 02:00:00', 4, 4, 0, 'clean');
-- type 1: перезаписываем email во всех версияхUPDATE dim_customer d SET email = s.emailFROM stg_customer_2 sWHERE d.customer_id = s.customer_id AND d.email IS DISTINCT FROM s.email;
-- type 2: находим изменения города у текущих строкCREATE TEMP TABLE scd2_changes ASSELECT s.*FROM stg_customer_2 sJOIN dim_customer d ON d.customer_id = s.customer_id AND d.is_currentWHERE d.city IS DISTINCT FROM s.city;
-- шаг 1: закрываем старые версииUPDATE dim_customerSET row_end = DATE '2024-03-31', is_current = FALSEWHERE is_current AND customer_id IN (SELECT customer_id FROM scd2_changes);
-- шаг 2: вставляем новые версии и новых клиентовINSERT INTO dim_customerSELECT (SELECT max(customer_key) FROM dim_customer) + row_number() OVER (ORDER BY customer_id),       customer_id, name, email, city, DATE '2024-04-01', DATE '9999-12-31', TRUE, FALSE, 2FROM (    SELECT * FROM scd2_changes    UNION ALL    SELECT * FROM stg_customer_2    WHERE customer_id NOT IN (SELECT customer_id FROM dim_customer WHERE customer_id IS NOT NULL));
SELECT customer_key, customer_id, email, city, row_start, row_end, is_currentFROM dim_customerORDER BY customer_id NULLS FIRST, row_start;
У клиента 101 две версии: Москва (до 31 марта) и Санкт-Петербург (с 1 апреля). Email новый в обеих. Клиент 106 добавлен.
5. Surrogate key pipeline и late arriving dimension. Загрузите fact_sales. Для клиента 107 в dimension нет строки. Создайте inferred member. Клиента без customer_id отправьте на unknown member. Для 101 подберите версию по дате заказа. Потом «пришли» данные клиента 107: обновите строку.
Решение
-- inferred members для ранних фактовINSERT INTO dim_customerSELECT (SELECT max(customer_key) FROM dim_customer) + row_number() OVER (ORDER BY customer_id),       customer_id, 'Не определён', NULL, 'Unknown',       DATE '1900-01-01', DATE '9999-12-31', TRUE, TRUE, 2FROM (    SELECT DISTINCT customer_id    FROM src_sales    WHERE customer_id IS NOT NULL      AND customer_id NOT IN (SELECT customer_id FROM dim_customer WHERE customer_id IS NOT NULL));
-- surrogate key pipeline: версия, действующая на дату заказаCREATE TABLE fact_sales ASSELECT s.order_id, s.line_no,       coalesce(d.customer_key, 0) AS customer_key,       s.order_date, s.amount,       2 AS audit_key          -- каждая fact-строка ссылается на audit dimensionFROM src_sales sLEFT JOIN dim_customer d       ON d.customer_id = s.customer_id      AND s.order_date BETWEEN d.row_start AND d.row_end;
SELECT f.order_id, f.order_date, f.customer_key, d.city, d.is_inferredFROM fact_sales fJOIN dim_customer d USING (customer_key)ORDER BY f.order_id;
-- пришли настоящие данные клиента 107: перезаписываем inferred-строкуUPDATE dim_customerSET name = 'Роман Лис', email = 'roman@mail.ru', city = 'Тверь', is_inferred = FALSEWHERE customer_id = 107 AND is_inferred;
SELECT * FROM dim_customer WHERE customer_id = 107;
Заказ 5001 (март) указывает на версию «Москва». Заказ 5002 (апрель) — на «Санкт-Петербург». Заказ 5004 использует inferred member, заказ 5005 — ключ 0. После обновления строки 107 факт остаётся на том же ключе. Ничего перезагружать не нужно.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему timed extract («все строки за вчера») ненадёжен как CDC?
- Какие три типа quality screens описывает книга? Приведите по примеру.
- Зачем fact-строке ссылка на audit dimension?
- Чем inferred member отличается от unknown member?
- Почему дата окончания текущей версии в type 2 лучше не
NULL, а дальняя дата?