

Designing Data-Intensive Applications — конспект книги
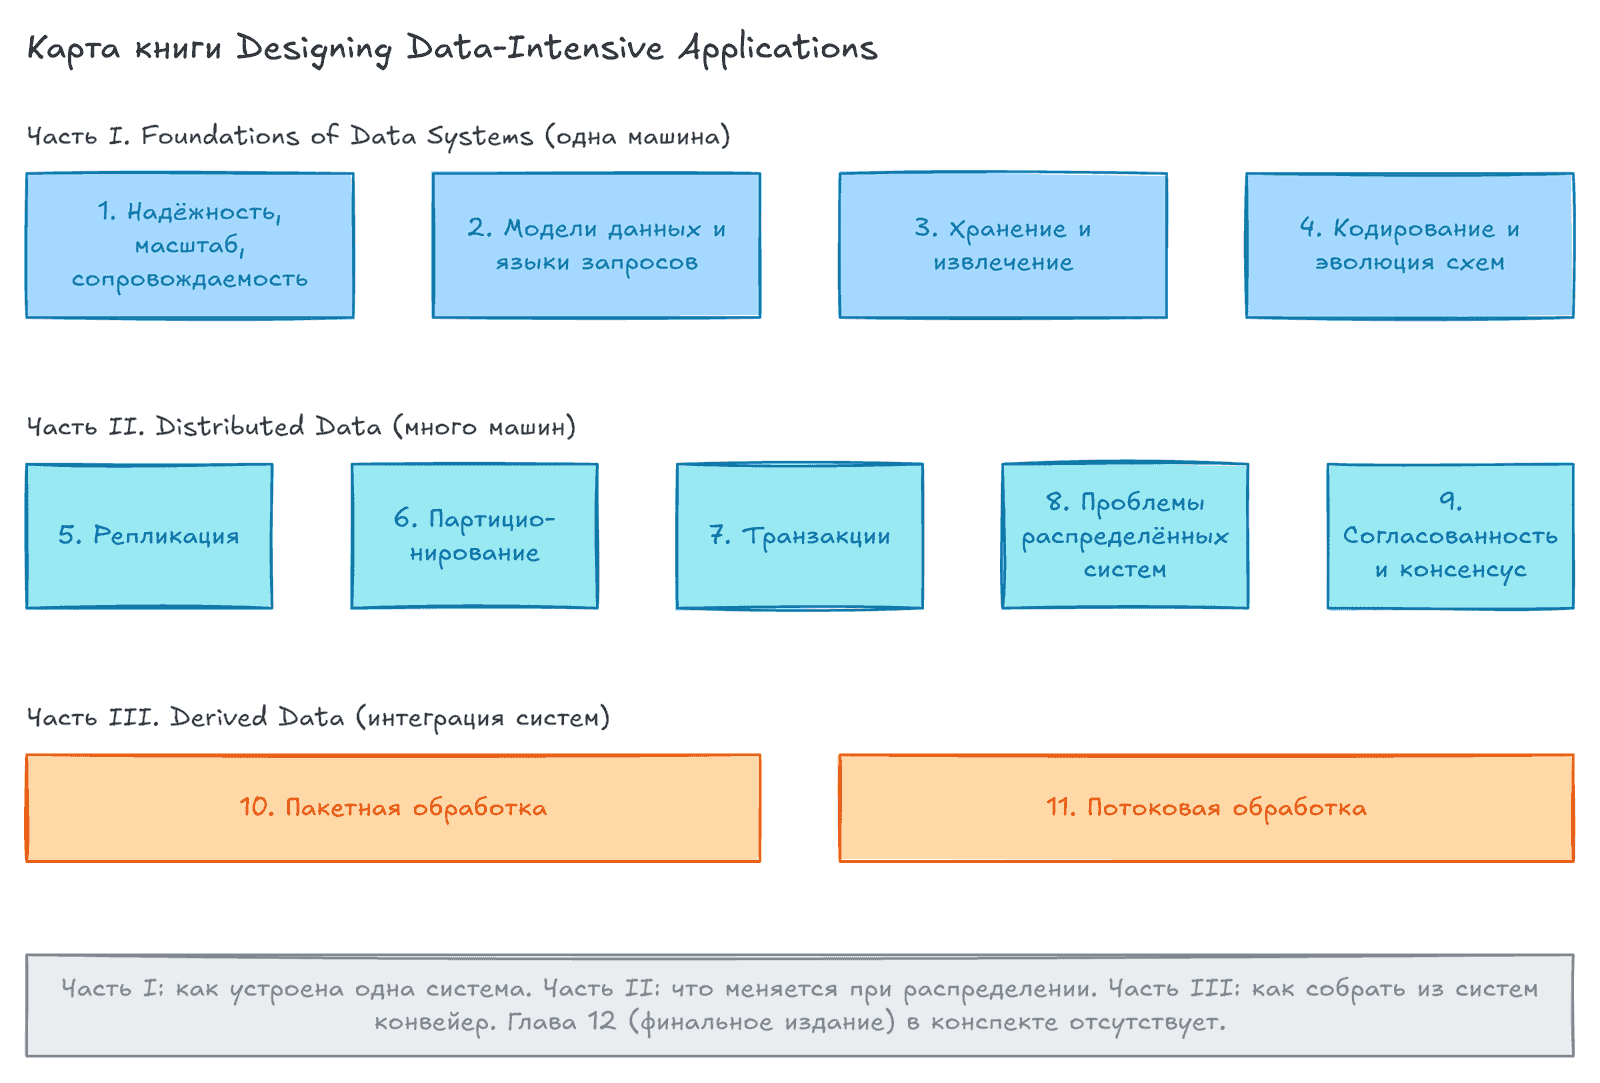
Designing Data-Intensive Applications — книга Martin Kleppmann (O’Reilly, 2017). Она объясняет, как устроены базы данных, брокеры сообщений и системы обработки данных внутри, и какие компромиссы за этим стоят. Наш конспект сделан по версии Early Release: в ней 11 глав в трёх частях. В финальном издании есть ещё глава 12, The Future of Data Systems. В конспекте её нет.
Это собственный пересказ, а не перевод. За полным текстом, примерами и ссылками на исследования идите в оригинал. Схемы нарисованы заново по содержанию глав.
Что за книга
Заголовок раздела «Что за книга»Автор называет приложение data-intensive, если главная проблема в данных: их объём, сложность или скорость изменения. Не в мощности процессора.
Книга не учит одному продукту. Она разбирает идеи, которые лежат под многими системами: PostgreSQL, MySQL, Cassandra, Kafka, Hadoop, Spark. Продукты меняются, идеи остаются.
| Часть | О чём | Главы |
|---|---|---|
| I. Foundations of Data Systems | Основы одной системы: надёжность, модели данных, хранение, кодирование | 1–4 |
| II. Distributed Data | Что происходит, когда данные на многих машинах | 5–9 |
| III. Derived Data | Как из систем собирать конвейеры: пакеты и потоки | 10–11 |
Зачем нужна эта книга
Заголовок раздела «Зачем нужна эта книга»Дата-инженер каждый день выбирает хранилище, способ загрузки и способ обработки. У каждого выбора есть цена. Книга учит видеть её.
- Компромиссы систем. Нет идеальной базы данных. Для каждой системы видно, что она выигрывает и что теряет.
- Реплики и партиции. Репликация даёт отказоустойчивость и задержку чтения. Партиционирование даёт масштаб и новые сложности.
- Транзакции и согласованность. Что гарантируют
ACID, уровни изоляции и consistency на практике. Почему данные иногда расходятся. - Сбои в распределённых системах. Сеть, часы и узлы ненадёжны. Книга показывает, как это влияет на дизайн.
- Пакеты и потоки. Как устроены MapReduce, dataflow-движки, брокеры и CDC.
- Основа для выбора. После книги проще оценить БД, брокер или схему пайплайна и задать правильные вопросы поставщику.
Для кого
Заголовок раздела «Для кого»| Роль | Что получит |
|---|---|
| Начинающий data engineer или backend-разработчик | Понимание, что скрыто под SQL, индексами и очередями |
| Опытный data engineer | Точные термины и модели для решений о репликации, партициях, потоках |
| Архитектор, тимлид | Язык для обсуждения компромиссов и рисков систем |
Книга плотная и теоретическая. Нужны базовые знания SQL и общее представление о базах данных.
Как читать
Заголовок раздела «Как читать»- Новичок. Читайте по порядку, но не застревайте. На первом проходе берите «Главную мысль» и таблицы терминов. Сложные места (главы 8 и 9) оставьте на второй проход.
- Опытный инженер. Идите по задаче. Нужны потоки: главы 10 и 11. Нужна БД: главы 3, 5, 6, 7. Нужно понять расхождение данных: главы 5, 8, 9.
- Готовите архитектуру пайплайна. Главы 4, 10, 11, затем 5–7.
Предлагаемый порядок:
- Главы 1–3: базовые понятия и как хранятся данные.
- Глава 4: форматы и совместимость схем.
- Главы 5–7: репликация, партиции, транзакции.
- Главы 8–9: сбои и согласованность.
- Главы 10–11: пакеты и потоки.
Связь с Fundamentals of Data Engineering
Заголовок раздела «Связь с Fundamentals of Data Engineering»Эти две книги дополняют друг друга.
| Fundamentals of Data Engineering | Designing Data-Intensive Applications | |
|---|---|---|
| Фокус | Жизненный цикл данных и архитектура | Внутреннее устройство систем |
| Вопрос | Что строить и как выбирать технологии | Как это работает и какие есть компромиссы |
| Уровень | Широкий обзор профессии | Глубокий разбор механизмов |
Сначала можно прочитать конспект Fundamentals of Data Engineering: он даёт карту. Потом эта книга объяснит, что происходит внутри блоков на карте.
Разбор по главам
Заголовок раздела «Разбор по главам»| Глава | Тема |
|---|---|
| 1. Надёжность, масштабируемость, сопровождаемость | Три цели дизайна, нагрузка, перцентили |
| 2. Модели данных и языки запросов | Реляционная, документная и графовая модели |
| 3. Хранение и извлечение | LSM-tree, B-tree, OLTP и OLAP |
| 4. Кодирование и эволюция схем | Форматы данных, совместимость версий |
| 5. Репликация | Leader и followers, задержка, конфликты |
| 6. Партиционирование | Разбиение данных, индексы, перебалансировка |
| 7. Транзакции | ACID, уровни изоляции, аномалии |
| 8. Проблемы распределённых систем | Сбои сети, часы, частичные отказы |
| 9. Согласованность и консенсус | Linearizability, порядок, консенсус |
| 10. Пакетная обработка | MapReduce, joins, dataflow-движки |
| 11. Потоковая обработка | Брокеры, CDC, окна, exactly-once |
Каждая страница содержит главную мысль, схемы, ключевые термины, выводы для практики и вопросы для самопроверки.