

The Data Warehouse Toolkit, глава 4: Склад и запасы
Главная мысль: один бизнес-процесс можно описать тремя типами fact tables. Для склада нужны все три: snapshot показывает остаток, transactions показывают движение, accumulating snapshot показывает путь партии. Здесь же появляется bus matrix и conformed dimensions.
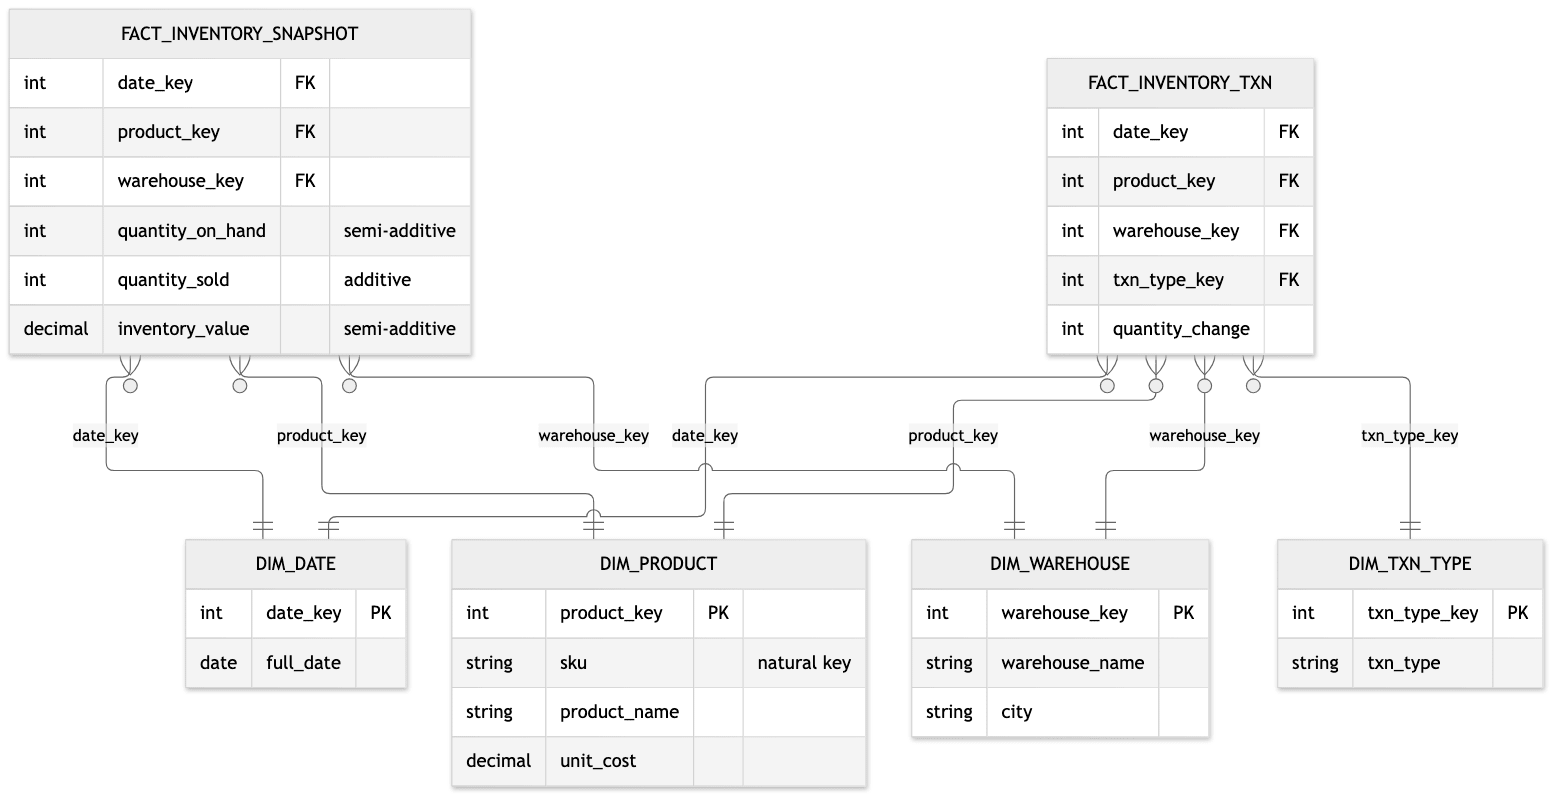
Value chain
Заголовок раздела «Value chain»Компания создаёт ценность по цепочке: закупка, склад, продажа, оплата. Каждый шаг — свой бизнес-процесс и свои fact tables. Склад связывает закупки (глава 5) и продажи (глава 3). Поэтому dimensions склада должны совпадать с dimensions соседних процессов.
Три модели склада
Заголовок раздела «Три модели склада»| Модель | Grain | Отвечает на вопрос |
|---|---|---|
| Periodic snapshot | Товар × склад × день | Сколько товара лежит на конец дня? |
| Transaction | Одно движение товара | Что принимали, отгружали, списывали? |
| Accumulating snapshot | Одна партия или единица на весь путь | Сколько дней партия шла от приёмки до продажи? |
Periodic snapshot
Заголовок раздела «Periodic snapshot»Строка — состояние за период. Мы не ждём события. ETL по расписанию записывает остаток на конец периода.
Типичные факты:
quantity_on_hand— остаток. Semi-additive;quantity_sold— продано за период. Additive;inventory_value— стоимость остатка. Semi-additive.
Правила:
- Snapshot плотный. Строка есть, даже если движений не было. Остаток без движения — это тоже информация.
- Остаток нельзя суммировать по времени. Складывать его можно по товарам и складам в один день.
- Для времени используйте среднее (
avg) или значение на конец периода. - Из остатка выводят показатели:
inventory turns,days of supply,GMROI. Они non-additive. Храните компоненты, а отношение считайте в запросе. - Ежедневный snapshot по всем товарам и складам может стать огромным. Типичный компромисс: детальные дни для свежих данных, недели для старых.
Transaction
Заголовок раздела «Transaction»Строка — одно событие движения: приёмка, проверка, размещение, отгрузка, возврат, списание.
- Хранит максимум детали. Можно восстановить остаток на любой момент.
- Тип движения — это dimension
transaction_type. Или отдельные fact tables, если у событий разные dimensions. - Остаток на дату из transactions считается долго. Поэтому делают snapshot.
- Transactions и snapshot дополняют друг друга. Snapshot часто строят из transactions.
Accumulating snapshot
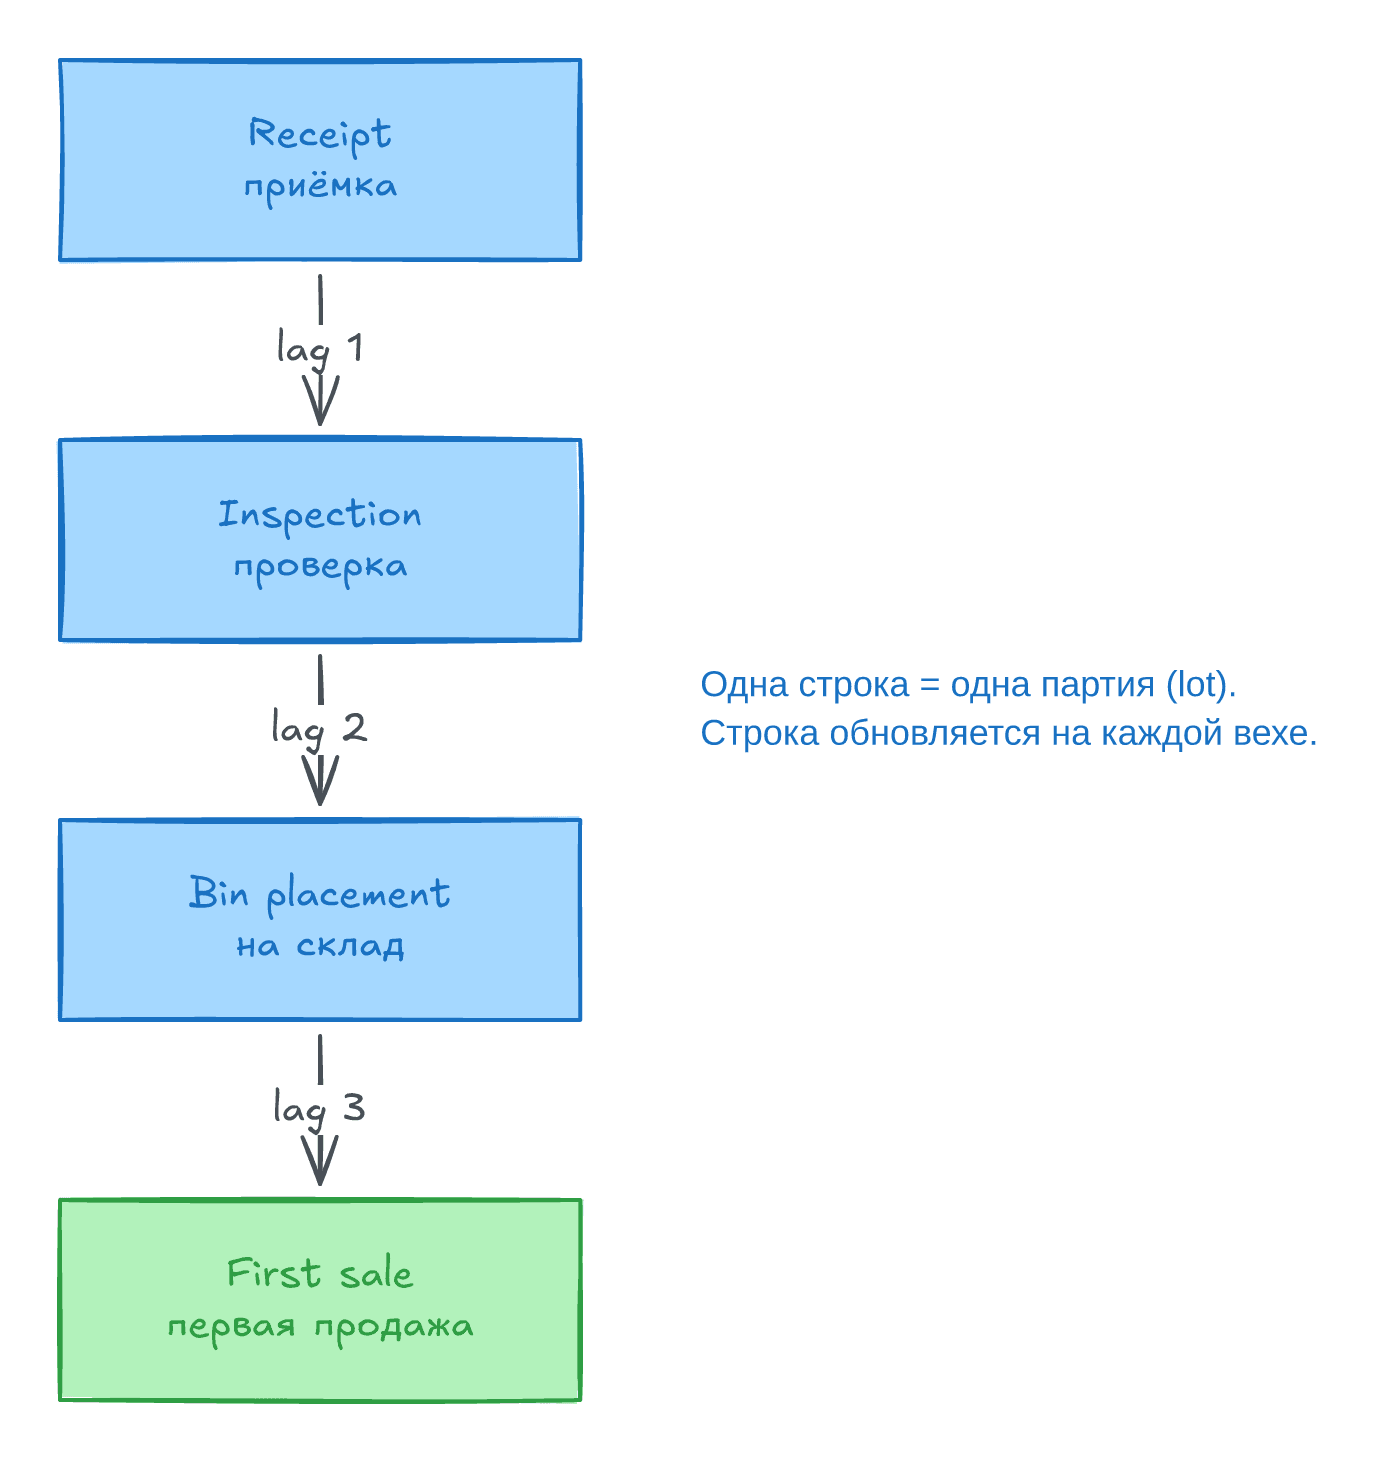
Заголовок раздела «Accumulating snapshot»Строка — один объект на весь путь через процесс. У процесса есть начало, типовые шаги и конец.
| Особенность | Как выглядит |
|---|---|
| Несколько date keys | По одному на каждую веху: received, inspected, bin placement, first sale |
| Lags | Числа дней между вехами. Сохраняем в строке |
| Обновления | Строку вставляют при старте и обновляют при каждой вехе |
| Неполная строка | Вехи, которых ещё не было, ссылаются на специальную строку dimension «ещё не наступило» |
- Это единственный тип fact table, где строки регулярно обновляются.
- Он подходит для процессов с понятным конвейером: заказы, претензии, поставки.
- Если процесс не имеет чёткого конвейера, используйте transactions.
Сравнение
Заголовок раздела «Сравнение»| Свойство | Transaction | Periodic snapshot | Accumulating snapshot |
|---|---|---|---|
| Grain | Событие | Период | Весь процесс |
| Размер | Зависит от событий | Растёт с каждым периодом | Равен числу процессов |
| Обновляется | Нет | Нет | Да |
| Date key | Один | Один (конец периода) | Несколько |
| Типичные факты | Количество, сумма | Остаток, итог за период | Лаги, счётчики вех |
Bus architecture и bus matrix
Заголовок раздела «Bus architecture и bus matrix»Хранилище строят по частям. Каждая часть — один бизнес-процесс. Чтобы части сходились, они используют общие dimensions. Это enterprise data warehouse bus.
Bus matrix — таблица планирования:
- строки — бизнес-процессы;
- колонки — conformed dimensions;
- крестик — процесс использует dimension.
| Процесс | Date | Product | Warehouse | Vendor | Store | Customer |
|---|---|---|---|---|---|---|
| Закупки | X | X | X | X | ||
| Склад (snapshot) | X | X | X | |||
| Продажи | X | X | X | X | ||
| Заказы | X | X | X |
Зачем она нужна:
- Это общий план для бизнеса и ИТ.
- Каждая строка — один проект. Можно сдавать по частям.
- Колонки показывают, какие dimensions надо согласовать в первую очередь.
Conformed dimensions
Заголовок раздела «Conformed dimensions»Conformed dimension одинакова во всех fact tables, где используется. Одинаковые ключи, названия атрибутов и значения. Либо одна из них — строгое подмножество другой.
| Вариант | Пример |
|---|---|
| Identical | Одна dim_date для всех |
| Shrunken rollup: подмножество атрибутов | dim_month для прогнозов по месяцам. dim_brand над dim_product для агрегатов |
| Shrunken: подмножество строк | Dimension магазинов только одного региона |
| Limited conformity | Полная conformity не нужна или невозможна (очень разные бизнесы). Начинают с нескольких общих атрибутов |
Что даёт conformity:
Drill across: объединяем метрики из разных fact. Агрегируем каждый fact отдельно по общему атрибуту, потом соединяем.- Общие названия и определения. Спор «чьи цифры верные» исчезает.
Governance:
- У каждой conformed dimension есть владелец (data steward).
- Согласование — главная трудность проекта. Это вопрос людей, а не технологий.
- Agile не отменяет conformity. Можно начать с одной dimension и расширять.
Conformed facts
Заголовок раздела «Conformed facts»Если одна метрика есть в нескольких fact tables, определение должно быть одинаковым: единица измерения, валюта, формула. Если определения разные, дайте метрикам разные имена. Тогда никто не сложит их по ошибке.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Periodic snapshot | Fact table: одна строка на период |
| Semi-additive fact | Суммируется по всем dimensions, кроме времени |
| Accumulating snapshot | Fact table: одна строка на процесс, обновляется |
| Lag | Число дней между двумя вехами |
| Bus matrix | Процессы против conformed dimensions |
| Conformed dimension | Одинаковая dimension в разных fact tables |
| Shrunken dimension | Урезанная версия conformed dimension |
| Drill across | Объединение метрик из разных fact tables |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Остаток — это snapshot, а не сумма движений. Считайте
avgили значение на последний день, неsumпо времени. - В
dbtsnapshot-таблицу остатков строят какincremental: новая порция строк на каждый день. - Accumulating snapshot в
dbt— этоincrementalсmergeпо ключу процесса. - Нарисуйте bus matrix до кода. Проверьте, что dimensions совпадают у соседних процессов.
- Тест
relationshipsвdbtпроверяет, что у каждого ключа в fact есть строка в conformed dimension.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку в одной сессии.
Шаг 1. Создаём dimensions и transactions
Заголовок раздела «Шаг 1. Создаём dimensions и transactions»-- превращает date key вида 20240105 в DATECREATE MACRO key_to_date(k) AS strptime(k::VARCHAR, '%Y%m%d')::DATE;
-- ключ 0 = «ещё не наступило» для вех accumulating snapshotCREATE TABLE dim_date ASSELECT strftime(d, '%Y%m%d')::INT AS date_key, d::DATE AS full_dateFROM generate_series(DATE '2024-01-01', DATE '2024-01-07', INTERVAL 1 DAY) t(d)UNION ALLSELECT 0, NULL;
CREATE TABLE dim_product ASSELECT * FROM (VALUES (1, 'SKU-1', 'Дрель', 50.0), (2, 'SKU-2', 'Молоток', 8.0)) t(product_key, sku, product_name, unit_cost);
CREATE TABLE dim_warehouse ASSELECT * FROM (VALUES (1, 'Склад Север', 'Москва'), (2, 'Склад Юг', 'Краснодар')) t(warehouse_key, warehouse_name, city);
CREATE TABLE dim_txn_type ASSELECT * FROM (VALUES (1, 'receipt'), (2, 'sale'), (3, 'adjustment')) t(txn_type_key, txn_type);
-- grain: одно движение товараCREATE TABLE fact_inventory_txn ASSELECT strftime(txn_date, '%Y%m%d')::INT AS date_key, product_key, warehouse_key, txn_type_key, quantity_changeFROM (VALUES (DATE '2024-01-01', 1, 1, 1, 100), (DATE '2024-01-01', 2, 1, 1, 50), (DATE '2024-01-01', 1, 2, 1, 40), (DATE '2024-01-02', 1, 1, 2, -30), (DATE '2024-01-02', 2, 1, 2, -10), (DATE '2024-01-03', 1, 1, 1, 20), (DATE '2024-01-03', 1, 2, 2, -15), (DATE '2024-01-05', 1, 1, 2, -40), (DATE '2024-01-05', 2, 1, 3, -2), (DATE '2024-01-06', 2, 1, 2, -8), (DATE '2024-01-06', 1, 2, 2, -5), (DATE '2024-01-07', 2, 1, 1, 30)) t(txn_date, product_key, warehouse_key, txn_type_key, quantity_change);Задания
Заголовок раздела «Задания»1. Постройте periodic snapshot из transactions. Grain: товар × склад × день. Строка должна быть и в дни без движений (например, 4 января). Остаток — накопленная сумма. Добавьте inventory_value = остаток × unit_cost.
Решение
CREATE TABLE fact_inventory_snapshot ASWITH grid AS (    SELECT d.date_key, pw.product_key, pw.warehouse_key    FROM dim_date d    CROSS JOIN (SELECT DISTINCT product_key, warehouse_key FROM fact_inventory_txn) pw    WHERE d.date_key <> 0), daily AS (    SELECT date_key, product_key, warehouse_key,           sum(quantity_change) AS qty_change,           sum(CASE WHEN txn_type_key = 2 THEN -quantity_change ELSE 0 END) AS quantity_sold    FROM fact_inventory_txn    GROUP BY ALL), snap AS (    SELECT g.date_key, g.product_key, g.warehouse_key,           sum(coalesce(d.qty_change, 0)) OVER (               PARTITION BY g.product_key, g.warehouse_key ORDER BY g.date_key           )::INT AS quantity_on_hand,           coalesce(d.quantity_sold, 0)::INT AS quantity_sold    FROM grid g    LEFT JOIN daily d USING (date_key, product_key, warehouse_key))-- стоимость остатка: остаток × себестоимость единицыSELECT s.*, s.quantity_on_hand * p.unit_cost AS inventory_valueFROM snap sJOIN dim_product p USING (product_key);
-- проверка: остаток на 7 января равен сумме всех движенийSELECT (SELECT sum(quantity_on_hand) FROM fact_inventory_snapshot WHERE date_key = 20240107) AS from_snapshot,       (SELECT sum(quantity_change) FROM fact_inventory_txn) AS from_txn;
2. Semi-additive остаток. Для каждого товара покажите: неверную сумму остатков по дням, средний дневной остаток и остаток на последний день. Остаток считайте по всем складам вместе.
Решение
WITH daily AS ( SELECT date_key, product_key, sum(quantity_on_hand) AS qoh FROM fact_inventory_snapshot GROUP BY ALL)SELECT p.product_name, sum(qoh) AS wrong_sum_over_days, -- так нельзя round(avg(qoh), 1) AS avg_daily_qoh, max_by(qoh, date_key) AS qoh_last_dayFROM dailyJOIN dim_product p USING (product_key)GROUP BY p.product_nameORDER BY p.product_name;wrong_sum_over_days растёт с числом дней. Это бессмысленное число. Для времени берите avg или последний день.
3. Inventory turns и days of supply. Для каждого товара посчитайте оборачиваемость: продано штук за неделю делить на средний остаток. И запас в днях (days of supply): остаток на последний день делить на средние продажи в день. Оба показателя non-additive: считаем их из компонентов.
Решение
WITH daily AS ( SELECT date_key, product_key, sum(quantity_on_hand) AS qoh, sum(quantity_sold) AS sold FROM fact_inventory_snapshot GROUP BY ALL)SELECT p.product_name, sum(sold) AS units_sold, round(avg(qoh), 1) AS avg_qoh, round(sum(sold) / avg(qoh), 2) AS turns, round(max_by(qoh, date_key) / avg(sold), 1) AS days_of_supplyFROM dailyJOIN dim_product p USING (product_key)GROUP BY p.product_nameORDER BY p.product_name;4. Accumulating snapshot. Создайте таблицу партий. Grain: одна партия. Вставьте новые партии с датой приёмки. Потом обновите строки по событиям и посчитайте lags.
Решение
CREATE TABLE fact_receipt_pipeline ASSELECT lot_number, product_key, warehouse_key,       received_date_key,       0 AS inspected_date_key,       0 AS bin_date_key,       0 AS first_sale_date_key,       NULL::INT AS inspect_lag_days,       NULL::INT AS bin_lag_days,       NULL::INT AS sale_lag_daysFROM (VALUES    ('L1', 1, 1, 20240101),    ('L2', 2, 1, 20240101),    ('L3', 1, 2, 20240102),    ('L4', 1, 1, 20240103)) t(lot_number, product_key, warehouse_key, received_date_key);
-- события, которые пришли позжеCREATE TABLE stg_lot_events ASSELECT * FROM (VALUES    ('L1', 20240102, 20240103, 20240105),    ('L2', 20240103, 20240104, 0),    ('L3', 20240104, 0,        0)) t(lot_number, inspected_key, bin_key, first_sale_key);
UPDATE fact_receipt_pipeline fSET inspected_date_key  = e.inspected_key,    bin_date_key        = e.bin_key,    first_sale_date_key = e.first_sale_keyFROM stg_lot_events eWHERE f.lot_number = e.lot_number;
UPDATE fact_receipt_pipelineSET inspect_lag_days = CASE WHEN inspected_date_key <> 0        THEN date_diff('day', key_to_date(received_date_key), key_to_date(inspected_date_key)) END,    bin_lag_days = CASE WHEN bin_date_key <> 0        THEN date_diff('day', key_to_date(inspected_date_key), key_to_date(bin_date_key)) END,    sale_lag_days = CASE WHEN first_sale_date_key <> 0        THEN date_diff('day', key_to_date(bin_date_key), key_to_date(first_sale_date_key)) END;
SELECT * FROM fact_receipt_pipeline ORDER BY lot_number;
Одна строка на партию. Каждый lag — дни между соседними вехами. Полный путь от приёмки до продажи — их сумма. Вехи, которых ещё не было, равны 0 («ещё не наступило»), а lag равен NULL.
5. Анализ конвейера. Покажите воронку: сколько партий дошло до каждой вехи. Потом средние lags. Затем найдите «застрявшие» партии: проверены, но ещё не размещены на складе.
Решение
SELECT count(*)                                              AS lots_received,       count(*) FILTER (WHERE inspected_date_key  <> 0)      AS lots_inspected,       count(*) FILTER (WHERE bin_date_key        <> 0)      AS lots_binned,       count(*) FILTER (WHERE first_sale_date_key <> 0)      AS lots_soldFROM fact_receipt_pipeline;
SELECT round(avg(inspect_lag_days), 2) AS avg_inspect_lag,       round(avg(bin_lag_days), 2)     AS avg_bin_lag,       round(avg(sale_lag_days), 2)    AS avg_sale_lagFROM fact_receipt_pipeline;
-- застряли после проверкиSELECT lot_number, key_to_date(inspected_date_key) AS inspected_onFROM fact_receipt_pipelineWHERE inspected_date_key <> 0 AND bin_date_key = 0;
avg игнорирует NULL, поэтому незавершённые вехи не портят средние. Застряла партия L3.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему остаток нельзя суммировать по времени? Что использовать вместо
sum? - Чем accumulating snapshot отличается от transaction fact table? Почему в нём есть
UPDATE? - Что показывает bus matrix и зачем строить её до кода?
- Как drill across связан с conformed dimensions?