

Fundamentals of Data Engineering: приложения A и B
Главная мысль: формат файла и сжатие сильно влияют на скорость и цену. Облачная сеть определяет задержки и расходы на egress.
Приложение A: сериализация и сжатие
Заголовок раздела «Приложение A: сериализация и сжатие»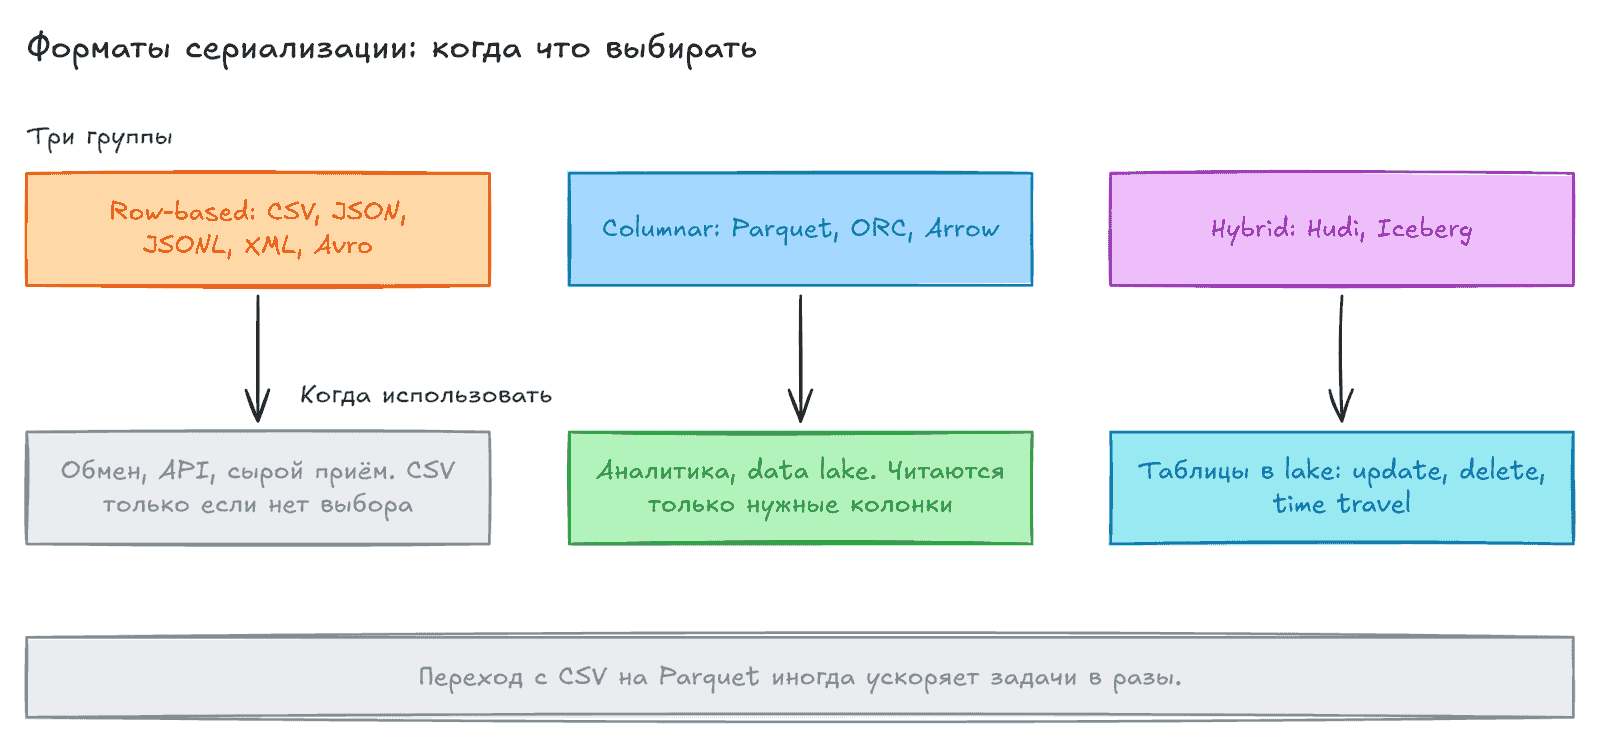
Иногда переход с CSV на Parquet ускоряет задачу в десятки раз. Данные в pipeline часто приходится reserialize, то есть переводить из одного формата в другой.
Row-based форматы
Заголовок раздела «Row-based форматы»| Формат | Суть |
|---|---|
| CSV | Нестандартный “стандарт”. Ошибки и низкая скорость. Нужен для обмена. При архивировании сохраняйте описание настроек |
| XML | Устаревший, медленный. Нужен для работы со старыми системами |
| JSON | Стандарт обмена через API. Поддерживается Snowflake, BigQuery, SQL Server |
| JSONL | JSON-объекты по одному на строку. Удобен для данных сразу после приёма |
| Avro | Бинарный формат, схема в JSON. Популярен в Hadoop |
Columnar форматы
Заголовок раздела «Columnar форматы»- Колонки хранятся отдельно. Читаются только нужные поля, а похожие значения хорошо сжимаются.
- Parquet. Хранит схему, поддерживает nested данные, переносим. Хорош для data lake. Часто с Snappy.
- ORC. Похож на Parquet. Популярен с Hive, поддерживается реже.
- Arrow. Один формат для памяти, сети и хранения. Не нужна десериализация. Есть библиотеки для многих языков. Используется в Spark и Dremio.
Hybrid форматы
Заголовок раздела «Hybrid форматы»- Hudi. Колонки плюс строки для обновлений. Хорош для CDC в таблицы. Периодически файлы пересобираются.
- Iceberg. Отслеживает файлы таблицы и снимки. Даёт time travel и schema evolution.
Storage engines
Заголовок раздела «Storage engines»- Storage engine управляет тем, как данные лежат на диске. Он отделён от query engine.
- Современные движки лучше подходят для SSD и сложных типов.
- Для аналитики растёт поддержка columnar в SQL Server, PostgreSQL и MySQL.
- Сжатие убирает повторы. На тексте возможен коэффициент около 10:1.
- Для аналитики нужно lossless (без потерь). Lossy нужен для аудио, картинок и видео.
- gzip и bzip2 хорошо сжимают текст (JSON, CSV, XML).
- Snappy, Zstandard, LZ4, LZFSE быстрее и легче для CPU. Их используют в data lake и колоночных БД.
Приложение B: облачная сеть
Заголовок раздела «Приложение B: облачная сеть»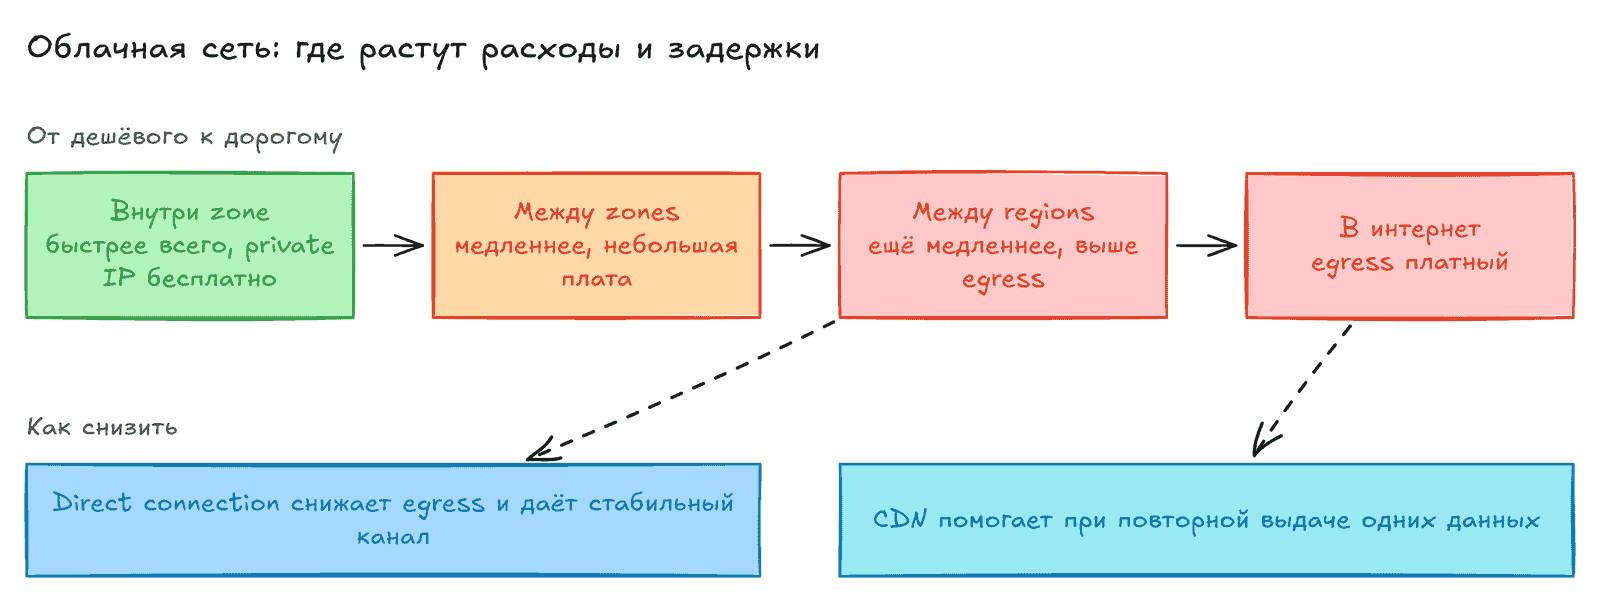
| Тема | Суть |
|---|---|
| Topology | AWS, Azure и GCP похожи: availability zones и regions. У GCP есть ещё multiregion |
| Egress | Входящий трафик бесплатен. Исходящий в интернет платный. Иногда плата есть и между zones и regions. Это способ удержать клиента |
| Availability zone | Минимальная единица. Лучшая скорость внутри zone. Трафик на private IP внутри zone бесплатен |
| Region | Несколько zones. Помогает приблизить ресурсы к пользователям. Между regions медленнее и дороже |
| Object storage | Обычно региональный ресурс |
| Correlated failure | Сбои из-за конфигурации часто затрагивают весь region |
| GCP multiregion | US, EU, ASIA. Георезервирование без ручной репликации. Premium tier идёт по сети Google |
| Direct connect | Выше скорость и ниже egress. Например, у AWS цена за GB может упасть с 9 до 2 центов |
| CDN | Хорош для повторной отдачи одних и тех же данных. Работает не везде |
- Нагрузки с большим трафиком держите в одной zone.
- Авторы ожидают, что плата за egress со временем снизится. Пример: расчёт для Zoom показал разницу между AWS и Oracle.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин (EN) | Что значит |
|---|---|
| Serialization | Кодирование данных для передачи и хранения |
| Columnar | Хранение по колонкам |
| Parquet | Колоночный формат со схемой для data lake |
| Arrow | Формат для обработки в памяти и обмена |
| Iceberg / Hudi | Управление таблицами в data lake |
| Lossless | Сжатие без потери данных |
| Availability zone | Минимальная видимая единица облачной топологии |
| Region | Группа зон |
| Egress | Исходящий трафик, часто платный |
| CDN | Сеть доставки контента |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для pipeline по возможности выбирайте Parquet вместо CSV.
- Для сырых данных после API подходит JSONL.
- Для CSV записывайте кодировку, разделители и схему.
- Для аналитики берите быстрое сжатие (Snappy, Zstandard).
- Считайте egress при проектировании multi-region и multi-cloud.
- Держите кластеры и хранилище в одном регионе и zone, если нет причин иначе.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему Parquet обычно быстрее CSV для аналитики?
- Что дают Iceberg и Hudi, чего нет у простых файлов?
- Почему трафик между regions может быть дорогим?
- Когда стоит рассмотреть direct connection?
Предыдущая: Будущее профессии.