

Другие подходы к моделированию
Dimensional modeling — не единственный способ моделировать хранилище. Подходы не исключают друг друга. Часто в одном хранилище живут два-три подхода, каждый в своём слое.
Правильный вопрос не «Кимбалл или Data Vault?», а «где в моём хранилище нужна звезда?».
Обзор подходов
Заголовок раздела «Обзор подходов»| Подход | Идея | Сильная сторона | Слабая сторона |
|---|---|---|---|
| Kimball (dimensional) | Звёзды по бизнес-процессам, связанные conformed dimensions | Понятно бизнесу, быстро для BI, можно строить по частям | Сложно, если источники часто меняют структуру |
| Inmon (CIF) | Сначала единое корпоративное хранилище в 3NF, потом витрины | Одна версия правды для всей компании | Долго и дорого. Подходит крупным компаниям |
| Data Vault | Ключи (hubs), связи (links) и атрибуты (satellites) — отдельно. Только добавление | Аудит, история, легко добавлять источники | Много таблиц и JOIN. Для отчётов нужен ещё слой |
| One Big Table (OBT) | Одна широкая таблица со всеми атрибутами | Самые простые запросы, быстро в колоночных базах | Повторы, сложно менять, разные grain не смешать |
| Activity Schema | Одна таблица-поток событий: кто, что, когда | Быстро моделировать, удобно для поведения клиентов | Новый подход, мало инструментов |
Inmon: Corporate Information Factory
Заголовок раздела «Inmon: Corporate Information Factory»Билл Инмон предложил строить хранилище сверху вниз. Сначала — единый интегрированный слой в 3NF для всей компании. Это «единая версия правды». Потом из него строят витрины (data marts) для отделов. Витрины часто — звёзды по Кимбаллу.
Кимбалл строит снизу вверх: процесс за процессом, звезда за звездой. Интеграция — через conformed dimensions.
Data Vault
Заголовок раздела «Data Vault»Data Vault (Дэн Линстедт) делит данные на три типа таблиц:
- Hub — список бизнес-ключей сущности. Например, все
customer_id, которые мы видели. - Link — связи между хабами. Например, «заказ — клиент».
- Satellite — атрибуты и их история. Каждое изменение — новая строка.
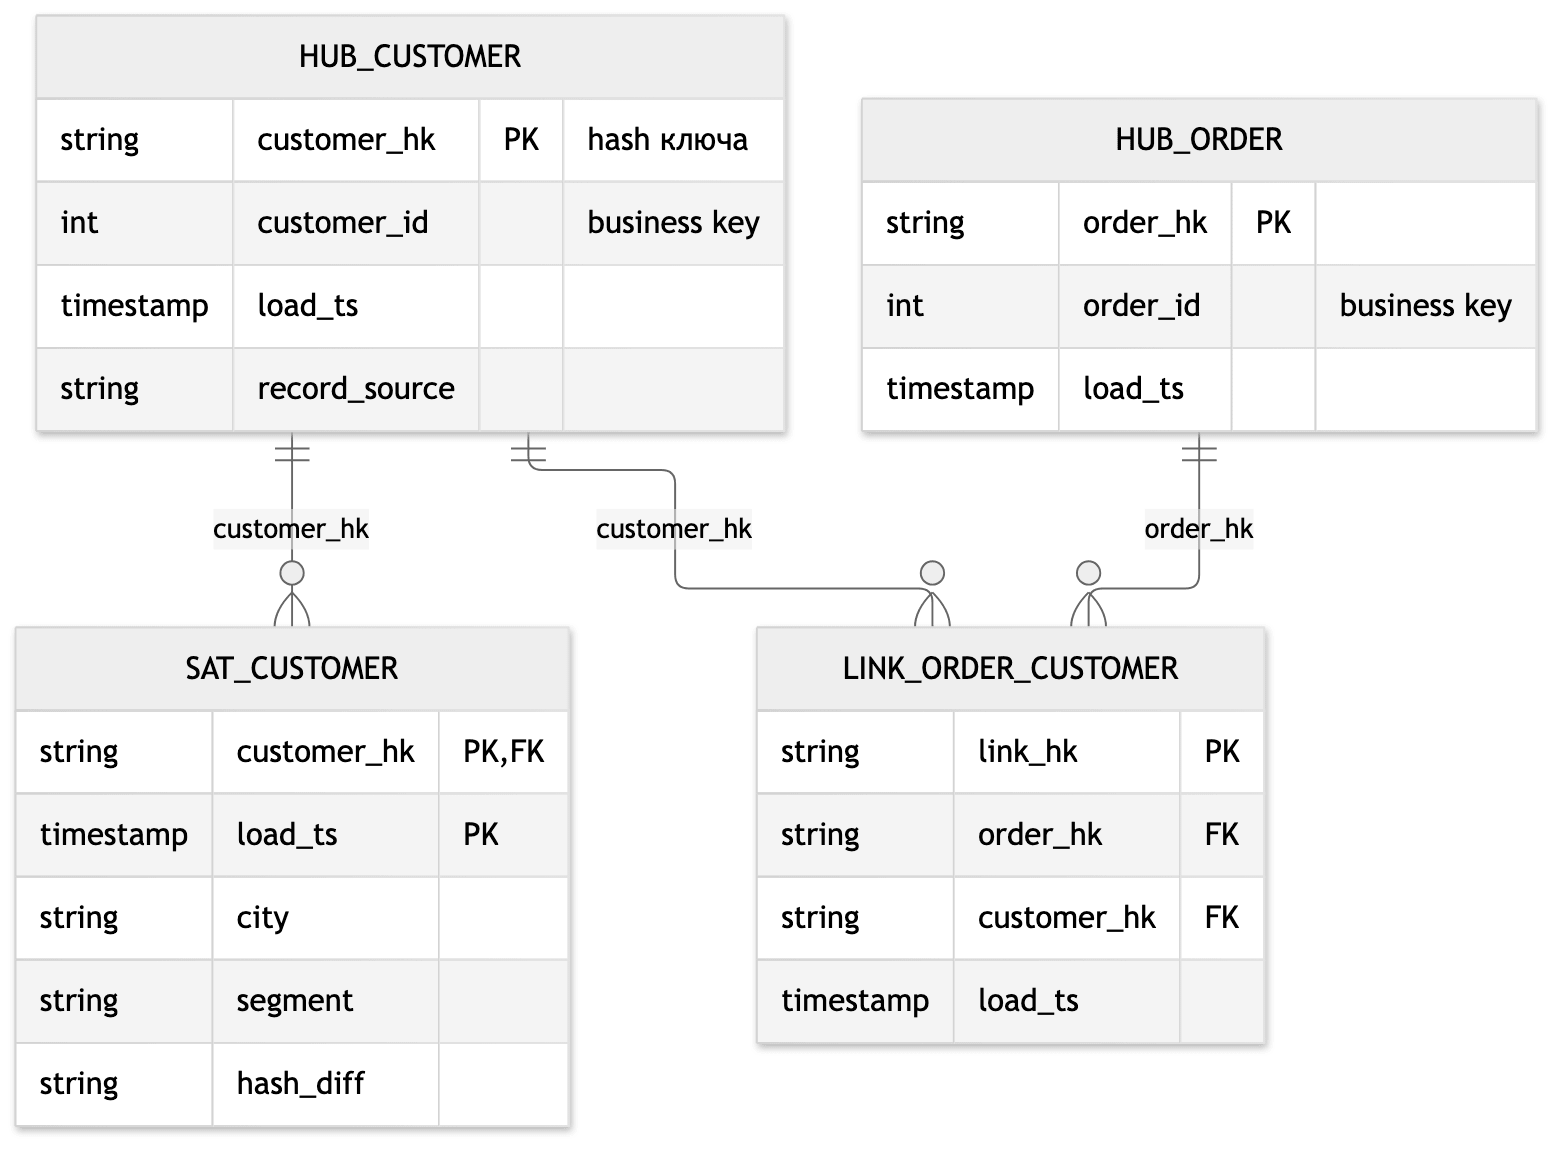
Данные только добавляются, никогда не меняются. Это удобно для аудита: видно, что и когда пришло из какого источника. Новый источник — новые сателлиты, старые таблицы не трогаем.
Минус — запросы сложные. Поэтому поверх Data Vault почти всегда строят звёзды для отчётов.
One Big Table
Заголовок раздела «One Big Table»OBT — одна широкая денормализованная таблица. Факты и все атрибуты измерений лежат в одной строке. JOIN не нужен.
Колоночные базы (BigQuery, Snowflake, ClickHouse, DuckDB) читают только нужные колонки. Поэтому широкие таблицы работают быстро. OBT удобна для дашбордов, ML-фичей и для пользователей, которые не пишут JOIN.
Хорошая практика: строить OBT из звезды, а не вместо неё. Звезда остаётся источником правды. OBT — удобная витрина поверх неё.
Activity Schema
Заголовок раздела «Activity Schema»Activity Schema — относительно новый подход. Все события клиента лежат в одной таблице-потоке: customer, activity, ts, несколько колонок-признаков. «Оформил заказ», «вернул товар», «открыл письмо» — строки одной таблицы.
Подходит для анализа поведения: воронки, когорты, «что клиент сделал после X».
Где место звезды: Medallion
Заголовок раздела «Где место звезды: Medallion»Medallion (bronze / silver / gold) — это слои хранилища, а не модель данных. Он говорит, в каком порядке обрабатывать данные. Но не говорит, какой формы должны быть таблицы в каждом слое.
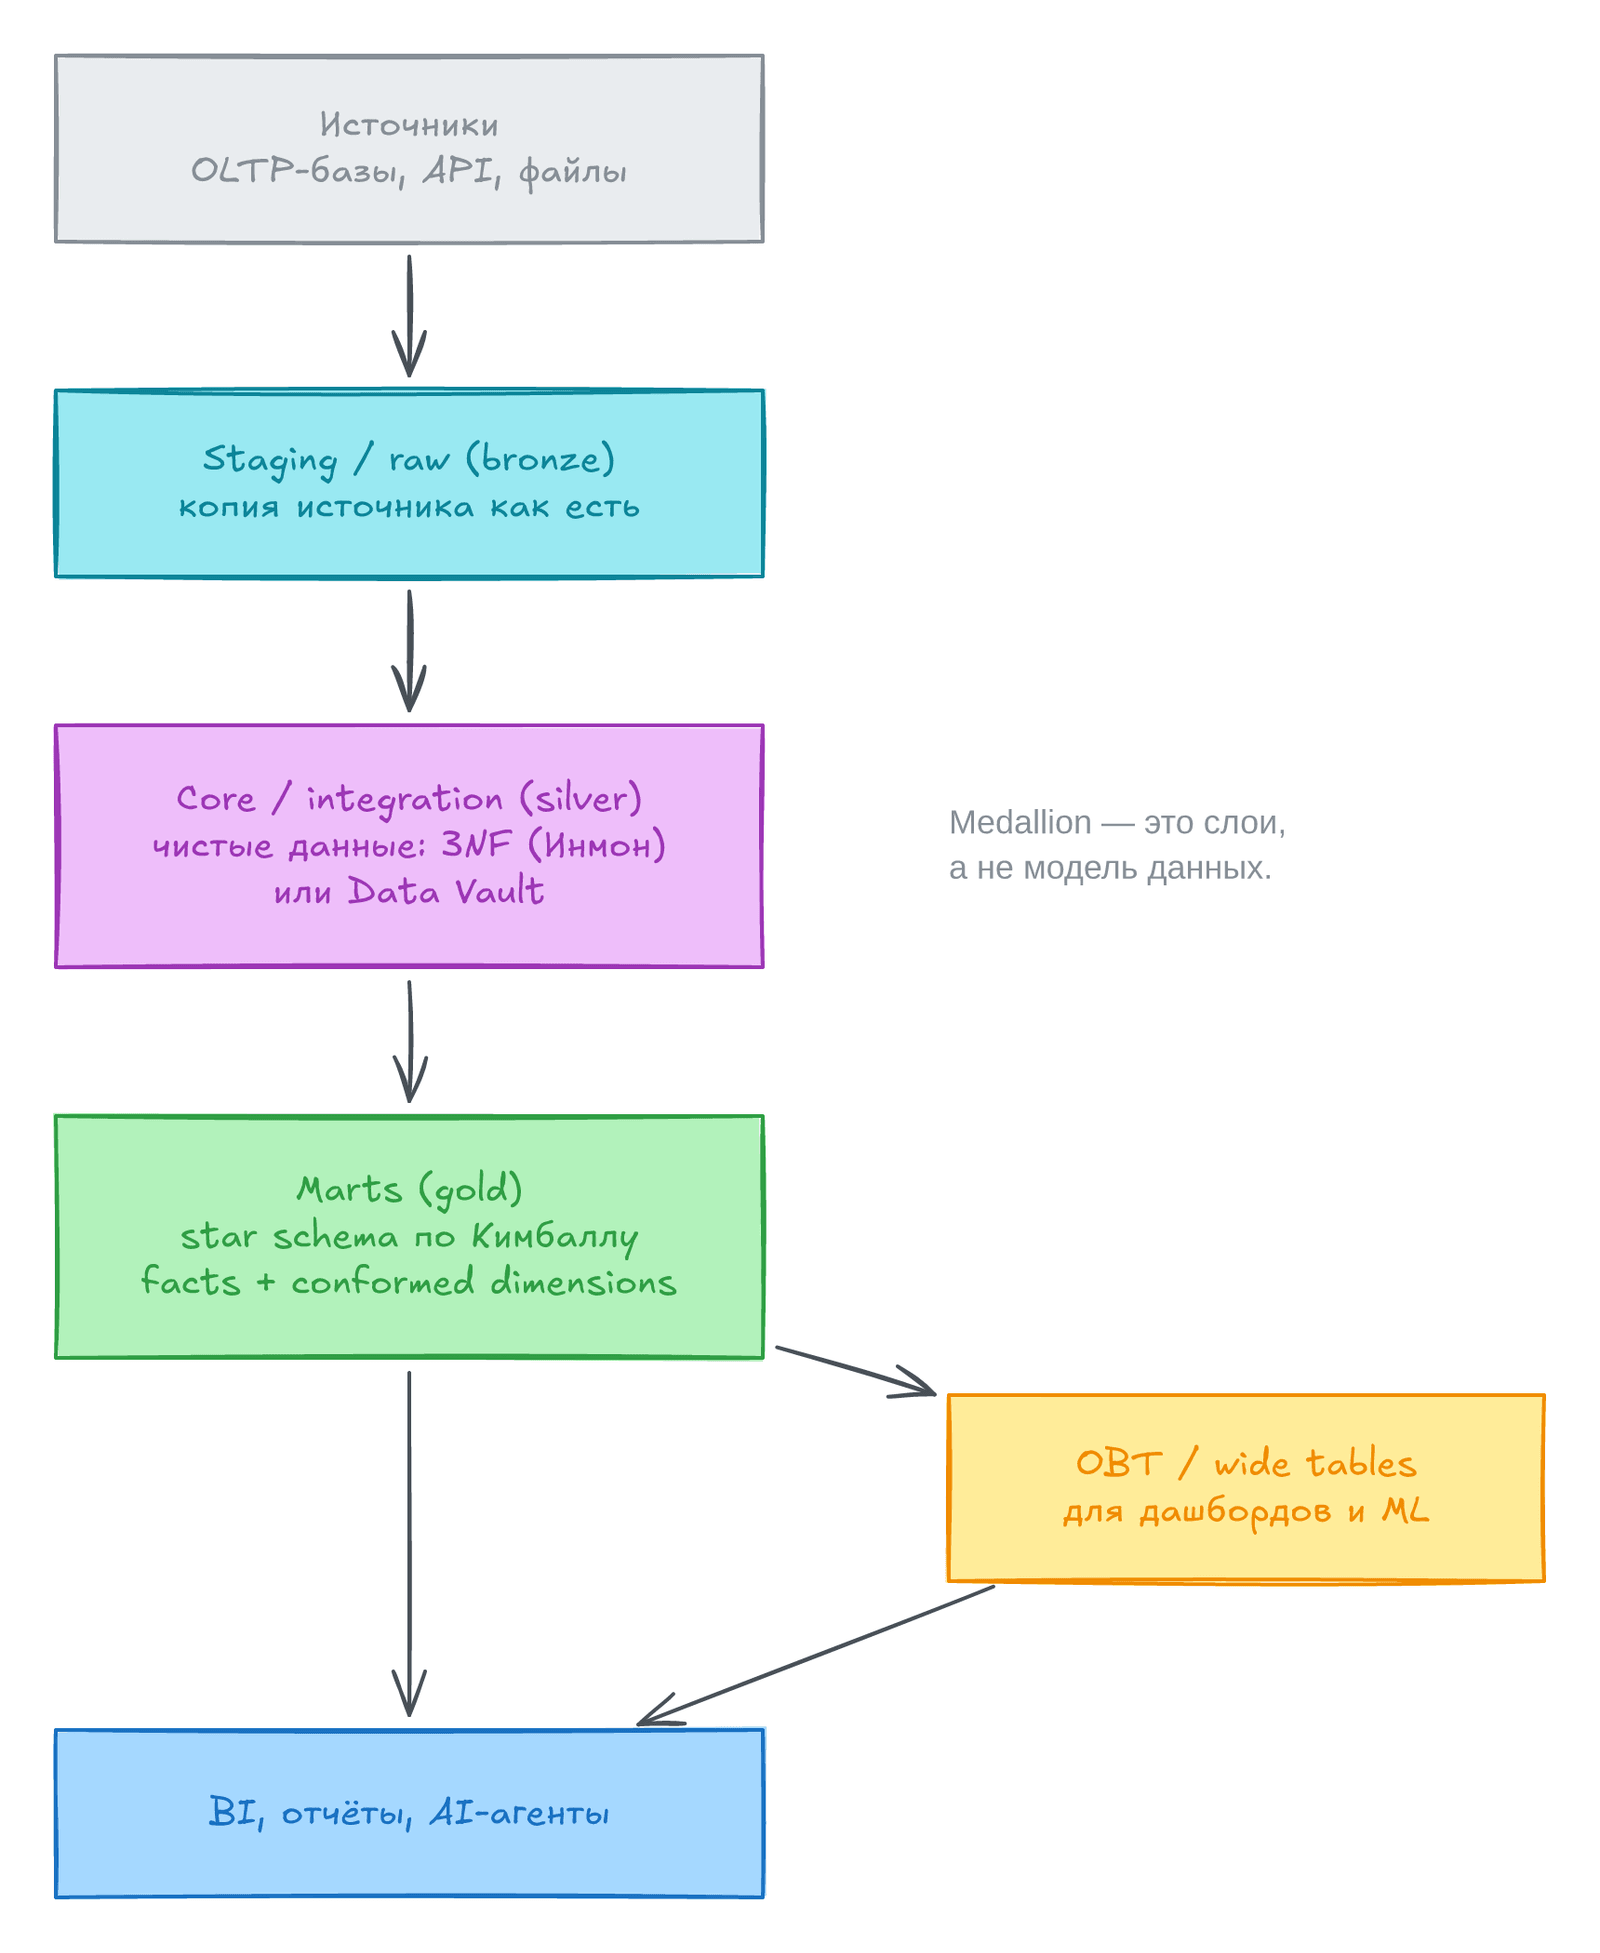
Типичная картина:
| Слой | Что лежит | Модель |
|---|---|---|
| Staging / bronze | Копия источника | Как в источнике |
| Core / silver | Очищенные, интегрированные данные | 3NF, Data Vault или сразу измерения |
| Marts / gold | Данные для бизнеса | Star schema |
| Витрины для BI и ML | Готовые широкие таблицы | OBT |
В небольших командах слой core часто пропускают. Из staging сразу строят звёзды в dbt. Это нормально.
Практика
Заголовок раздела «Практика»Решайте сами, без AI. Сначала напишите запрос, потом сверьтесь с проверкой, и только потом открывайте решение.
Подготовка: база modeling.duckdb открыта, звезда построена.
OBT из звезды
Заголовок раздела «OBT из звезды»CREATE OR REPLACE TABLE obt_sales ASSELECT f.order_id, f.line_number, d.full_date, d.year_month, d.day_type, c.customer_id, c.customer_name, c.city AS customer_city, c.segment, p.product_name, p.brand, p.category_name, p.price_band, s.store_name, s.city AS store_city, s.region, s.store_type, f.quantity, f.gross_amount, f.discount_amount, f.net_amount, f.shipping_amountFROM fact_sales fJOIN dim_date d ON d.date_key = f.date_keyJOIN dim_customer c ON c.customer_key = f.customer_keyJOIN dim_product p ON p.product_key = f.product_keyJOIN dim_store s ON s.store_key = f.store_key;
SELECT category_name, store_type, sum(net_amount) AS revenueFROM obt_salesGROUP BY ALLORDER BY ALL;Запрос без JOIN. Это то же, что flat_sales из первого урока. Но теперь атрибуты чистые: «Гость» вместо NULL, город клиента на момент покупки, ценовой диапазон.
Задание 1
Заголовок раздела «Задание 1»Клиент 82 переехал. Что нужно сделать, чтобы обновить OBT? А звезду?
Ответ
- Звезда: добавить одну строку-версию в
dim_customer. Факты не трогаем: новые продажи получат новый ключ. - OBT: если нужен город на момент покупки — ничего, старые строки верны. Если нужен текущий город — переписать все строки этого клиента. У активного клиента их могут быть тысячи.
Поэтому OBT пересобирают целиком из звезды. Это дёшево: звезда уже содержит всю логику.
Data Vault для клиента
Заголовок раздела «Data Vault для клиента»Построим hub и satellite клиента из источника. Ключи — хеши от business key. hash_diff — хеш атрибутов: по нему видно, изменилась ли запись.
CREATE OR REPLACE TABLE hub_customer ASSELECT md5(customer_id::VARCHAR) AS customer_hk,       customer_id,       TIMESTAMP '2025-01-01 00:00:00' AS load_ts,       'shop_db' AS record_sourceFROM src.customers;
CREATE OR REPLACE TABLE sat_customer ASSELECT md5(customer_id::VARCHAR)  AS customer_hk,       load_ts, city, segment,       md5(city || '|' || segment) AS hash_diffFROM (    SELECT customer_id, TIMESTAMP '2025-01-01 00:00:00' AS load_ts, city, segment    FROM src.customers    UNION ALL    SELECT customer_id, changed_at::TIMESTAMP, city, segment    FROM src.customer_changes);
CREATE OR REPLACE TABLE link_order_customer ASSELECT md5(order_id::VARCHAR || '|' || customer_id::VARCHAR) AS link_hk,       md5(order_id::VARCHAR)    AS order_hk,       md5(customer_id::VARCHAR) AS customer_hk,       order_date::TIMESTAMP     AS load_tsFROM src.ordersWHERE customer_id IS NOT NULL;
SELECT (SELECT count(*) FROM hub_customer)        AS hubs,       (SELECT count(*) FROM sat_customer)        AS sats,       (SELECT count(*) FROM link_order_customer) AS links;
Задание 2
Заголовок раздела «Задание 2»Из Data Vault получите текущий город и сегмент клиента 82. Нужна последняя строка сателлита.
Проверка: Санкт-Петербург, VIP. Сравните с dim_customer: там то же самое делает фильтр is_current.
Решение
SELECT h.customer_id, s.city, s.segment, s.load_tsFROM hub_customer hJOIN sat_customer s ON s.customer_hk = h.customer_hkWHERE h.customer_id = 82QUALIFY row_number() OVER (PARTITION BY h.customer_hk ORDER BY s.load_ts DESC) = 1;Даже простой вопрос требует окна и JOIN. Отчёт «выручка по городу» потребует hub, link, сателлиты заказа и клиента с выбором версии на дату. Поэтому для BI поверх Data Vault строят звезду.
Activity Schema
Заголовок раздела «Activity Schema»Соберём поток событий клиента из трёх процессов: заказ, возврат, переезд.
CREATE OR REPLACE TABLE customer_stream ASSELECT customer_id, order_date::TIMESTAMP AS ts, 'completed_order' AS activity,       order_id::VARCHAR AS feature_1, NULL AS feature_2FROM src.ordersWHERE customer_id IS NOT NULL AND status <> 'cancelled'UNION ALLSELECT o.customer_id, r.return_date::TIMESTAMP, 'returned_item',       r.order_id::VARCHAR, r.reasonFROM src.returns rJOIN src.orders o ON o.order_id = r.order_idWHERE o.customer_id IS NOT NULLUNION ALLSELECT customer_id, changed_at::TIMESTAMP, 'changed_profile', city, segmentFROM src.customer_changes;
SELECT activity, count(*) AS eventsFROM customer_streamGROUP BY ALLORDER BY events DESC;
Задание 3
Заголовок раздела «Задание 3»Сколько клиентов сделали заказ после своего первого возврата? Это вопрос о поведении «что было после X». В Activity Schema он решается одной таблицей.
Проверка: 119 клиентов из 141, у которых был возврат.
Решение
WITH first_return AS ( SELECT customer_id, min(ts) AS returned_at FROM customer_stream WHERE activity = 'returned_item' GROUP BY ALL)SELECT count(*) AS returned_customers, count(*) FILTER (WHERE EXISTS ( SELECT 1 FROM customer_stream s WHERE s.customer_id = r.customer_id AND s.activity = 'completed_order' AND s.ts > r.returned_at )) AS ordered_after_returnFROM first_return r;Задание 4
Заголовок раздела «Задание 4»Для каждой задачи выберите подход: Kimball, Inmon, Data Vault, OBT или Activity Schema.
- Стартап, 5 источников, аналитики пишут SQL в dbt и строят дашборды.
- Банк: 200 источников, регулятор требует показать, откуда и когда пришла каждая запись.
- Дата-сайентист собирает признаки клиента для модели оттока.
- Продуктовый аналитик изучает, что делают пользователи после регистрации.
Ответ
- Kimball. Звёзды в dbt — стандарт для небольших команд. Поверх можно сделать OBT для дашбордов.
- Data Vault в слое core (аудит, много источников) + звёзды в слое marts для отчётов. Возможен и Inmon.
- OBT: одна строка на клиента со всеми признаками. Строится из звезды.
- Activity Schema или transaction fact table событий с conformed
dim_customer.
- Подходы дополняют друг друга. Звезда — слой для бизнеса и BI.
- Inmon и Data Vault решают интеграцию и аудит. Поверх них всё равно строят звёзды.
- OBT — удобная витрина. Стройте её из звезды.
- Medallion — это слои, а не модель. Звезда обычно живёт в gold.
Глубже: глава 1 — архитектура Кимбалла против Инмона и мифы о dimensional modeling. Глава 21 — dimensional modeling в мире big data. Обзор подходов и ссылки — в разделе Моделирование данных.
Дальше: Итоговая практика.