

Корреляция
Корреляция показывает, связаны ли две величины. Когда растёт одна, что происходит с другой?
Мера связи — коэффициент корреляции r. Он от −1 до +1.
r | Что значит |
|---|---|
| Около +1 | Одна растёт, другая тоже. Сильная связь |
| Около 0 | Связи нет |
| Около −1 | Одна растёт, другая падает. Сильная связь |
Грубо: |r| больше 0,7 — сильная связь, 0,3–0,7 — средняя, меньше 0,3 — слабая.
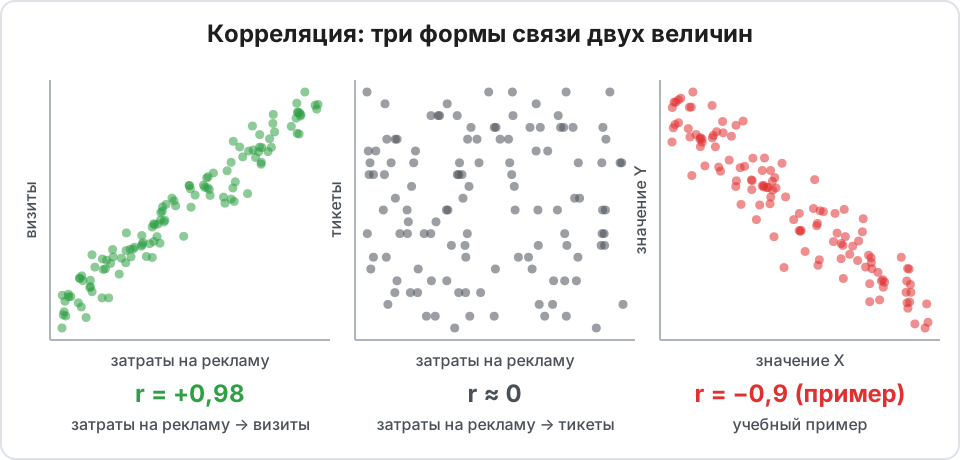
Каждая точка — один день. Слева затраты на рекламу и визиты в нашем файле daily.csv. В середине затраты и обращения в поддержку: связи нет. Справа — учебный пример с отрицательной связью.
Считаем
Заголовок раздела «Считаем»Подготовка: вы в папке stats-practice.
import csvimport statistics as st
with open("data/daily.csv") as f:    daily = list(csv.DictReader(f))
spend = [float(r["ad_spend"]) for r in daily]visits = [float(r["visits"]) for r in daily]tickets = [float(r["support_tickets"]) for r in daily]
print(round(st.correlation(spend, visits), 3))print(round(st.correlation(spend, tickets), 3))
Ответ:
0.9750.008SELECT round(corr(ad_spend, visits), 3) AS spend_visits, round(corr(ad_spend, support_tickets), 3) AS spend_ticketsFROM daily;Ответ:
spend_visits spend_tickets0.975 0.008Затраты на рекламу и визиты связаны сильно (r = 0,975). Затраты и тикеты — нет (r = 0,008).
Линия тренда
Заголовок раздела «Линия тренда»Если связь сильная, можно провести через точки прямую: y = a × x + b. Это линейная регрессия. Она отвечает на вопрос «на сколько растёт y, когда x растёт на единицу».
slope, intercept = st.linear_regression(spend, visits)print(round(slope, 3), round(intercept, 2))4.585 218.61SELECT round(regr_slope(visits, ad_spend), 3) AS slope, round(regr_intercept(visits, ad_spend), 2) AS intercept, round(regr_r2(visits, ad_spend), 3) AS r2FROM daily;slope intercept r24.585 218.61 0.951Читаем: каждая дополнительная единица затрат на рекламу даёт в среднем 4,59 визита. Без рекламы было бы около 219 визитов в день.
r2 (R²) — это r в квадрате: 0,951. Линия объясняет 95% изменений визитов.
Прогноз: при затратах 700 ждём 4,585 × 700 + 218,61 ≈ 3 428 визитов.
Практика
Заголовок раздела «Практика»Задание 1
Заголовок раздела «Задание 1»Посчитайте корреляцию затрат на рекламу (ad_spend) с заказами (orders) и с выручкой (revenue). С чем связь сильнее?
Проверка: с заказами 0,967, с выручкой 0,903. Сильнее связь с заказами.
Решение
SELECT round(corr(ad_spend, orders), 3) AS with_orders, round(corr(ad_spend, revenue), 3) AS with_revenueFROM daily;Python:
orders_n = [float(r["orders"]) for r in daily]revenue = [float(r["revenue"]) for r in daily]print(round(st.correlation(spend, orders_n), 3))print(round(st.correlation(spend, revenue), 3))С выручкой связь слабее, потому что чек у каждого заказа свой. Это добавляет шум.
Задание 2
Заголовок раздела «Задание 2»Сколько визитов ждать при затратах на рекламу 400? Используйте линию тренда.
Проверка: около 2 053 визита (4,585 × 400 + 218,61).
Решение
print(round(slope * 400 + intercept))Результат: 2053. Прогноз надёжен только внутри диапазона данных. Затраты в файле — от 218 до 996. Для затрат 5 000 прогноз уже нельзя считать верным.
Задание 3
Заголовок раздела «Задание 3»В таблице orders посчитайте корреляцию числа товаров (items) и суммы заказа (amount). Потом повторите без заказов дороже 1000. Что изменилось?
Проверка: со всеми заказами r = 0,098. Без пяти выбросов r = 0,506. Пять заказов спрятали настоящую связь.
Решение
SQL:
SELECT round(corr(items, amount), 3) AS with_outliers, round(corr(items, amount) FILTER (WHERE amount <= 1000), 3) AS without_outliersFROM orders;Python:
with open("data/orders.csv") as f:    orders = list(csv.DictReader(f))
items = [float(r["items"]) for r in orders]amount = [float(r["amount"]) for r in orders]print(round(st.correlation(items, amount), 3))
pairs = [(i, a) for i, a in zip(items, amount) if a <= 1000]items2 = [p[0] for p in pairs]amount2 = [p[1] for p in pairs]print(round(st.correlation(items2, amount2), 3))
Дальше: Нормальное распределение.