

Распределения и выбросы
Два числа (среднее и разброс) не показывают форму данных. Распределение — это то, как значения расположены по шкале: где их много, где мало.
Самый простой способ увидеть распределение — гистограмма. Мы режем шкалу на интервалы и считаем, сколько значений попало в каждый.
Гистограмма
Заголовок раздела «Гистограмма»Подготовка: вы в папке stats-practice.
Рисуем гистограмму текстом. Одна # — 10 заказов.
import csvfrom collections import Counter
with open("data/orders.csv") as f:    orders = list(csv.DictReader(f))
hours = [float(r["delivery_hours"]) for r in orders]
buckets = Counter(int(h // 10) * 10 for h in hours)for b in sorted(buckets):    print(f"{b:>3}-{b + 10:<3} {'#' * (buckets[b] // 10)} {buckets[b]}")
Ответ:
20-30 9 30-40 ############## 146 40-50 ######################################### 417 50-60 ################################## 349 60-70 ####### 79h // 10 * 10 округляет вниз до десятков: 47,3 → 40.
SELECT floor(delivery_hours / 10) * 10 AS bucket, count(*) AS n, bar(count(*), 0, 450, 30) AS chartFROM ordersGROUP BY bucketORDER BY bucket;Ответ:
bucket n chart20.0 9 ▌30.0 146 █████████▋40.0 417 ███████████████████████████▊50.0 349 ███████████████████████▎60.0 79 █████▎Функция bar() рисует полоску из символов прямо в терминале.
Это колокол: пик в середине, спад в обе стороны. Такая форма встречается часто. Мы разберём её в уроке Нормальное распределение.
Скошенность
Заголовок раздела «Скошенность»Теперь суммы заказов. Они выглядят иначе: много маленьких, мало больших.
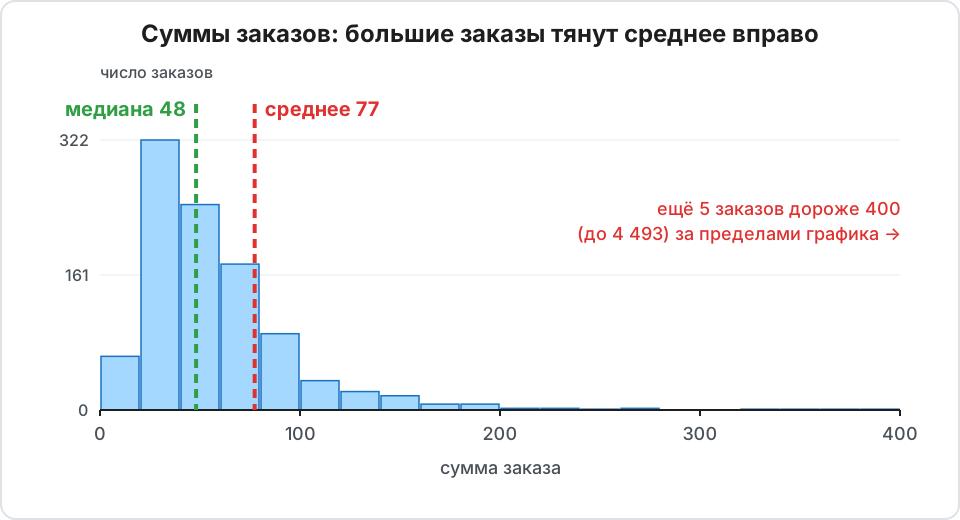
Такое распределение называют скошенным вправо. Длинный «хвост» уходит вправо. Для него среднее больше медианы.
В SQL скошенность считает skewness():
SELECT round(skewness(amount), 2) AS skew_amount, round(skewness(delivery_hours), 2) AS skew_hoursFROM orders;skew_amount skew_hours13.84 -0.02Около 0 — симметрично. Сильно больше 0 — хвост вправо. Меньше 0 — хвост влево.
Выбросы
Заголовок раздела «Выбросы»Выброс (outlier) — значение, которое далеко от остальных. Это может быть:
- ошибка (лишний ноль, дубль, сбой в пайплайне);
- редкое, но настоящее событие (крупный клиент).
Чтобы найти выбросы, нужно правило. Самое популярное — правило IQR.
IQR = Q3 − Q1. Это ширина «середины» данных.- Верхняя граница:
Q3 + 1,5 × IQR. - Нижняя граница:
Q1 − 1,5 × IQR. - Всё, что за границами, — выброс.
Это то, что рисует ящик с усами (boxplot):
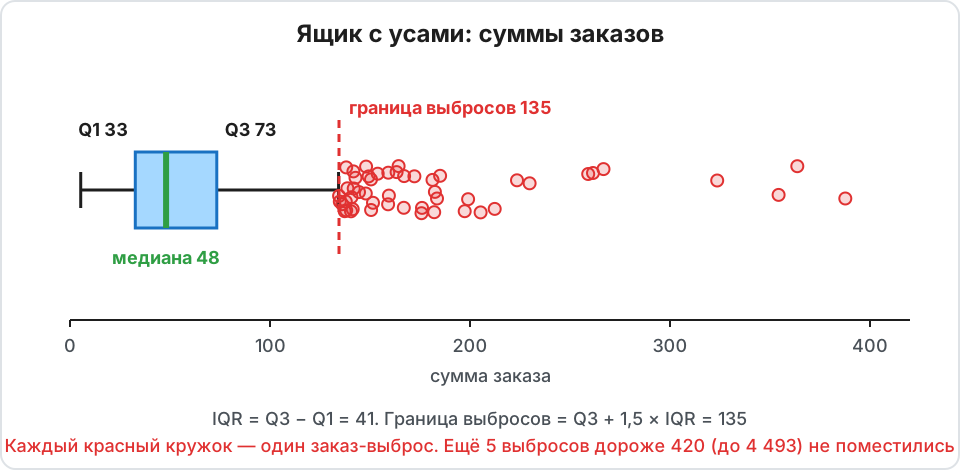
- Ящик — от Q1 до Q3. Зелёная линия внутри — медиана.
- «Усы» — до самых далёких значений внутри границ.
- Точки дальше — выбросы.
import statistics as st
amount = [float(r["amount"]) for r in orders]
q1, q2, q3 = st.quantiles(amount, n=4, method="inclusive")iqr = q3 - q1upper = q3 + 1.5 * iqr
outliers = [a for a in amount if a > upper]print(round(iqr, 2), round(upper, 2), len(outliers))
Ответ:
40.74 134.5 55WITH q AS ( SELECT quantile_cont(amount, 0.25) AS q1, quantile_cont(amount, 0.75) AS q3 FROM orders)SELECT round(q3 - q1, 2) AS iqr, round(q3 + 1.5 * (q3 - q1), 2) AS upper_fence, (SELECT count(*) FROM orders WHERE amount > q3 + 1.5 * (q3 - q1)) AS outliersFROM q;Ответ:
iqr upper_fence outliers40.74 134.5 55Правило нашло 55 выбросов. Нижней границы нет: Q1 − 1,5 × IQR меньше нуля.
Что делать с выбросами:
| Что | Когда |
|---|---|
| Оставить и использовать медиану | Выбросы настоящие, но вас интересует типичное значение |
| Посчитать отдельно (с ними и без них) | Нужно показать, как сильно они влияют |
| Исправить или убрать | Это ошибка данных. Сообщите владельцу источника |
Практика
Заголовок раздела «Практика»Задание 1
Заголовок раздела «Задание 1»Постройте гистограмму amount по интервалам 20 (0–20, 20–40, …) для заказов дешевле 200. В каком интервале больше всего заказов?
Проверка: больше всего заказов в интервале 20–40: их 322. Дальше число заказов падает: 245, 174, 91, …
Решение
SQL:
SELECT floor(amount / 20) * 20 AS bucket, count(*) AS n, bar(count(*), 0, 350, 30) AS chartFROM ordersWHERE amount < 200GROUP BY bucketORDER BY bucket;Python:
buckets = Counter(int(a // 20) * 20 for a in amount if a < 200)for b in sorted(buckets): print(f"{b:>3}-{b + 20:<3} {'#' * (buckets[b] // 10)} {buckets[b]}")Задание 2
Заголовок раздела «Задание 2»Найдите границы выбросов для delivery_hours. Сколько там выбросов?
Проверка: границы 26,0 и 70,8. Выброс один: заказ с доставкой 21,8 часа (слишком быстро).
Решение
q1, q2, q3 = st.quantiles(hours, n=4, method="inclusive")iqr = q3 - q1low, high = q1 - 1.5 * iqr, q3 + 1.5 * iqrprint(round(low, 1), round(high, 1))print([h for h in hours if h < low or h > high])Границы: 26.0 и 70.8. В списке одно значение: [21.8]. Для почти нормального распределения один выброс из 1000 — это ожидаемо.
Задание 3
Заголовок раздела «Задание 3»Найдите пять самых дорогих заказов. Что у них общего?
Проверка: суммы 3332,65–4493,42. Все пять сделаны с mobile. Запомните это — пригодится в итоговой практике.
Решение
SELECT order_id, device, channel, amountFROM ordersORDER BY amount DESCLIMIT 5;Python:
top = sorted(orders, key=lambda r: float(r["amount"]), reverse=True)[:5]for r in top: print(r["order_id"], r["device"], r["amount"])Задание 4
Заголовок раздела «Задание 4»Какое распределение скошено сильнее: amount или delivery_hours? Объясните одним предложением, как это видно по среднему и медиане.
Проверка: amount. Скошенность 13,84 против −0,02. Среднее суммы (77,3) сильно больше медианы (48,0). У времени доставки среднее (48,3) и медиана (48,25) почти равны.
Дальше: Корреляция.