

Факты и измерения
В dimensional modeling есть только два типа таблиц: факты и измерения. Всё остальное — их варианты.
Бизнес-процесс
Заголовок раздела «Бизнес-процесс»Модель строят вокруг бизнес-процесса. Это событие, которое компания делает и может измерить.
Как найти процесс: ищите глаголы. Клиент покупает. Склад отгружает. Клиент возвращает товар. Кладовщик считает остатки.
Один процесс — одна fact table. Не «таблица про клиентов», а «таблица про покупки».
Fact table (таблица фактов)
Заголовок раздела «Fact table (таблица фактов)»Fact table хранит измерения процесса в числах: сколько штук, на какую сумму, сколько дней.
- Одна строка — одно событие на определённом уровне детализации. Этот уровень называется grain (зерно). Подробно — в следующем уроке.
- Таблица узкая: ключи измерений и числа.
- Таблица длинная: миллионы и миллиарды строк.
- Строки только добавляются.
Числа в fact table называют facts или measures (меры). Например: quantity, unit_price, net_amount = quantity × unit_price − discount.
Fact table бывает трёх основных типов. Подробно — в уроке Типы fact tables.
| Тип | Одна строка — это | Пример |
|---|---|---|
| Transaction | Одно событие | Позиция в чеке |
| Periodic snapshot | Состояние на конец периода | Остаток товара на конец дня |
| Accumulating snapshot | Весь процесс с этапами | Заказ: создан → отгружен → доставлен |
Есть ещё factless fact table — таблица без чисел. Мерой служит сам факт строки. Пример: студент пришёл на занятие.
Аддитивность фактов
Заголовок раздела «Аддитивность фактов»Главный вопрос о любом числе: можно ли его складывать?
| Тип | Можно складывать | Пример | Как агрегировать |
|---|---|---|---|
| Additive | По всем измерениям | Выручка, количество | sum |
| Semi-additive | По некоторым, но не по времени | Остаток на складе, баланс счёта | По времени: avg или значение на последний день |
| Non-additive | Нельзя | Цена, процент, средний чек, маржа % | Хранить числитель и знаменатель. Делить после sum |
Остаток на складе 10 штук в понедельник и 10 во вторник — это не 20 штук. А выручка 10 в понедельник и 10 во вторник — это 20.
Правило: в fact table храните аддитивные числа. Проценты и отношения считайте в запросе или в BI: sum(числитель) / sum(знаменатель).
Dimension table (таблица измерений)
Заголовок раздела «Dimension table (таблица измерений)»Dimension table даёт контекст числам. Она отвечает на вопросы:
- Кто? — клиент: имя, город, сегмент.
- Что? — товар: название, бренд, категория.
- Когда? — дата: день недели, месяц, квартал, праздник.
- Где? — магазин: город, регион, тип.
По атрибутам измерений аналитик фильтрует (WHERE), группирует (GROUP BY) и подписывает отчёт. Число «9 650 300» без измерений ничего не значит. «Выручка категории Электроника за первое полугодие 2025» — значит.
Свойства измерений:
- Таблица широкая: десятки и сотни колонок-атрибутов.
- Таблица короткая: сотни и тысячи строк. Миллионы — редко (клиенты).
- Атрибуты — понятный текст:
«VIP», а неS2;«Выходной», а не1. - Денормализована: категория лежит прямо в товаре.
Star schema
Заголовок раздела «Star schema»Fact table в центре. Измерения вокруг. Похоже на звезду — отсюда название.
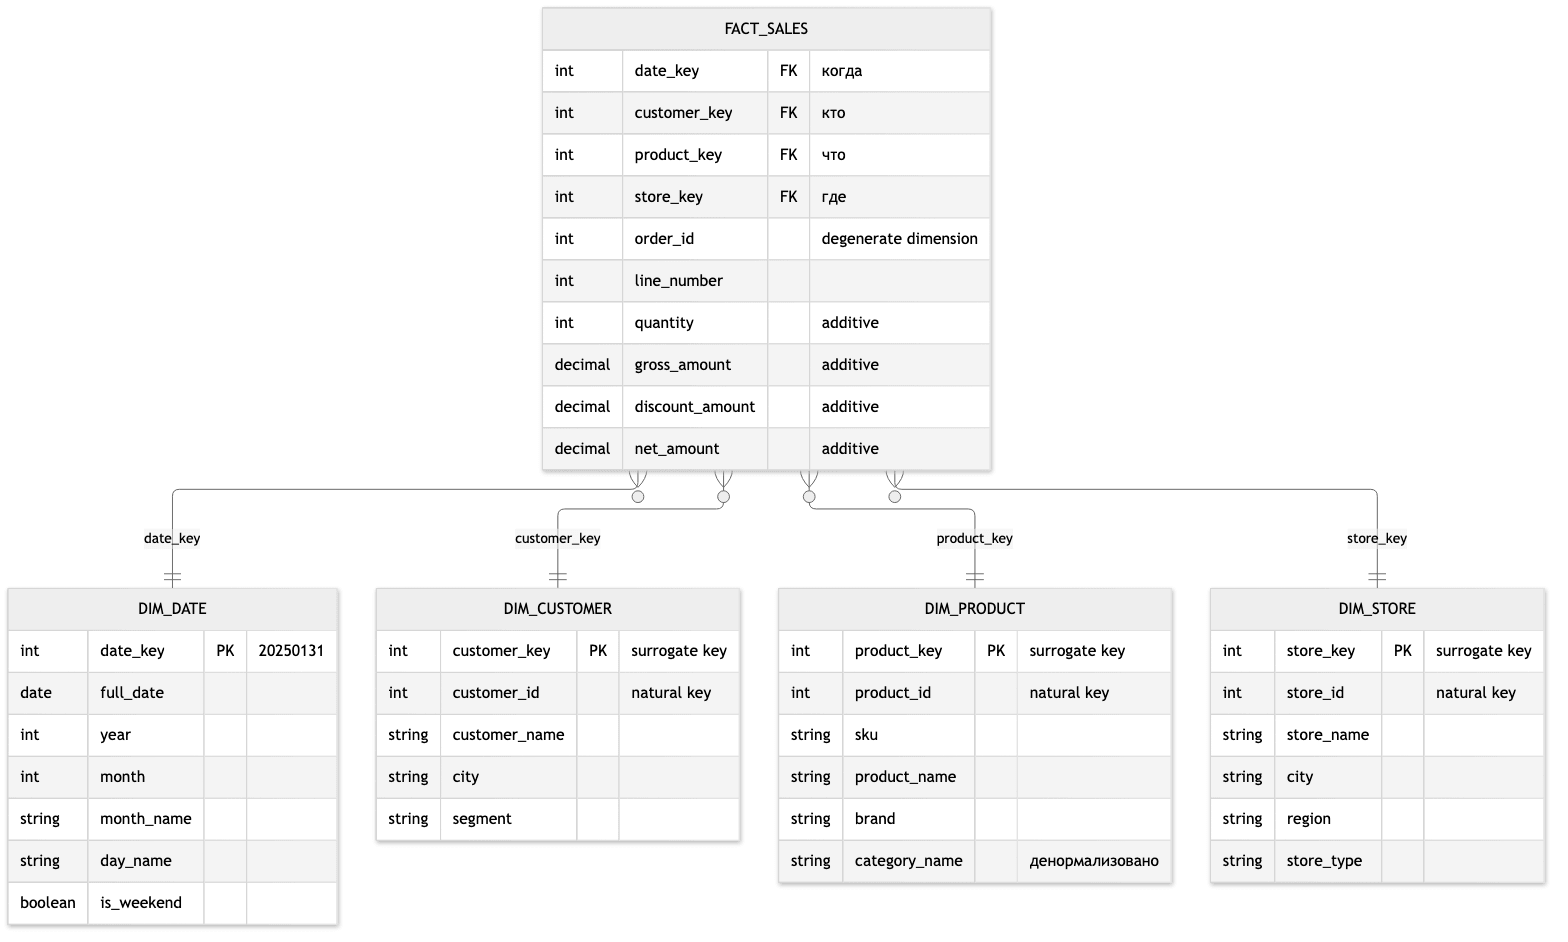
Запрос к звезде всегда одинаковый: берём факт, соединяем с нужными измерениями, группируем по атрибутам, суммируем числа.
SELECT <атрибуты измерений>, sum(<факты>)FROM factJOIN dim_1 ... JOIN dim_2 ...WHERE <фильтр по атрибутам>GROUP BY <атрибуты измерений>Star или snowflake
Заголовок раздела «Star или snowflake»Если измерение нормализовать (вынести категорию в свою таблицу), получится snowflake (снежинка).
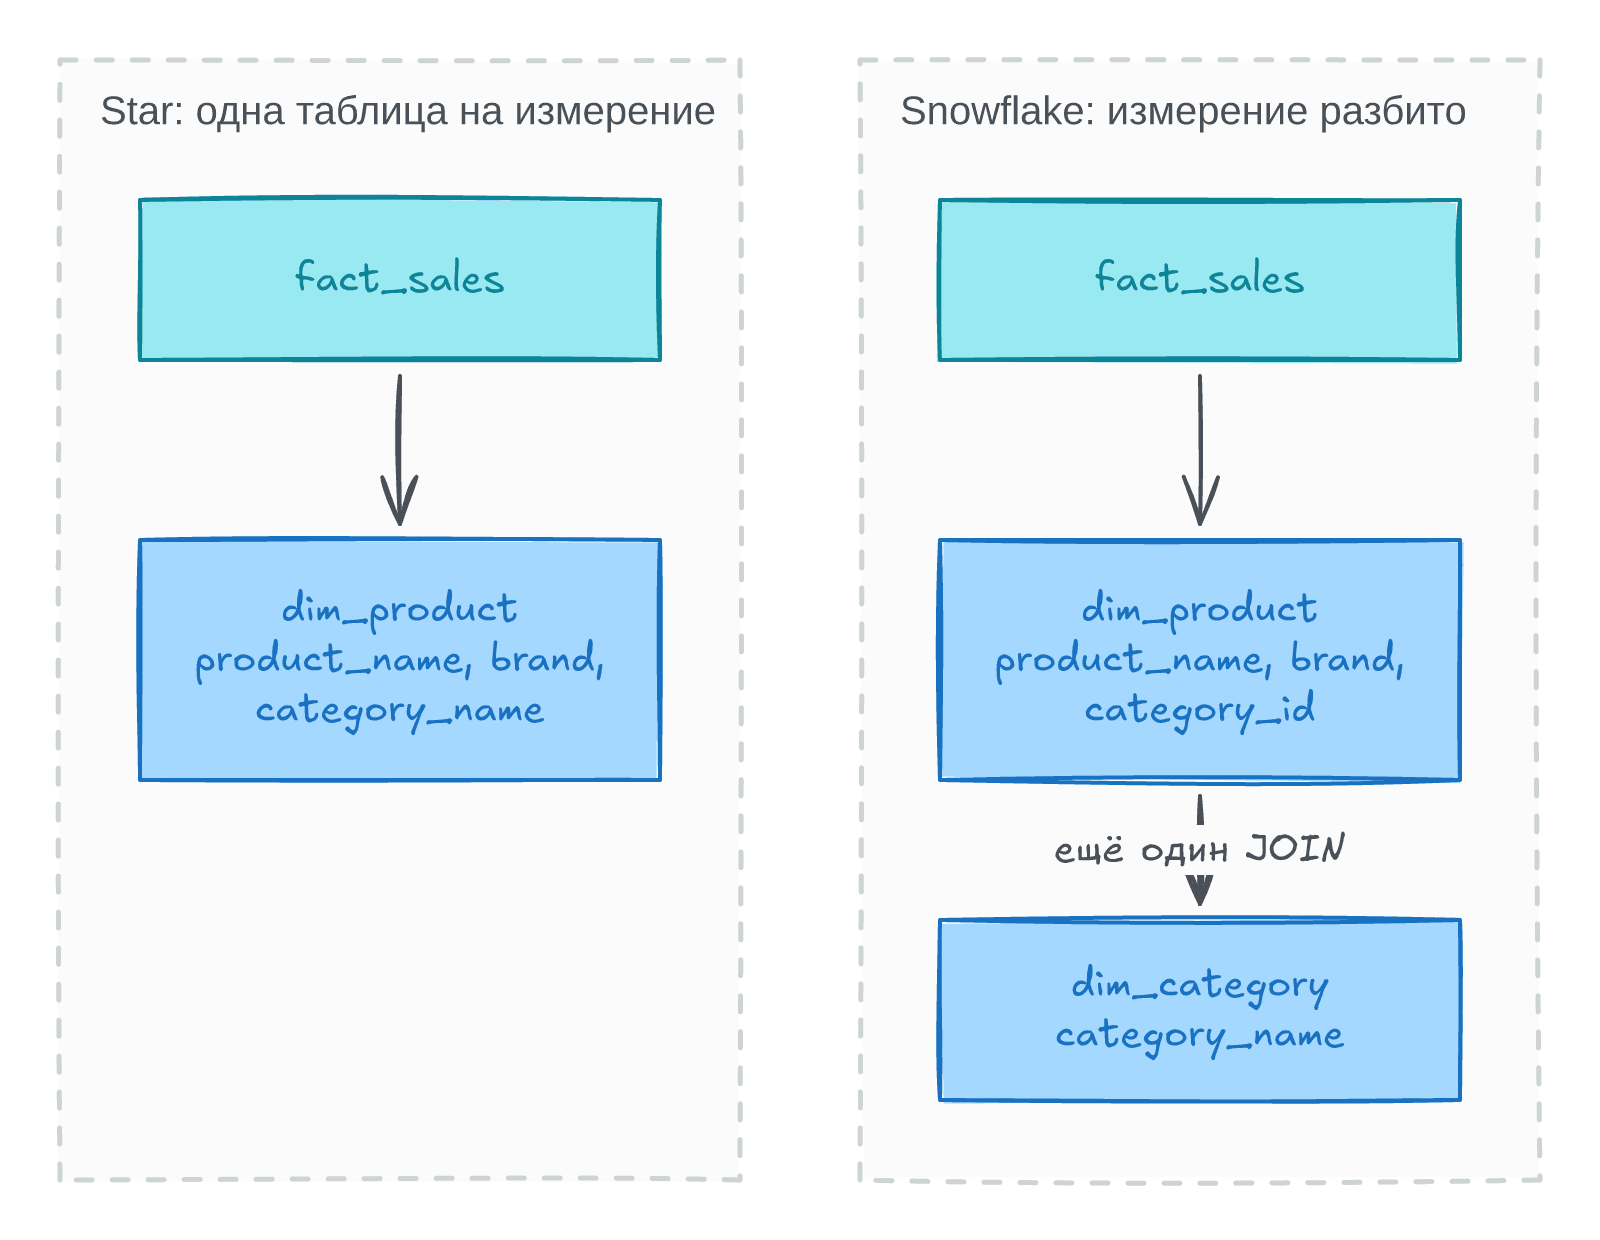
Кимбалл советует star: меньше JOIN, проще запросы, понятнее бизнесу. Место почти не экономится: измерения маленькие по сравнению с фактами. Snowflake оправдан редко, например когда BI-инструмент этого требует.
Ещё три термина
Заголовок раздела «Ещё три термина»Мы разберём их подробно дальше. Сейчас — коротко.
| Термин | Что это | Урок |
|---|---|---|
| Surrogate key | Свой ключ измерения (1, 2, 3…) вместо ключа из источника | Измерения |
| Slowly Changing Dimension (SCD) | Как хранить историю атрибутов. Клиент переехал — где учитывать старые покупки? | SCD |
| Conformed dimension | Одно измерение на несколько fact tables. Можно сравнить продажи и остатки по одному товару | Conformed dimensions |
Практика
Заголовок раздела «Практика»Решайте сами, без AI. Сначала напишите запрос, потом сверьтесь с проверкой, и только потом открывайте решение.
Подготовка: база modeling.duckdb открыта, таблица flat_sales создана в прошлом уроке.
Задание 1
Заголовок раздела «Задание 1»Посмотрите на колонки src.orders и src.order_items. Для каждой скажите: это факт (число для суммирования), ссылка на измерение или что-то другое. Без SQL.
Ответ
| Колонка | Что это |
|---|---|
order_id | Номер заказа. Измерения у него нет, все атрибуты заказа разошлись по другим измерениям. Его оставляют в факте как degenerate dimension |
line_number | Номер позиции. Вместе с order_id даёт уникальность строки |
customer_id | Ссылка на измерение «клиент» (кто) |
store_id | Ссылка на измерение «магазин» (где) |
product_id | Ссылка на измерение «товар» (что) |
order_date | Ссылка на измерение «дата» (когда) |
shipped_date, delivered_date | Тоже даты. Нужны процессу доставки, а не продаже |
status | Атрибут заказа. Используется как фильтр |
quantity | Факт, additive |
unit_price | Факт, но non-additive: цены нельзя складывать. Храним gross_amount = quantity × unit_price |
discount_amount | Факт, additive |
shipping_cost | Факт, additive. Но он на уровне заказа, а не позиции. Ловушка, о ней — в следующем уроке |
Задание 2. Additive
Заголовок раздела «Задание 2. Additive»Посчитайте выручку (без отменённых заказов) тремя способами: всего, по месяцам, по магазинам. Сложите месяцы и магазины в уме или в Excel. Сходится с общей суммой?
Проверка: всего 25 999 963. Июнь — 5 187 090.
Решение
SELECT sum(quantity * unit_price - discount_amount) AS revenueFROM flat_sales WHERE status <> 'cancelled';
SELECT month(order_date) AS month,       sum(quantity * unit_price - discount_amount) AS revenueFROM flat_sales WHERE status <> 'cancelled'GROUP BY ALL ORDER BY month;
SELECT store_name,       sum(quantity * unit_price - discount_amount) AS revenueFROM flat_sales WHERE status <> 'cancelled'GROUP BY ALL ORDER BY revenue DESC;
Сумма по месяцам и сумма по магазинам дают то же число, что и общая выручка. Выручка — additive факт.
Полный результат по месяцам:
| month | revenue |
|---|---|
| 1 | 3 655 248 |
| 2 | 3 603 021 |
| 3 | 4 066 776 |
| 4 | 4 137 647 |
| 5 | 5 350 181 |
| 6 | 5 187 090 |
Задание 3. Semi-additive
Заголовок раздела «Задание 3. Semi-additive»В src.inventory лежит остаток каждого товара в каждом магазине на конец каждого дня июня. Посчитайте для магазина store_id = 2 (ТЦ Авиапарк):
sum(quantity_on_hand)за весь июнь.- Остаток всех товаров на 30 июня.
- Средний дневной остаток: сначала сумма по товарам за день, потом среднее по дням.
Какое число имеет смысл?
Проверка: сумма за июнь — 5 652, на 30 июня — 192, средний остаток — 188,4. Какое из трёх чисел не имеет смысла?
Решение
SELECT sum(quantity_on_hand) AS wrong_sumFROM src.inventory WHERE store_id = 2;
SELECT sum(quantity_on_hand) AS stock_on_june_30FROM src.inventory WHERE store_id = 2 AND snapshot_date = DATE '2025-06-30';
SELECT round(avg(daily_stock), 1) AS avg_daily_stockFROM (    SELECT snapshot_date, sum(quantity_on_hand) AS daily_stock    FROM src.inventory WHERE store_id = 2    GROUP BY snapshot_date);
Полный результат:
| Способ | Значение | Смысл |
|---|---|---|
| Сумма за июнь | 5 652 | Нет смысла. Это не штуки на складе |
| На 30 июня | 192 | Да: столько товара лежит на складе в конце месяца |
| Средний за день | 188,4 | Да: средний запас за месяц |
Остатки можно складывать по товарам и магазинам в один день. По дням — нельзя.
Задание 4. Non-additive
Заголовок раздела «Задание 4. Non-additive»Какая доля скидки в продажах? Посчитайте двумя способами:
- Для каждой позиции
discount_amount / (quantity × unit_price), потомavg. sum(discount_amount) / sum(quantity × unit_price).
Какой ответ правильный?
Проверка: способ 1 — 1,40%. Способ 2 — 1,43%. Правильный — второй. Первый даёт одинаковый вес носкам за 590 и часам за 21 990. На наших данных разница маленькая. На реальных данных она бывает в разы.
Решение
SELECT round(100 * avg(discount_amount / (quantity * unit_price)), 2) AS avg_of_ratios, round(100 * sum(discount_amount) / sum(quantity * unit_price), 2) AS ratio_of_sumsFROM flat_salesWHERE status <> 'cancelled';Задание 5
Заголовок раздела «Задание 5»Найдите в источнике бизнес-процессы. Ищите глаголы. Какие таблицы описывают каждый процесс?
Ответ
| Процесс | Глагол | Таблицы источника |
|---|---|---|
| Продажи | Клиент покупает товары | orders, order_items |
| Выполнение заказа | Склад отгружает, курьер доставляет | orders (даты отгрузки и доставки) |
| Запасы | Магазин хранит товар | inventory |
| Возвраты | Клиент возвращает товар | returns |
| Изменение клиента | Клиент переезжает | customer_changes — это не процесс для fact table, а история измерения. Об этом в уроке SCD |
products, stores, categories — не процессы. Это справочники. Из них получатся измерения.
- Fact — числа о событии. Dimension — контекст: кто, что, когда, где.
- Перед суммированием проверьте аддитивность. Остатки по времени не складывают. Проценты считают из сумм.
- Star schema лучше snowflake почти всегда.
Глубже: The Data Warehouse Toolkit, глава 2 — справочник всех техник Кимбалла.
Дальше: Четыре шага Кимбалла.